第 1 章 从零扩展到百万用户
引言
把一个系统扩展到支持数百万用户,是一段复杂且需要反复迭代的旅程,需要不断地改进和优化。本章将介绍如何从单服务器部署起步,一步一步地扩展架构,最终支撑数百万用户。
1. 单服务器部署
最初,所有组件(Web 应用、数据库、缓存)都运行在同一台服务器上。
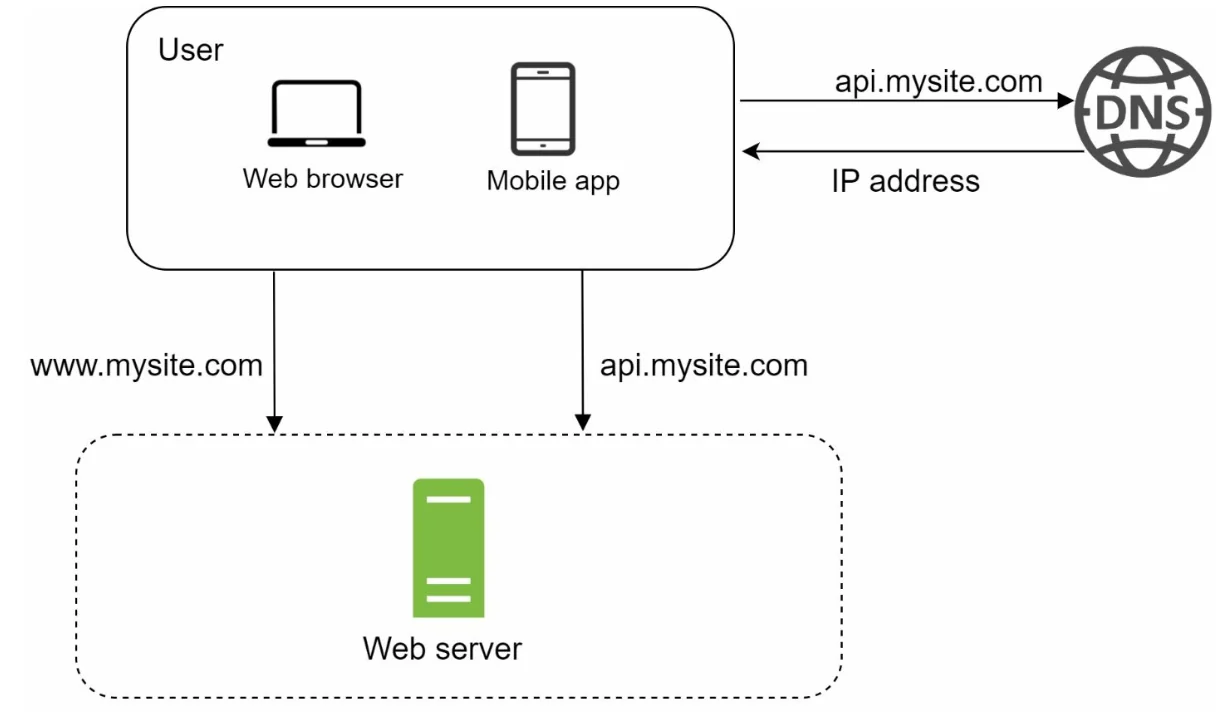
请求流程
- 用户通过域名(例如
api.mysite.com)访问应用,域名由 DNS 解析为 IP 地址。 - Web 服务器的 IP 地址被返回给浏览器或移动应用。
- HTTP 请求被发送到 Web 服务器,服务器返回 HTML 或 JSON 响应。
流量来源
- Web 应用: 使用服务端语言(例如 Python、Java)实现业务逻辑,使用客户端语言(例如 JavaScript、HTML)负责展示。
- 移动应用: 通过 HTTP 和 JSON 与 Web 服务器通信,以实现轻量级的数据交换。
2. 数据库分离
随着用户量增长,数据库被迁移到一台专用服务器上,这样 Web 层和数据库层就可以独立扩展。
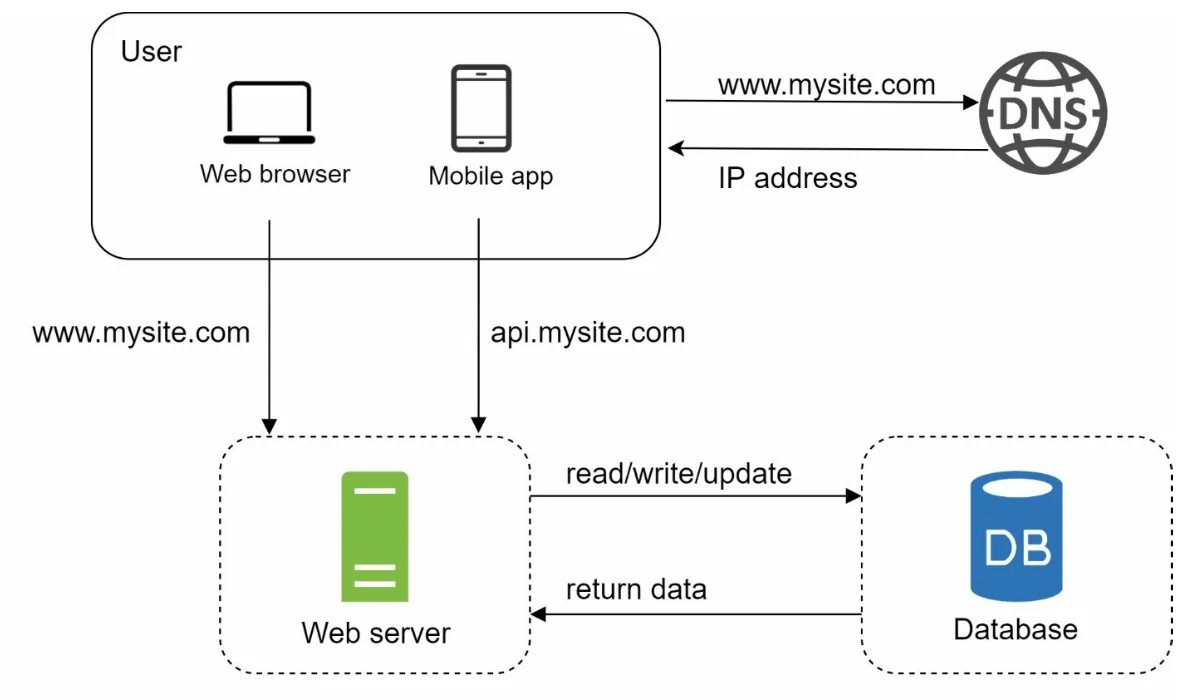
数据库选型
- 关系型数据库(SQL): 数据以结构化的形式存储在表中。例如:MySQL、PostgreSQL。
-
非关系型数据库(NoSQL): 适合非结构化数据或对低延迟有要求的场景。类别包括:
- 键值存储
- 图数据库
- 列存储
- 文档存储
-
在以下情况下,非关系型数据库可能是正确的选择:
- 应用要求极低的延迟。
- 数据是非结构化的,或者不存在关系型数据。
- 只需要对数据进行序列化和反序列化(JSON、XML、YAML 等)。
- 需要存储海量数据。
3. 垂直扩展与水平扩展
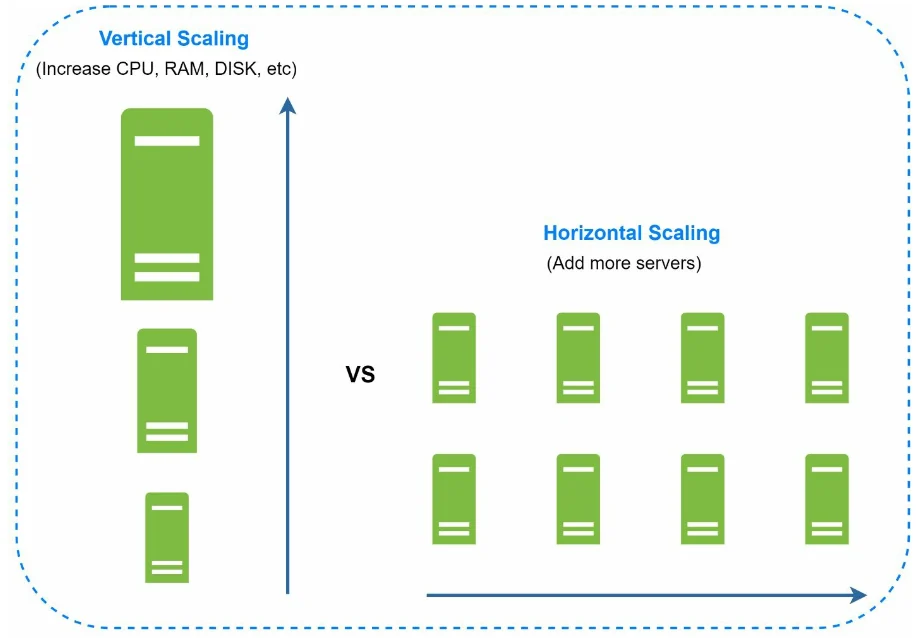
垂直扩展
- 为现有服务器增加更多资源(CPU、内存)。
- 受限于硬件条件,并且缺乏冗余。
水平扩展
- 向资源池中增加更多服务器,更适合大规模系统。
- 使用负载均衡器在服务器之间进行请求路由。
4. 负载均衡器
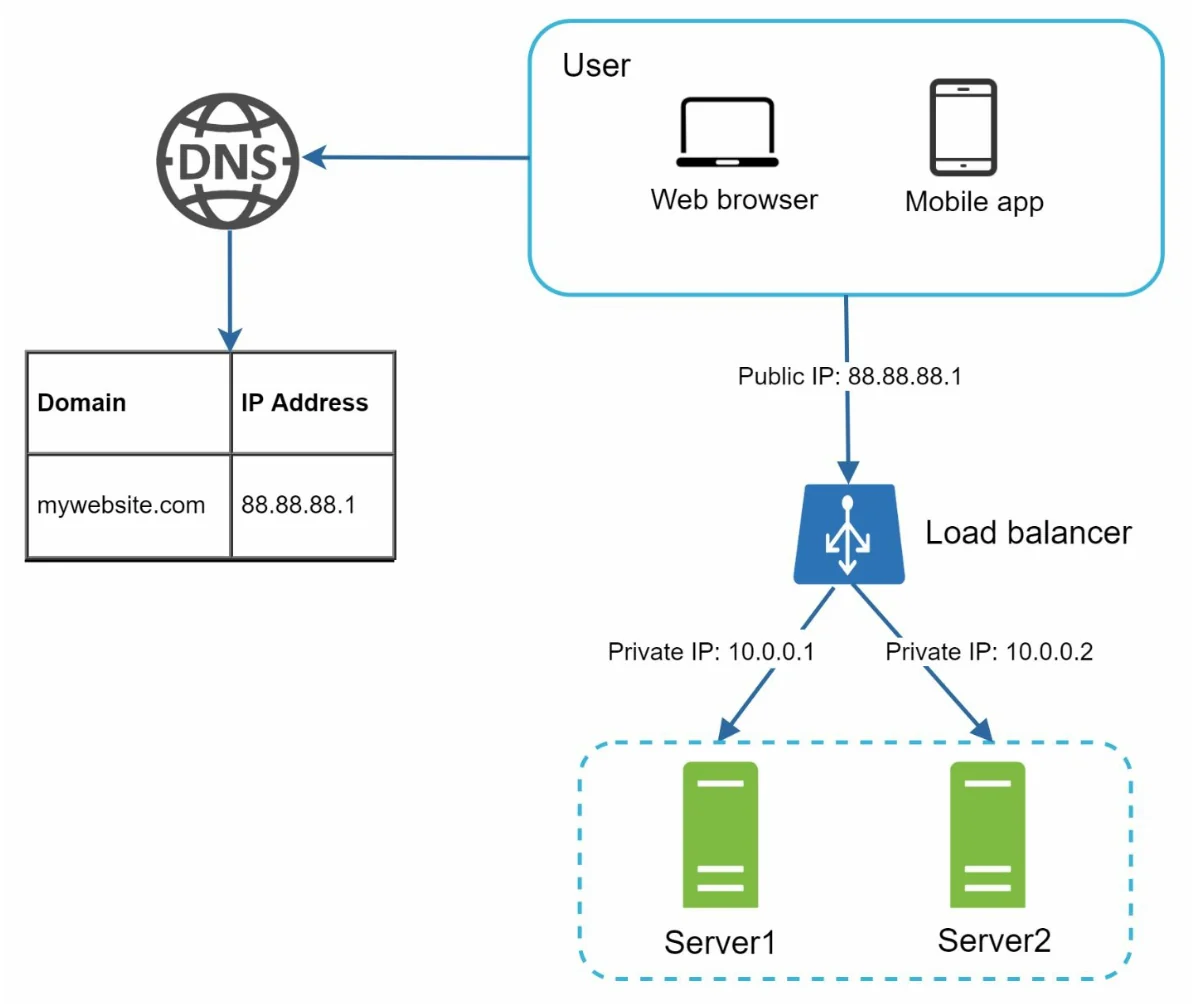
负载均衡器(Load Balancer) 将流量分发到多台服务器上。它的好处包括:
- 冗余:某台服务器下线时,流量会被重新路由。
- 如果服务器 1 下线,所有流量都会被路由到服务器 2。
- 可扩展性:可以方便地增加服务器来应对流量高峰。
- 如果网站流量快速增长,可以继续添加服务器来承接新增的流量。
5. 数据库复制
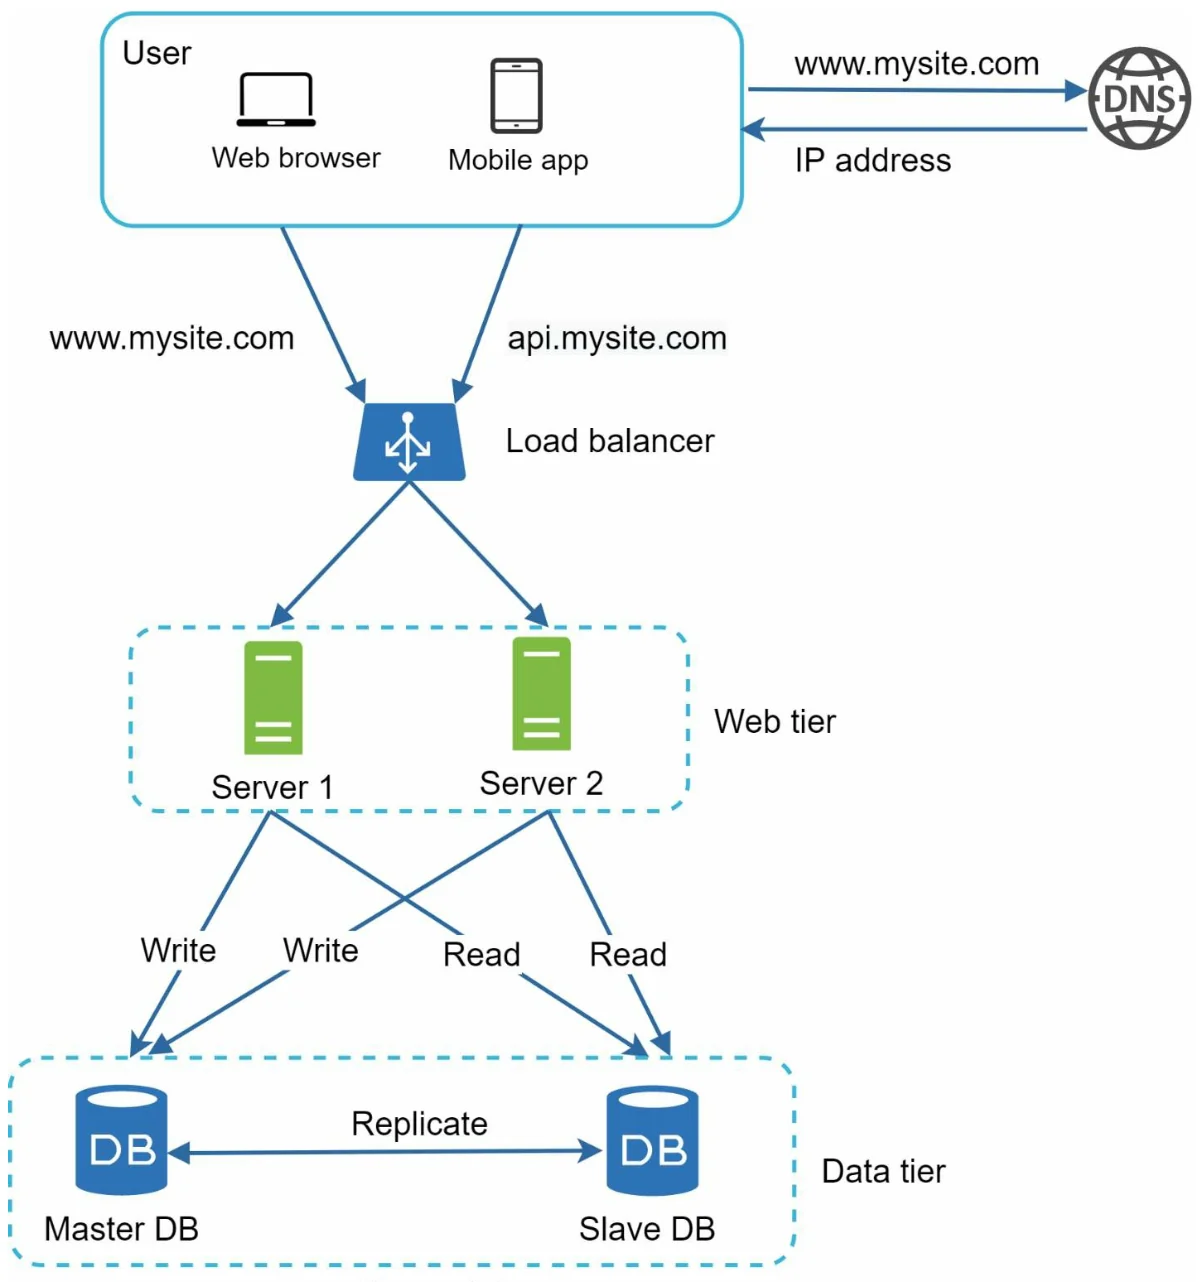
主从模型
- 主数据库: 负责处理写操作。
- 所有修改数据的命令,例如插入、删除或更新,都必须发送到主数据库。
- 从数据库: 负责处理读操作,从而提升性能和可靠性。
- 由于大多数应用的读写比都较高,因此系统中从数据库的数量通常多于主数据库的数量。
好处
- 读操作可以并行执行,从而提升性能。
- 通过冗余实现高可用和数据可靠性。
故障处理
- 如果只有一个从数据库可用,而它下线了,读操作会被临时转发到主数据库。
- 如果有多个从数据库可用,读操作会被重定向到其他健康的从数据库,同时会用一台新服务器替换掉旧的。
- 如果主数据库下线,会有一个从数据库被提升为新的主数据库。
- 在生产系统中,被选中的从数据库上的数据可能不是最新的,因此需要运行数据恢复脚本来补齐数据(多主复制和环形复制等方法也会有帮助)。
6. 缓存
缓存(Cache) 将频繁访问的数据存放在内存中,以降低数据库的负载。缓存层是一个临时的数据存储层,速度比数据库快得多。
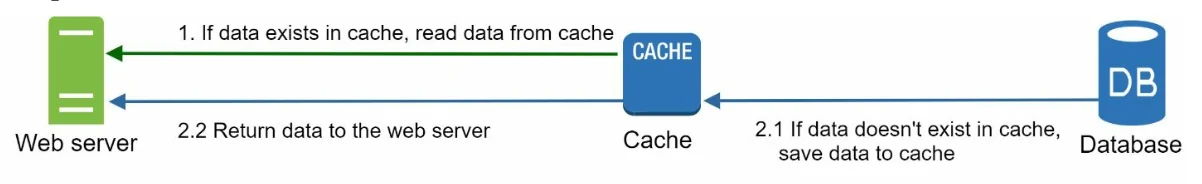
使用缓存的注意事项
- 使用场景:当数据读取频繁而修改不频繁时,可以考虑使用缓存。
- 过期策略: 缓存数据一旦过期,就会从缓存中移除。如果没有过期策略,缓存数据会永久保存在内存中。
- 一致性: 指保持数据存储和缓存之间的同步。由于对数据存储和缓存的数据修改操作不在同一个事务中,因此可能出现不一致。
- 降低故障影响:单台缓存服务器是一个潜在的单点故障(SPOF),建议在不同数据中心部署多台缓存服务器来避免单点故障。
- 淘汰策略::缓存满了之后,需要淘汰一些条目以释放内存。LRU 是最常用的缓存淘汰策略。
7. 内容分发网络(CDN)
CDN 通过在地理上分散的服务器上缓存静态内容(图片、CSS、JavaScript)来缩短加载时间。
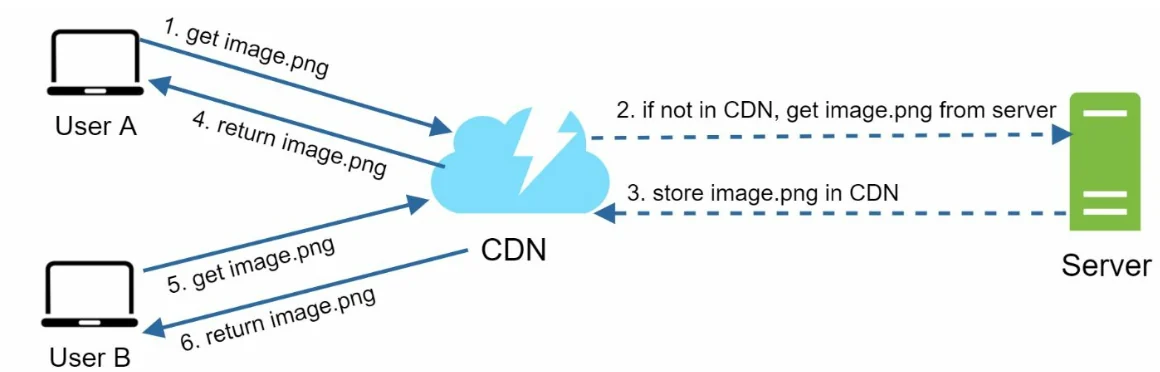
工作流程
- 用户向最近的 CDN 服务器请求内容。
- 如果 CDN 上没有,就从源服务器获取内容并缓存起来。
使用 CDN 的注意事项
- 成本: CDN 由第三方服务商运营,对进出 CDN 的数据传输收费。
- 缓存过期: 缓存过期时间既不能太长,也不能太短。
- CDN 回退: 如果 CDN 出现临时故障,客户端应该能够检测到问题,并改为从源站请求资源。
- 使文件失效: 如果文件有更新,应使缓存失效,让其指向更新后的文件。
8. 无状态 Web 层
把会话数据移到共享的数据存储中,Web 服务器就变成了无状态的。这样可以:
- 更容易进行水平扩展。
- 根据流量进行自动扩缩容。
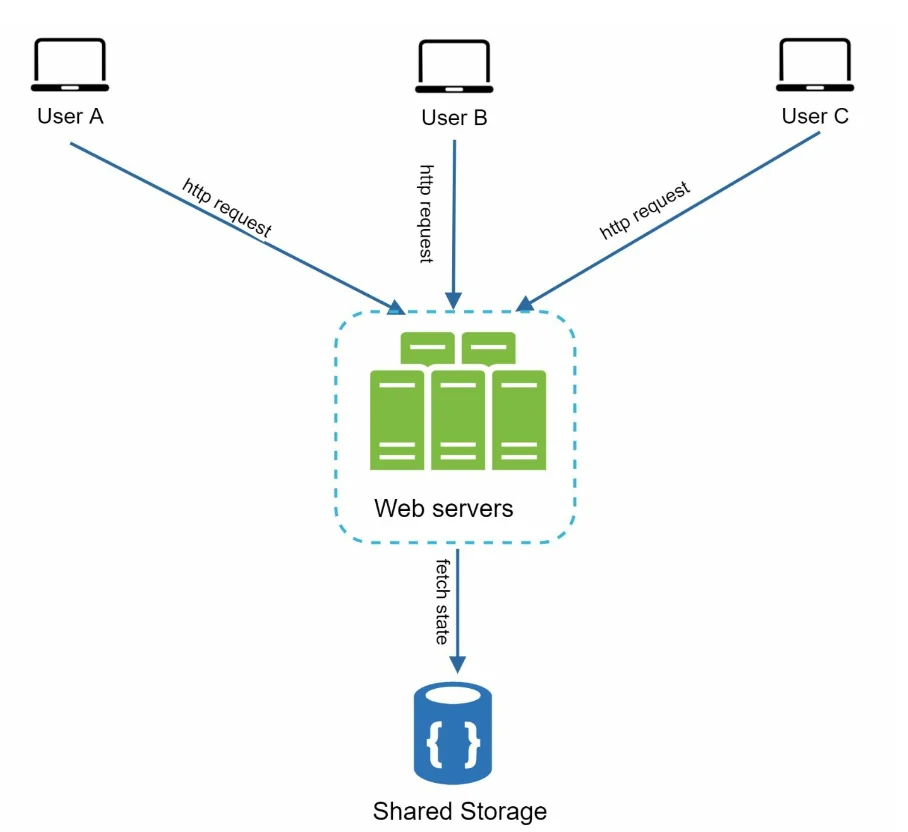
9. 多数据中心部署
跨多个数据中心部署可以提升可用性并降低延迟。相关策略包括:
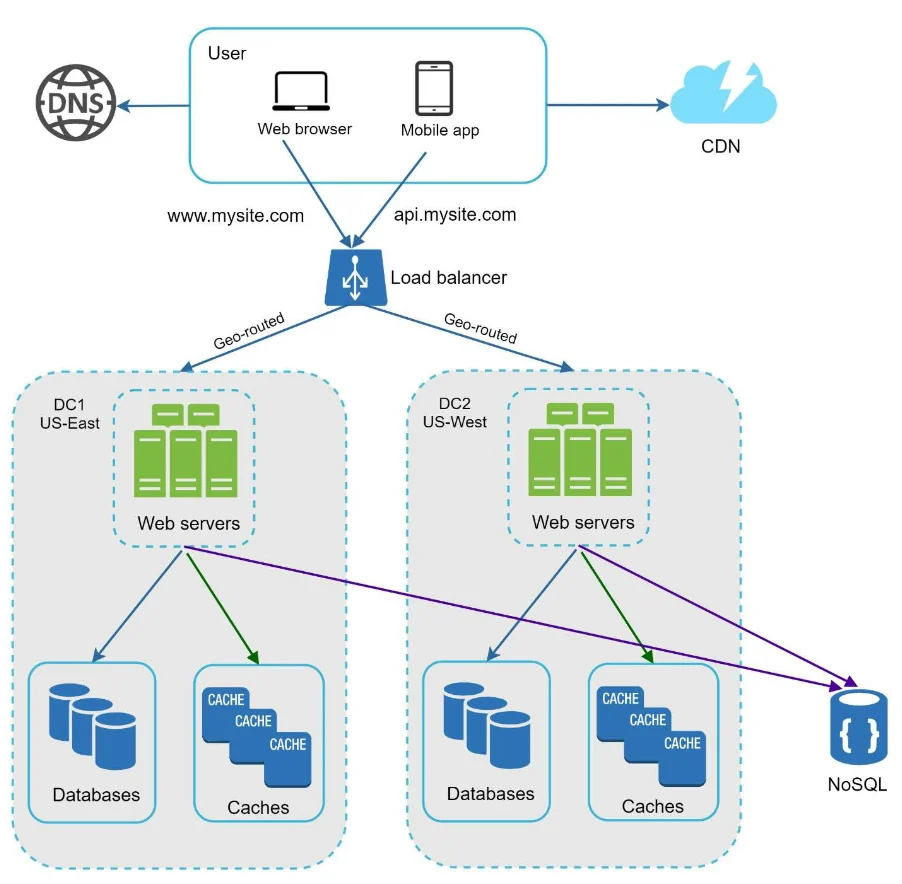
- GeoDNS 路由: 将用户引导到最近的数据中心。
- 数据复制: 在各数据中心之间同步数据,以避免不一致。
关键注意事项
- 流量重定向: 需要有效的工具把流量引导到正确的数据中心。
- 数据同步: 一种常见策略是在多个数据中心之间复制数据。
- 测试与部署: 自动化部署工具对于让所有数据中心的服务保持一致至关重要。
10. 消息队列
消息队列(Message Queue) 是一个持久化的组件,存储在内存中,用于支持异步通信。它充当缓冲区,并负责分发异步请求。
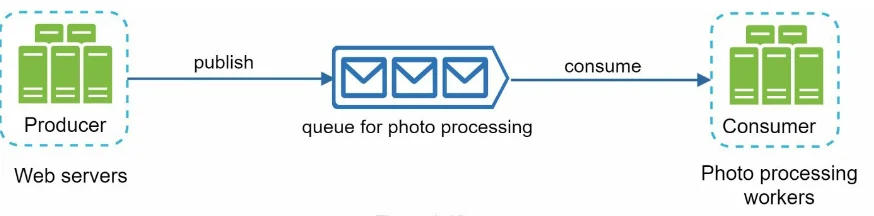
- 输入服务称为生产者(producer)或发布者(publisher),它们创建消息并发布到消息队列。
- 其他服务称为消费者(consumer)或订阅者(subscriber),它们连接到队列,并执行消息所定义的操作。
11. 日志、指标与自动化
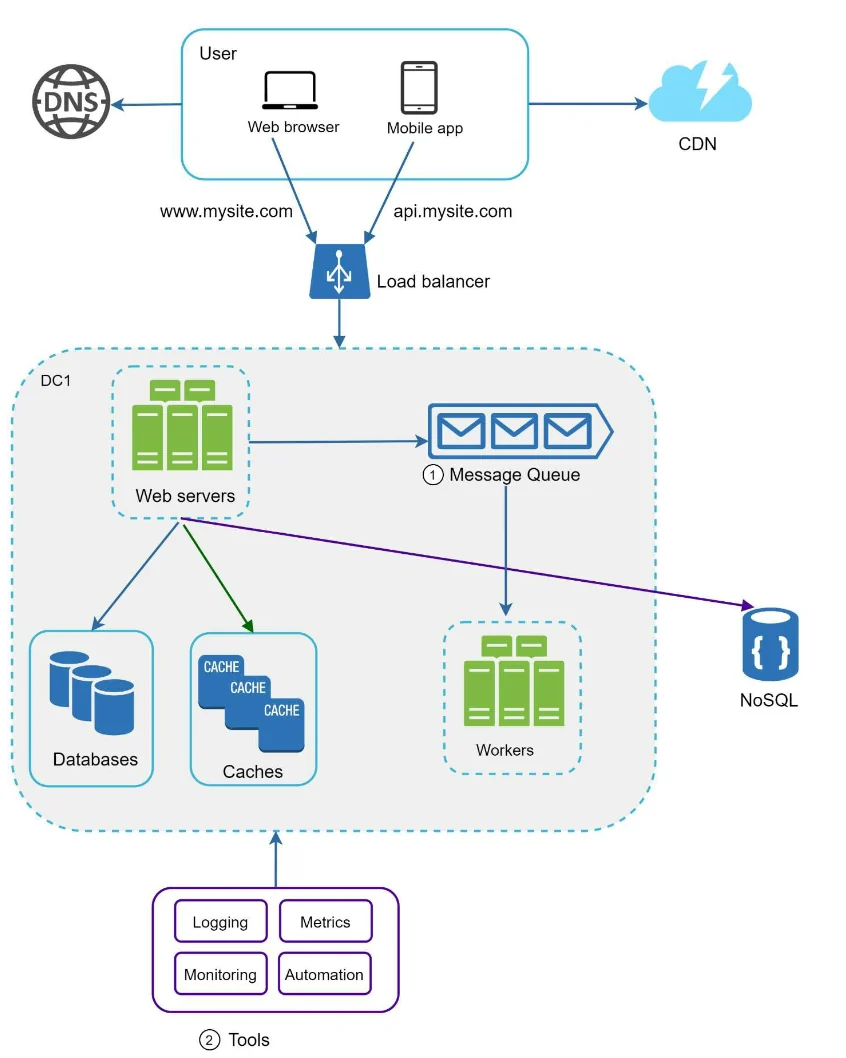
重要性
- 日志: 跟踪错误和系统健康状况。
- 指标: 提供关于性能和用户活动的洞察。
- 自动化: 简化测试、部署和扩展流程。
12. 数据库扩展
垂直扩展
- 增加硬件资源,但存在物理和成本上的限制。
- 有多个缺点:
- 单点故障的风险更大。
- 垂直扩展的总体成本很高。
水平扩展(分片)
- 使用键(例如
user_id)把数据划分到多个分片上。- 分片(Sharding)把大型数据库拆分成更小、更易于管理的部分,这些部分称为分片(shard)。
- 每个分片的表结构(schema)相同,但每个分片上的实际数据是该分片独有的。
- 实施分片策略时,分片键至关重要。选择分片键时,重要的是选一个能让数据均匀分布的键。
挑战
-
数据重新分片: 以下情况需要对数据重新分片:
- 由于数据快速增长,单个分片已无法容纳更多数据。
- 由于数据分布不均,某些分片可能会比其他分片更快地被耗尽。
- 可以使用一致性哈希(Consistent Hashing)来解决这些问题。
-
名人问题: 对某个特定分片的过度访问可能导致服务器过载。
- 为了解决这个问题,我们可能需要为每位名人单独分配一个分片。
-
连接与反规范化: 数据库一旦被分片到多台服务器上,就很难跨分片执行连接(join)操作。
- 一种常见的变通方法是对数据库进行反规范化(de-normalization),让查询可以在单张表中完成。
总结
关键要点
- 保持 Web 层无状态。
- 在每一层都构建冗余。
- 使用缓存和 CDN 优化性能。
- 通过分片扩展数据层。
- 解耦各组件以获得灵活性。
本章为构建能够支撑数百万用户的可扩展系统打下了坚实的基础。