第 25 章 实时游戏排行榜
引言
我们要为一款在线手机游戏设计一个排行榜(Leaderboard):
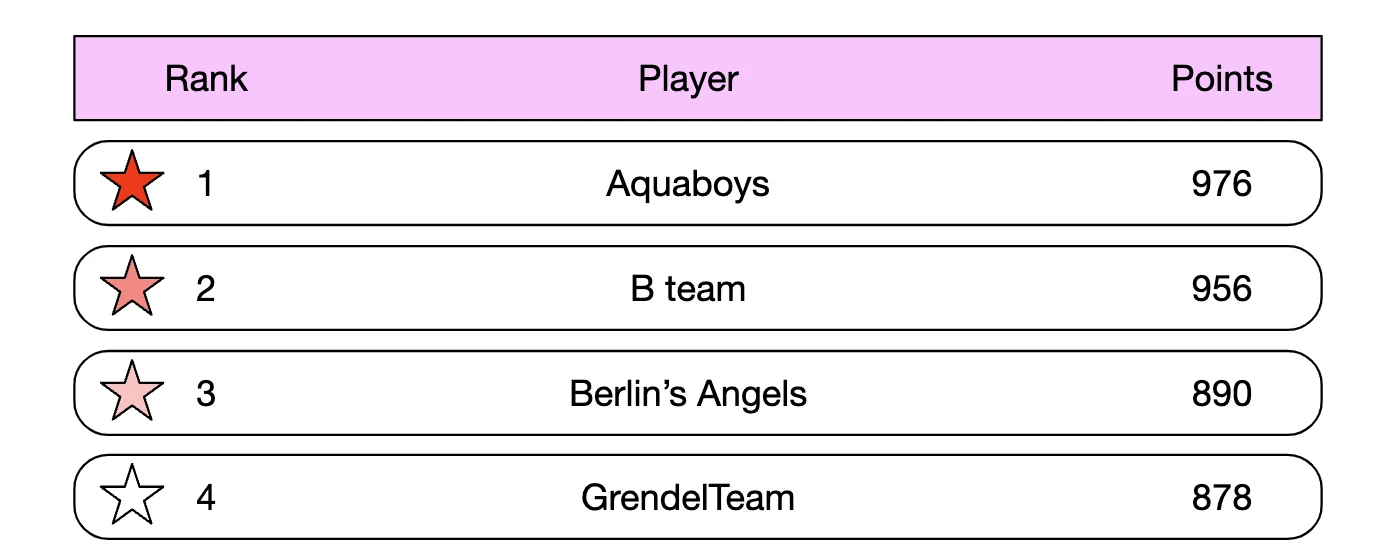
第 1 步:理解问题并确定设计范围
- 候选人:排行榜的分数是怎么计算的?
- 面试官:用户每赢一场比赛就得一分。
- 候选人:所有玩家都会进入排行榜吗?
- 面试官:是的。
- 候选人:排行榜是否和某个时间段相关联?
- 面试官:每个月会开始一场新的锦标赛,同时开启一个新的排行榜。
- 候选人:可以假设我们只关心前 10 名用户吗?
- 面试官:我们要展示前 10 名用户,以及某个特定用户的名次。如果时间允许,还可以讨论如何展示排行榜中某个用户前后的用户。
- 候选人:一场锦标赛有多少用户?
- 面试官:500 万 DAU,2500 万 MAU。
- 候选人:一场锦标赛中平均会进行多少场比赛?
- 面试官:每个玩家平均每天玩 10 场。
- 候选人:如果两个玩家分数相同,怎么确定名次?
- 面试官:这种情况下他们的名次相同。如果时间允许,可以讨论如何打破平局。
- 候选人:排行榜需要实时吗?
- 面试官:是的,我们希望展示实时结果,或者尽可能接近实时。展示批量处理的历史结果是不行的。
功能需求
- 在排行榜上展示前 10 名玩家
- 展示某个用户的具体名次
- 展示排在给定用户前后各四位的用户(加分项)
非功能需求
- 分数实时更新
- 分数更新实时反映在排行榜上
- 通用的可扩展性、可用性和可靠性
粗略估算(Back-of-the-envelope Estimation)
如果有 5000 万 DAU,且游戏玩家在 24 小时内均匀分布,那么平均每秒会有 50 个用户。 不过,由于分布通常并不均匀,我们可以估计峰值在线用户为每秒 250 个。
用户得分的 QPS:平均每天 10 场游戏,50 用户/秒 * 10 = 500 QPS。峰值 QPS = 2500。
获取前 10 名排行榜的 QPS:假设用户平均每天打开一次,QPS 为 50。
第 2 步:提出高层设计并获得认可
API 设计
我们需要的第一个 API 用于更新用户的分数:
POST /v1/scores
这个 API 接收两个参数:user_id 和赢得一场游戏所获得的 points。
这个 API 只应允许游戏服务器访问,而不对终端客户端开放。
下一个 API 用于获取排行榜的前 10 名玩家:
GET /v1/scores
响应示例:
{
  "data": [
    {
      "user_id": "user_id1",
      "user_name": "alice",
      "rank": 1,
      "score": 12543
    },
    {
      "user_id": "user_id2",
      "user_name": "bob",
      "rank": 2,
      "score": 11500
    }
  ],
  ...
  "total": 10
}
你还可以获取某个特定用户的分数:
GET /v1/scores/{:user_id}
响应示例:
{
    "user_info": {
        "user_id": "user5",
        "score": 1000,
        "rank": 6,
    }
}
高层架构
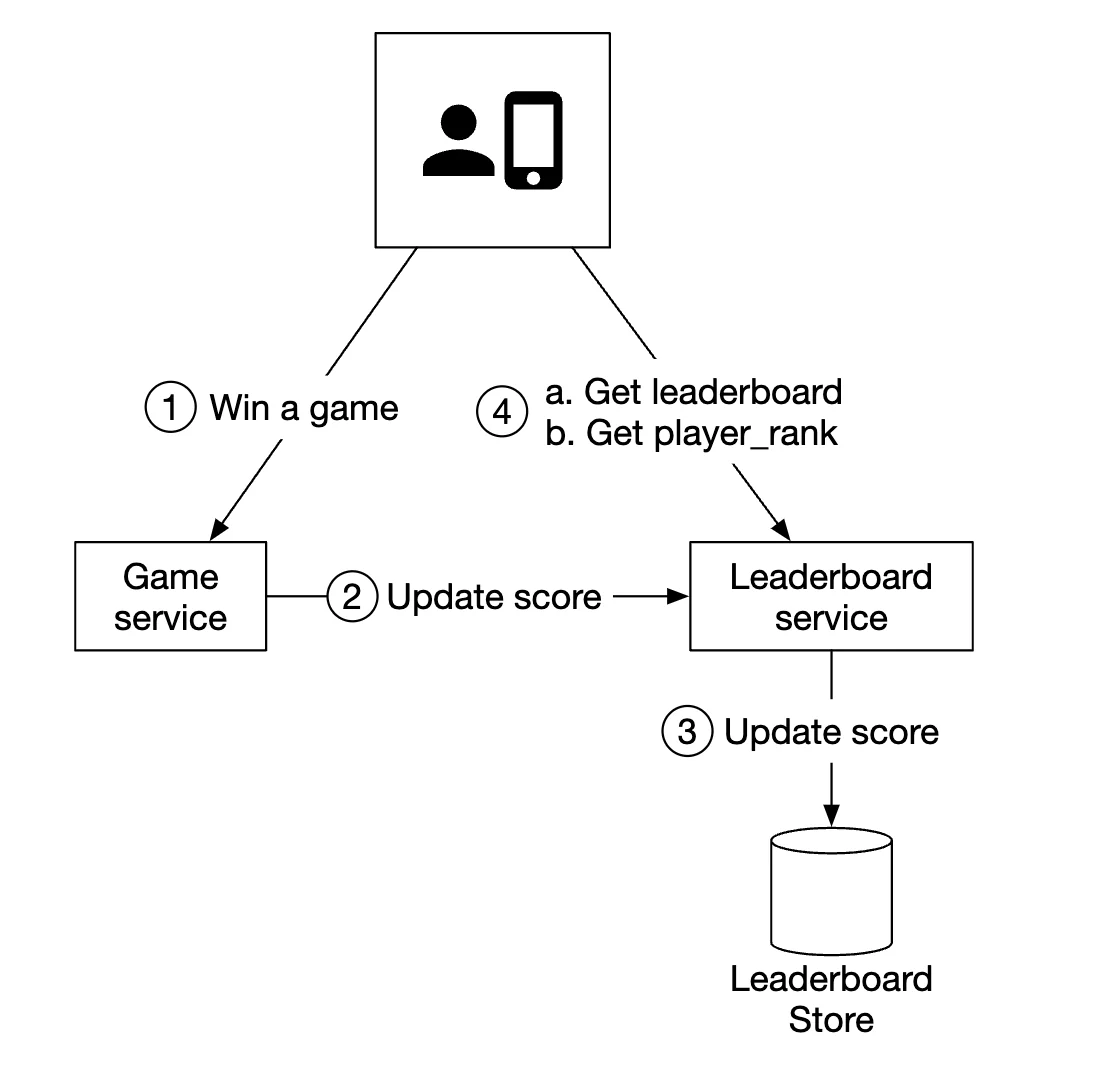
- 当玩家赢得一场游戏时,客户端向游戏服务发送请求
- 游戏服务校验这次胜利是否有效,然后调用排行榜服务更新玩家的分数
- 排行榜服务在排行榜存储中更新该用户的分数
- 玩家调用排行榜服务获取排行榜数据,例如前 10 名玩家以及该玩家的名次
我们还考虑过另一种设计:由客户端直接在排行榜服务中更新自己的分数:
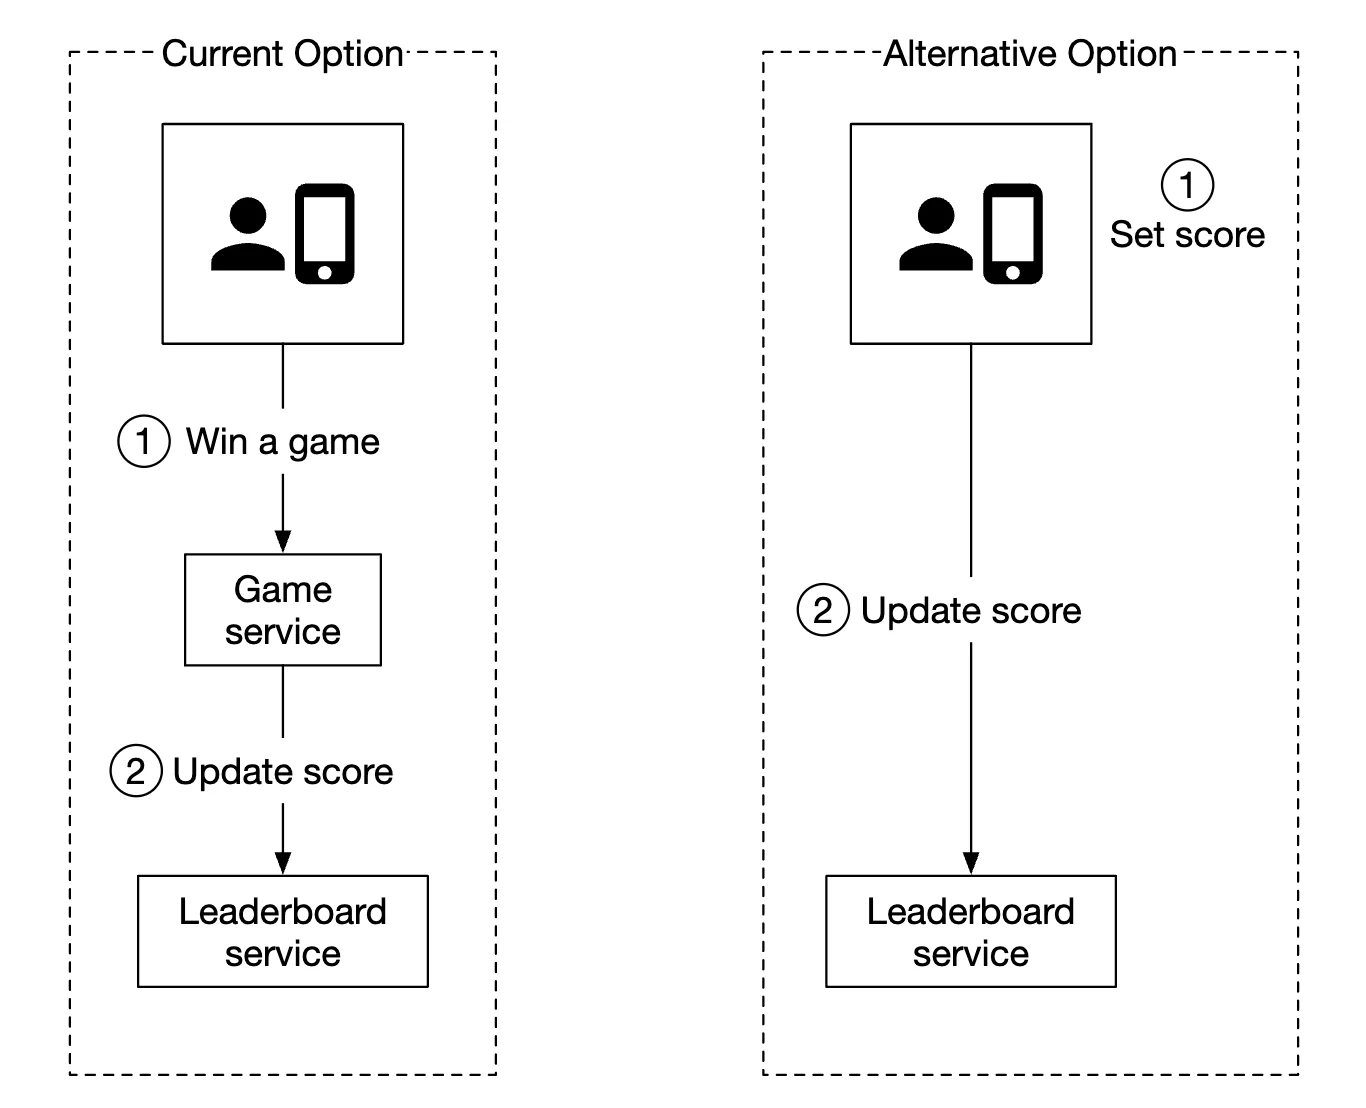
这种方案并不安全,因为它容易遭受中间人攻击(Man-in-the-middle Attack)。玩家可以架设一个代理,随意修改自己的分数。
另外需要注意的一点是,对于由服务器管理游戏逻辑的游戏,客户端不需要显式调用服务器来记录自己的胜利。 服务器会根据游戏逻辑自动替它们完成。
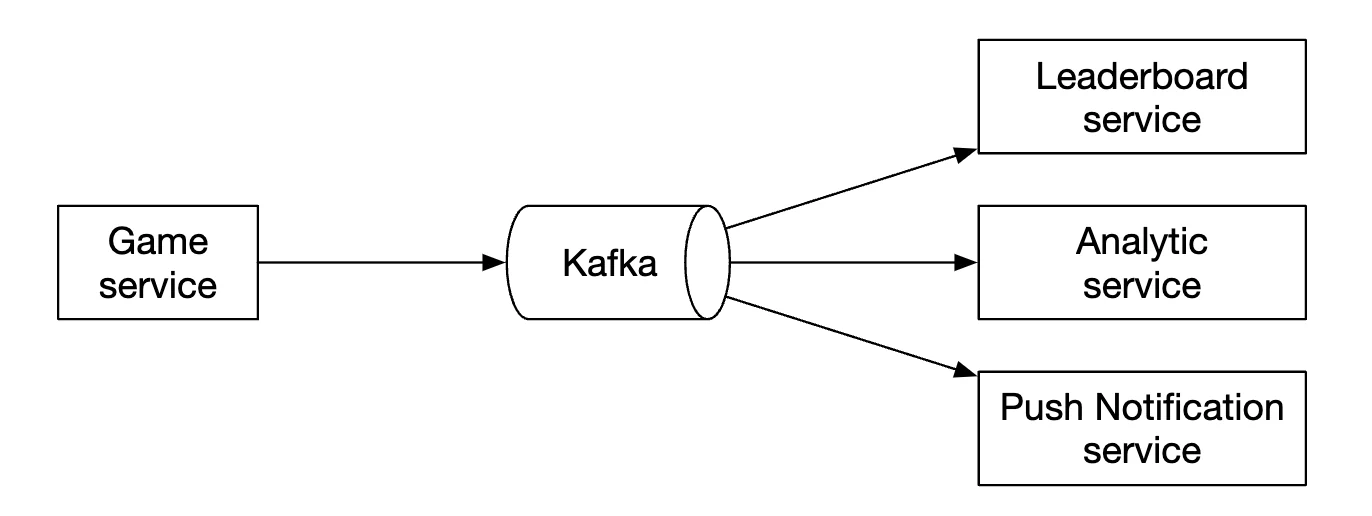
还有一个需要考虑的问题是,是否应该在游戏服务器和排行榜服务之间放一个消息队列(Message Queue)。如果有其他服务关心游戏结果,这会很有用;但到目前为止,面试中并没有明确提出这个需求,因此设计中没有包含它:
数据模型
我们来讨论一下存储排行榜数据的几种方案:关系型数据库、Redis 和 NoSQL。
NoSQL 方案会在深入设计部分讨论。
关系型数据库方案
如果规模无关紧要,用户也没那么多,关系型数据库就能很好地满足我们的需求。
我们可以从一张简单的排行榜表开始,每个月一张(个人注:这样做没有道理。完全可以只加一个 month 列,省去每个月维护新表的麻烦):
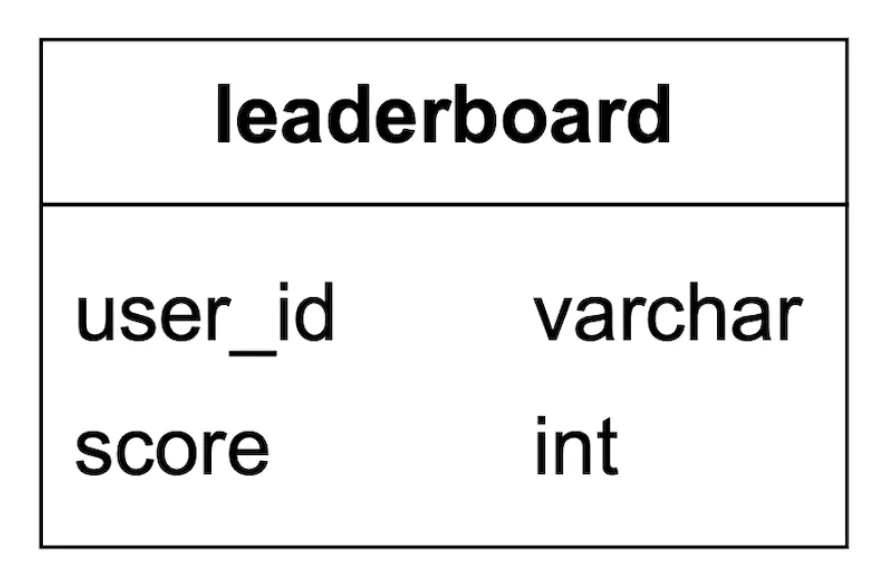
表中还可以包含其他数据,但它们与我们要执行的查询无关,所以这里省略了。
当用户赢得一分时会发生什么?
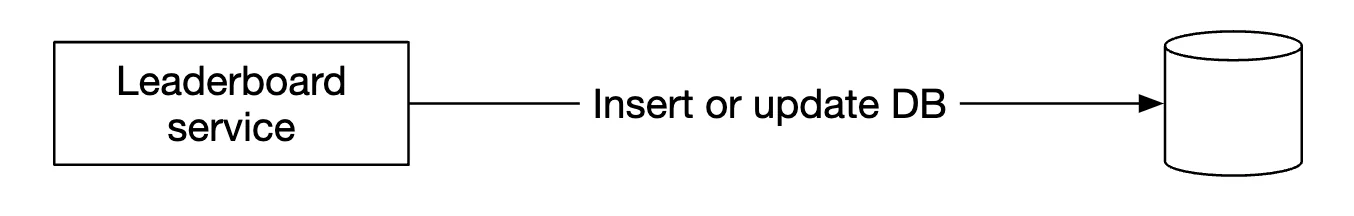
如果用户还不在表中,我们需要先插入:
INSERT INTO leaderboard (user_id, score) VALUES ('mary1934', 1);
后续调用时,只需更新其分数:
UPDATE leaderboard set score=score + 1 where user_id='mary1934';
如何找出排行榜上的头部玩家?
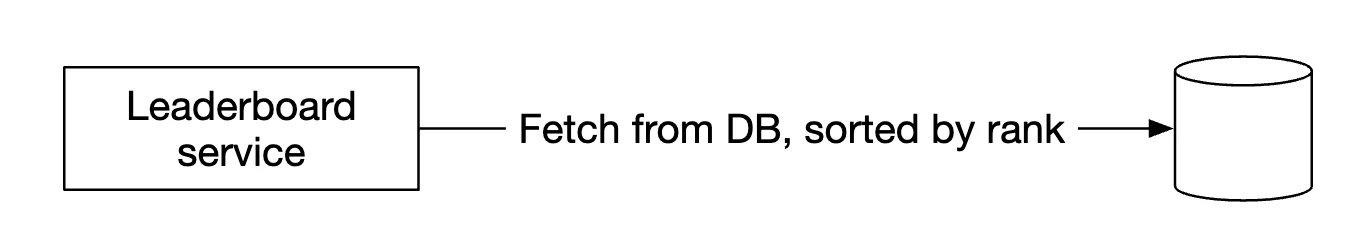
我们可以执行以下查询:
SELECT (@rownum := @rownum + 1) AS rank, user_id, score
FROM leaderboard
ORDER BY score DESC;
不过这样做性能不好,因为它要进行全表扫描,对数据库表中的所有记录排序。
我们可以给 score 加上索引,并使用 LIMIT 操作来避免扫描全部数据,从而进行优化:
SELECT (@rownum := @rownum + 1) AS rank, user_id, score
FROM leaderboard
ORDER BY score DESC
LIMIT 10;
然而,如果用户并不在排行榜的头部,而你又想确定他的名次,这种方法的扩展性就不好了。
Redis 方案
我们希望找到一种方案,即使面对数百万玩家也能运行良好,而不必退回到复杂的数据库查询。
Redis 是一个内存数据存储,由于在内存中运行,它速度很快,而且拥有一种恰好满足我们需求的数据结构:有序集合(Sorted Set)。
有序集合是一种类似于编程语言中集合的数据结构,它能让数据按给定的标准保持有序。 在内部,它由两部分实现:一个哈希表,用于维护键(user_id)和值(score)之间的映射;一个跳表(Skip List),用于按排序顺序把分数映射到用户:
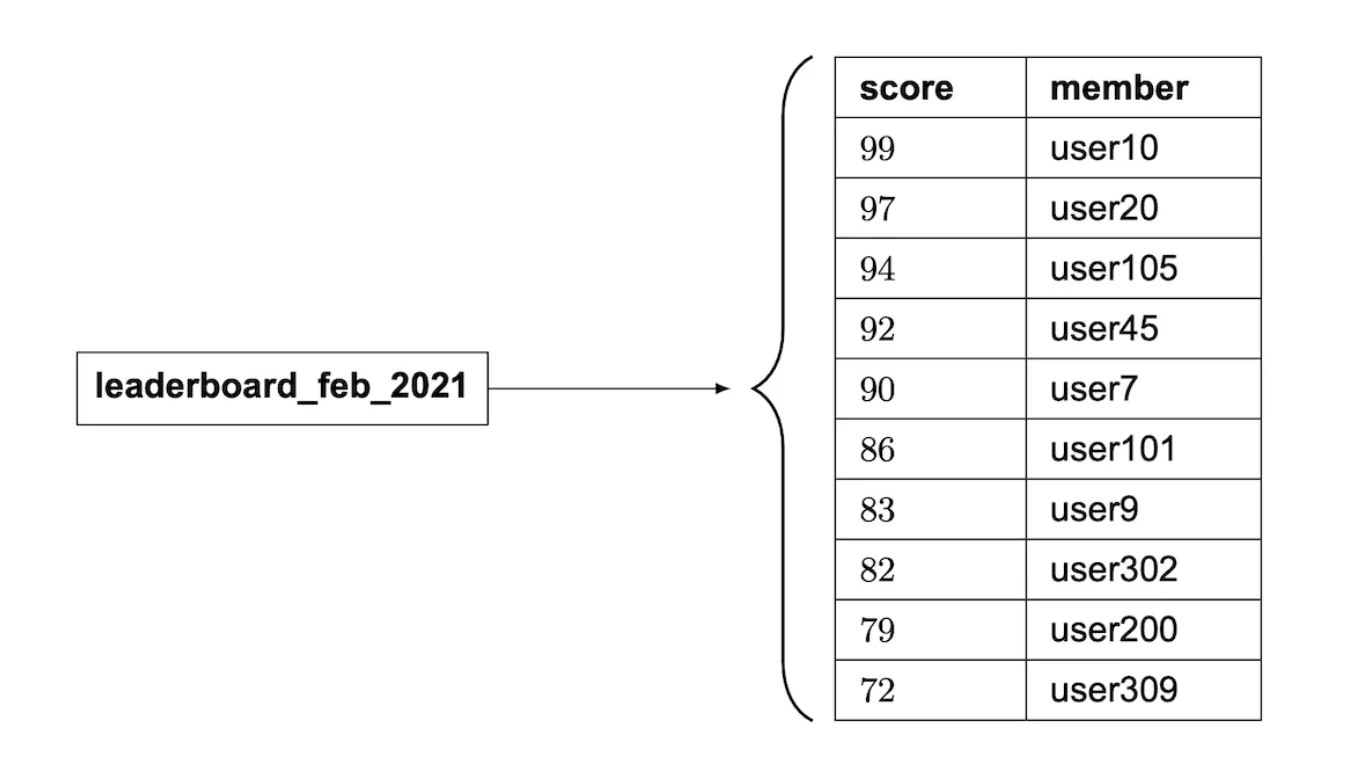
跳表是怎么工作的?
- 它是一种支持快速查找的链表
- 它由一个有序链表和多级索引组成
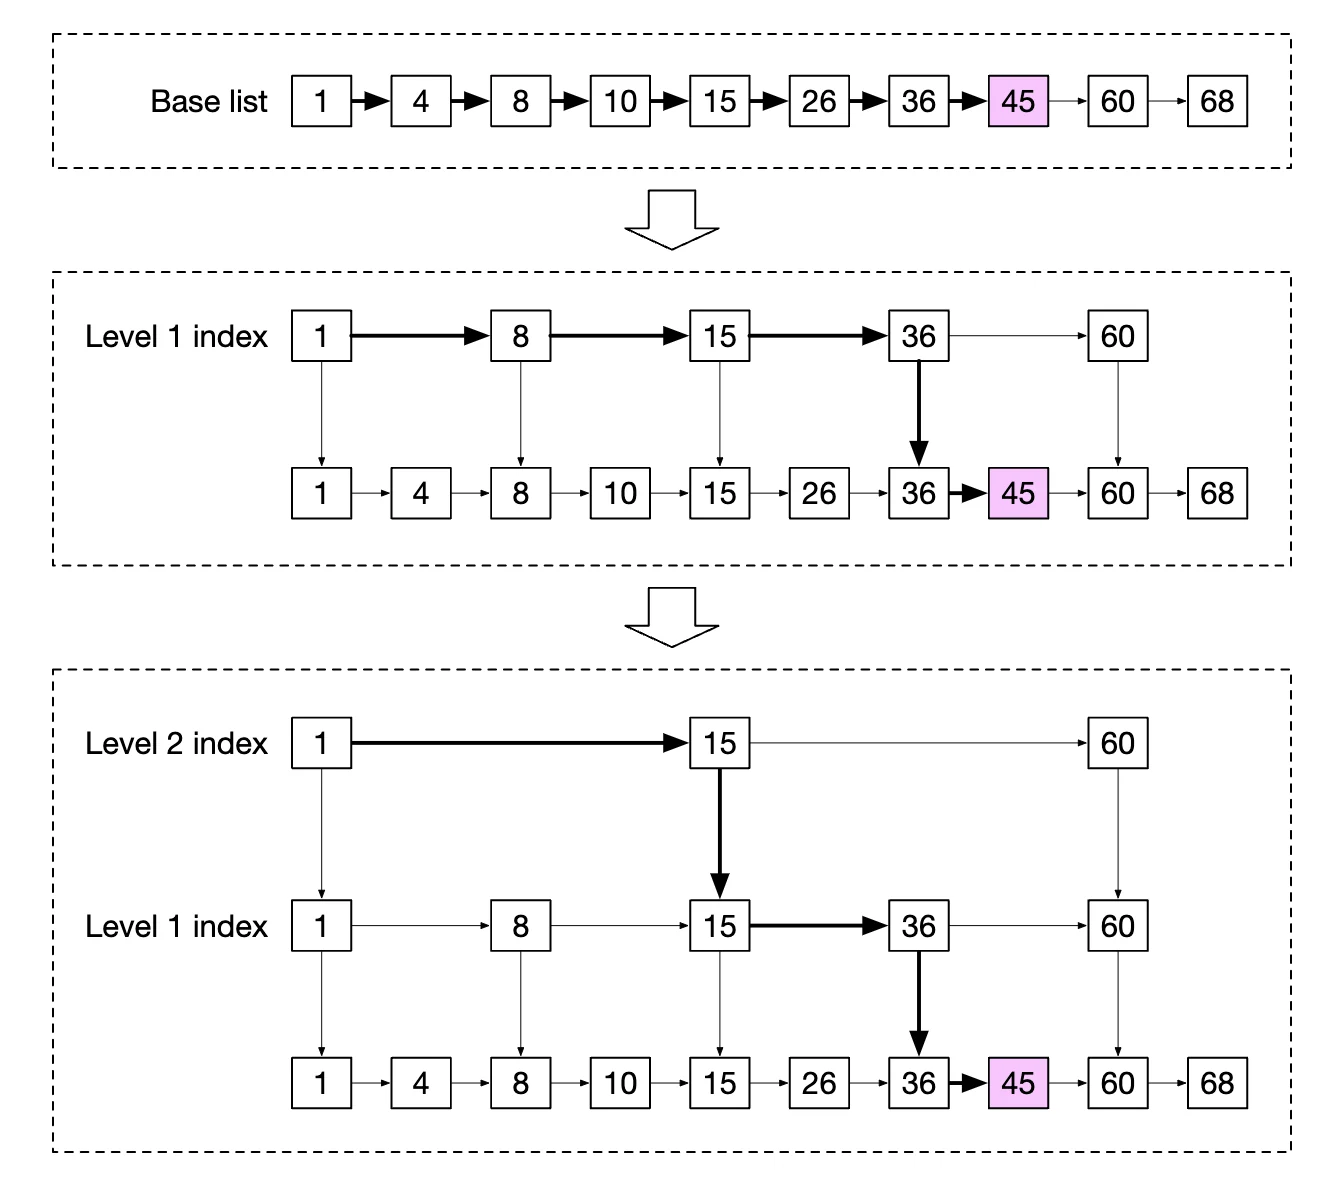
当数据集足够大时,这种结构让我们能够快速查找特定的值。 在下面的例子中(64 个节点),在基础链表中查找给定值需要遍历 62 个节点,而在跳表中只需遍历 11 个节点:
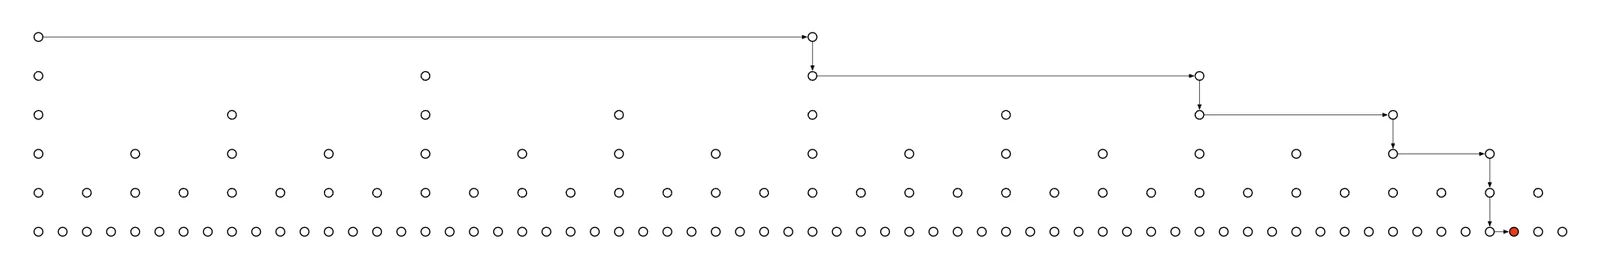
有序集合比关系型数据库性能更好,因为数据始终保持有序,代价是添加和查找操作的复杂度为 O(logN)。
相比之下,下面是在关系型数据库中查找给定用户名次时需要执行的嵌套查询示例:
SELECT *,(SELECT COUNT(*) FROM leaderboard lb2
WHERE lb2.score >= lb1.score) RANK
FROM leaderboard lb1
WHERE lb1.user_id = {:user_id};
在 Redis 中运营排行榜需要哪些操作?
- ZADD:如果用户不存在,就把用户插入集合;否则更新其分数。时间复杂度 O(logN)。
- ZINCRBY:把用户的分数增加给定的数值。如果用户不存在,分数从零开始。时间复杂度 O(logN)。
- ZRANGE/ZREVRANGE:获取按分数排序的一段用户。可以指定顺序(ASC/DESC)、偏移量和结果数量。时间复杂度 O(logN+M),其中 M 为结果数量。
- ZRANK/ZREVRANK:按 ASC/DESC 顺序获取给定用户的位置(名次)。时间复杂度 O(logN)。
当用户得到一分时会发生什么?
ZINCRBY leaderboard_feb_2021 1 'mary1934'
每个月都会创建一个新的排行榜,旧的排行榜则被移到历史存储中。
当用户获取前 10 名玩家时会发生什么?
ZREVRANGE leaderboard_feb_2021 0 9 WITHSCORES
结果示例:
[(user2,score2),(user1,score1),(user5,score5)...]
用户获取自己在排行榜上的位置又是怎样的?
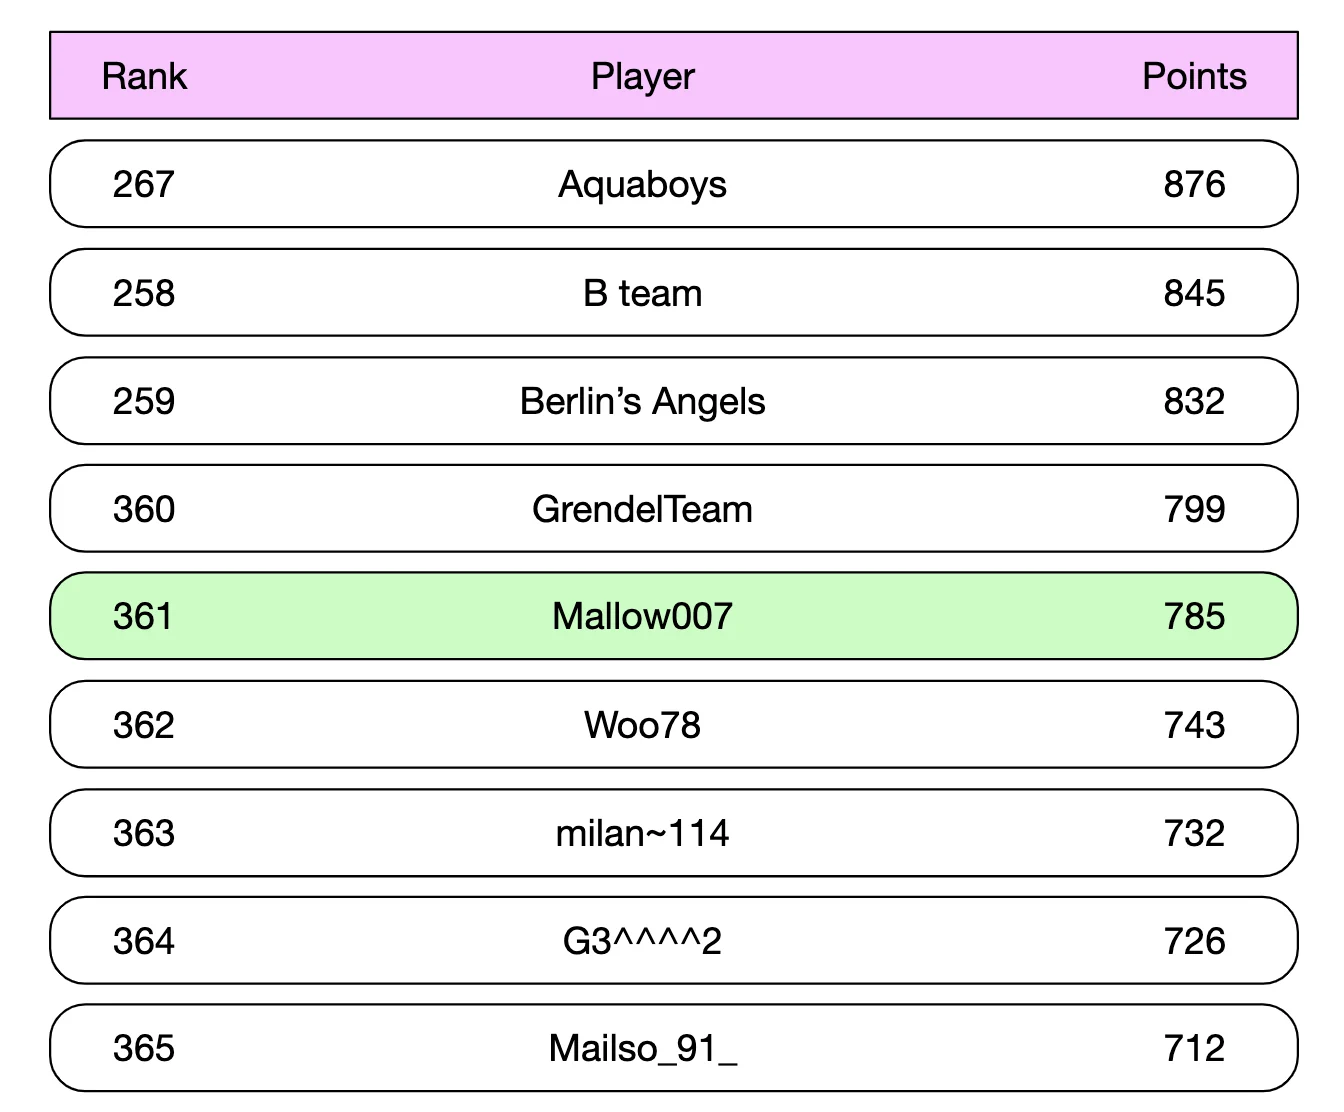
在已知用户排行榜位置的前提下,用下面的查询就能轻松实现:
ZREVRANGE leaderboard_feb_2021 357 365
用户的位置可以通过 ZREVRANK <user-id> 获取。
我们来看看存储需求是多少:
- 假设最坏情况下,全部 2500 万 MAU 都在某个月参与了游戏
- ID 是 24 个字符的字符串,分数是 16 位整数,我们需要 26 字节 * 2500 万 = 约 650MB 的存储
- 即使因为跳表的开销把存储成本翻倍,也依然可以轻松放进一个现代 Redis 集群
另一个需要考虑的非功能需求是支持每秒 2500 次更新。这完全在单台 Redis 服务器的能力范围之内。
其他注意事项:
- 可以启动一个 Redis 副本(Replica),避免 Redis 服务器崩溃时丢失数据
- 仍然可以利用 Redis 持久化,以便在崩溃时不丢失数据
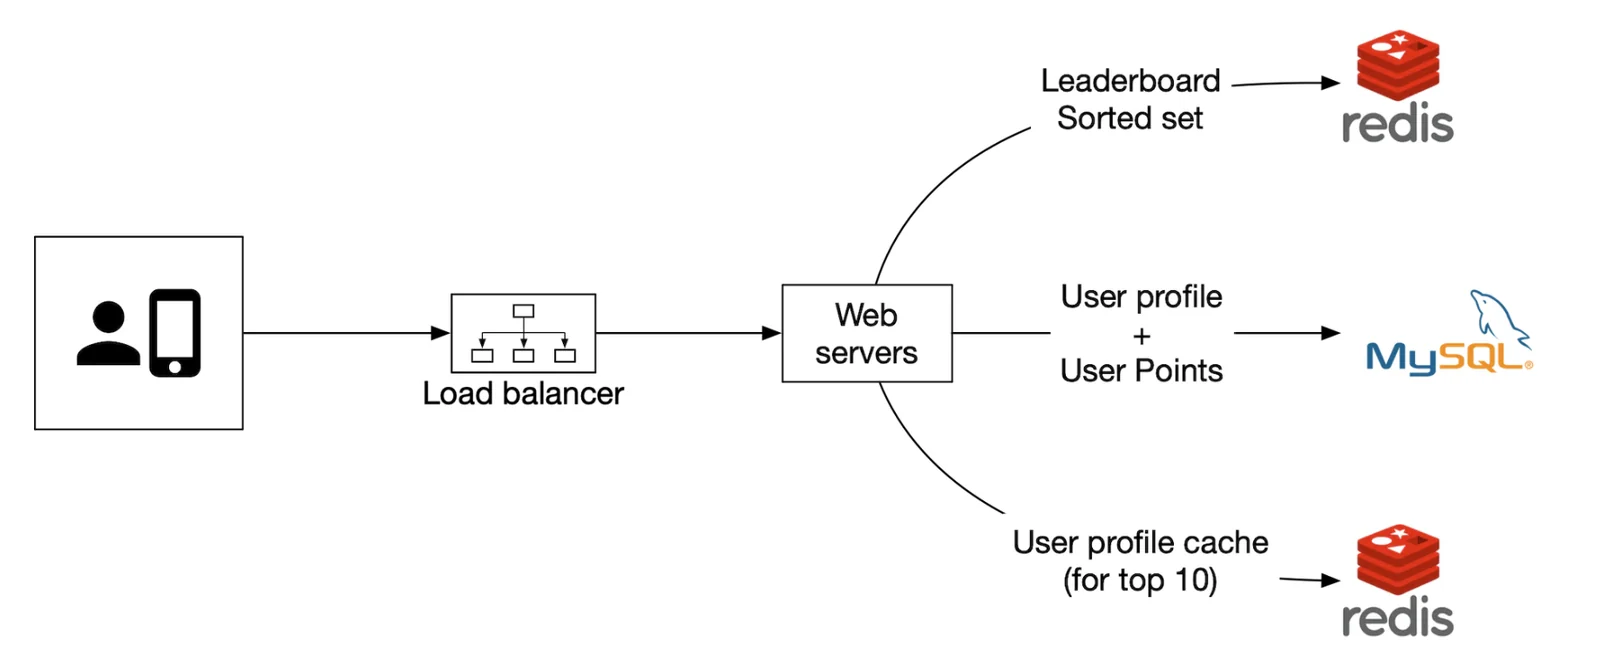
- 我们需要在 MySQL 中建两张辅助表:一张用于获取用户详情,例如用户名、显示名称等;另一张用于记录诸如用户何时赢得了一场游戏之类的信息
- MySQL 中的第二张表可以在基础设施发生故障时用于重建排行榜
- 作为一项小的性能优化,可以缓存前 10 名玩家的用户详情,因为它们会被频繁访问
第 3 步:深入设计
是否使用云服务提供商
我们既可以选择自己部署和管理服务,也可以使用云服务提供商替我们管理。
如果选择自己管理服务,我们会用 Redis 存储排行榜数据,用 MySQL 存储用户资料;如果想扩展数据库,还可能为用户资料加一层缓存:
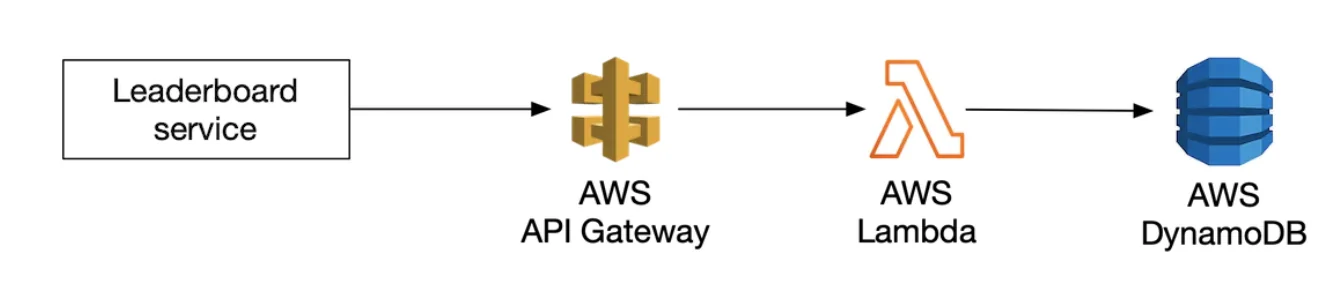
或者,我们可以利用云服务替我们管理很多服务。例如,可以使用 AWS API Gateway 把 API 调用路由到 AWS Lambda 函数:
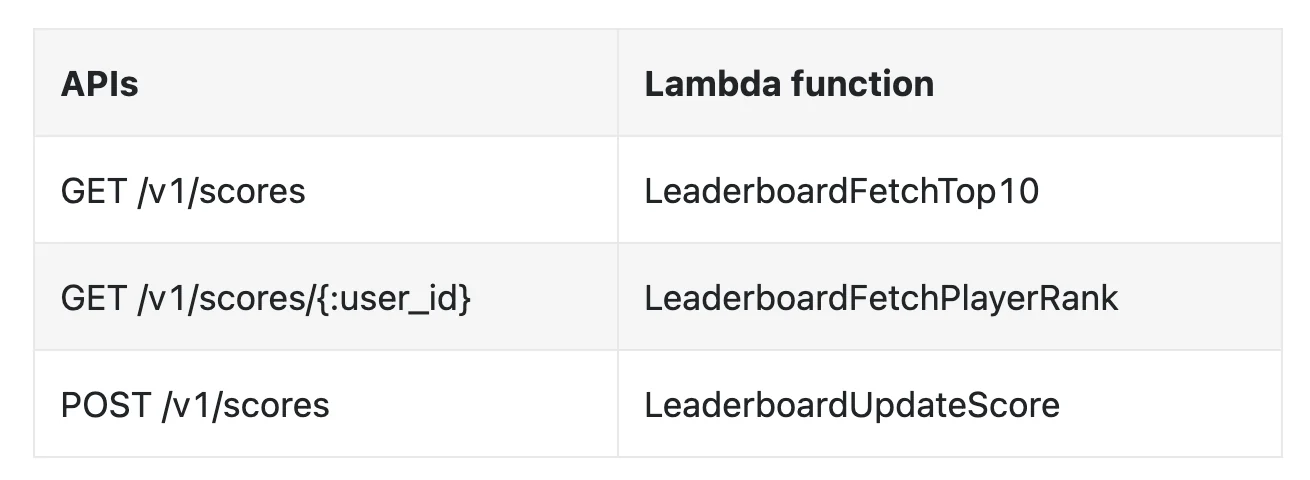
AWS Lambda 让我们无需自己管理或配置服务器就能运行代码。它只在需要时运行,并且会自动扩展。
用户得分的示例:
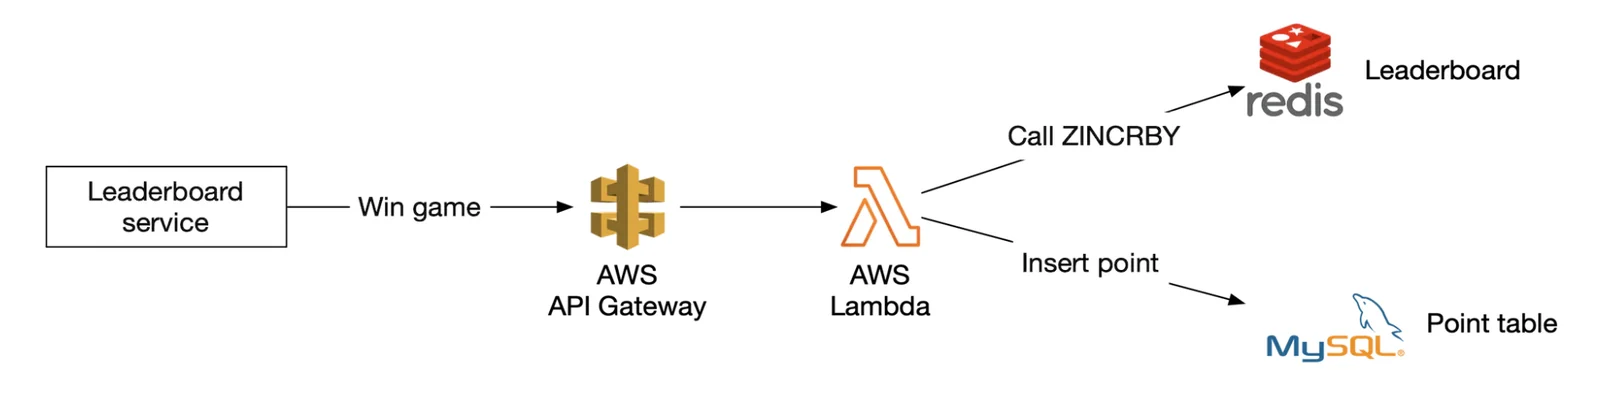
用户获取排行榜的示例:
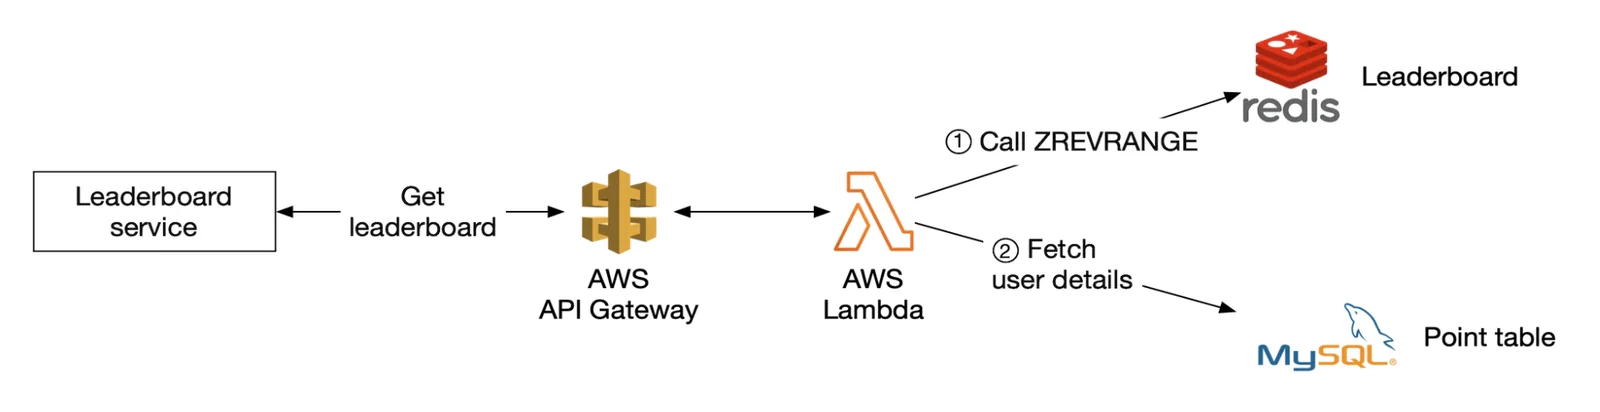
Lambda 是无服务器架构(Serverless Architecture)的一种实现。我们不需要管理扩缩容和环境配置。
如果我们从零开始构建这款游戏,作者推荐采用这种方案。
扩展 Redis
在 500 万 DAU 的情况下,无论从存储还是 QPS 的角度看,单个 Redis 实例都足以应付。
但是,如果设想用户量增长 10 倍,达到 5 亿 DAU,那么就需要 65GB 的存储,QPS 也会上升到 25 万。
这样的规模就需要分片(Sharding)了。
一种实现方式是对数据做范围分区(Range Partitioning):
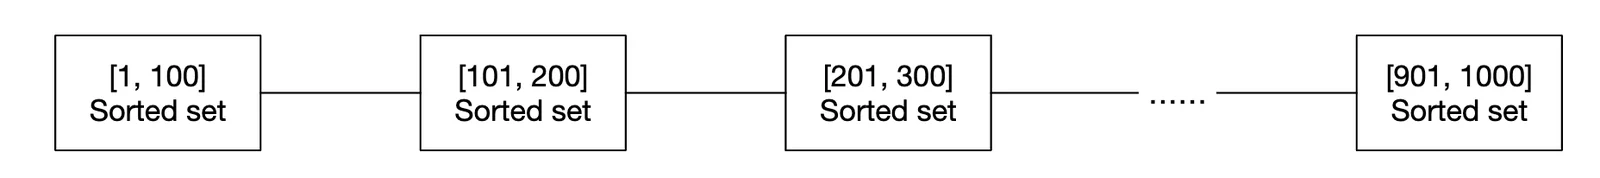
在这个例子中,我们按用户的分数分片。user_id 与分片之间的映射由应用代码维护。 这个映射本身可以存放在 MySQL 中,也可以存放在另一个缓存中。
要获取前 10 名玩家,只需查询分数最高的分片([900-1000])。
要获取用户的名次,我们需要先计算该用户在其所在分片内的名次,再加上其他分片中分数更高的所有用户数量。 后者是 O(1) 操作,因为每个分片的总记录数可以通过 info keyspace 命令快速获取。
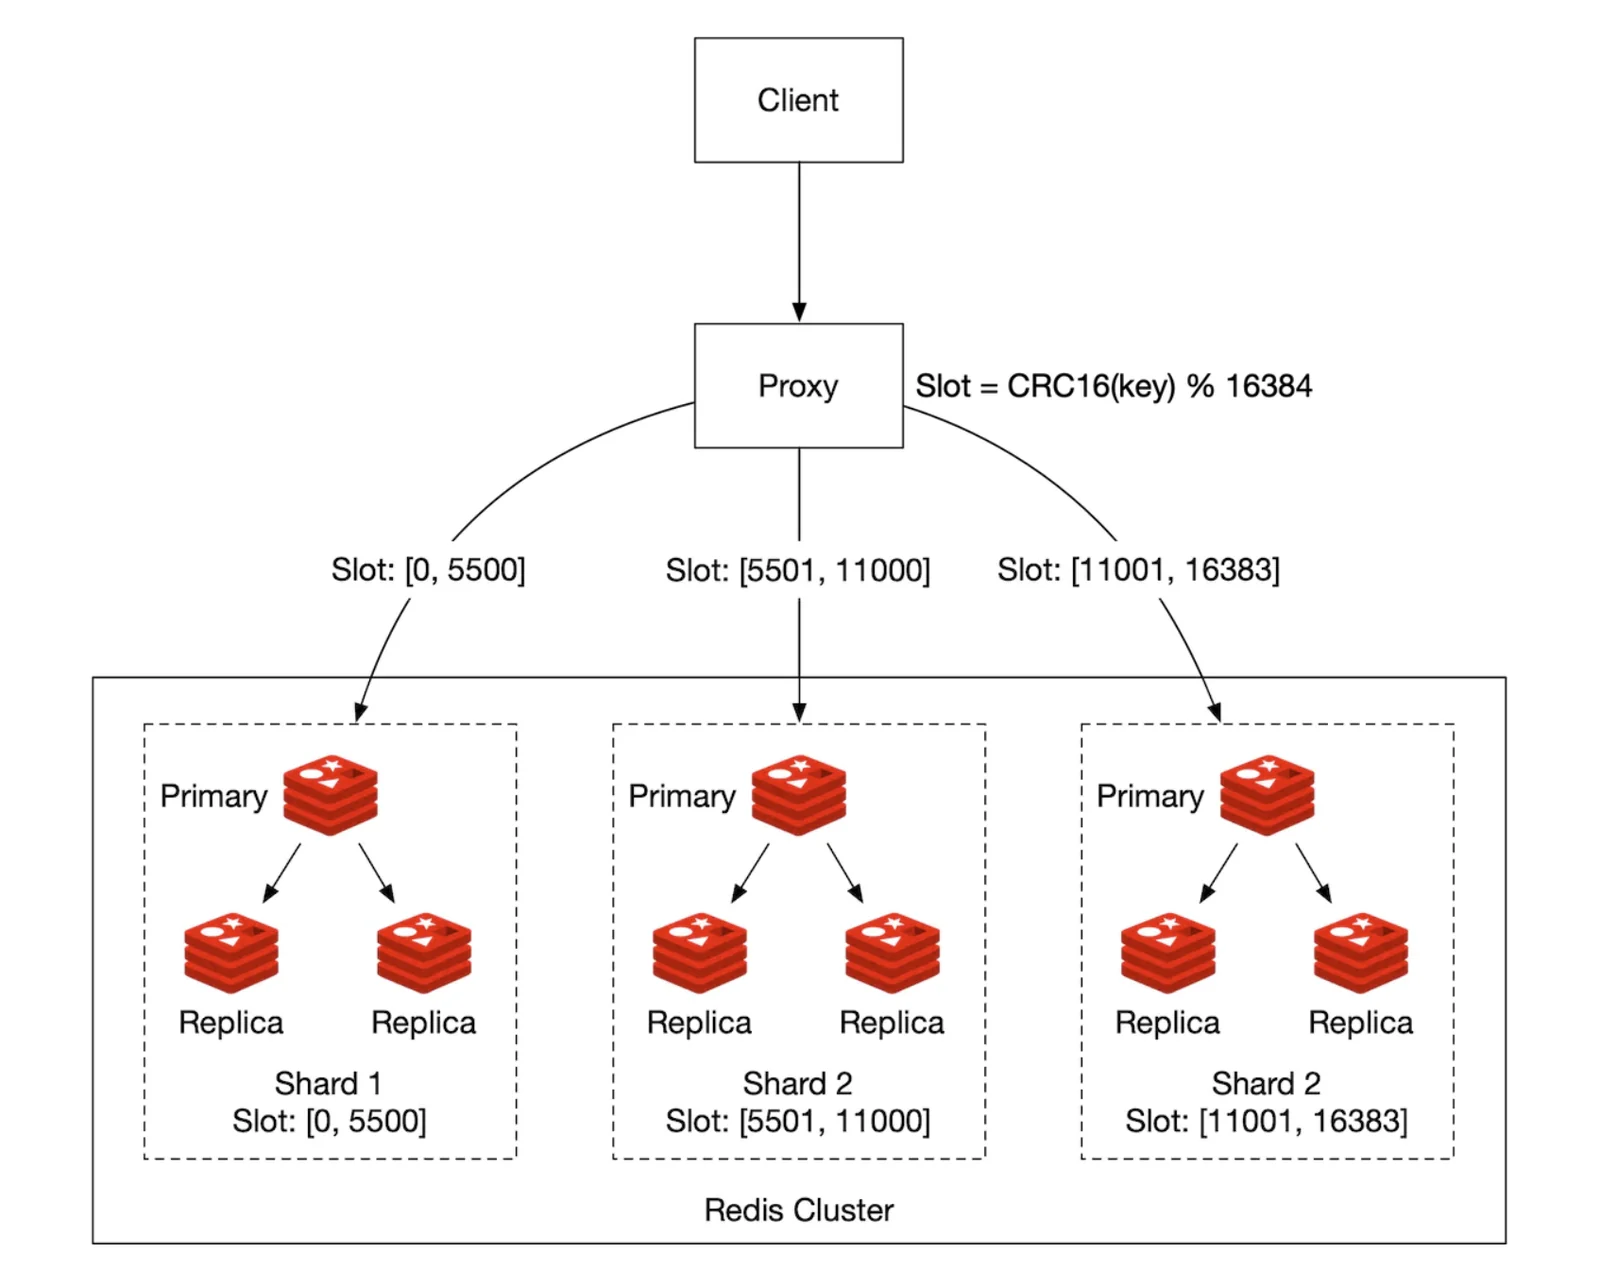
另一种做法是通过 Redis Cluster 进行哈希分区(Hash Partitioning)。它是一个代理,基于一种类似于一致性哈希(Consistent Hashing)但又不完全相同的分区方式,把数据分布到各个 Redis 节点上:
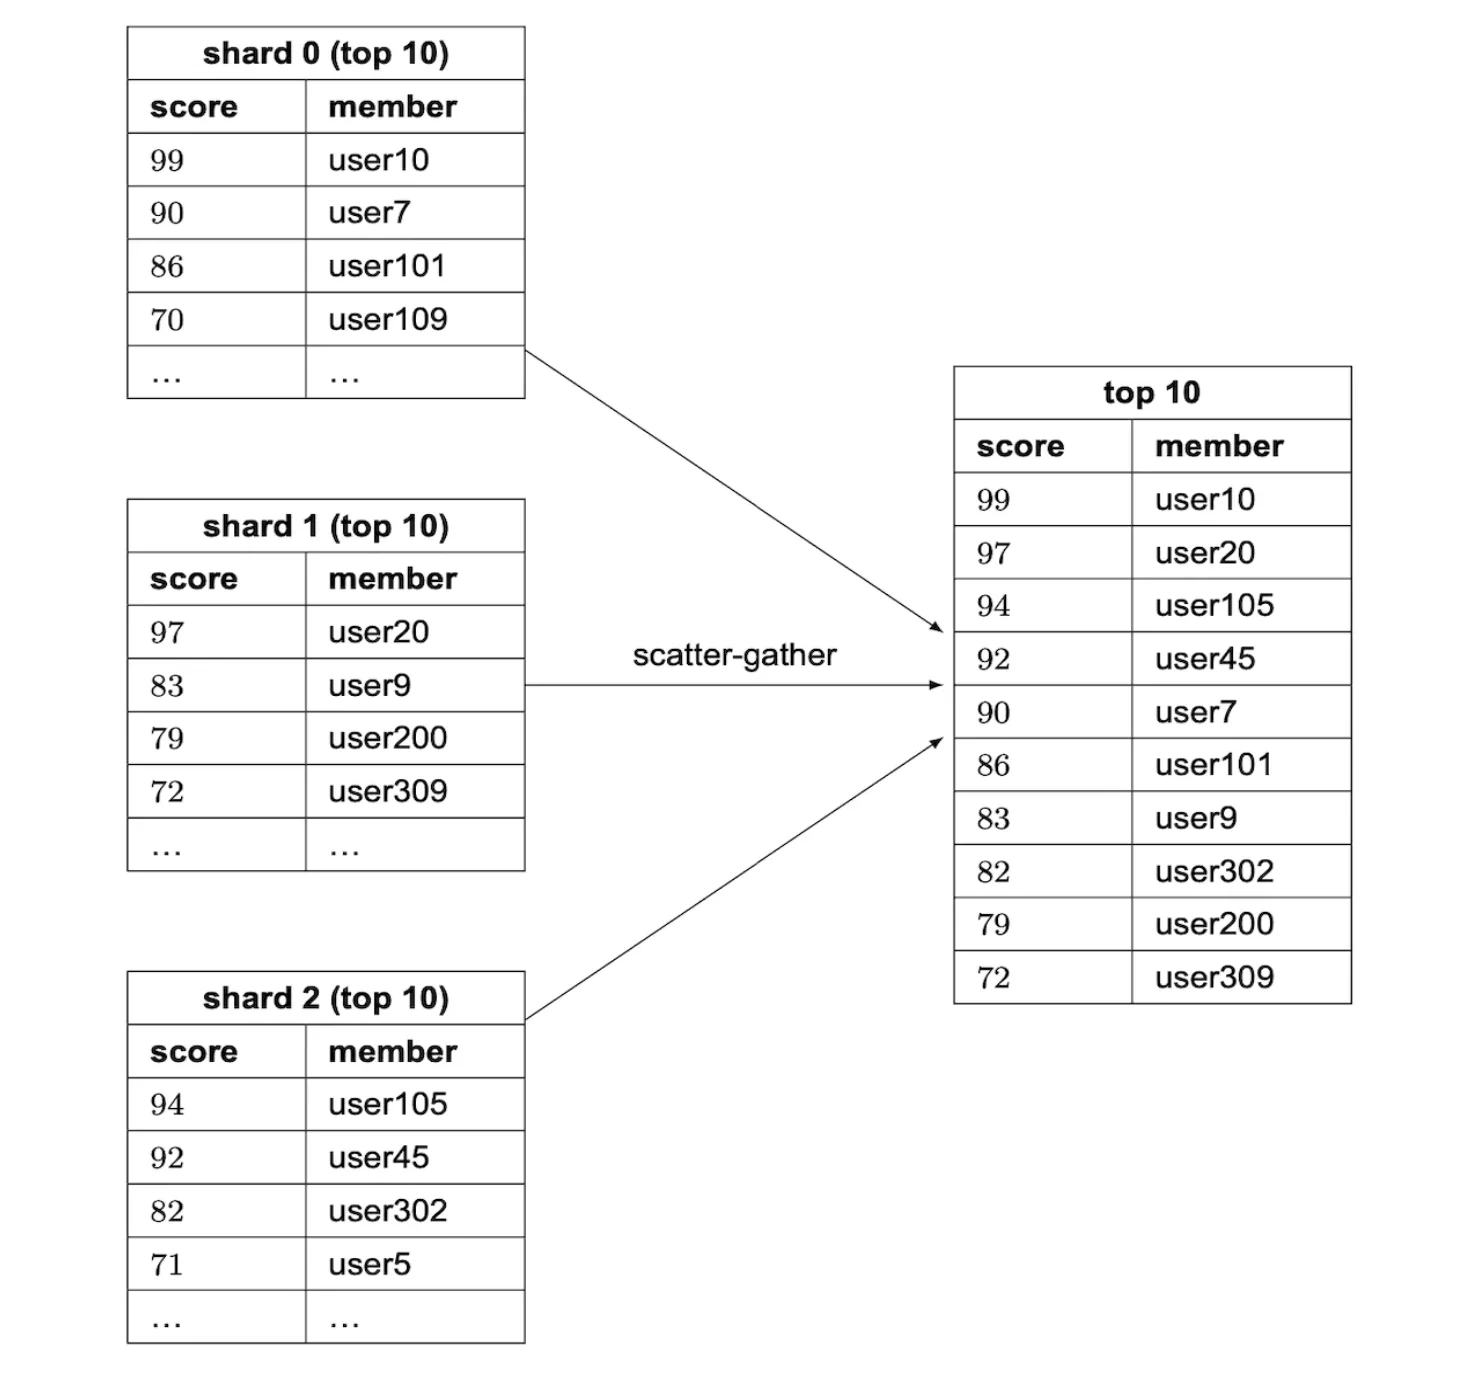
在这种部署下,计算前 10 名玩家就比较困难了。我们需要获取每个分片的前 10 名玩家,然后在应用中合并结果:
哈希分区有一些局限:
- 如果需要获取前 K 名用户,而 K 很大,延迟可能会增加,因为需要从所有分片获取大量数据
- 随着分区数量增加,延迟也会增加
- 没有直接的方法来确定用户的名次
鉴于以上原因,作者在这个问题上倾向于使用固定分区。
其他注意事项:
- 一个最佳实践是,为写入密集的 Redis 节点分配两倍于所需的内存,以便在需要时容纳快照
- 可以使用一个名为 Redis-benchmark 的工具来跟踪 Redis 部署的性能,从而做出数据驱动的决策
备选方案:NoSQL
另一个可以考虑的方案是使用合适的 NoSQL 数据库,它需要针对以下方面做过优化:
- 大量写入
- 能在同一分区内高效地按分数对条目排序
DynamoDB、Cassandra 或 MongoDB 都很合适。
在本章中,作者决定使用 DynamoDB。它是一个全托管的 NoSQL 数据库,提供可靠的性能和出色的可扩展性。 当需要查询不属于主键的字段时,它还支持使用全局二级索引(Global Secondary Index)。
我们先从一张存储国际象棋游戏排行榜的表开始:
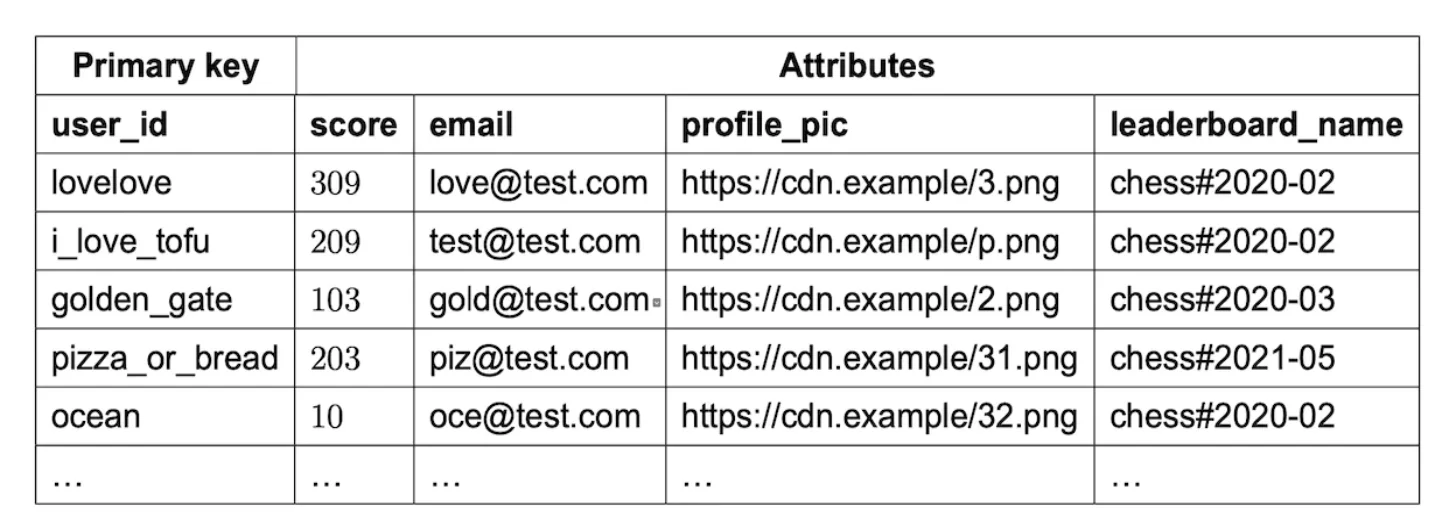
这样能正常工作,但如果需要按分数查询任何内容,扩展性就不好了。因此,我们可以把分数作为排序键(Sort Key):
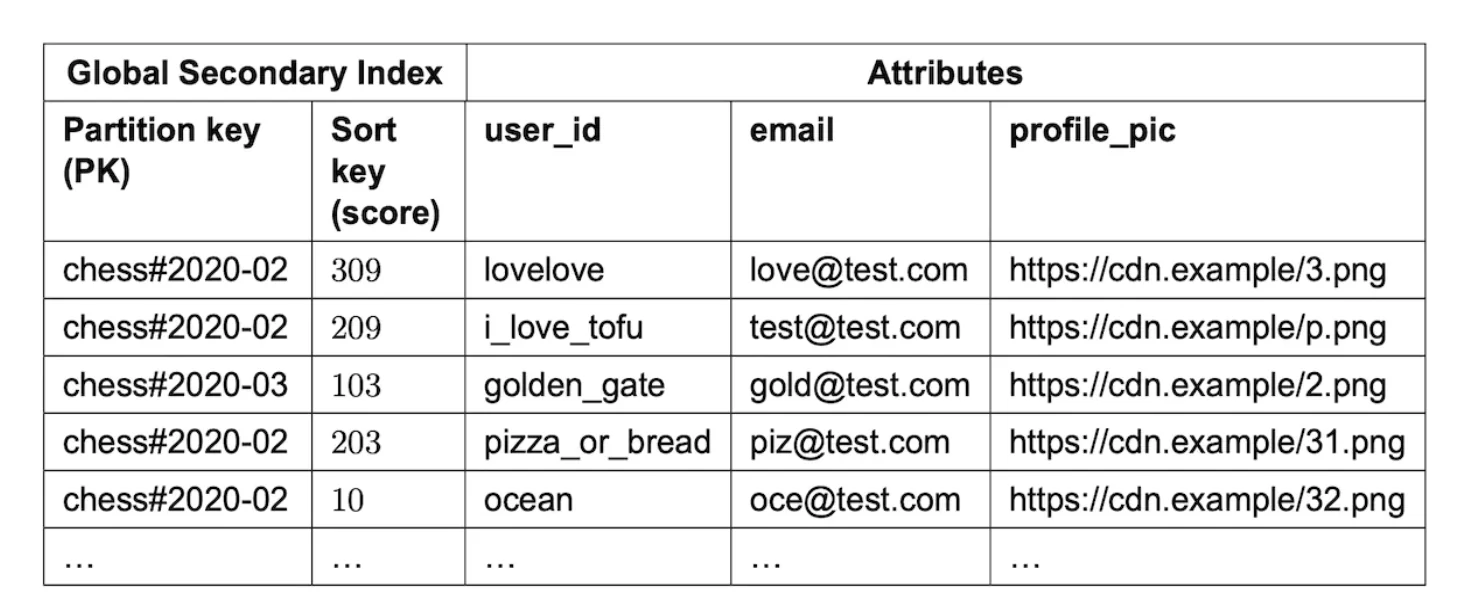
这个设计的另一个问题是我们按月份分区。这会导致热点(Hot Spot)分区,因为与其他月份相比,最近一个月的访问量会极不均衡。
我们可以使用一种叫写分片(Write Sharding)的技术,为每个键追加一个分区号,分区号通过 user_id % num_partitions 计算:
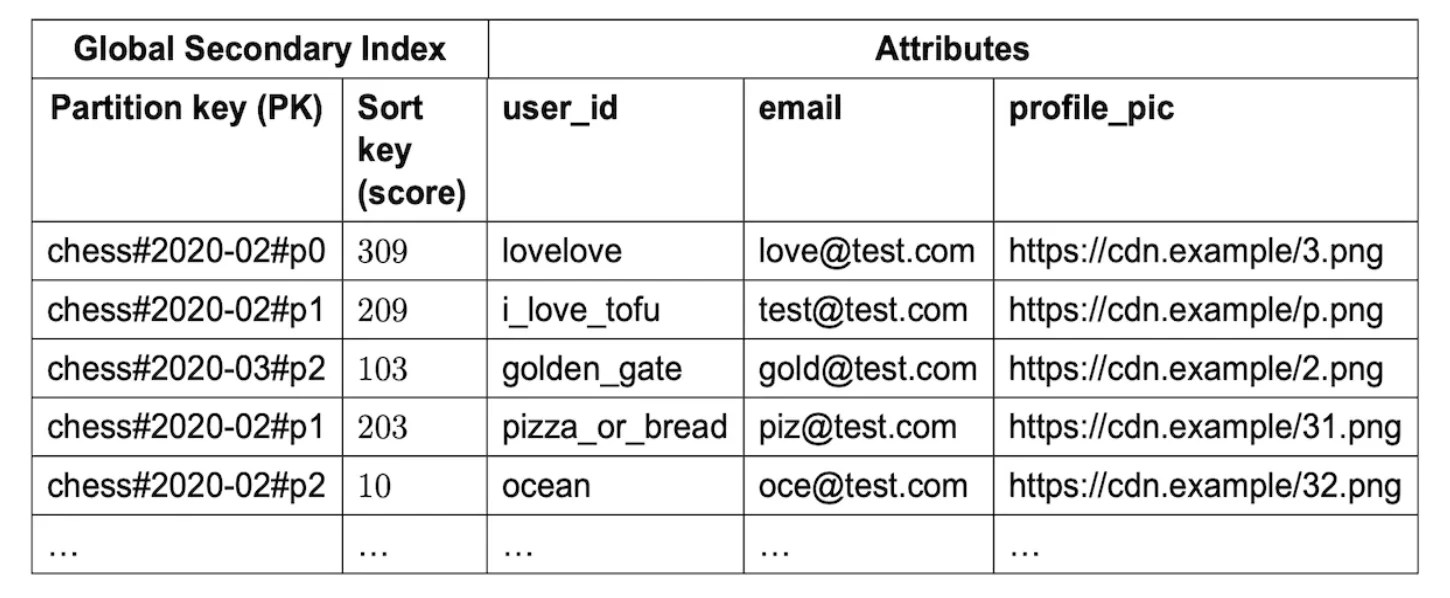
需要考虑的一个重要权衡(Trade-off)是应该使用多少个分区:
- 分区越多,写入的可扩展性越高
- 然而读取的可扩展性会受损,因为需要查询更多分区才能汇总结果
采用这种方法需要使用我们之前见过的“分散-聚集”(Scatter-Gather)技术,其时间复杂度会随着分区增加而增长:
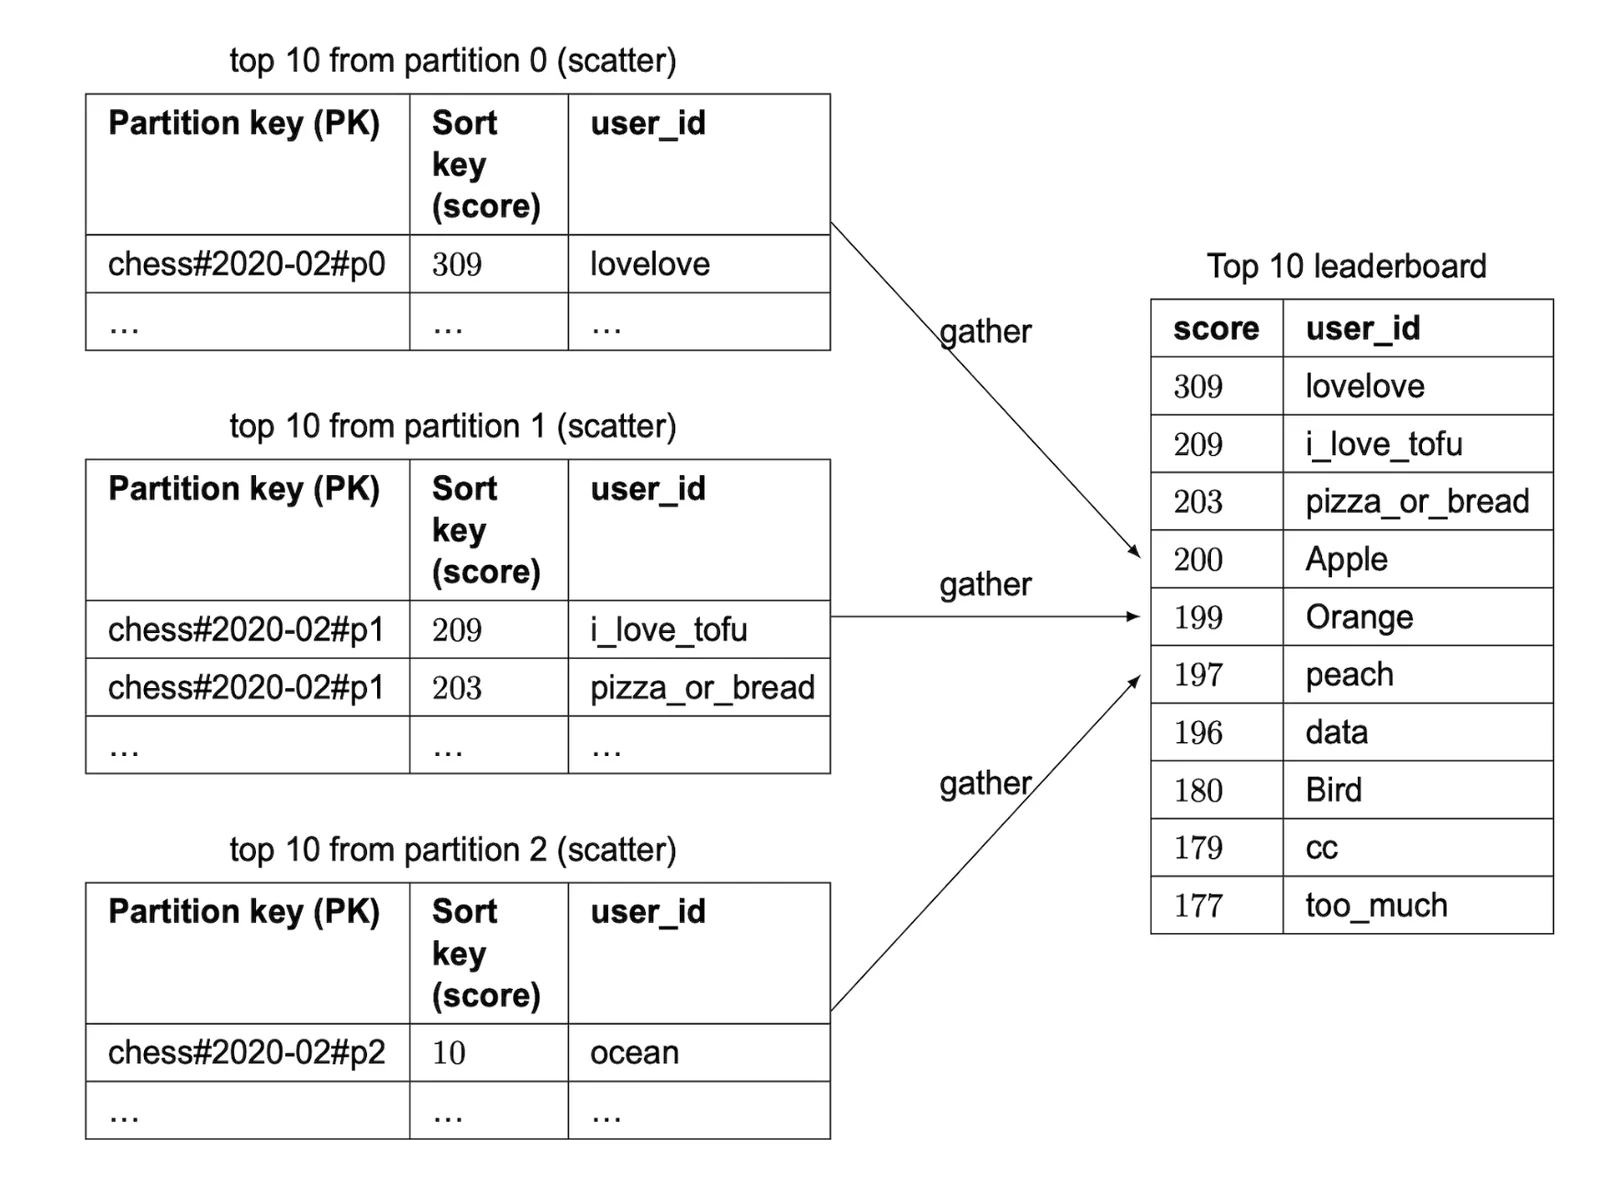
要合理评估分区数量,我们需要做一些基准测试。
这种 NoSQL 方法仍然有一个主要缺点:很难计算用户的具体名次。
如果规模大到需要分片,那么我们或许可以告诉用户他们的分数处于哪个“百分位”。
可以用一个定时任务(cron job)定期分析分数分布,并据此确定用户所在的百分位,例如:
第 10 百分位 = score < 100
第 20 百分位 = score < 500
...
第 90 百分位 = score < 6500
第 4 步:总结
如果时间允许,还可以讨论以下内容:
- 更快的检索:可以通过 Redis 哈希缓存用户对象,映射关系为
user_id -> user object。与查询数据库相比,检索速度更快。 - 打破平局:当两个玩家分数相同时,可以按最近一场游戏的时间对他们排序来打破平局。
- 系统故障恢复:如果 Redis 发生大规模宕机,可以遍历 MySQL 的 WAL 条目,通过一个临时脚本重建排行榜