第 18 章 Google Maps
引言
我们将设计一个简化版的 Google Maps。
关于 Google Maps 的一些事实:
- 始于 2005 年
- 提供多种服务:卫星图像、街道地图、实时路况、路线规划
- 截至 2021 年,拥有 10 亿日活跃用户,覆盖全球 99% 的地区,每天有 2500 万次实时位置信息更新
第 1 步:理解问题并确定设计范围
候选人与面试官之间的问答示例:
- 候选人:我们要面对多少日活跃用户?
- 面试官:10 亿 DAU。
- 候选人:我们应该重点关注哪些功能?
- 面试官:位置更新、导航、预计到达时间(ETA)、地图渲染。
- 候选人:道路数据有多大?我们能拿到这些数据吗?
- 面试官:我们已经从多种来源获取了道路数据,原始数据有数 TB。
- 候选人:我们需要考虑路况吗?
- 面试官:需要,这样才能准确估算时间。
- 候选人:不同的出行方式呢,比如步行、骑行、驾车?
- 面试官:这些都应该支持。
- 候选人:多途经点的路线规划呢?
- 面试官:在本次面试范围内先不关注这一点。
- 候选人:商家地点和照片呢?
- 面试官:好问题,但不需要考虑。
我们将重点关注三个关键功能:用户位置更新、包含 ETA 的导航服务、地图渲染。
非功能性需求
- 准确性:不应给用户提供错误的路线指引。
- 流畅的导航:用户应能体验到流畅的地图渲染。
- 数据与电量消耗:客户端应尽可能少地消耗流量和电量。这对移动设备来说很重要。
- 一般性的可用性与可扩展性需求。
地图入门
在开始设计之前,我们应当先了解一些与地图相关的概念。
定位系统
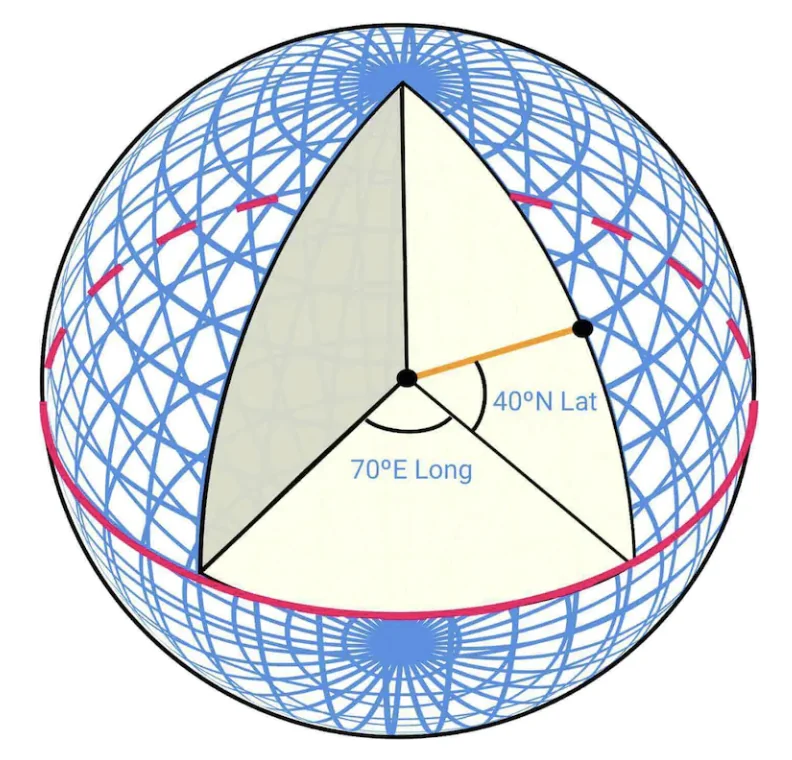
地球是一个绕自身轴线旋转的球体。位置由纬度(你在南北方向上的位置)和经度(你在东西方向上的位置)来定义:
从三维到二维
把三维球面上的点转换到二维平面上的过程称为“地图投影(Map Projection)”。
实现方式有很多种,每种都有各自的优缺点。几乎所有投影都会扭曲实际的几何形状。
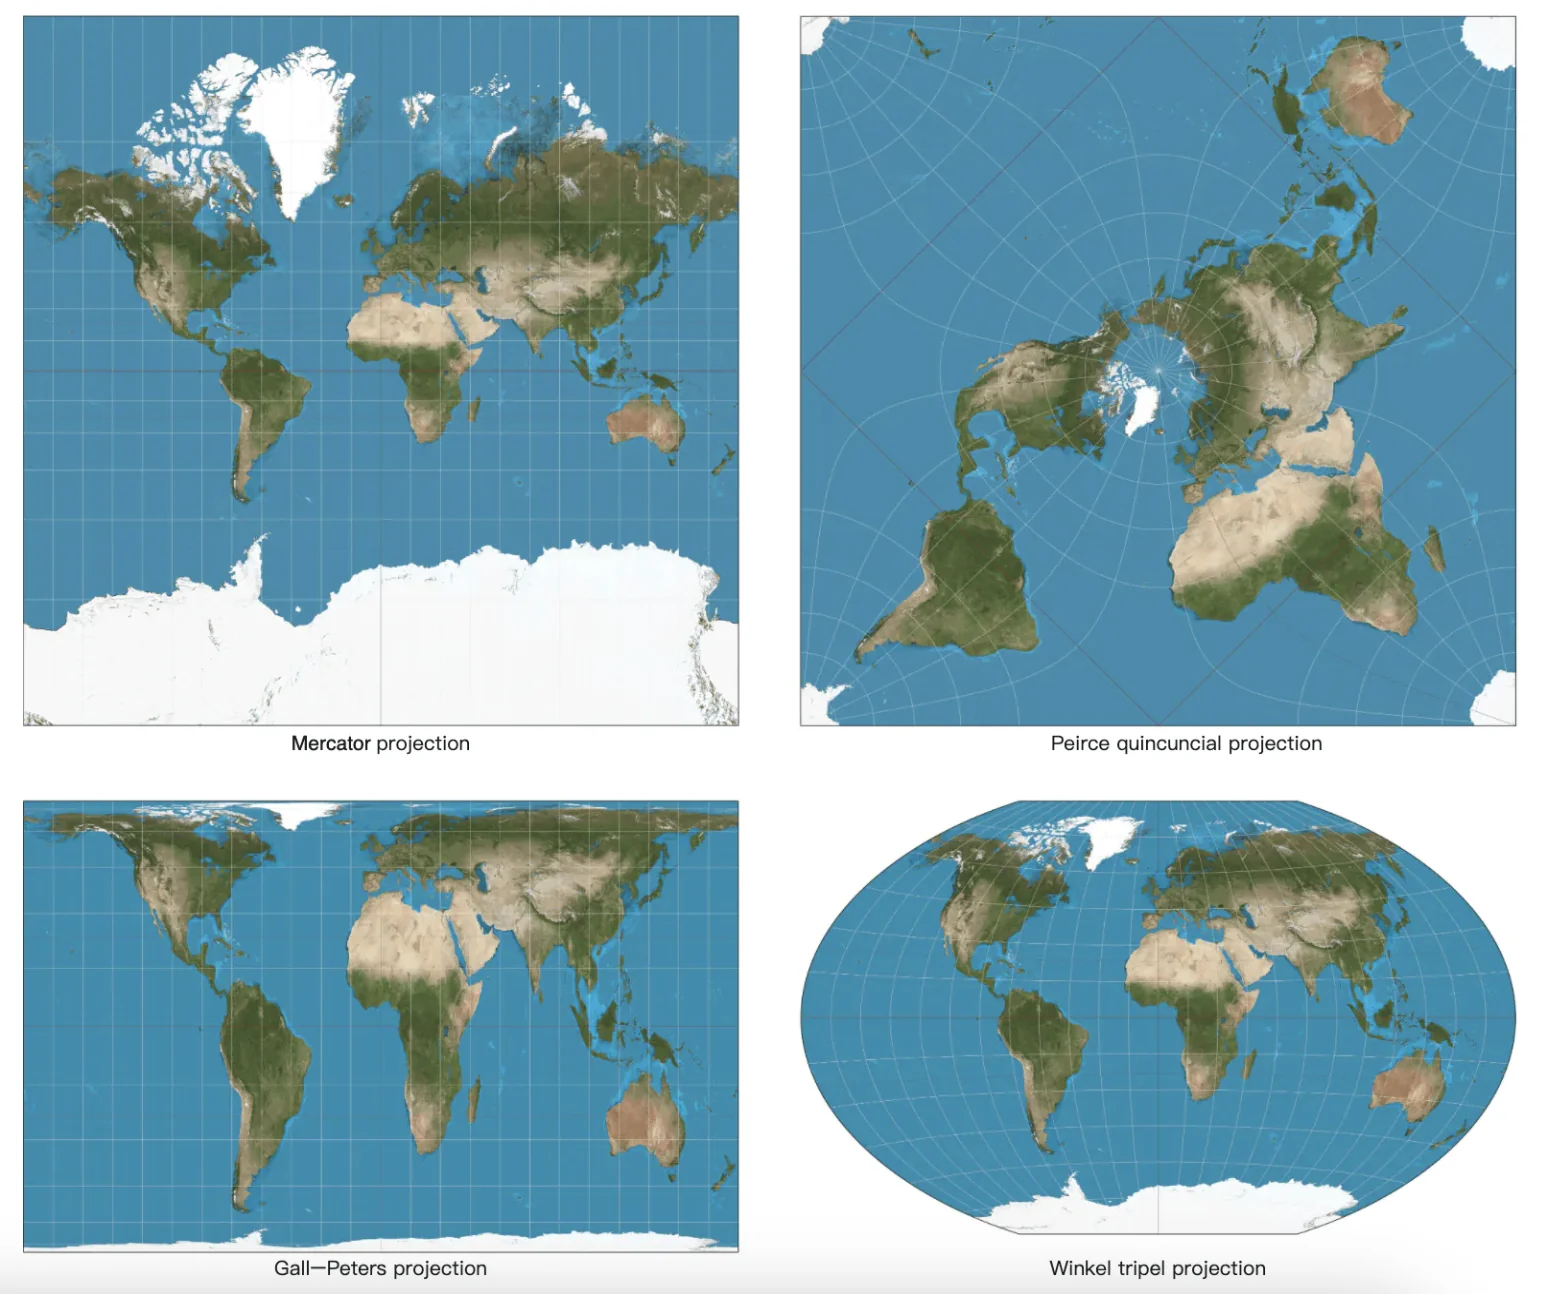
Google Maps 选用了墨卡托投影的一个改进版本,称为“Web 墨卡托(Web Mercator)”。
地理编码
地理编码(Geocoding)是把地址转换为地理坐标的过程。
其逆过程称为“逆地理编码(Reverse Geocoding)”。
实现它的一种方法是插值:利用来自不同来源(例如各种 GIS 系统)的数据,这些数据中街道网络已经映射到了地理坐标空间。
Geohash
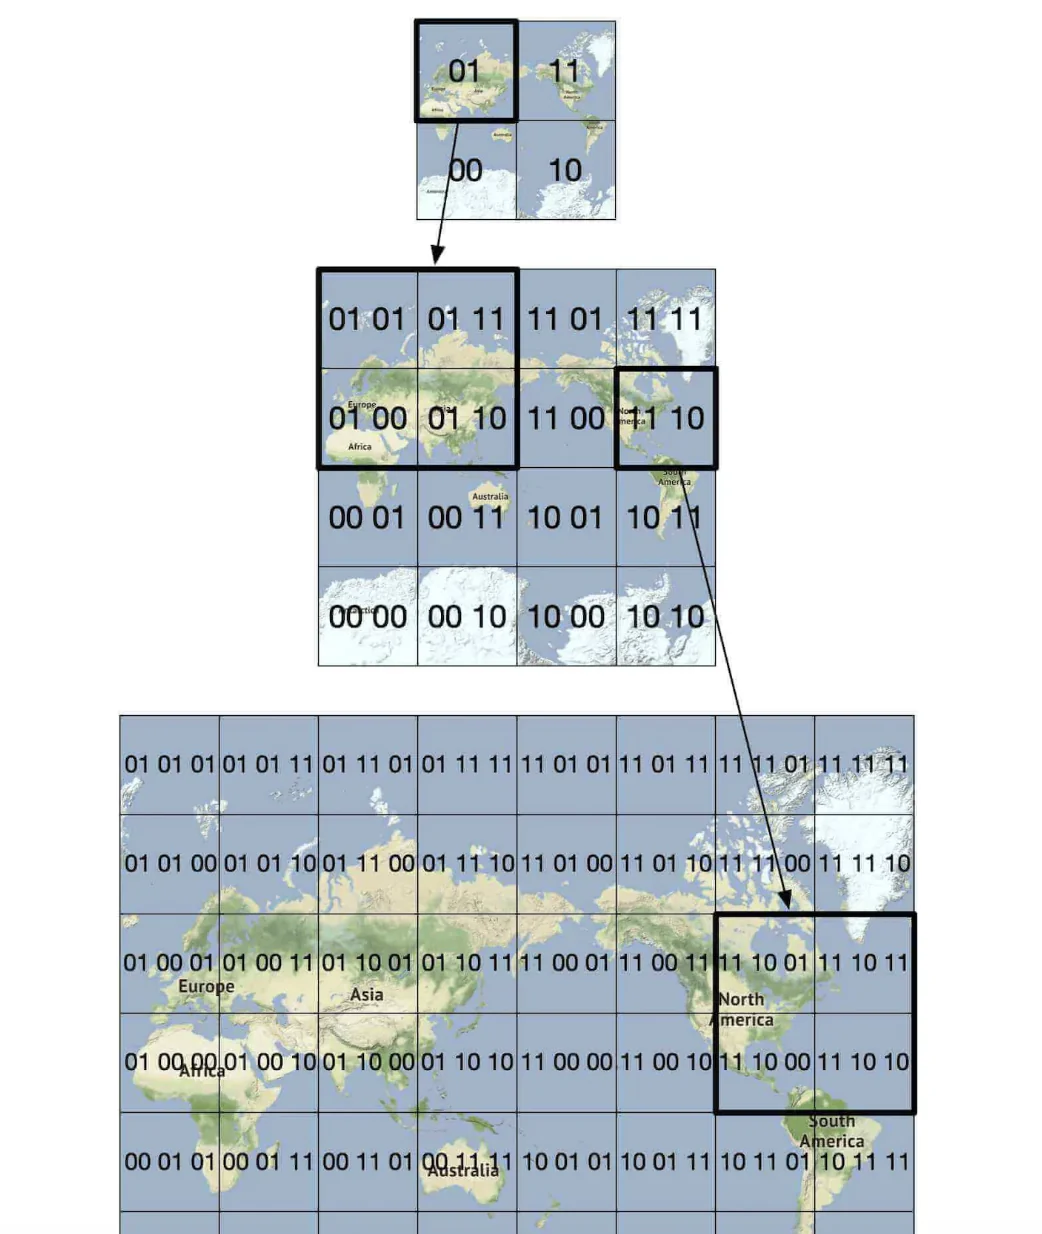
Geohash 是一种编码系统,它把一块地理区域编码成由字母和数字组成的字符串。
它把世界描绘成一个展平的平面,并递归地将其划分为四个象限:
地图渲染
地图渲染通过瓦片化(tiling)来实现。不是把整张地图作为一张巨大的定制图片来渲染,而是把世界拆分成许多较小的瓦片(tile)。
客户端只下载相关的瓦片,然后像拼马赛克一样把它们拼接起来渲染。
不同的缩放级别有不同的瓦片。客户端根据自身的缩放级别选择合适的瓦片。
例如,缩小到能看到整个世界时,只需下载一张代表全世界的 256x256 瓦片。
为导航算法处理道路数据
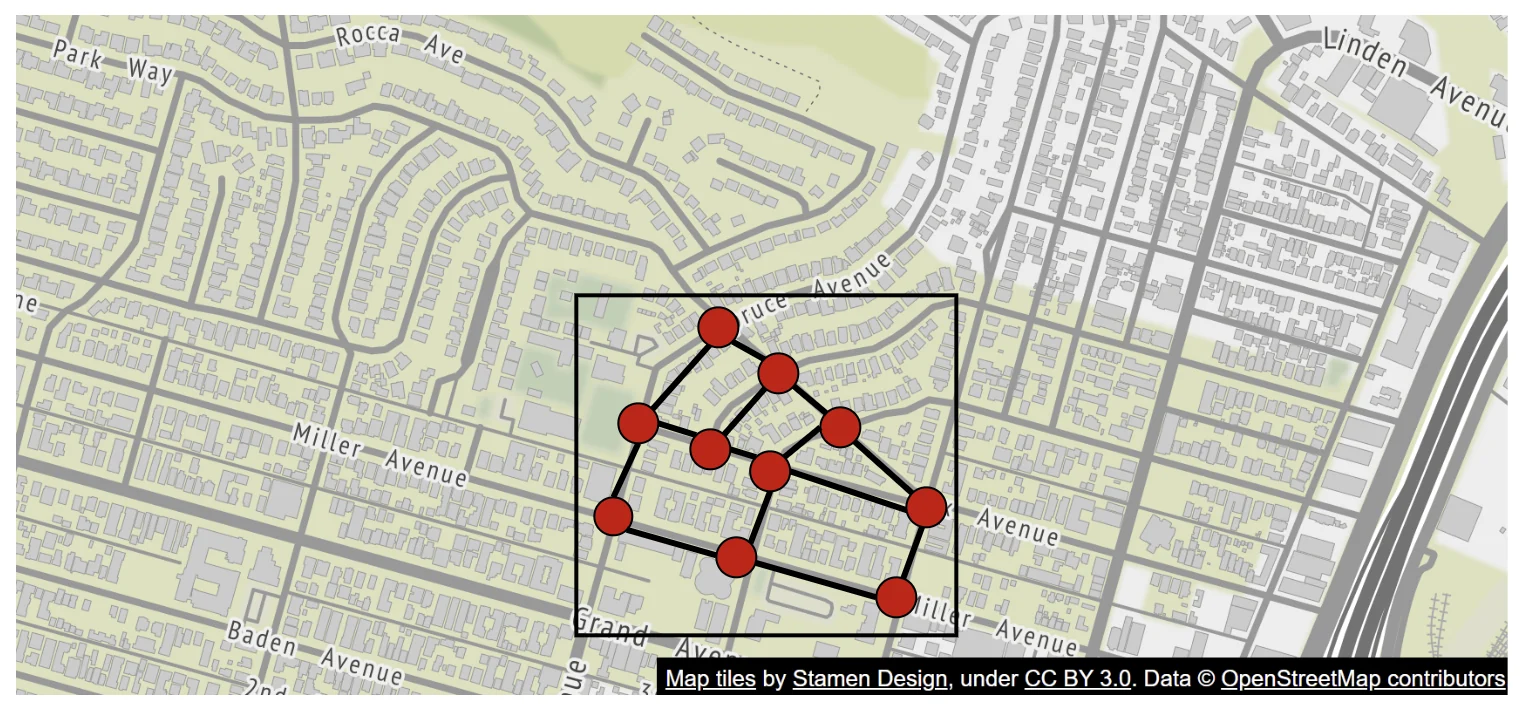
在大多数路径规划算法中,路口用节点表示,道路用边表示:
大多数导航算法使用的是 Dijkstra 算法或 A* 算法的改进版本。
寻路的性能对图的大小非常敏感。要在大规模下工作,我们不能把整个世界表示成一张图,再在上面运行算法。
取而代之的是,我们使用一种类似瓦片化的技术:把世界细分成越来越小的图。
路由瓦片(Routing Tile)持有对相邻瓦片的引用,算法在遍历相互连接的瓦片时,可以把它们拼接成一张更大的道路图:
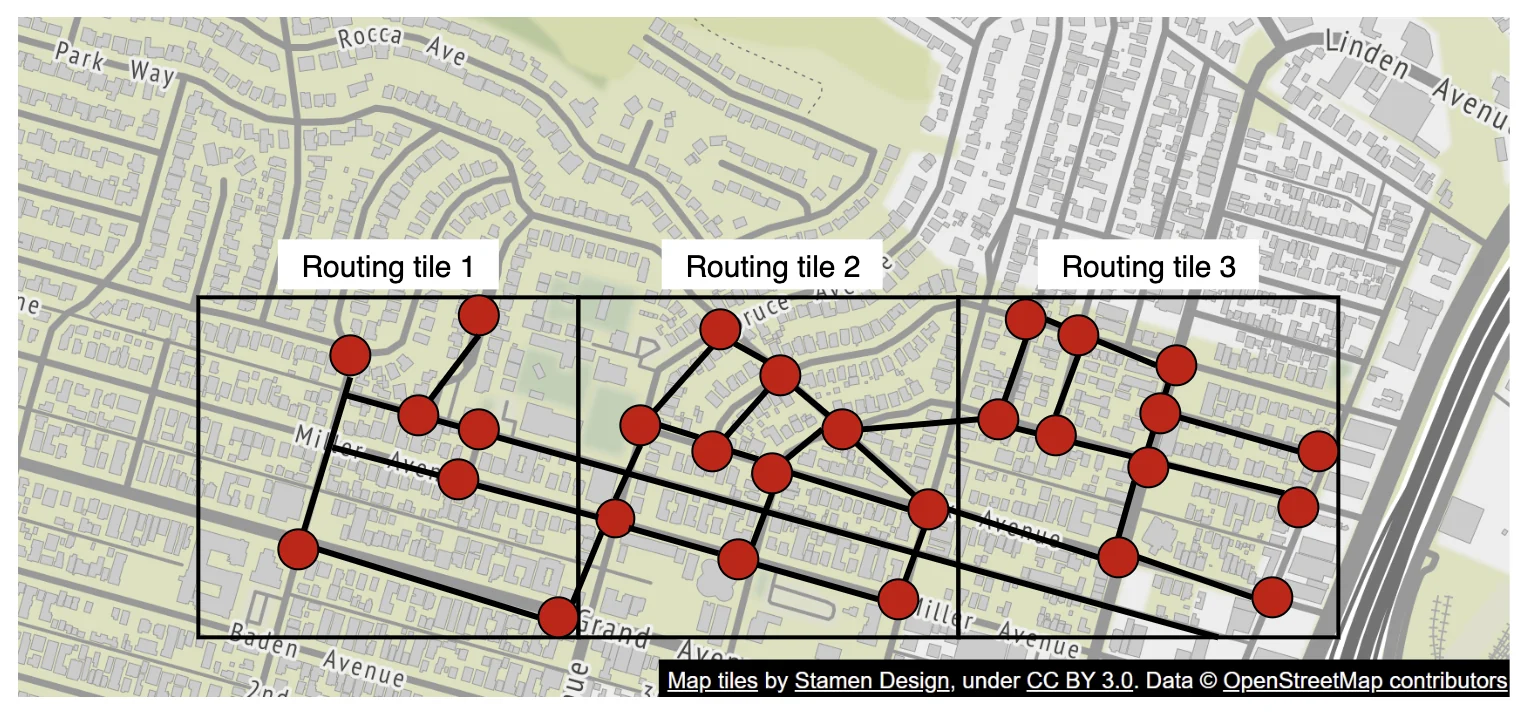
这种技术能显著降低内存带宽占用,并且只需加载给定起点/终点对所需的瓦片。
然而,对于更长的路线,把细小而详细的路由瓦片拼接起来仍然会耗费大量时间和内存。因此,路由瓦片分为不同的详细程度,算法会根据我们要前往的目的地,使用详细程度合适的瓦片:
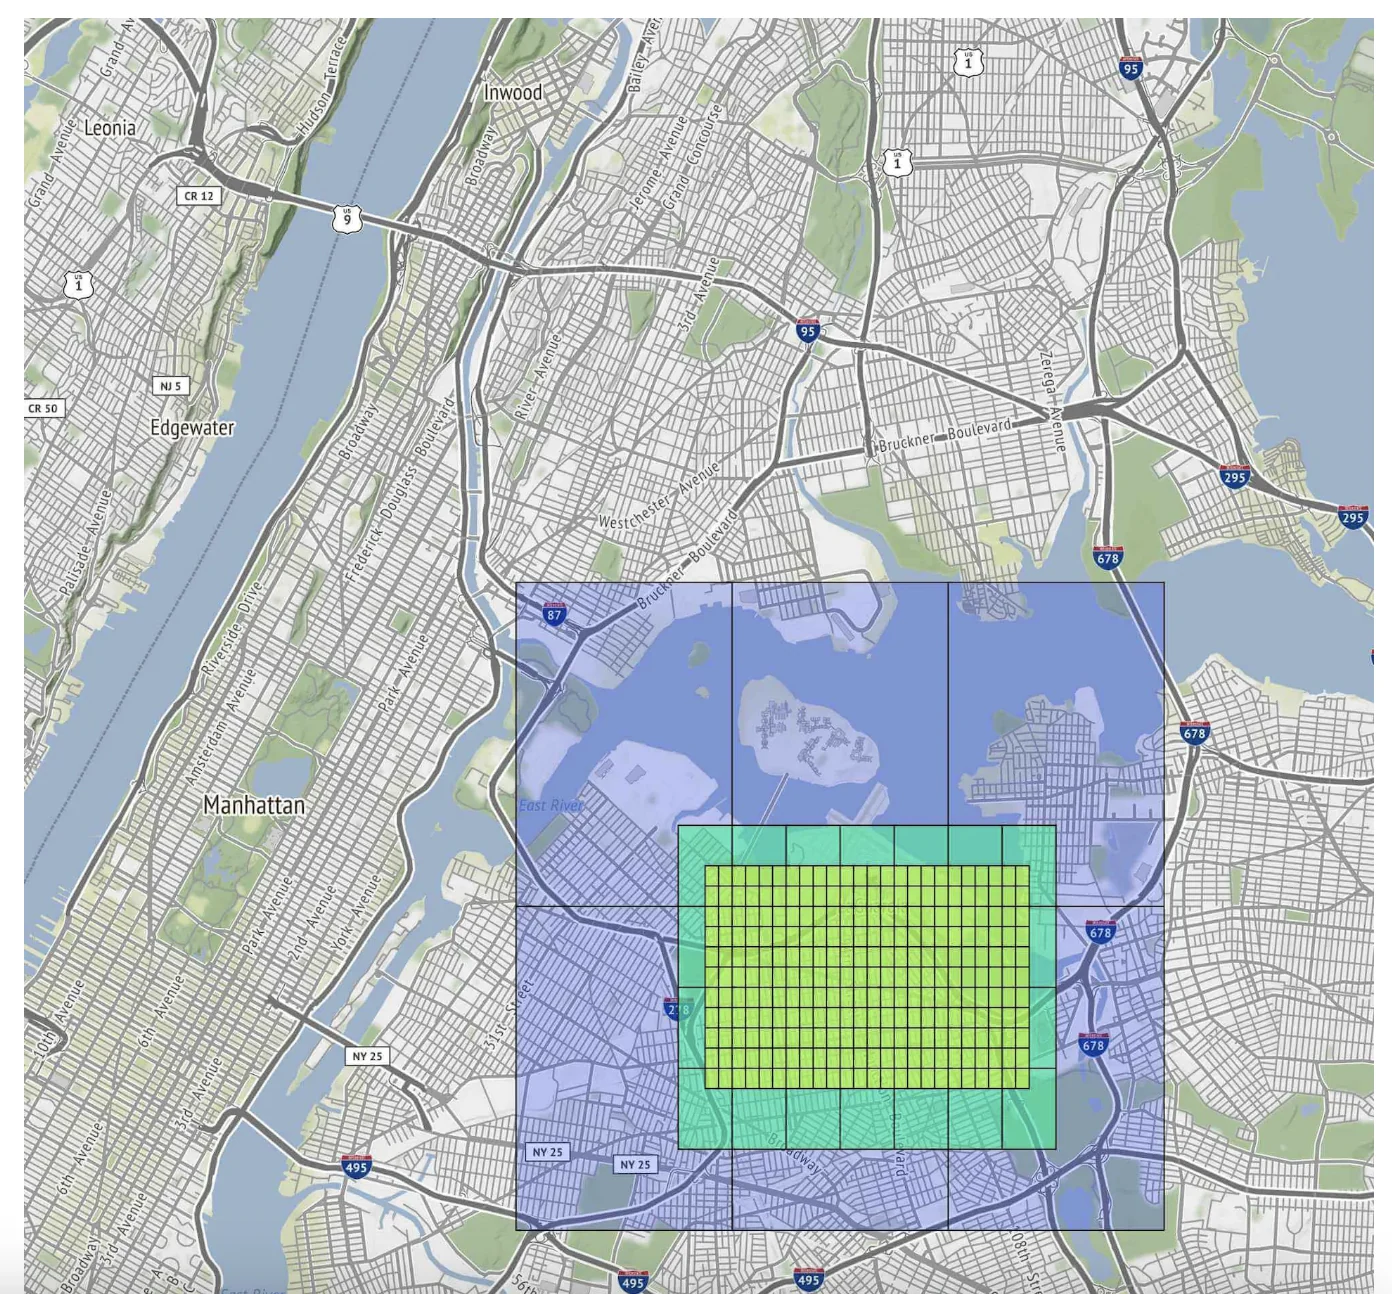
粗略估算
在存储方面,我们需要存储:
- 世界地图:根据需要存储的所有瓦片估算约为 70PB,这已考虑了对非常相似的瓦片(例如大片沙漠)进行压缩。
- 元数据:体量可以忽略不计,因此在计算中可以略去。
- 道路信息:以路由瓦片的形式存储。
导航请求的 QPS 估算:10 亿 DAU,每人每周使用 35 分钟,即每天 50 亿分钟。 假设 GPS 更新请求是批量发送的,可以得出 QPS 为 20 万,峰值负载时为 100 万 QPS。
第 2 步:提出高层设计并获得认可
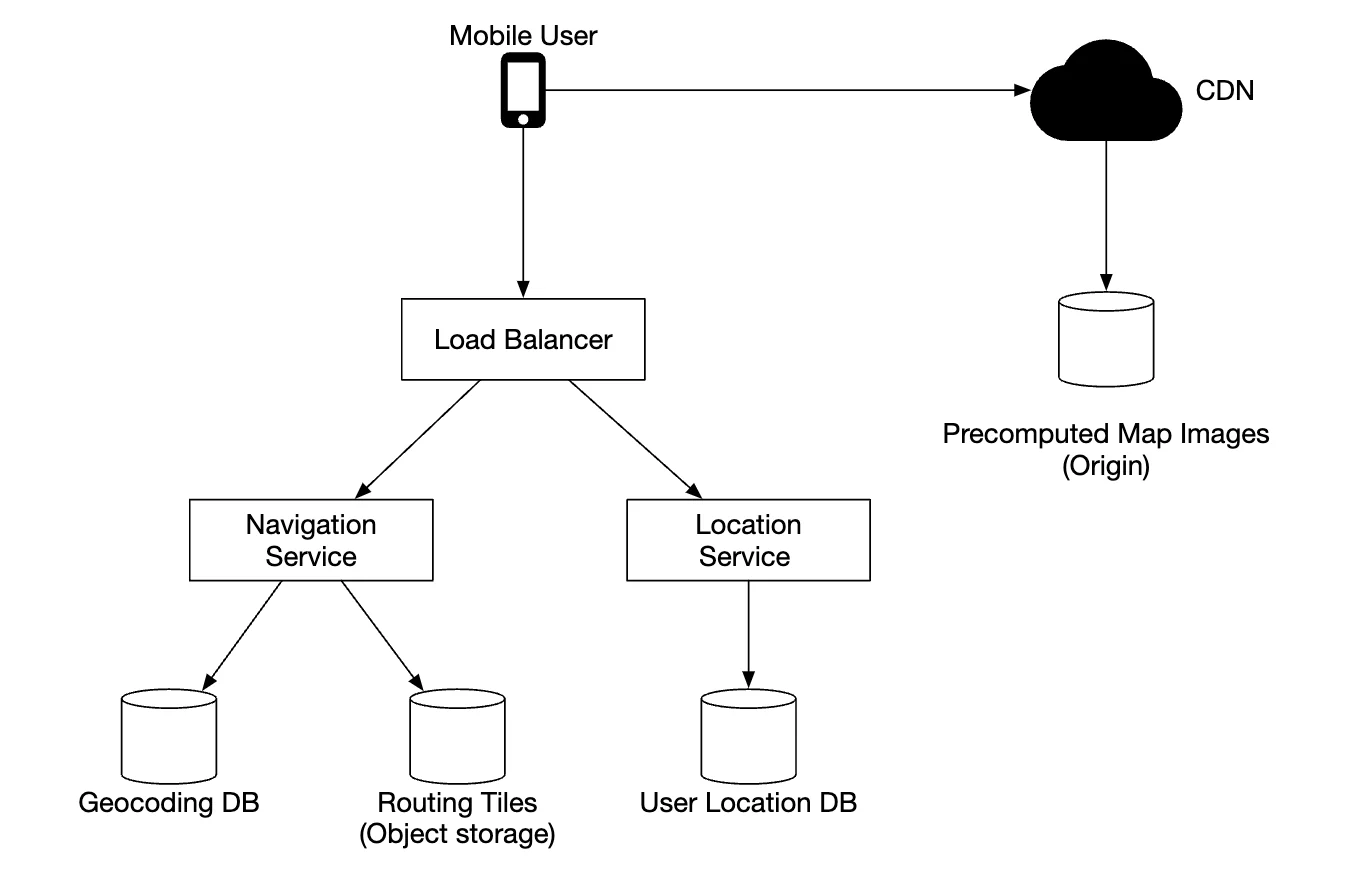
位置服务
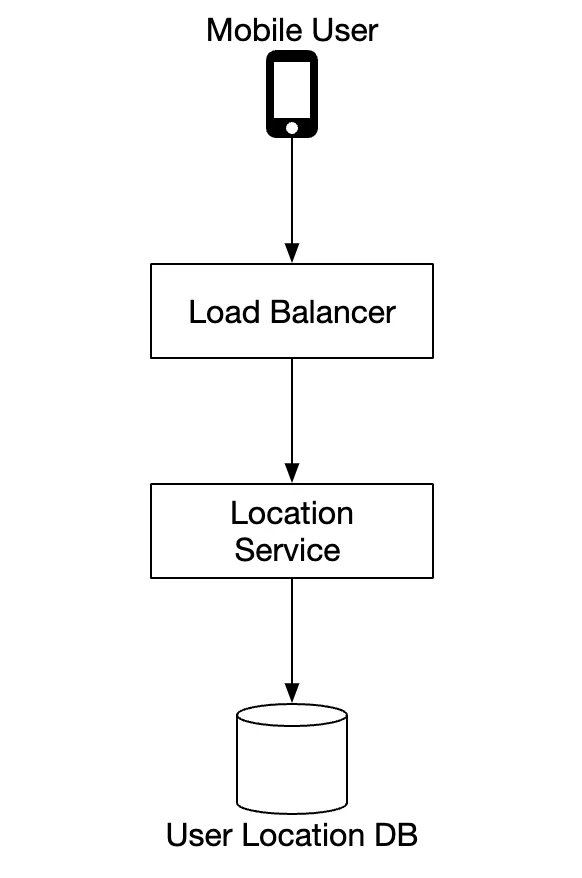
它负责记录用户的位置更新:
- 每隔
t秒发送一次位置更新。 - 位置数据流可以用来随时间不断改进服务,例如提供更准确的 ETA、监测路况数据、发现封闭道路、分析用户行为等。
与其一直向服务器发送位置更新,我们可以在客户端把更新攒成批,再批量发送:
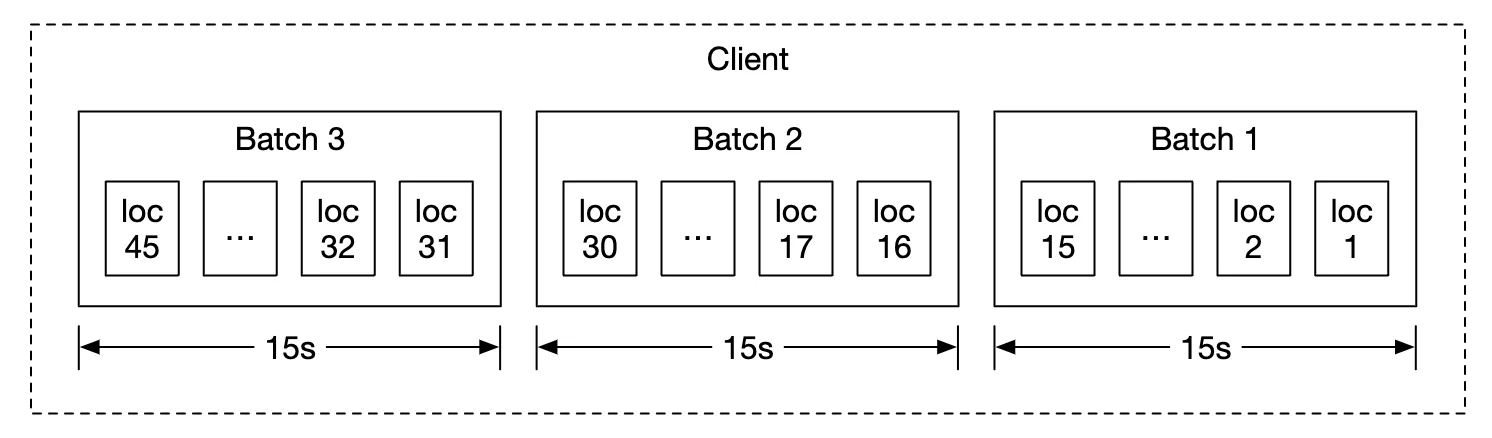
即便有了这一优化,对于 Google Maps 这种规模的系统来说,负载仍然相当可观。因此,我们可以使用为大量写入优化过的数据库,例如 Cassandra。
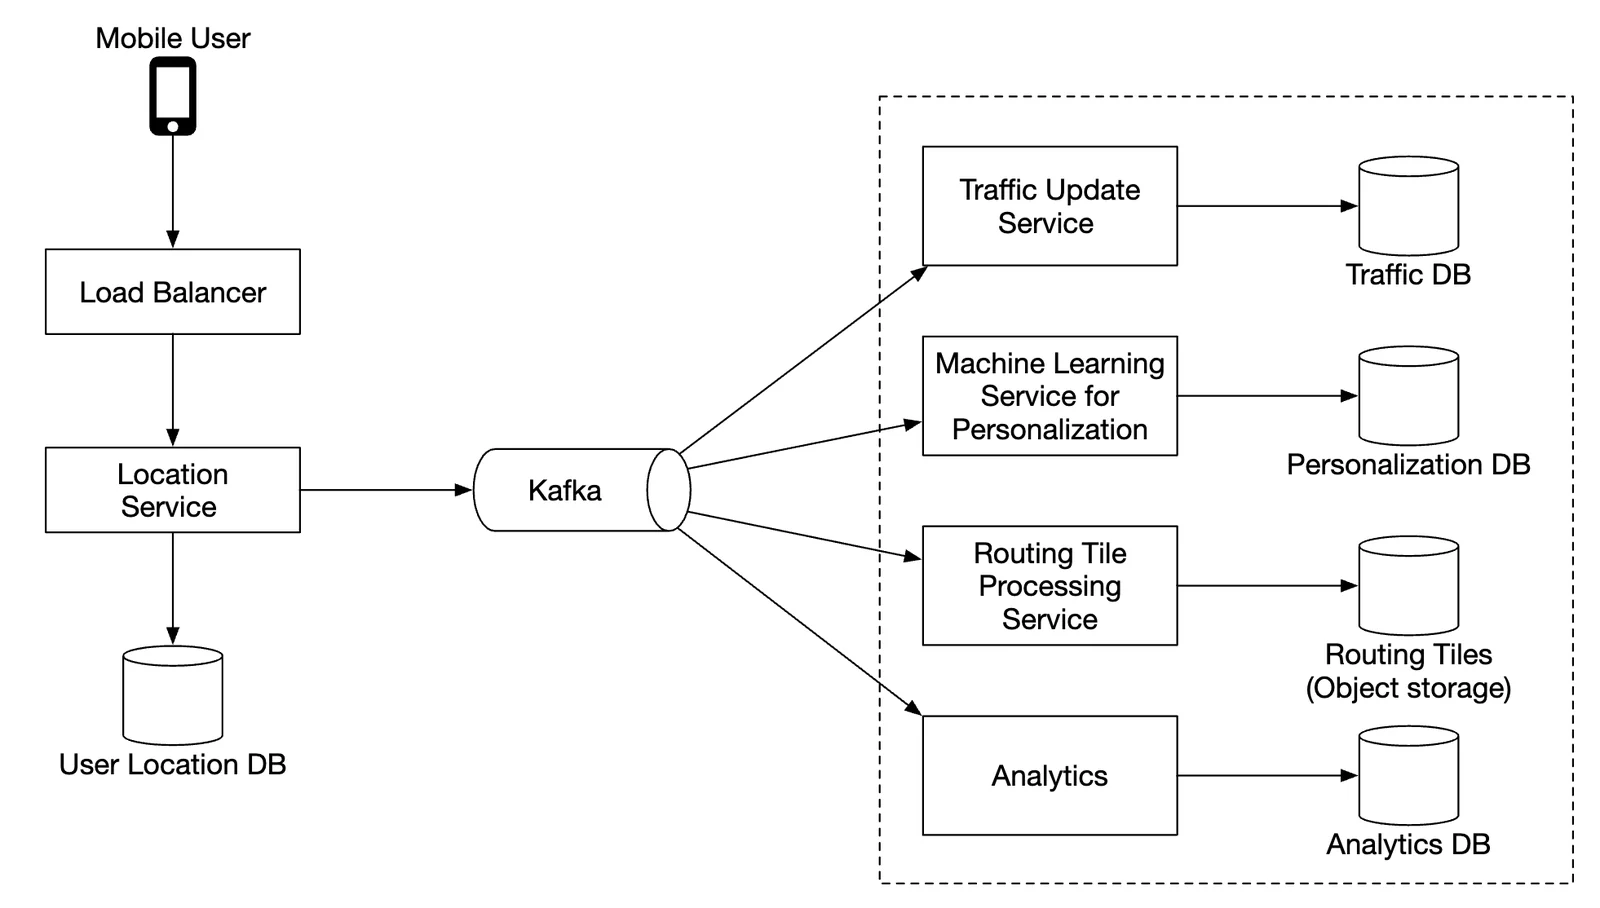
我们还可以利用 Kafka 对位置更新进行高效的流处理,以便做进一步分析。
位置更新请求负载示例:
POST /v1/locations
参数
  locs:由 (latitude, longitude, timestamp) 元组组成的 JSON 编码数组。
导航服务
该组件负责在合理的时间内(允许有一点延迟)找出从 A 到 B 的较快路线。路线不一定非得是最快的,但准确性很重要。
请求负载示例:
GET /v1/nav?origin=1355+market+street,SF&destination=Disneyland
响应示例:
{
  "distance": {"text":"0.2 mi", "value": 259},
  "duration": {"text": "1 min", "value": 83},
  "end_location": {"lat": 37.4038943, "Ing": -121.9410454},
  "html_instructions": "Head <b>northeast</b> on <b>Brandon St</b> toward <b>Lumin Way</b><div style=\"font-size:0.9em\">Restricted usage road</div>",
  "polyline": {"points": "_fhcFjbhgVuAwDsCal"},
  "start_location": {"lat": 37.4027165, "lng": -121.9435809},
  "geocoded_waypoints": [
    {
       "geocoder_status" : "OK",
       "partial_match" : true,
       "place_id" : "ChIJwZNMti1fawwRO2aVVVX2yKg",
       "types" : [ "locality", "political" ]
    },
    {
       "geocoder_status" : "OK",
       "partial_match" : true,
       "place_id" : "ChIJ3aPgQGtXawwRLYeiBMUi7bM",
       "types" : [ "locality", "political" ]
    }
  ],
  "travel_mode": "DRIVING"
}
目前还没有考虑路况变化和重新规划路线,这些将在深入设计部分处理。
地图渲染
在客户端保存全部地图瓦片数据集是不可行的,因为其体量达到 PB 级。
这些瓦片需要根据客户端的位置和缩放级别,按需从服务器获取。
什么时候应该获取新的瓦片?在用户放大/缩小地图时,以及在导航过程中用户移动到新瓦片范围时。
地图瓦片应该如何提供给客户端?
- 可以动态生成,但这会给服务器带来巨大负载,也会让缓存变得困难。
- 地图瓦片根据其 geohash 以静态方式提供,客户端可以自行计算 geohash。瓦片可以静态存储,并通过 CDN 分发。
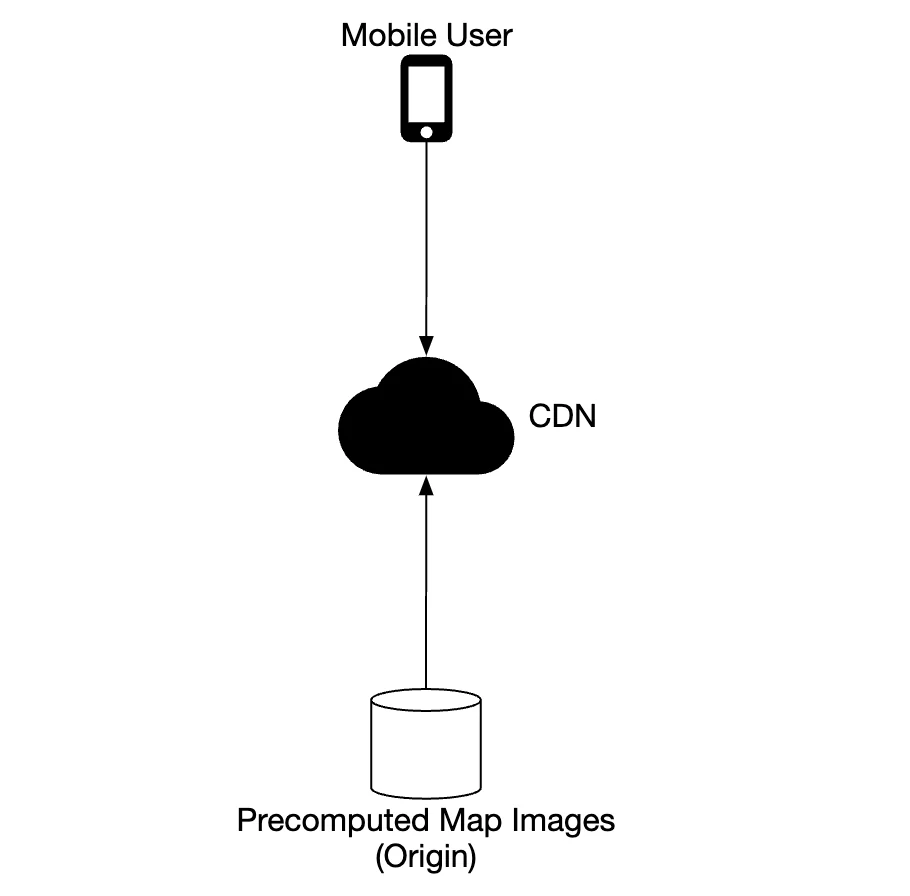
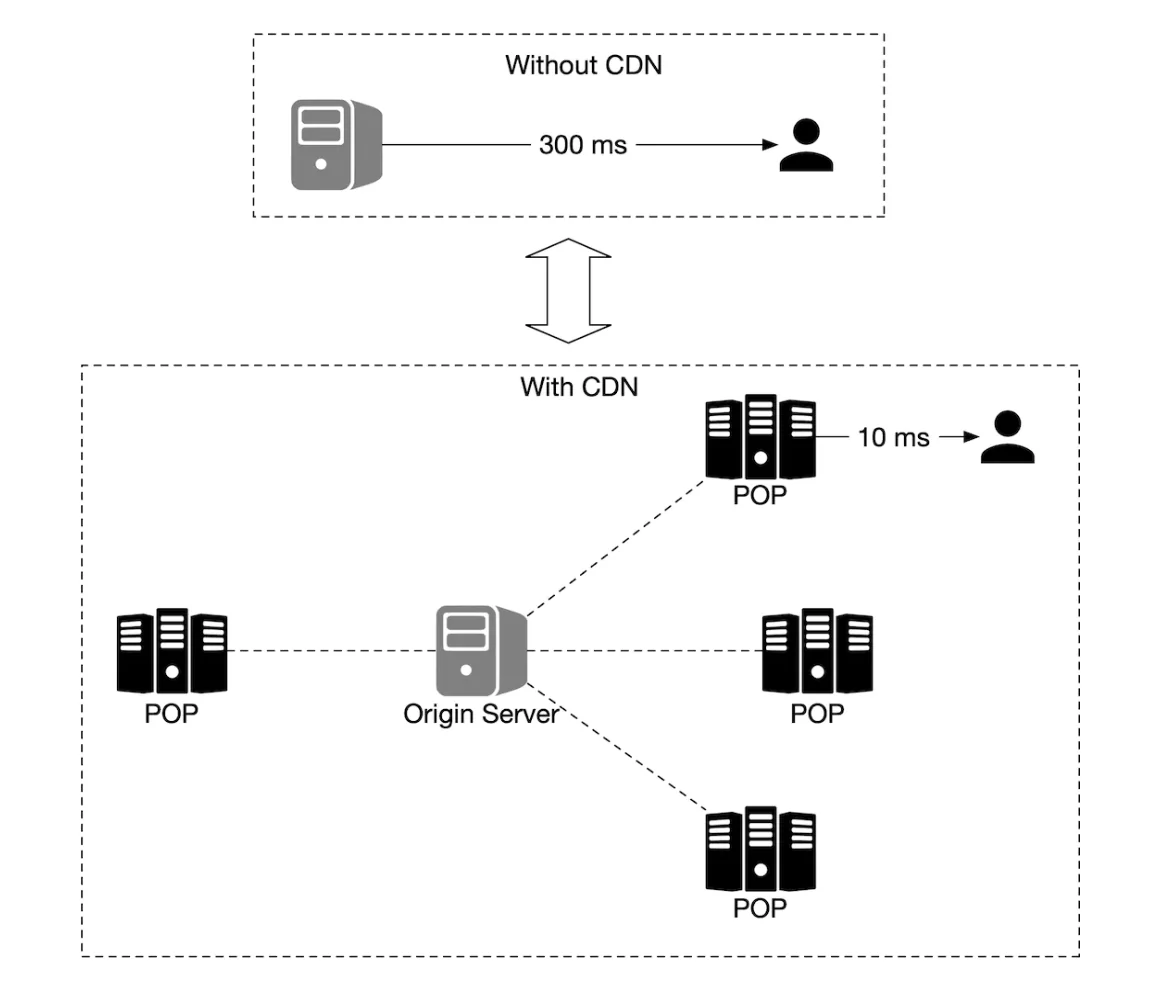
CDN 让用户能够从离自己最近的接入点(Point of Presence,POP)服务器获取地图瓦片,从而尽量降低延迟:
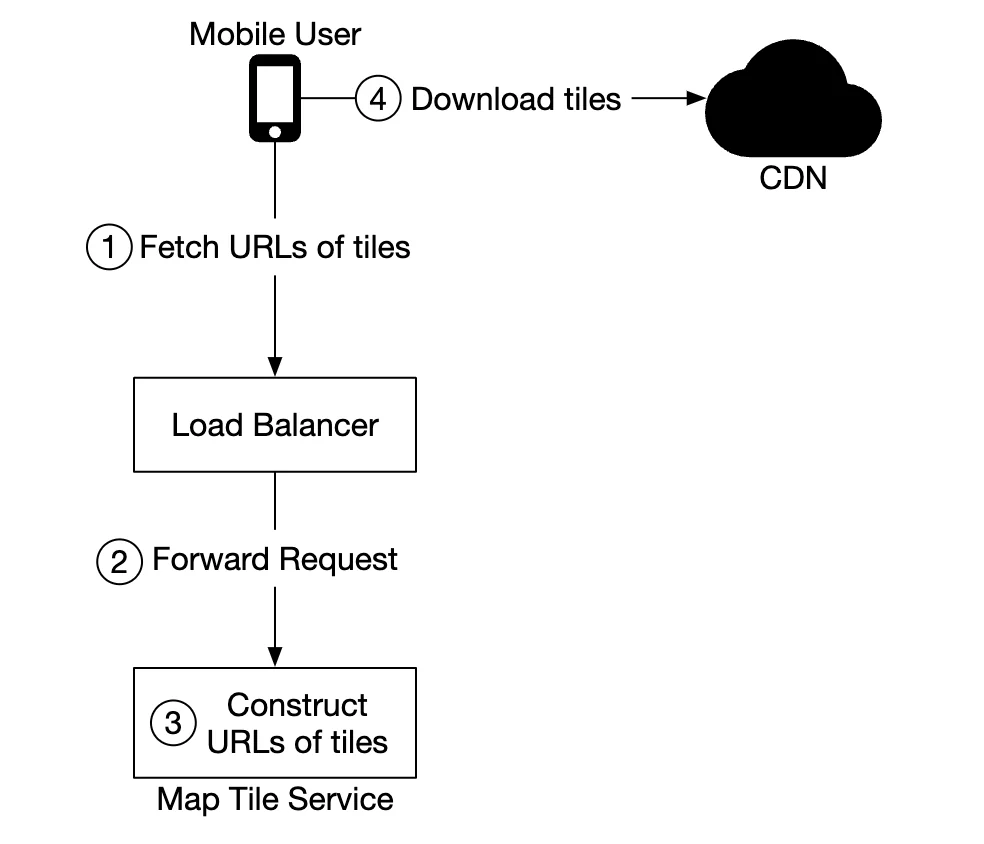
确定地图瓦片时可以考虑的方案:
- 地图瓦片的 geohash 可以在客户端计算。如果这样做,就要谨慎,因为我们得长期沿用这种瓦片计算方式,强制客户端更新是很困难的。
- 另一种做法是提供一个简单的 API,代替客户端计算地图瓦片的 URL,代价是多一次 API 调用。
第 3 步:深入设计
数据模型
我们来讨论如何存储所涉及的各类数据。
路由瓦片
初始的道路数据集来自不同的来源,并会基于位置更新数据随时间不断改进。
道路数据是非结构化的。我们有一条周期性运行的离线处理管道,把这些原始数据转换成应用所需的、基于图的路由瓦片。
我们不需要任何数据库特性,因此不把这些瓦片存进数据库,而是存放在 S3 对象存储中,同时对其进行积极缓存。
我们还可以借助一些库,把邻接表高效地压缩成二进制文件。
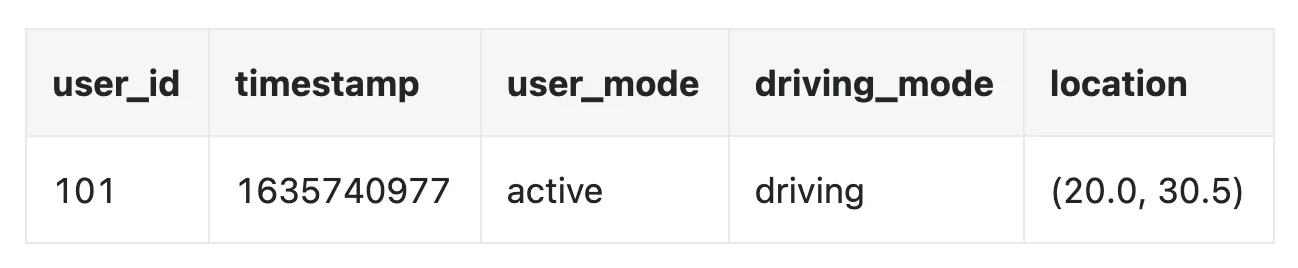
用户位置数据
用户位置数据对于更新路况以及进行各种其他分析都非常有用。
由于这类数据天然是写多读少的,我们可以用 Cassandra 来存储。
行示例:
地理编码数据库
该数据库以键值对的形式存储经纬度对与地点之间的对应关系。
由于读取频繁而写入很少,我们可以利用 Redis 读取速度快的特点来存储。
预先计算好的世界地图图像
如前所述,我们会预先计算地图瓦片图像,并将其存放在 CDN 中。
服务
位置服务
我们重点来看这个服务的数据库设计,以及用户位置是如何具体存储的。
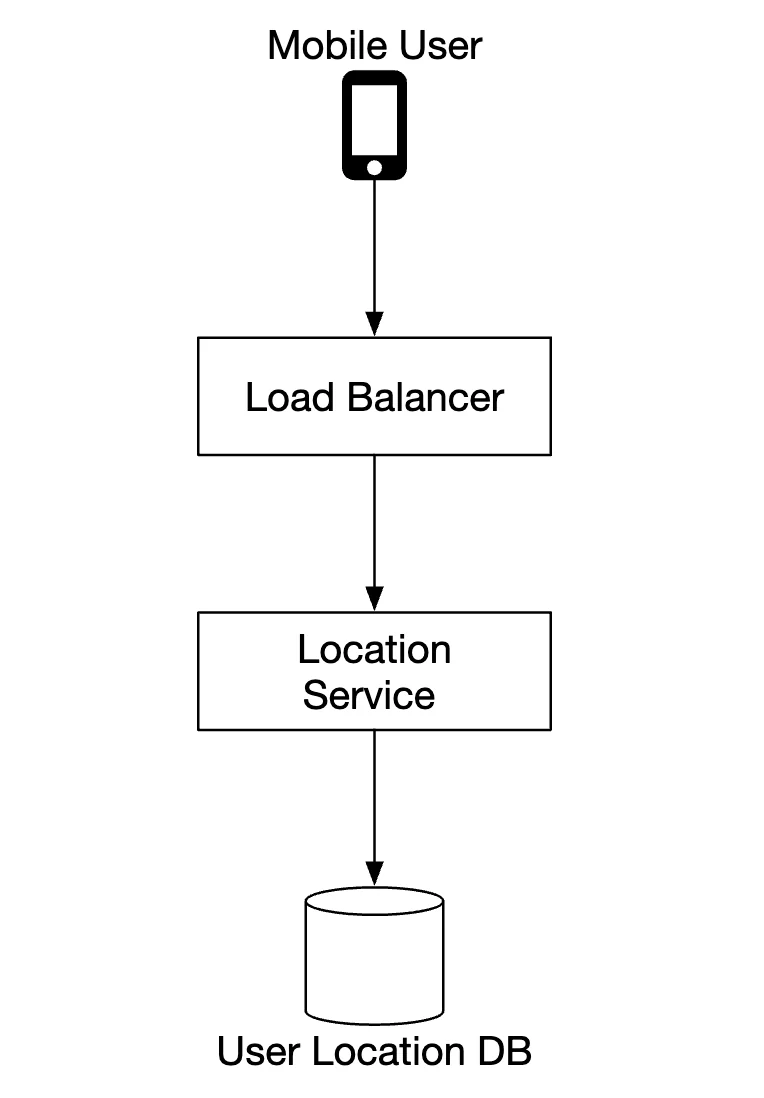
我们可以使用 NoSQL 数据库来承接位置更新带来的大量写入负载。我们把可用性置于一致性之上,因为用户位置数据经常变化,新的更新一到,旧数据就过时了。
我们选择 Cassandra 作为数据库,因为它很好地满足了我们的所有需求。
我们将要存储的行示例:
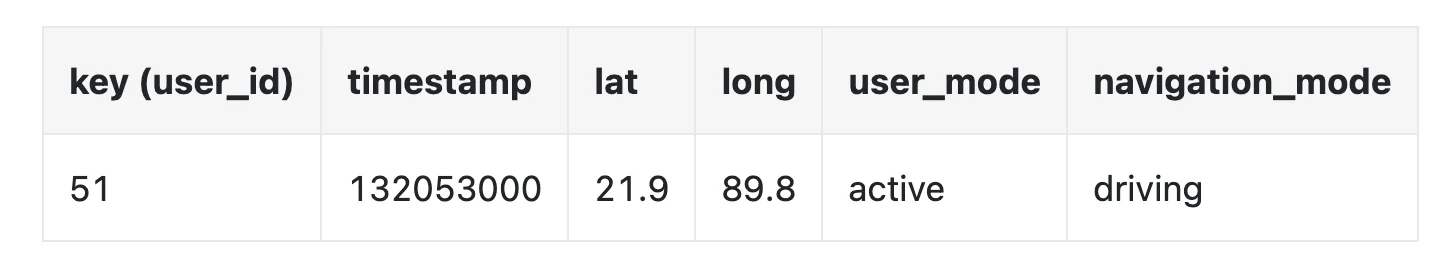
user_id是分区键(partition key),以便快速访问某个用户的所有位置更新。timestamp是聚簇键(clustering key),使数据按收到位置更新的时间排序存储。
我们还利用 Kafka,把位置更新以流的形式发送给其他各种出于不同目的需要位置更新的服务:
地图渲染
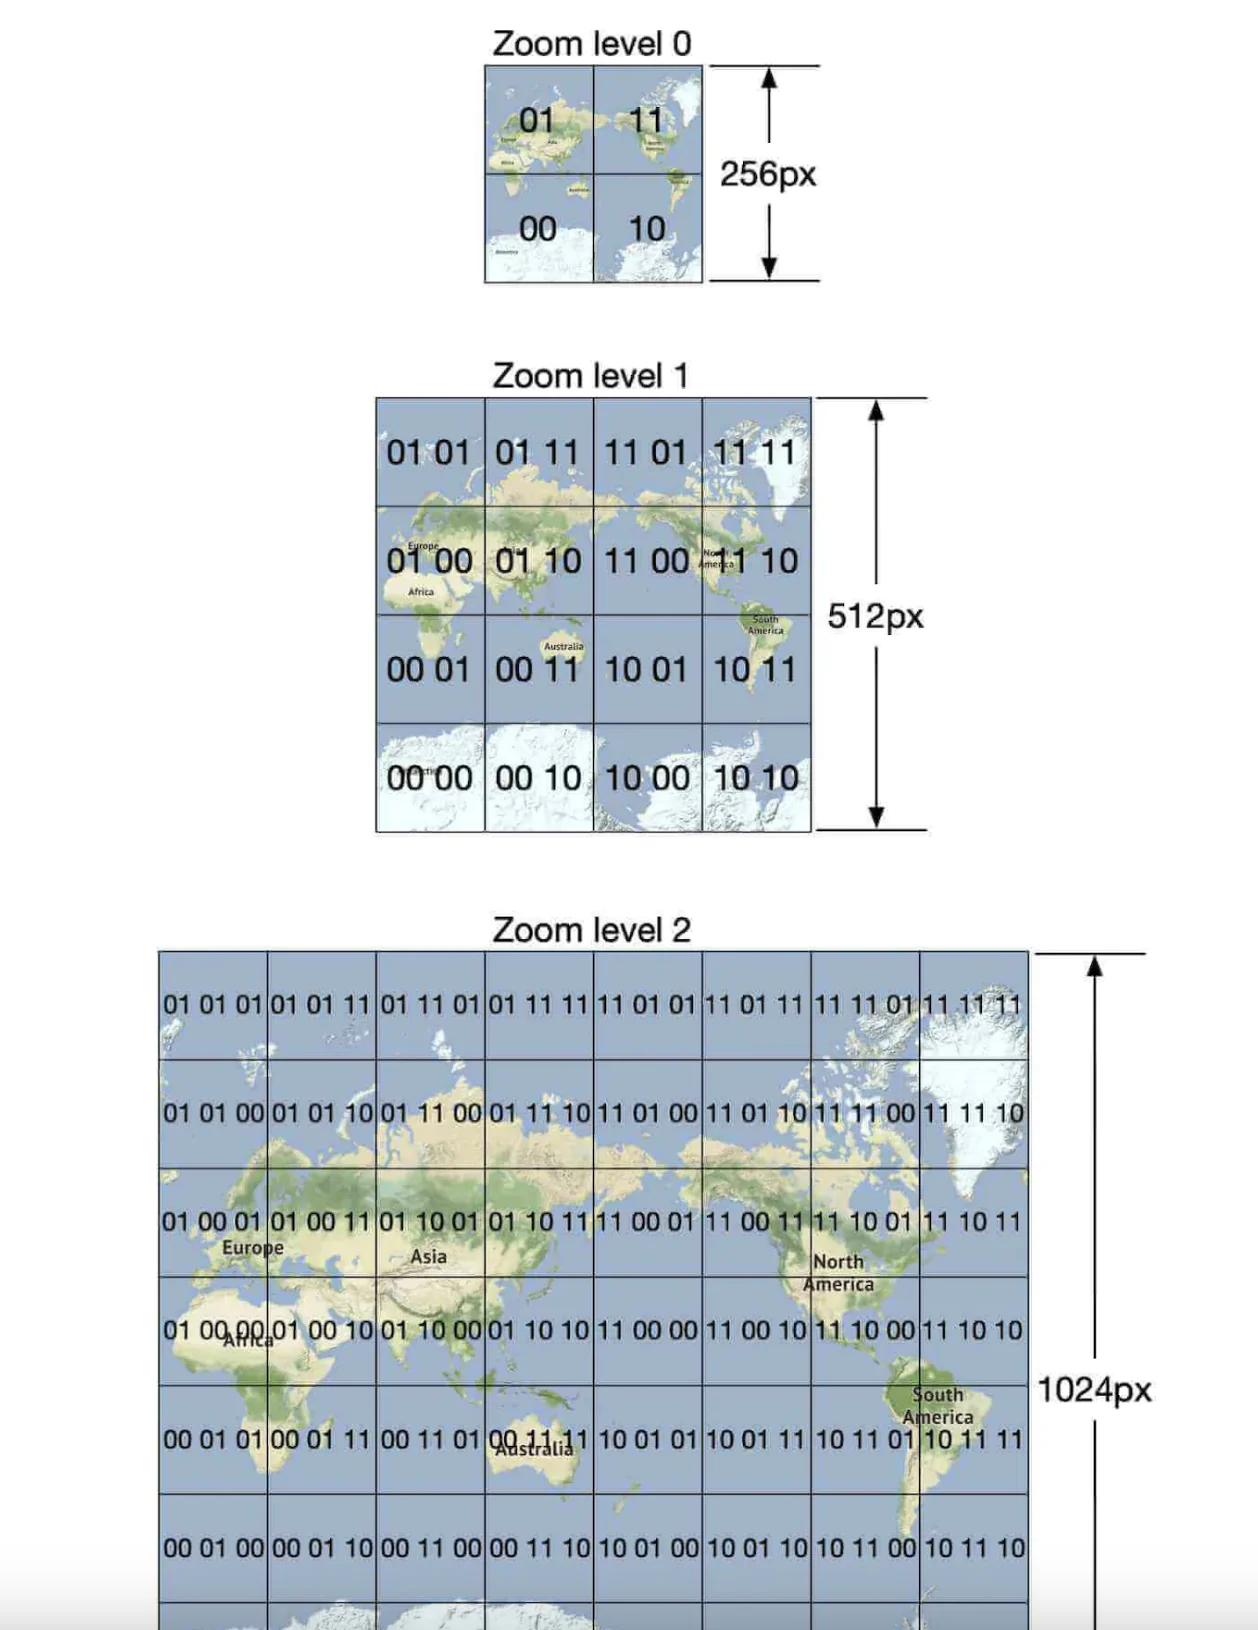
地图瓦片按不同的缩放级别存储。在最低缩放级别下,整个世界由一张 256x256 的瓦片表示。
缩放级别每增加一级,地图瓦片的数量就变为原来的四倍:
我们可以采用的一项优化是:不通过网络发送完整的图像信息,而是把瓦片表示为矢量(路径和多边形),让客户端动态渲染瓦片。
这将大幅节省带宽。
导航服务
该服务负责找出最快的路线:
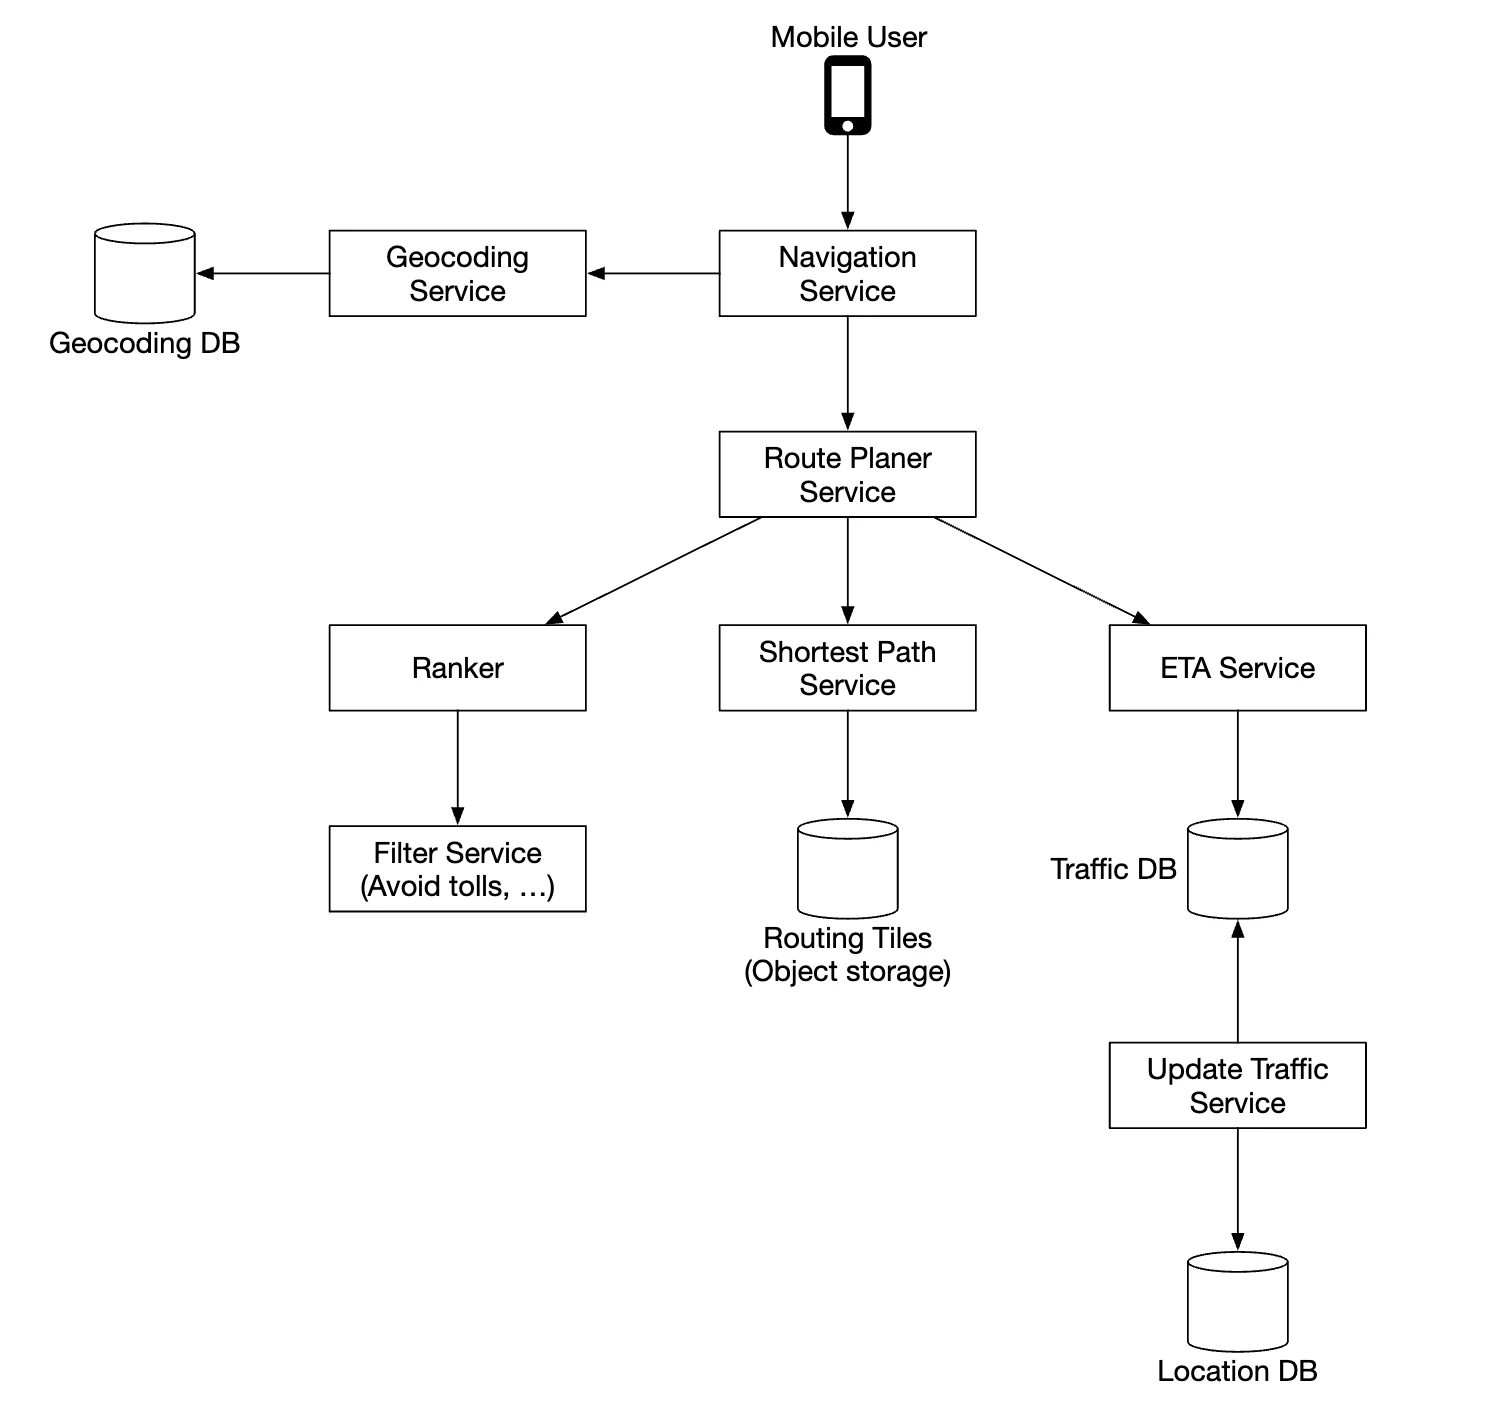
我们逐一看看这个子系统中的各个组件。
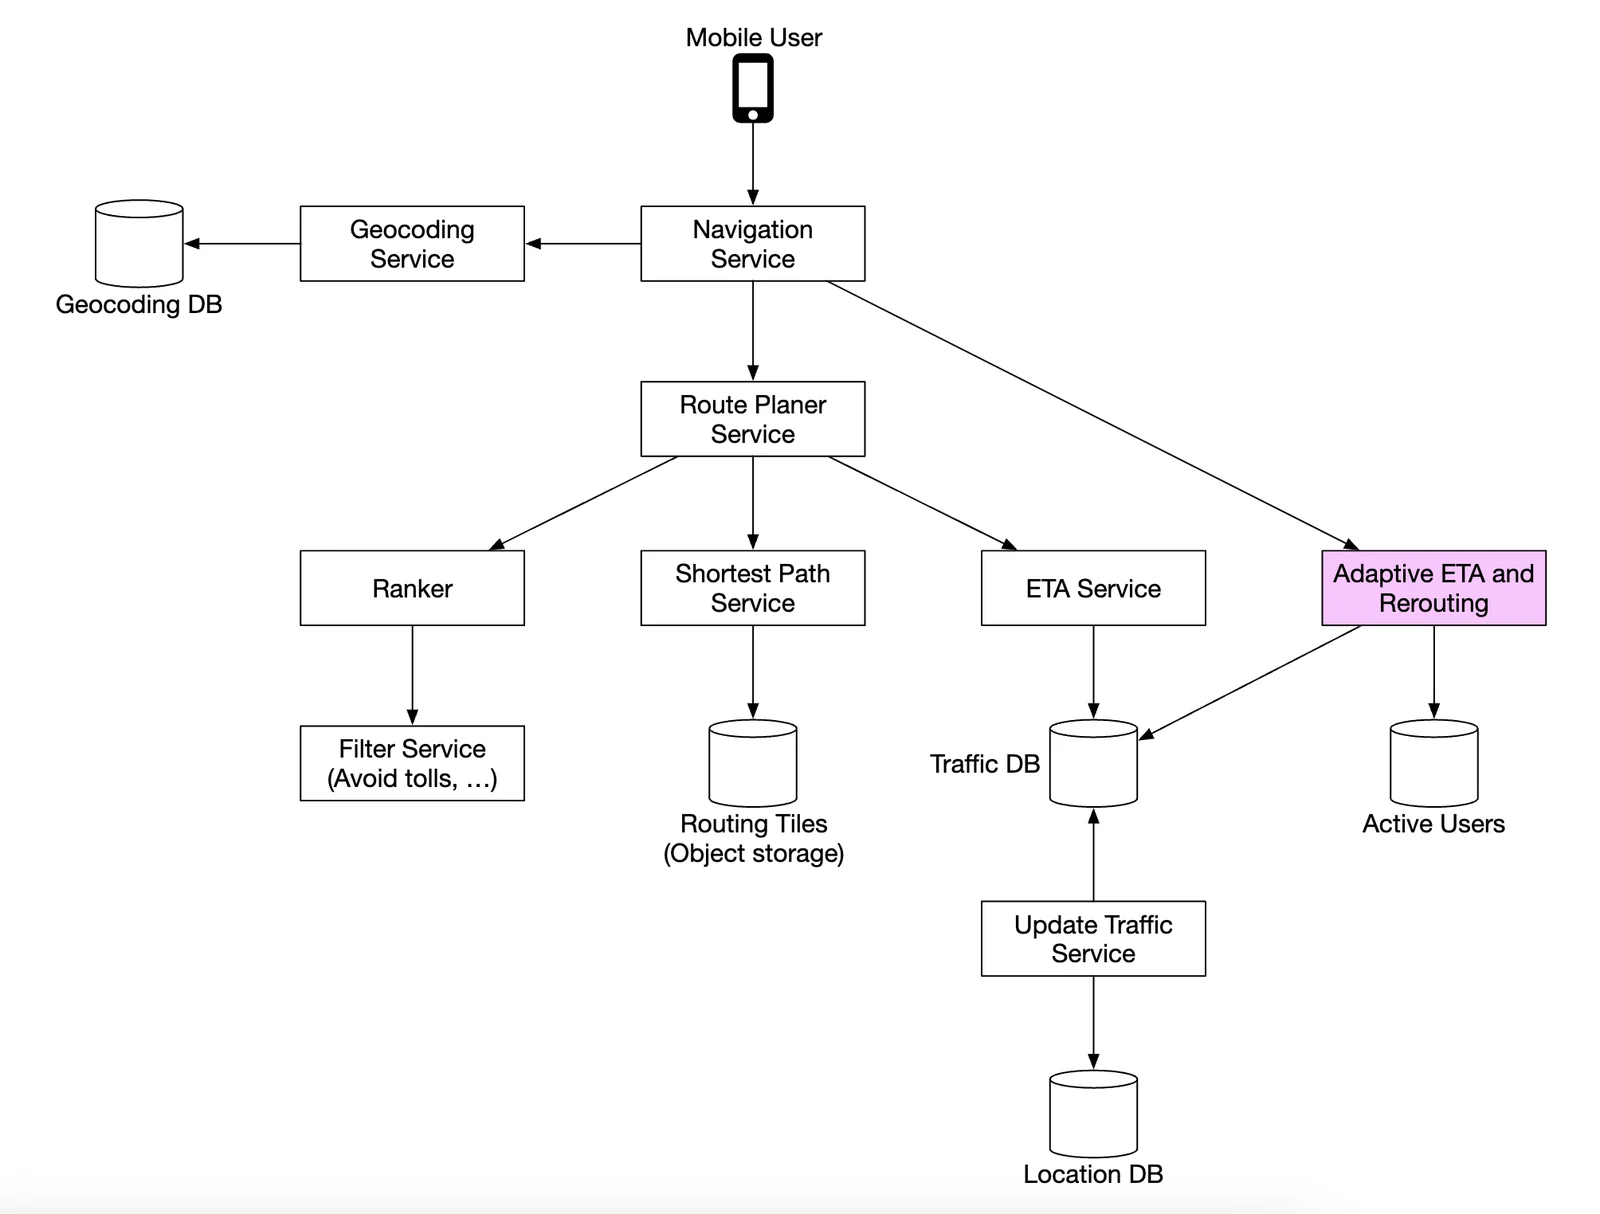
首先是地理编码服务,它把地址解析为一个经纬度对表示的位置。
请求示例:
https://maps.googleapis.com/maps/api/geocode/json?address=1600+Amphitheatre+Parkway,+Mountain+View,+CA
响应示例:
{
   "results" : [
      {
         "formatted_address" : "1600 Amphitheatre Parkway, Mountain View, CA 94043, USA",
         "geometry" : {
            "location" : {
               "lat" : 37.4224764,
               "lng" : -122.0842499
            },
            "location_type" : "ROOFTOP",
            "viewport" : {
               "northeast" : {
                  "lat" : 37.4238253802915,
                  "lng" : -122.0829009197085
               },
               "southwest" : {
                  "lat" : 37.4211274197085,
                  "lng" : -122.0855988802915
               }
            }
         },
         "place_id" : "ChIJ2eUgeAK6j4ARbn5u_wAGqWA",
         "plus_code": {
            "compound_code": "CWC8+W5 Mountain View, California, United States",
            "global_code": "849VCWC8+W5"
         },
         "types" : [ "street_address" ]
      }
   ],
   "status" : "OK"
}
路线规划服务根据当前路况计算出一条建议路线,以出行时间为优化目标。
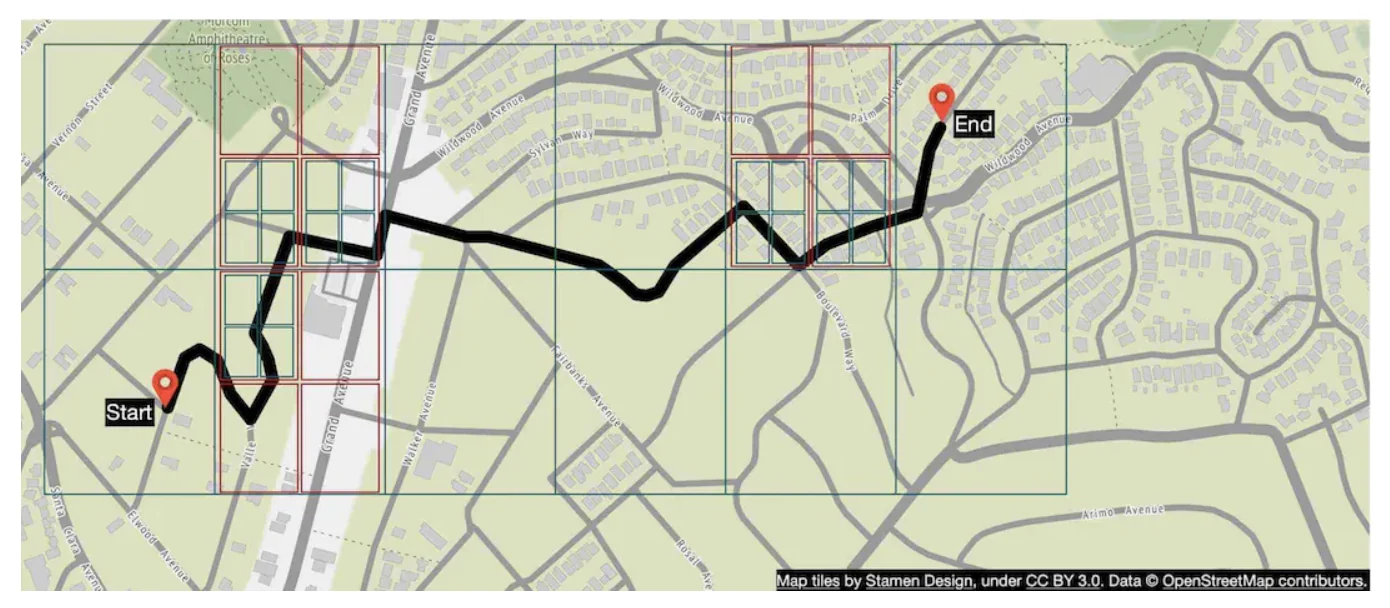
最短路径服务在对象存储中的路由瓦片上运行 A* 算法的一个变体,以计算出最优路径:
- 它接收起点/终点对,将其转换为经纬度对,再由这些经纬度对推导出 geohash,进而得到对应的路由瓦片。
- 算法从起始路由瓦片出发开始遍历,直到找到一条通往目的地瓦片的足够好的路径。
路线规划服务会调用 ETA 服务来获取预计时间,ETA 服务基于机器学习算法,根据路况数据预测 ETA。
排序服务负责根据用户传入的过滤条件(例如避开收费道路或高速公路的标志)对各条可能的路径进行排序。
更新服务异步地更新一些重要的数据库,使其保持最新。
改进:自适应 ETA 与重新规划路线
我们可以做的一项改进是:根据新获得的路况数据,自适应地更新正在进行中的路线。
一种实现方式是把当前正在按某条路线导航的用户存入数据库,同时存储他们将要经过的所有瓦片。
数据可能如下所示:
user_1: r_1, r_2, r_3, …, r_k
user_2: r_4, r_6, r_9, …, r_n
user_3: r_2, r_8, r_9, …, r_m
...
user_n: r_2, r_10, r21, ..., r_l
如果某个瓦片上发生了交通事故,我们就能找出所有路线经过该瓦片的用户,并为他们重新规划路线。
为了减少存储在数据库中的瓦片数量,我们可以改为存储起点路由瓦片,以及若干不同分辨率级别的路由瓦片,直到其中也包含了目的地瓦片为止:
user_1, r_1, super(r_1), super(super(r_1)), ...
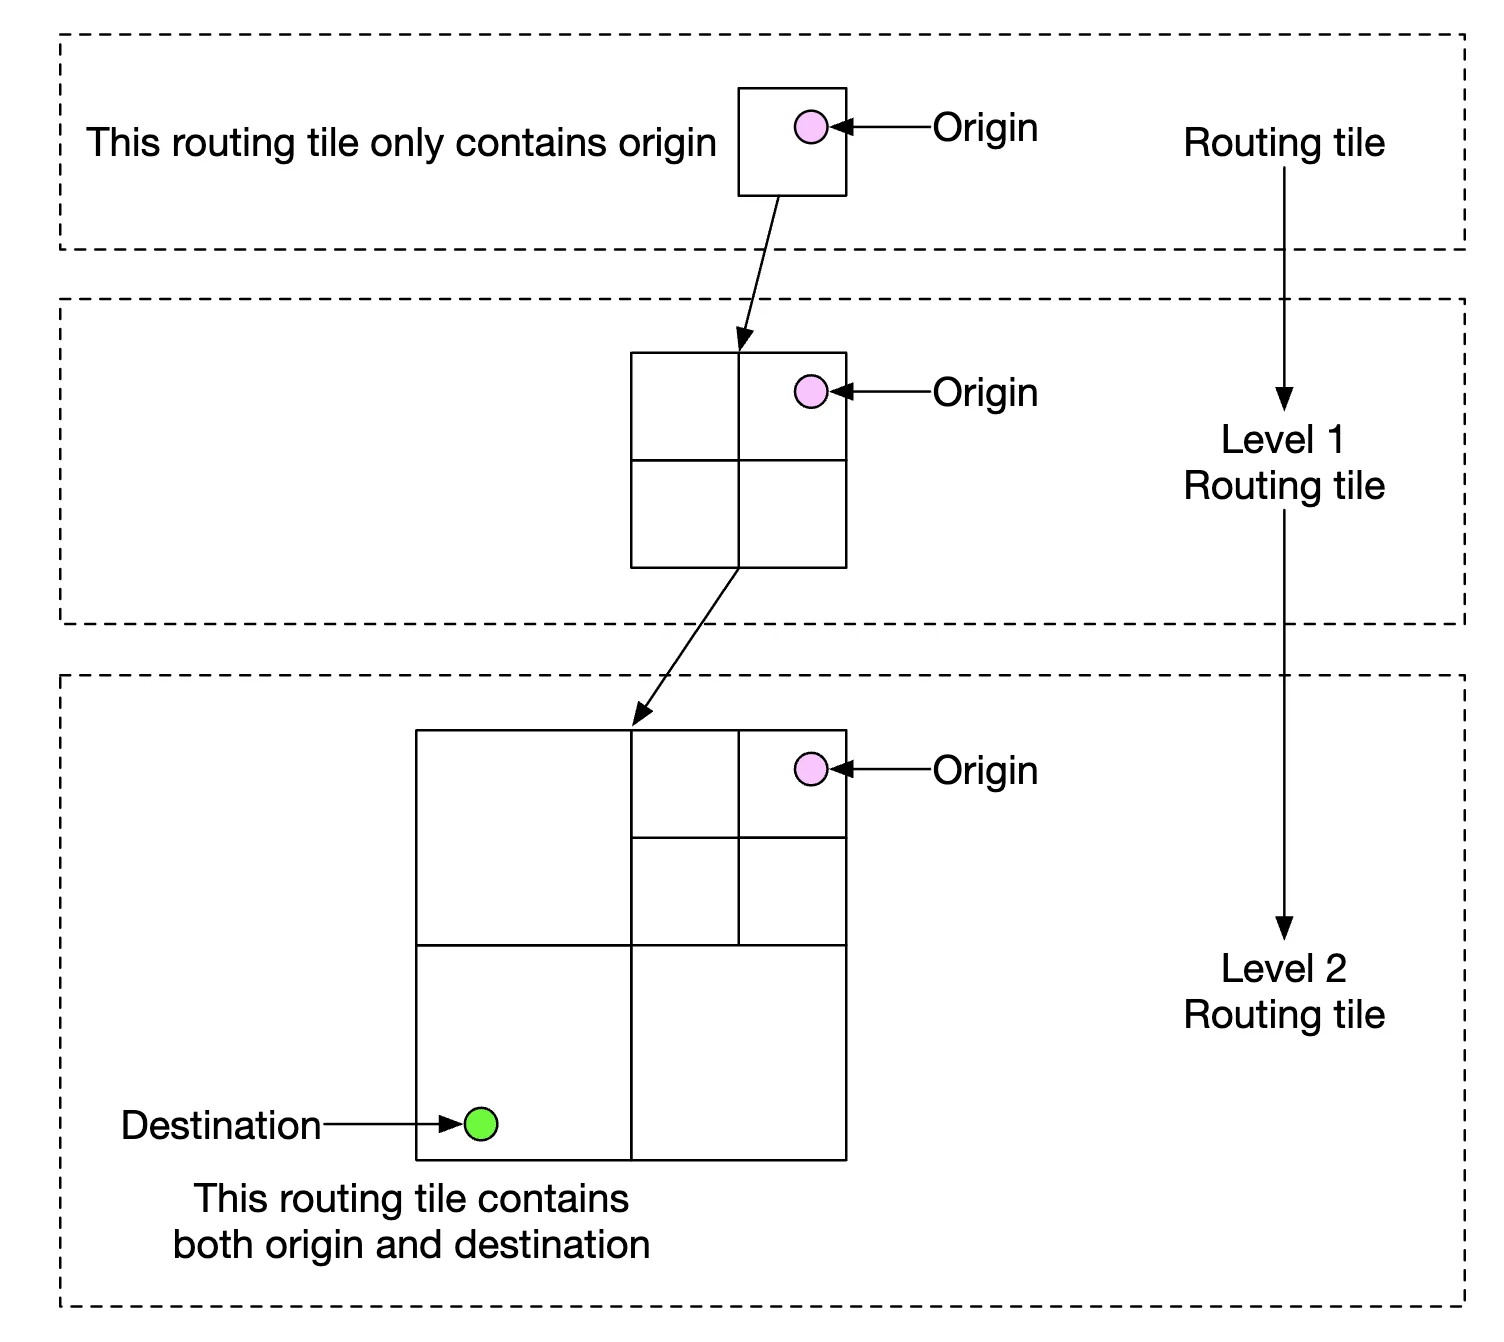
这样一来,我们只需检查用户的最后一个瓦片是否包含发生交通事故的瓦片,就能判断该用户是否受到影响。
我们还可以跟踪正在导航的用户所有可能的路线,一旦有更快的替代路线,就通知他们。
推送协议
有几种方案可以让服务器主动向客户端推送数据:
- 移动推送通知不可行,因为其负载大小有限,而且 Web 应用无法使用。
- WebSocket 通常比长轮询(long-polling)更好,因为它在服务器上占用的计算资源更少。
- 我们也可以使用服务器发送事件(Server-Sent Events,SSE),但更倾向于 WebSocket,因为它支持双向通信,这对诸如最后一公里配送之类的功能可能会很有用。
第 4 步:总结
这是我们的最终设计:
我们还可以提供的一项额外功能是多途经点导航,它可以卖给 Uber 或 Lyft 这样的企业客户,用来确定访问一组地点的最优路径。