第 28 章 证券交易所
引言
本章我们将设计一个电子证券交易所(Electronic Stock Exchange)。
它的基本功能是高效地撮合买方和卖方。
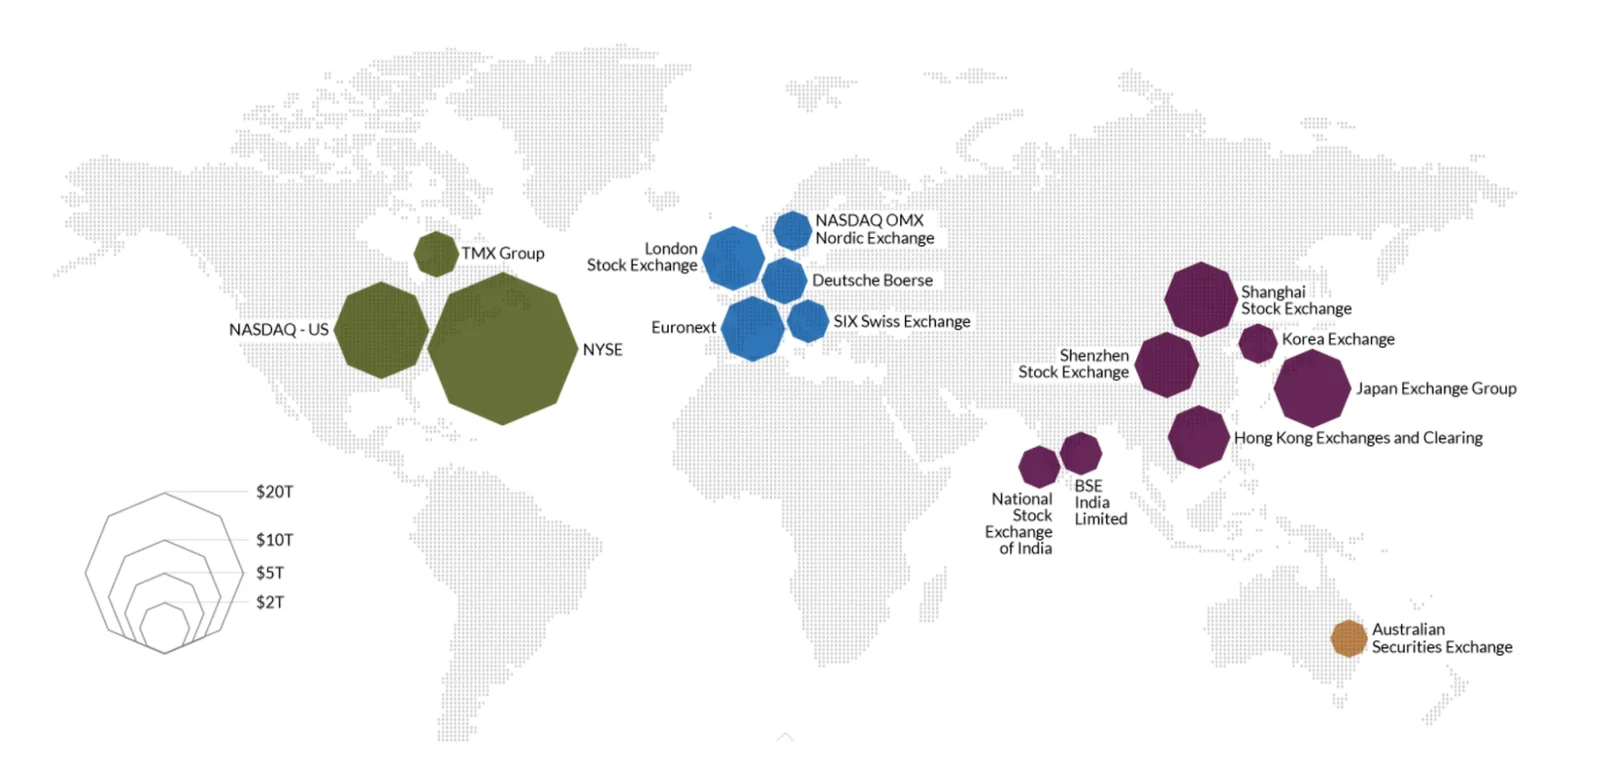
主要的证券交易所有 NYSE、NASDAQ 等。
第 1 步:理解问题并确定设计范围
- 候选人:我们要交易哪些证券?股票、期权还是期货?
- 面试官:为简单起见,只交易股票。
- 候选人:支持哪些订单操作:下单、撤单、改单?订单类型方面,限价单、市价单、条件单呢?
- 面试官:我们需要支持下单和撤单。订单类型只需考虑限价单。
- 候选人:系统需要支持盘后交易吗?
- 面试官:不需要,只支持正常交易时段。
- 候选人:能描述一下交易所的基本功能吗?
- 面试官:客户可以下限价单或撤销限价单,并实时收到已撮合的成交。他们应该能够实时看到订单簿。
- 候选人:交易所的规模有多大?
- 面试官:数万名用户同时交易,大约 100 个交易标的(Symbol)。每天数十亿笔订单。出于合规需要,我们还需要支持风险检查。
- 候选人:什么样的风险检查?
- 面试官:做些简单的风险检查就行,例如限制一个用户一天最多只能交易 100 万股苹果股票。
- 候选人:用户钱包方面需要怎么处理?
- 面试官:我们需要在下单前确保客户有足够的资金。用于挂单的资金需要被冻结,直到订单最终完成。
非功能性需求
面试官提到的规模暗示我们要设计的是一个中小规模的交易所。 我们还需要保证足够的灵活性,以便将来支持更多的交易标的和用户。
其他非功能性需求:
- 可用性:至少 99.99%。停机会损害声誉
- 容错:需要具备容错能力和快速恢复机制,以限制生产事故的影响
- 延迟:往返延迟应在毫秒级,重点关注第 99 百分位。持续偏高的 p99 延迟会让一小部分用户体验很差。
- 安全:我们应该有一个账户管理系统。为了满足法律合规,我们需要支持 KYC 来验证用户身份。对于公开资源,我们还应该防范 DDoS 攻击。
粗略估算
- 100 个交易标的,每天 10 亿笔订单
- 正常交易时段为 09:30 至 16:00(6.5 小时)
- QPS = 10 亿 / 6.5 / 3600 = 43000
- 峰值 QPS = 5*QPS = 215000
- 开盘时的交易量明显更高
第 2 步:提出高层设计并获得认可
业务知识入门
我们来讨论一些与交易所相关的基本概念。
经纪商(Broker)在交易所与终端用户之间充当中介,例如 Robinhood、Fidelity 等。
机构客户使用专门的交易软件进行大批量交易。他们需要特殊对待, 例如在大批量交易时进行拆单,以避免对市场造成冲击。
订单类型:
- 限价单(Limit):以固定价格买入或卖出。它可能无法立即找到对手方,也可能只被部分撮合。
- 市价单(Market):不指定价格。以当前市场价格立即成交。
价格:
- 买价(Bid):买方愿意买入股票的最高价格
- 卖价(Ask):卖方愿意卖出股票的最低价格
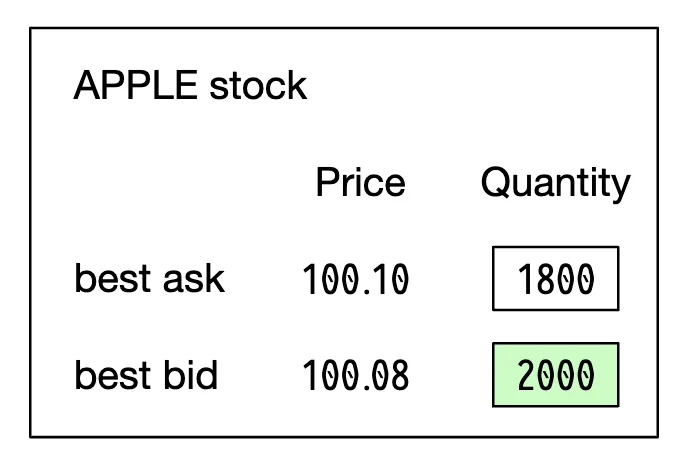
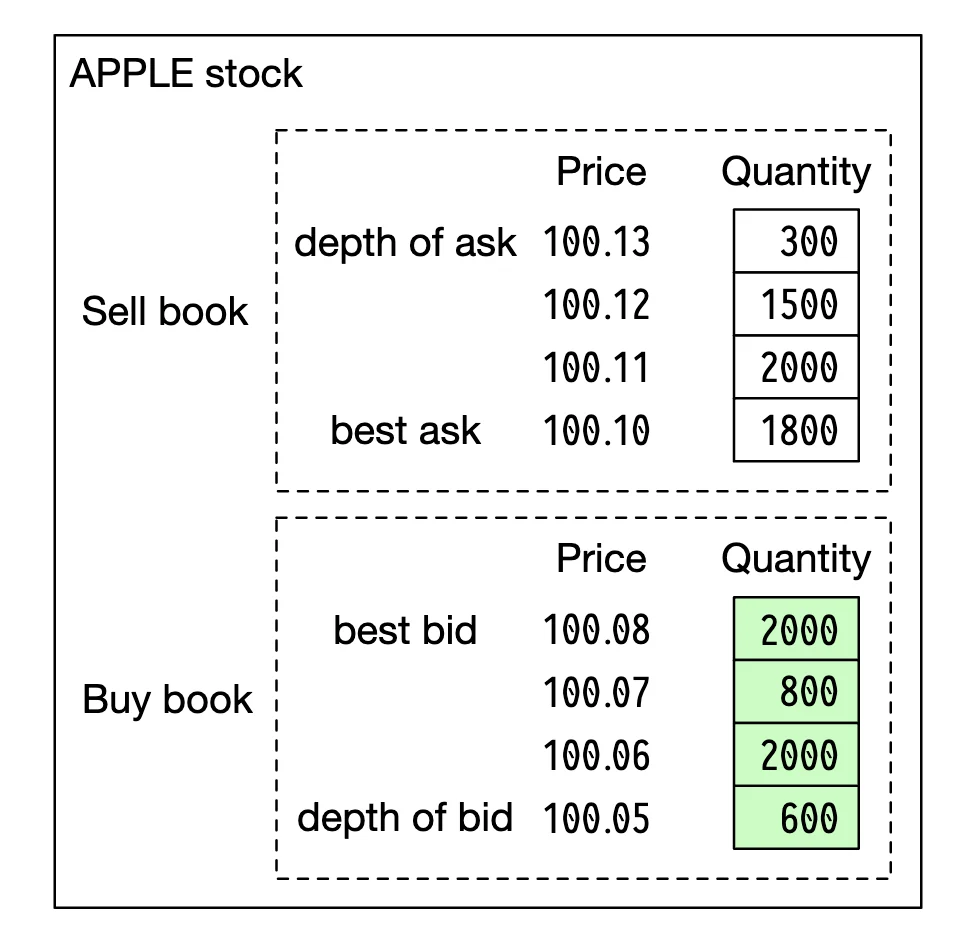
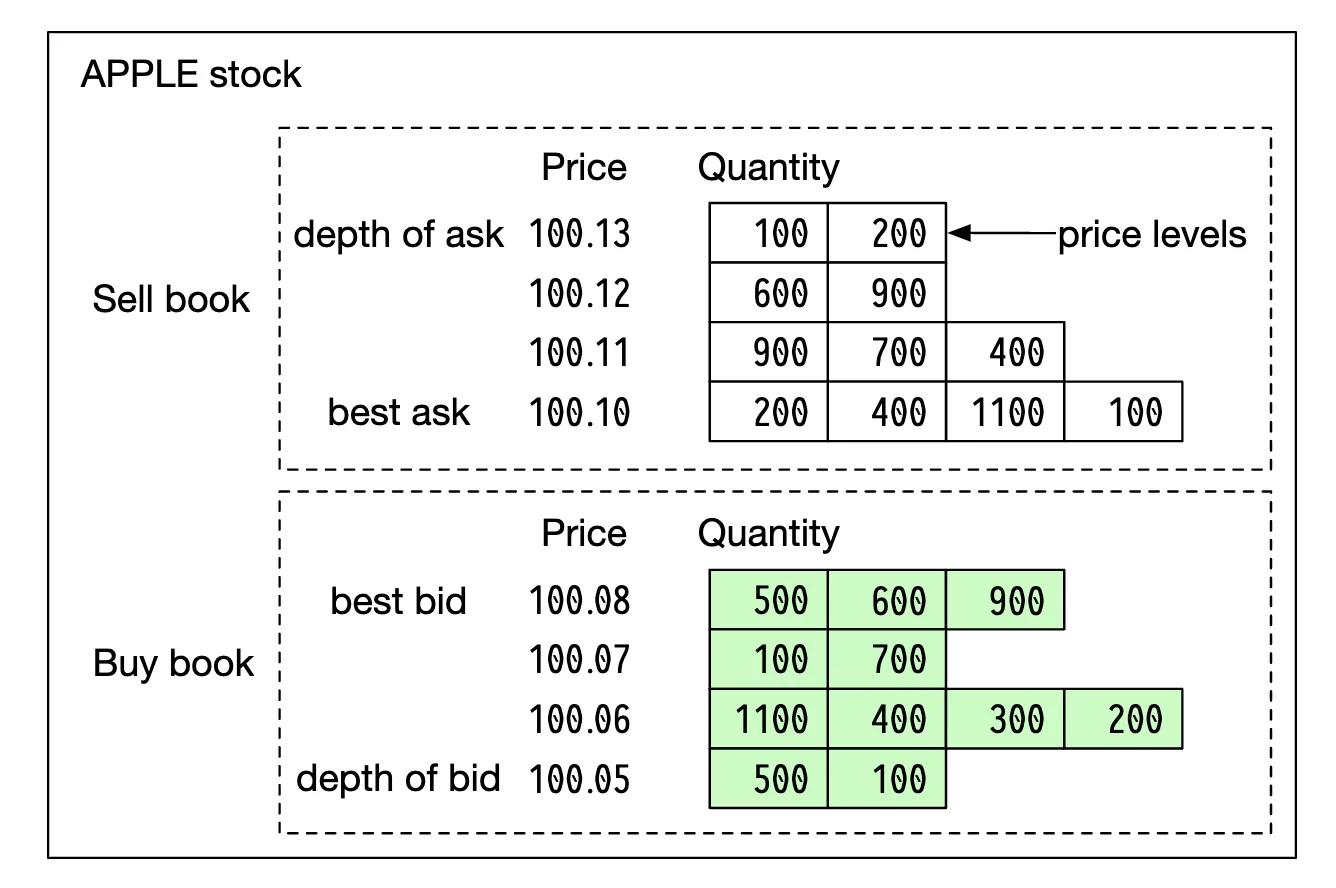
美国市场有三个层级的报价:L1、L2、L3。
L1 行情数据包含最优买/卖价格及其数量:
L2 包含更多的价格档位:
L3 显示各个价格档位,以及每个档位上排队的数量:
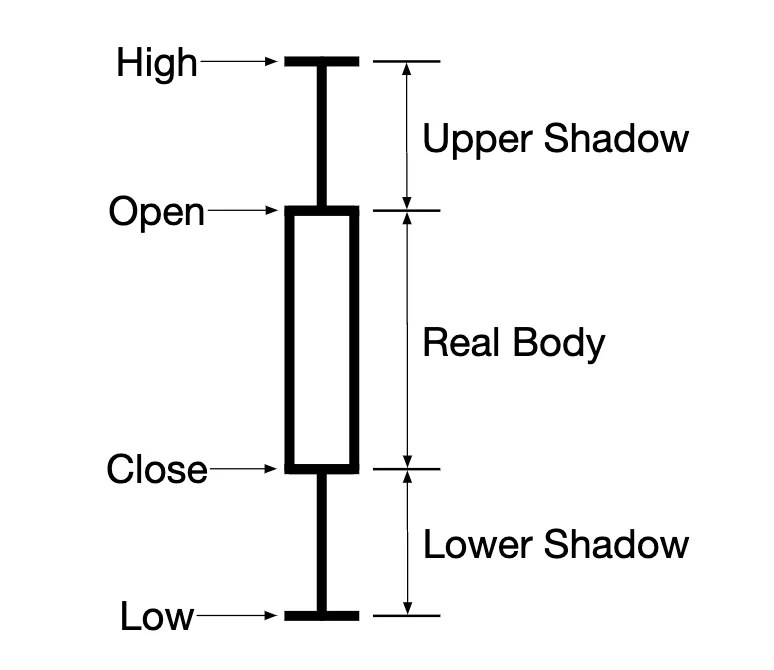
K 线(Candlestick)显示给定时间区间内市场的开盘价和收盘价,以及最高价和最低价:
FIX 是一种用于交换证券交易信息的协议,大多数厂商都在使用。证券交易示例:
8=FIX.4.2 | 9=176 | 35=8 | 49=PHLX | 56=PERS | 52=20071123-05:30:00.000 | 11=ATOMNOCCC9990900 | 20=3 | 150=E | 39=E | 55=MSFT | 167=CS | 54=1 | 38=15 | 40=2 | 44=15 | 58=PHLX EQUITY TESTING | 59=0 | 47=C | 32=0 | 31=0 | 151=15 | 14=0 | 6=0 | 10=128 |
高层设计
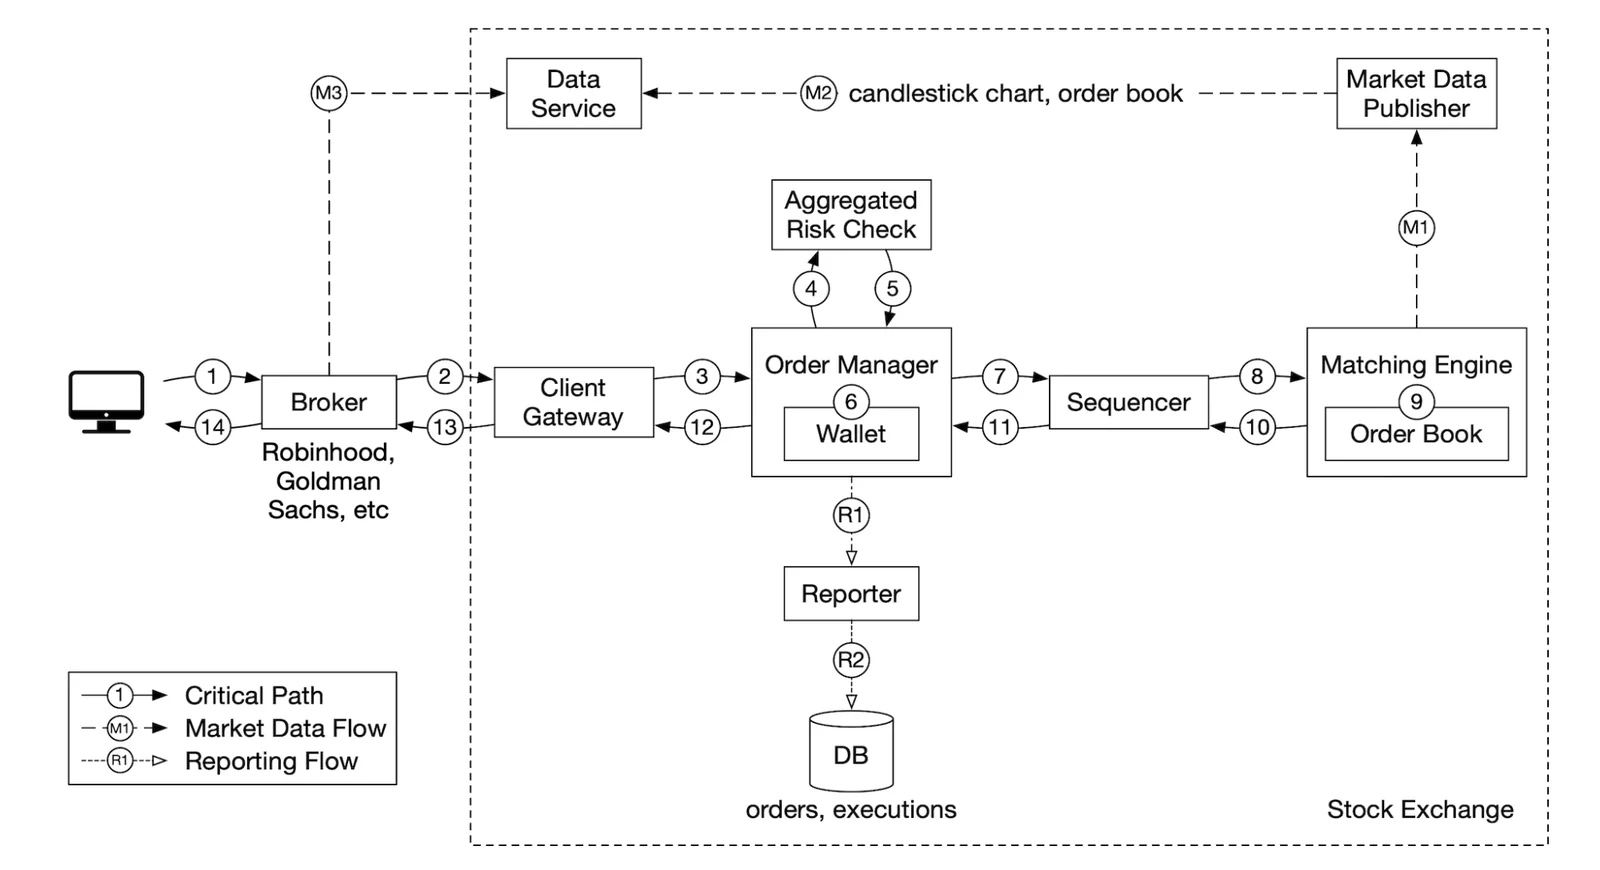
交易流程:
- 客户通过交易界面下单
- 经纪商把订单发送给交易所
- 订单通过客户端网关(Client Gateway)进入交易所,网关负责校验、限流、身份认证等。随后订单被转发给订单管理器(Order Manager)。
- 订单管理器根据风险管理器(Risk Manager)设定的规则执行风险检查
- 通过风险检查后,订单管理器核实钱包中有足够的资金来完成该订单
- 订单被发送到撮合引擎(Matching Engine)。找到匹配时,撮合引擎为买方和卖方各生成一条成交回报(称为 fill)。两个订单都会被排序,从而保证确定性。
- 成交回报被返回给客户。
行情数据流程(M1-M3):
- 撮合引擎生成成交流,发送给行情数据发布器(Market Data Publisher)
- 行情数据发布器构建 K 线图,并把它们发送给数据服务
- 行情数据被存储在专门的存储中,用于实时分析。经纪商连接到数据服务以获取及时的行情数据。
报告流程(R1-R2):
- 报告器(Reporter)从订单和成交中收集所有必要的报告字段,并写入数据库
- 报告字段:client_id、price、quantity、order_type、filled_quantity、remaining_quantity
交易流程位于关键路径上,而其余流程则不在关键路径上,因此它们之间的延迟要求有所不同。
交易流程
交易流程位于关键路径上,因此应当针对低延迟进行高度优化。
它的核心是撮合引擎,也称为交叉引擎(Cross Engine)。主要职责:
- 为每个交易标的维护订单簿(Order Book),即该标的的买/卖订单列表。
- 撮合买单和卖单:一次撮合会产生两条成交回报(fill),买方和卖方各一条。这个功能必须快速且准确
- 把成交流作为行情数据分发出去
- 撮合必须以确定性的顺序产生。这是高可用性的基础
接下来是定序器(Sequencer):它是让撮合引擎具备确定性的关键组件,会给每个入站订单和出站成交回报打上一个序列 ID。
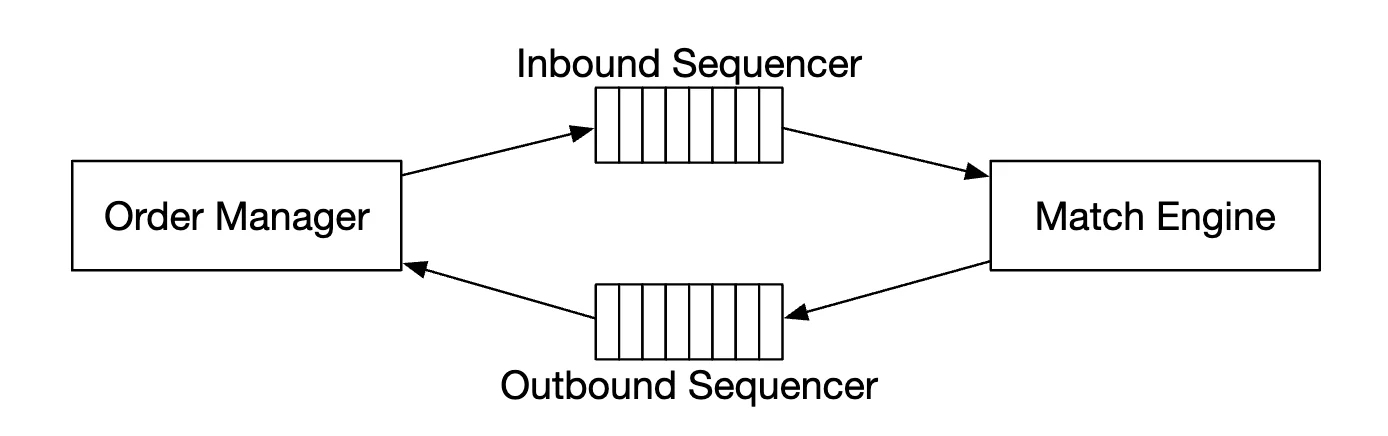
我们给入站订单和出站成交回报打序号,原因有以下几点:
- 及时性和公平性
- 快速恢复/重放
- 恰好一次(exactly-once)保证
从概念上讲,我们可以用 Kafka 作为定序器,因为它实际上就是一个入站和出站的消息队列。不过,为了获得更低的延迟,我们将自己实现它。
订单管理器管理订单状态。它还与撮合引擎交互:发送订单并接收成交回报。
订单管理器的职责:
- 把订单发去做风险检查,例如核实用户的交易量低于 100 万
- 用用户钱包核对订单,确认有足够的资金来执行它
- 把订单发送给定序器,再由定序器转给撮合引擎。为了减少带宽,只把必要的订单信息传给撮合引擎
- 从定序器接收返回的成交回报(fill),然后通过客户端网关把它们发送给经纪商
实现订单管理器的主要挑战在于状态转换管理。事件溯源(Event Sourcing)是一种可行的方案(在深入设计部分讨论)。
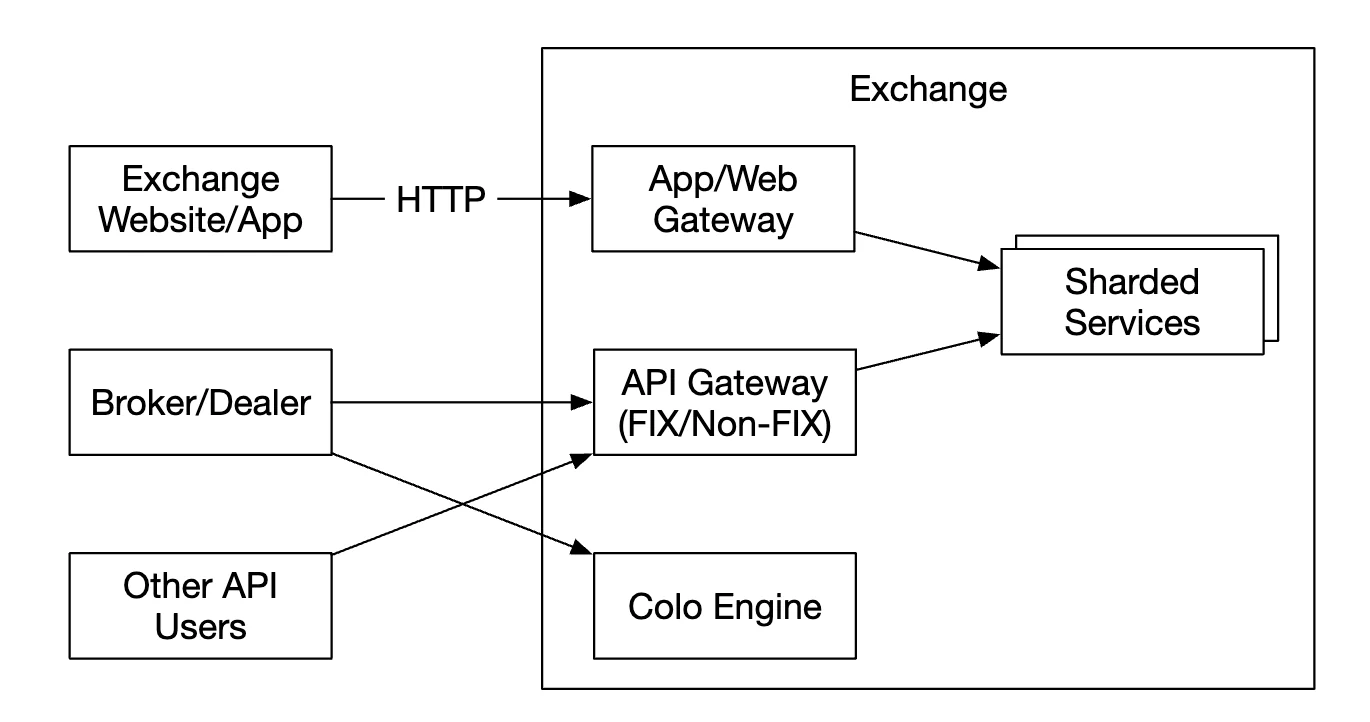
最后,客户端网关接收来自用户的订单,并把它们发送给订单管理器。它的职责:
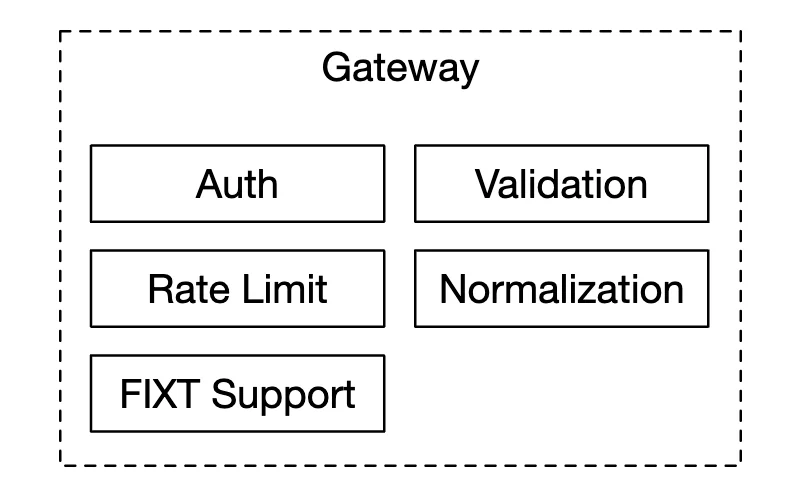
由于客户端网关位于关键路径上,它应当保持轻量。
针对不同的客户可以有多个客户端网关。例如,托管引擎(colo engine)是经纪商在交易所数据中心租用的交易引擎服务器:
行情数据流程
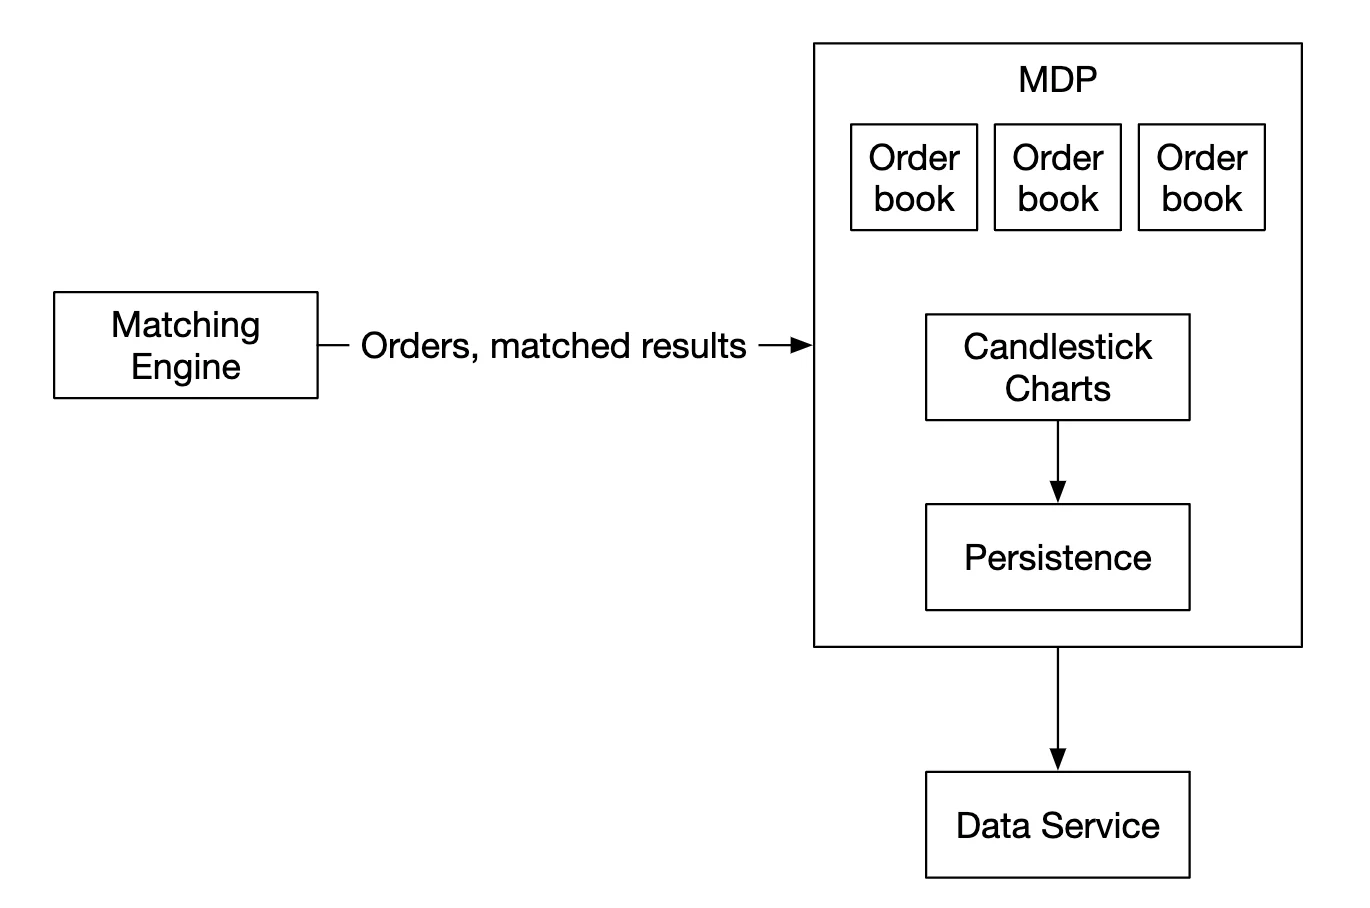
行情数据发布器从撮合引擎接收成交,并根据成交流构建订单簿/K 线图。
这些数据被发送给数据服务,数据服务负责向订阅者展示聚合后的数据:
报告流程
报告器不在关键路径上,但它仍然是一个重要的组件。
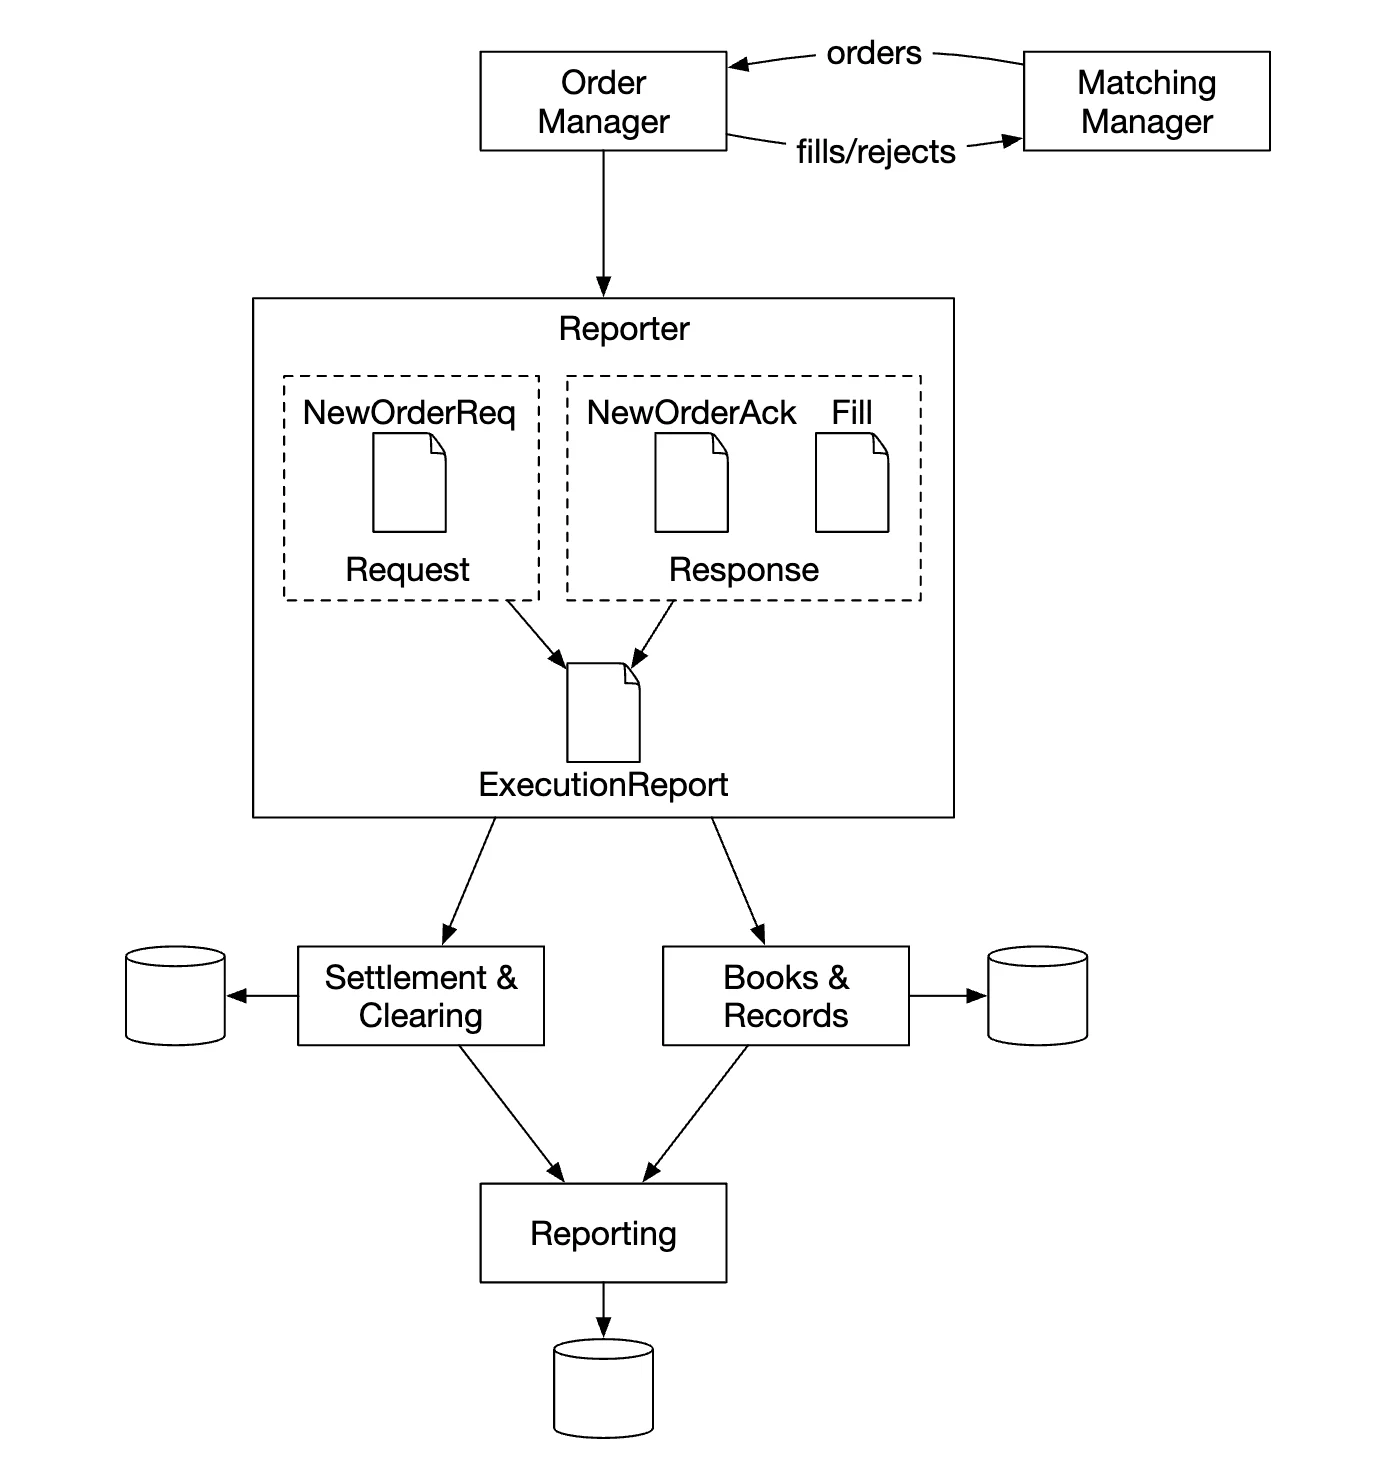
它负责交易历史、税务报告、合规报告、结算等。 对报告流程来说,延迟不是关键要求。准确性和合规性更为重要。
API 设计
客户通过经纪商与证券交易所交互,以便下单、查看成交、查看行情数据、下载历史数据用于分析等。
客户端网关与经纪商之间使用 RESTful API 通信。
对于机构客户,则使用专有协议来满足其低延迟需求。
创建订单:
POST /v1/order
参数:
- symbol:股票代码。String
- side:buy 或 sell。String
- price:限价单的价格。Long
- orderType:limit 或 market(我们的设计只支持限价单)。String
- quantity:订单数量。Long
响应:
- id:订单的 ID。Long
- creationTime:订单在系统中的创建时间。Long
- filledQuantity:已成功成交的数量。Long
- remainingQuantity:尚待成交的数量。Long
- status:new/canceled/filled。String
- 其余属性与输入参数相同
获取成交:
GET /execution?symbol={:symbol}&orderId={:orderId}&startTime={:startTime}&endTime={:endTime}
参数:
- symbol:股票代码。String
- orderId:订单的 ID。可选。String
- startTime:查询开始时间,以 epoch 表示 [11]。Long
- endTime:查询结束时间,以 epoch 表示。Long
响应:
- executions:包含范围内每条成交的数组(属性见下)。Array
- id:成交的 ID。Long
- orderId:订单的 ID。Long
- symbol:股票代码。String
- side:buy 或 sell。String
- price:成交价格。Long
- orderType:limit 或 market。String
- quantity:已成交数量。Long
获取订单簿:
GET /marketdata/orderBook/L2?symbol={:symbol}&depth={:depth}
参数:
- symbol:股票代码。String
- depth:订单簿每一侧的深度。Int
响应:
- bids:包含价格和数量的数组。Array
- asks:包含价格和数量的数组。Array
获取 K 线:
GET /marketdata/candles?symbol={:symbol}&resolution={:resolution}&startTime={:startTime}&endTime={:endTime}
参数:
- symbol:股票代码。String
- resolution:K 线图的窗口长度,单位为秒。Long
- startTime:窗口的开始时间,以 epoch 表示。Long
- endTime:窗口的结束时间,以 epoch 表示。Long
响应:
- candles:包含每根 K 线数据的数组(属性如下)。Array
- open:每根 K 线的开盘价。Double
- close:每根 K 线的收盘价。Double
- high:每根 K 线的最高价。Double
- low:每根 K 线的最低价。Double
数据模型
我们的交易所中主要有三类数据:
- 产品、订单、成交
- 订单簿
- K 线图
产品、订单、成交
产品描述了一个交易标的的属性:产品类型、交易代码、UI 显示代码等。
这些数据不会频繁变化,主要用于在 UI 中渲染。
订单表示一条买/卖指令。成交是出站的撮合结果。
数据模型如下:
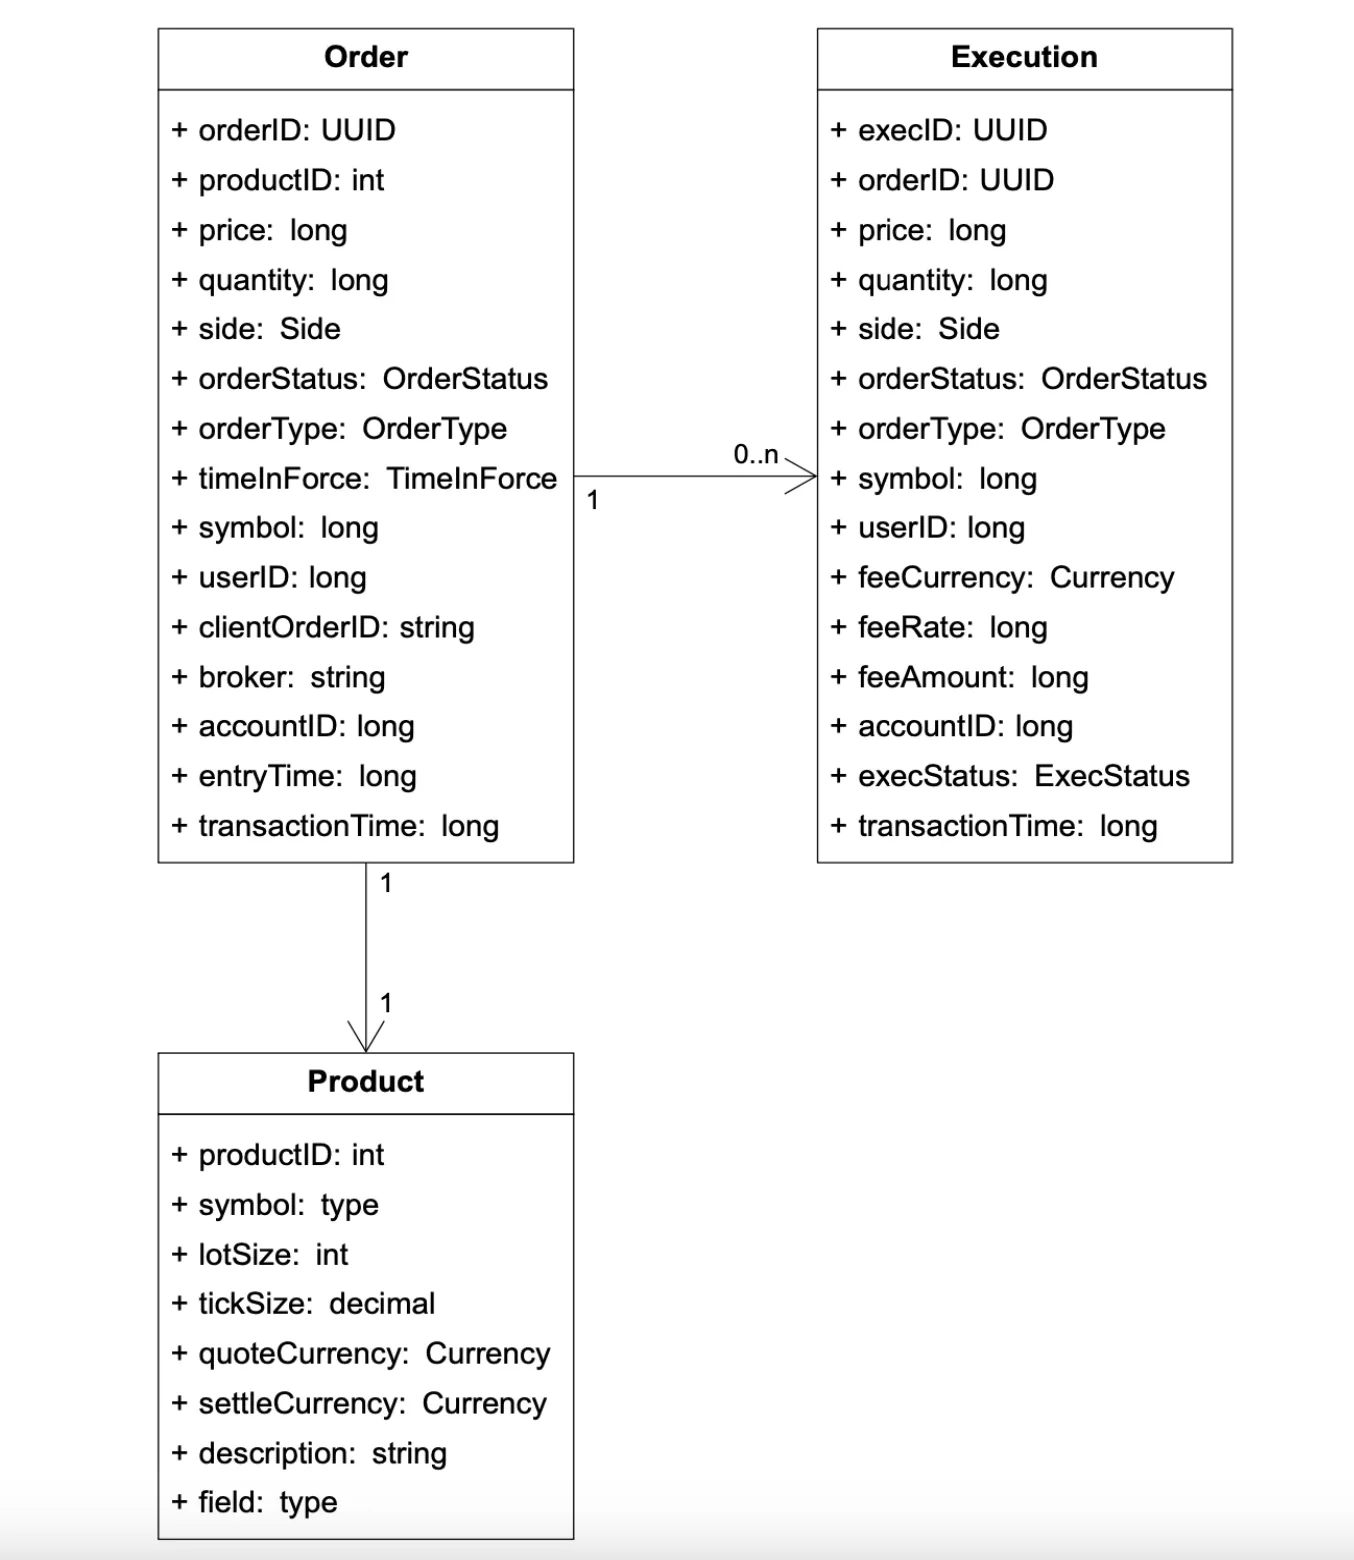
在全部三个流程中,我们都会遇到订单和成交:
- 在关键路径上,为了高性能,它们在内存中处理。它们由定序器存储,也从定序器恢复。
- 报告器把订单和成交写入数据库,用于报告场景
- 成交被转发给行情数据服务,用于重建订单簿和 K 线图
订单簿
订单簿是某个交易品种的买/卖订单列表,按价格档位组织。
适用于这个模型的高效数据结构需要满足:
- 常数时间的查找:获取某个价格档位或价格档位之间的成交量
- 快速的新增/成交/撤销操作
- 查询最优买/卖价格
- 遍历价格档位
订单簿成交示例:
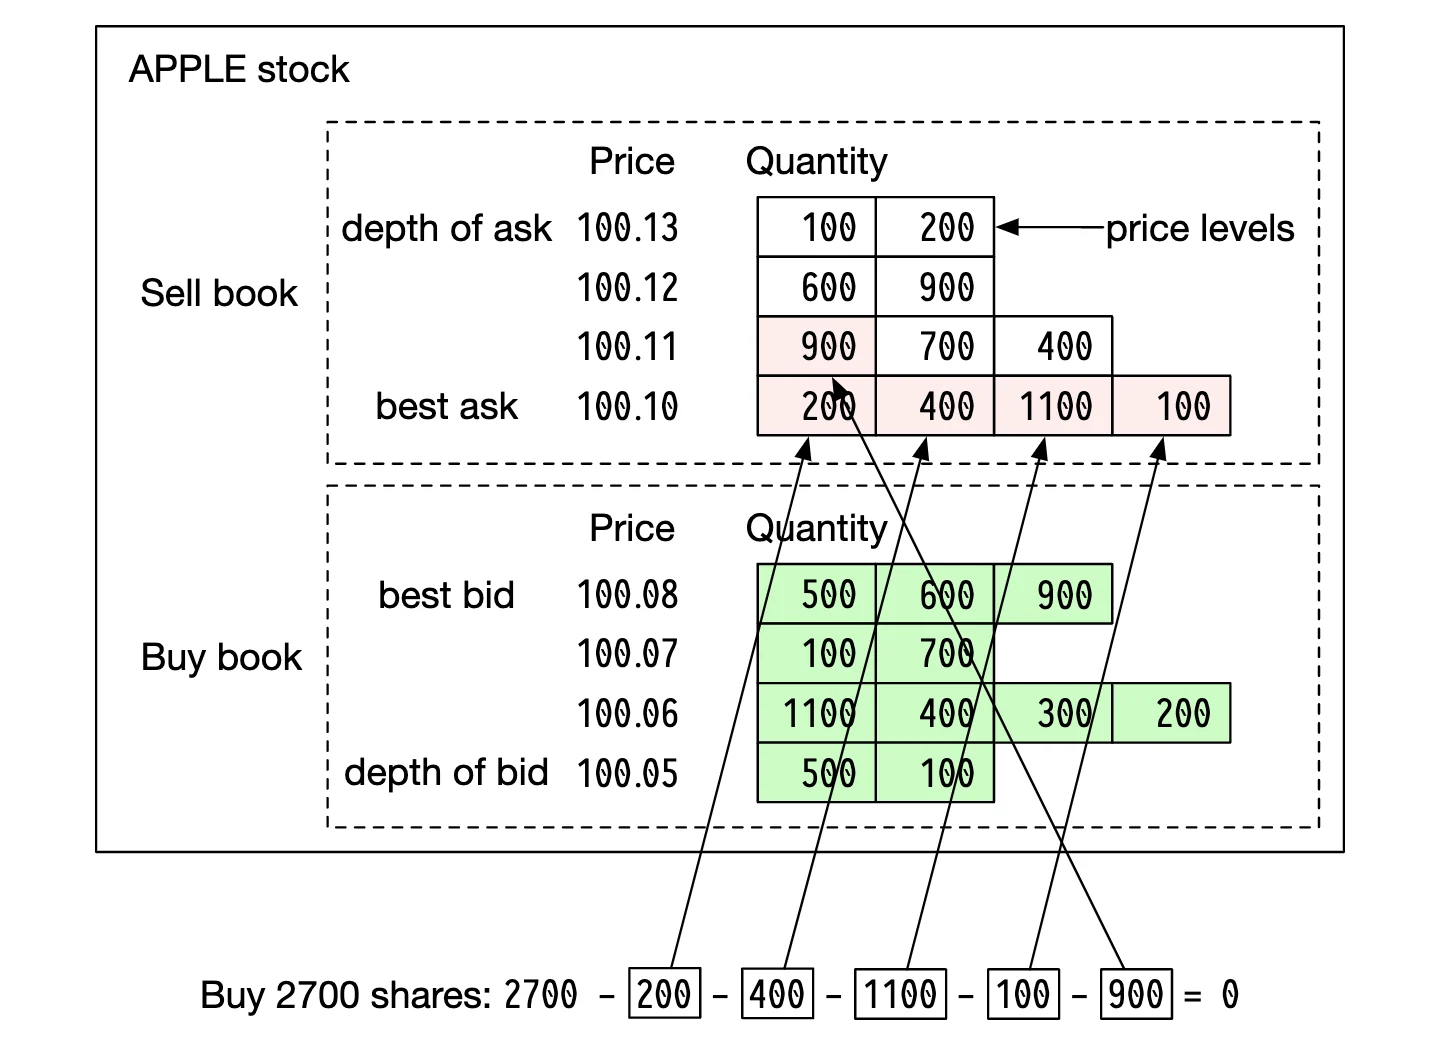
在这笔大单成交之后,随着买卖价差扩大,价格上涨。
订单簿实现的伪代码示例:
class PriceLevel{
    private Price limitPrice;
    private long totalVolume;
    private List<Order> orders;
}

class Book<Side> {
    private Side side;
    private Map<Price, PriceLevel> limitMap;
}

class OrderBook {
    private Book<Buy> buyBook;
    private Book<Sell> sellBook;
    private PriceLevel bestBid;
    private PriceLevel bestOffer;
    private Map<OrderID, Order> orderMap;
}
为了实现得更高效,我们可以用双向链表代替标准列表:
- 下新单是 O(1),因为我们是把订单添加到链表尾部。
- 撮合订单是 O(1),因为我们是从链表头部删除订单
- 撤单意味着从订单簿中删除一个订单。我们借助
orderMap实现 O(1) 查找和 O(1) 删除(因为Order持有对链表中前一个元素的引用)。
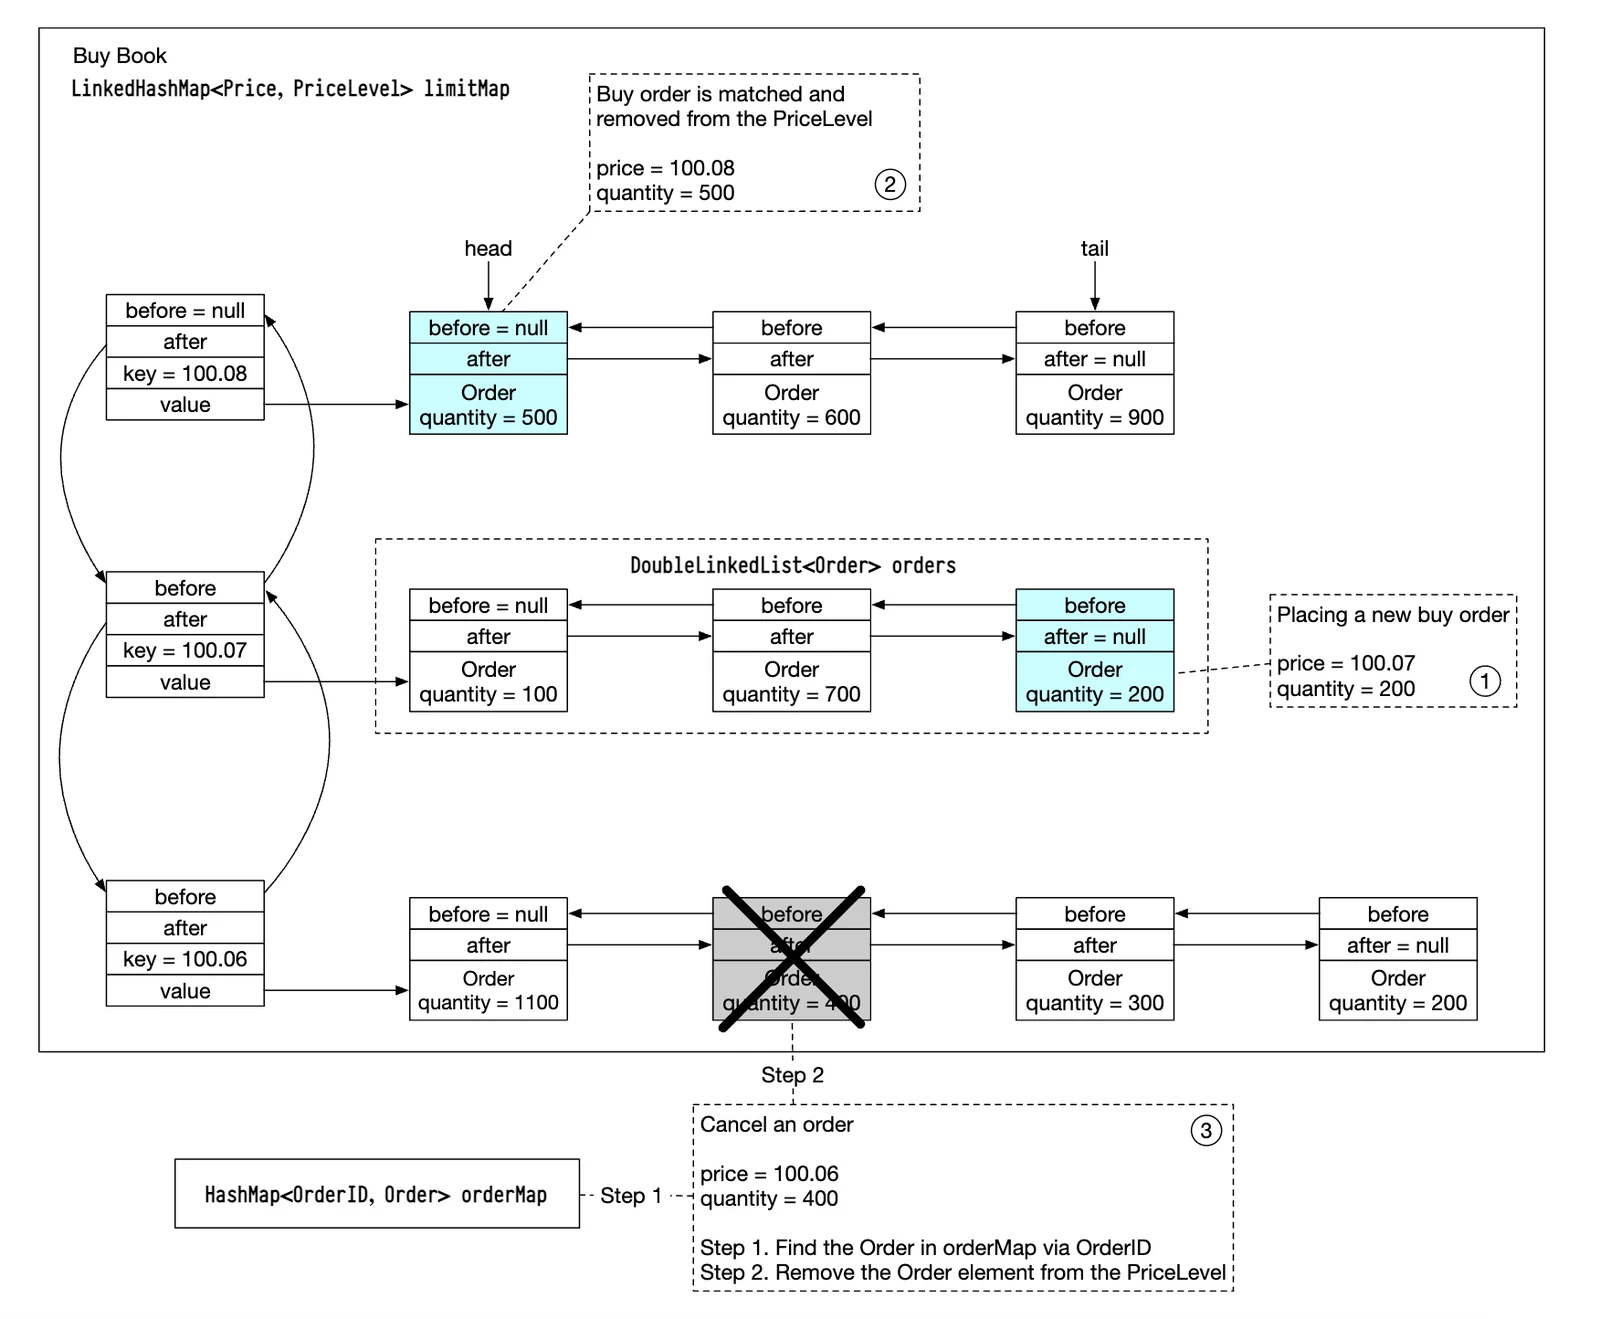
行情数据服务也使用这种数据结构来重建订单簿。
K 线图
K 线数据在行情数据服务中,根据某个时间区间内处理的订单计算得出:
class Candlestick {
    private long openPrice;
    private long closePrice;
    private long highPrice;
    private long lowPrice;
    private long volume;
    private long timestamp;
    private int interval;
}

class CandlestickChart {
    private LinkedList<Candlestick> sticks;
}
为了避免占用过多内存,可以做一些优化:
- 使用预分配的环形缓冲区(Ring Buffer)来存放 K 线,以减少内存分配次数
- 限制内存中 K 线的数量,其余部分持久化到磁盘
我们将使用内存列式数据库(例如 KDB)来做实时分析。收盘后,数据会被持久化到历史数据库中。
第 3 步:深入设计
关于现代交易所,有一点值得注意:与大多数其他软件不同,它们通常把所有东西都运行在一台巨型服务器上。
我们来看看其中的细节。
性能
对交易所来说,在所有百分位上都有良好的整体延迟是非常重要的。
如何降低延迟?
- 减少关键路径上的任务数量
- 通过减少网络/磁盘使用和/或缩短任务执行时间,来缩短每个任务所花的时间
为了实现第一个目标,我们把所有无关的职责都从关键路径上剥离了,为了获得最佳延迟,甚至连日志都去掉了。
如果沿用最初的设计,会有几个瓶颈:服务之间的网络延迟,以及定序器的磁盘使用。
采用那样的设计,我们能实现几十毫秒的端到端延迟。而我们想要实现的是几十微秒。
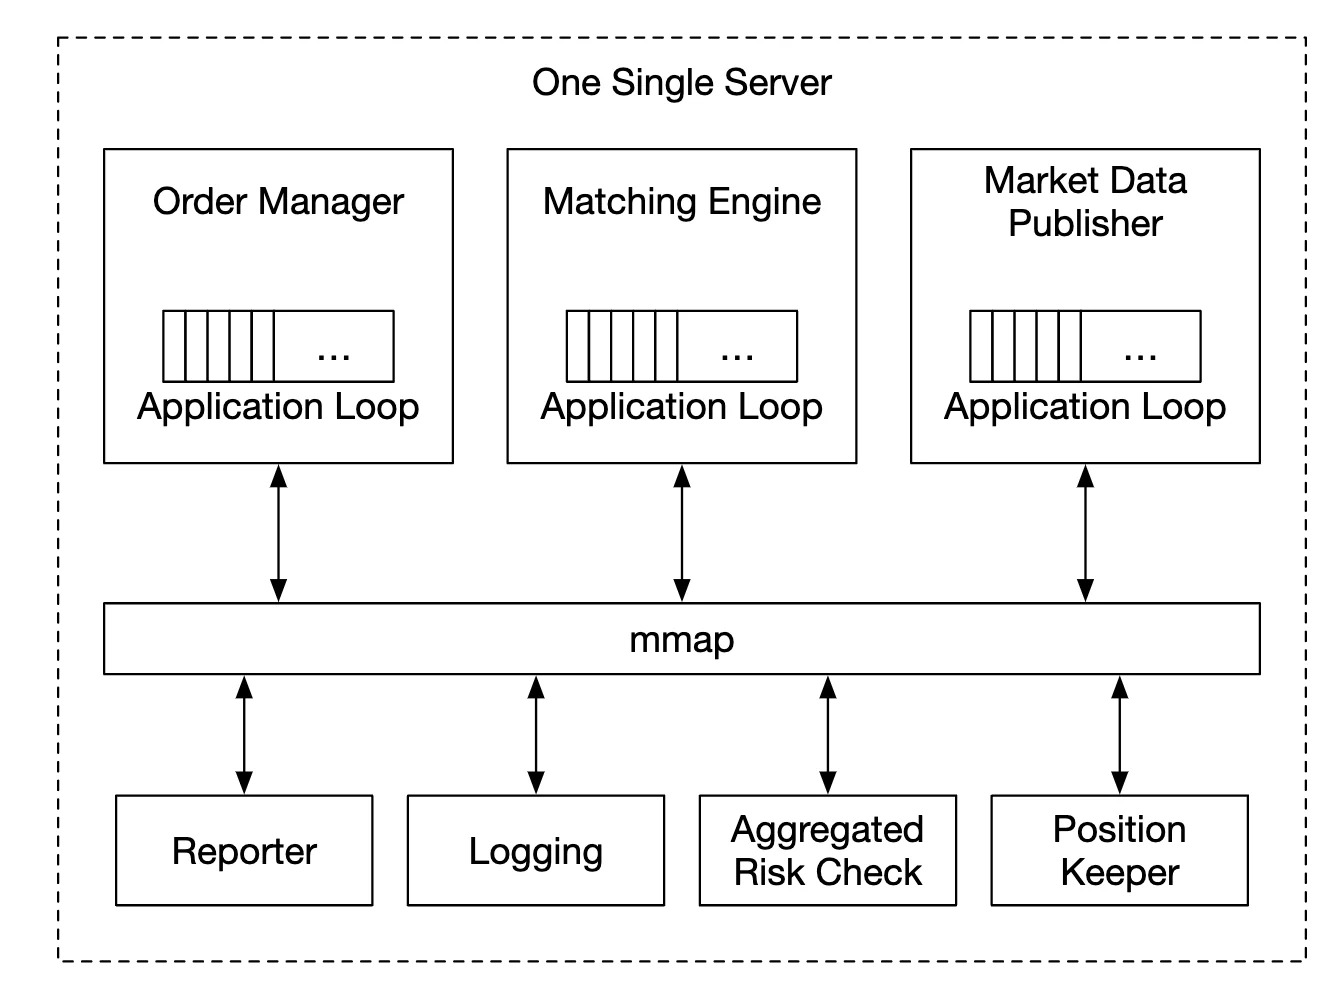
因此,我们会把所有东西放到一台服务器上,各进程之间通过作为事件存储的 mmap 进行通信:
另一个优化是使用应用循环(Application Loop,即执行关键任务的 while 循环),并把它绑定到同一个 CPU 上,以避免上下文切换:
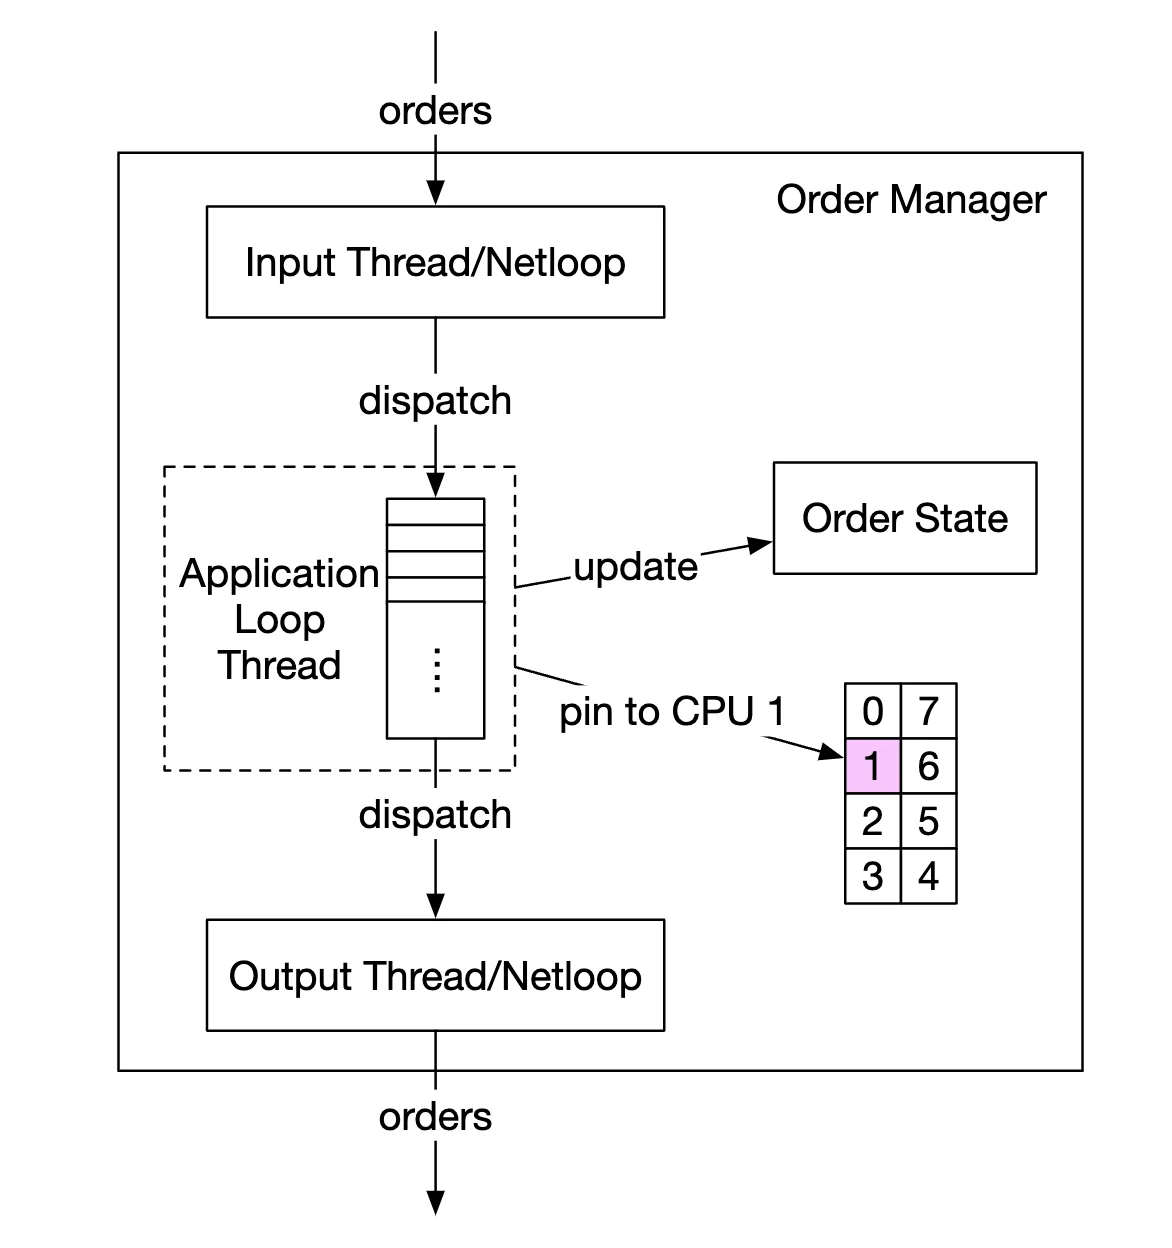
使用应用循环的另一个附带效果是不存在锁竞争,即多个线程争抢同一资源的情况。
现在我们来看看 mmap 是如何工作的:它是一个 UNIX 系统调用,把磁盘上的文件映射到应用程序的内存中。
我们可以用的一个技巧是在 /dev/shm 中创建文件,shm 代表“共享内存(shared memory)”。这样一来,我们就完全不需要访问磁盘了。
事件溯源
事件溯源在数字钱包一章中有深入讨论。完整细节请参阅该章。
简而言之,我们存储的不是当前状态,而是不可变的状态转换:
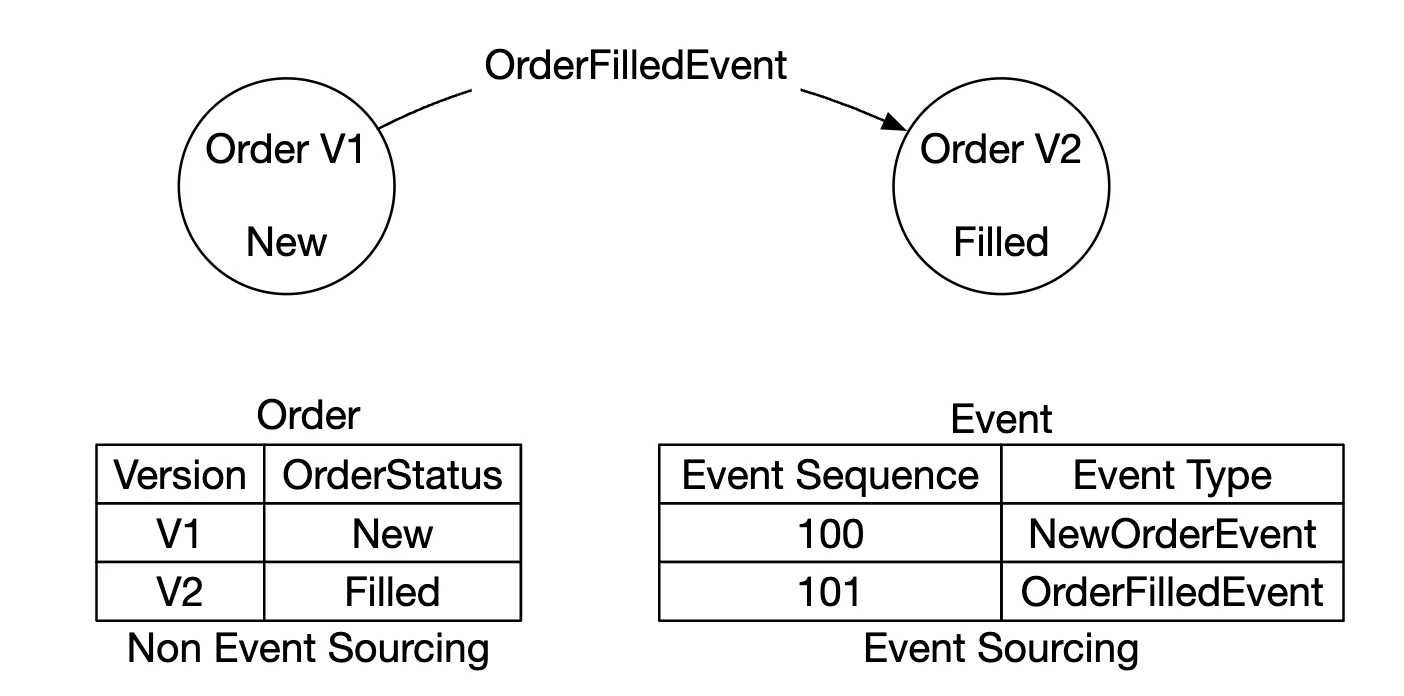
- 左边:传统的模式
- 右边:事件溯源的模式
到目前为止,我们的设计如下:
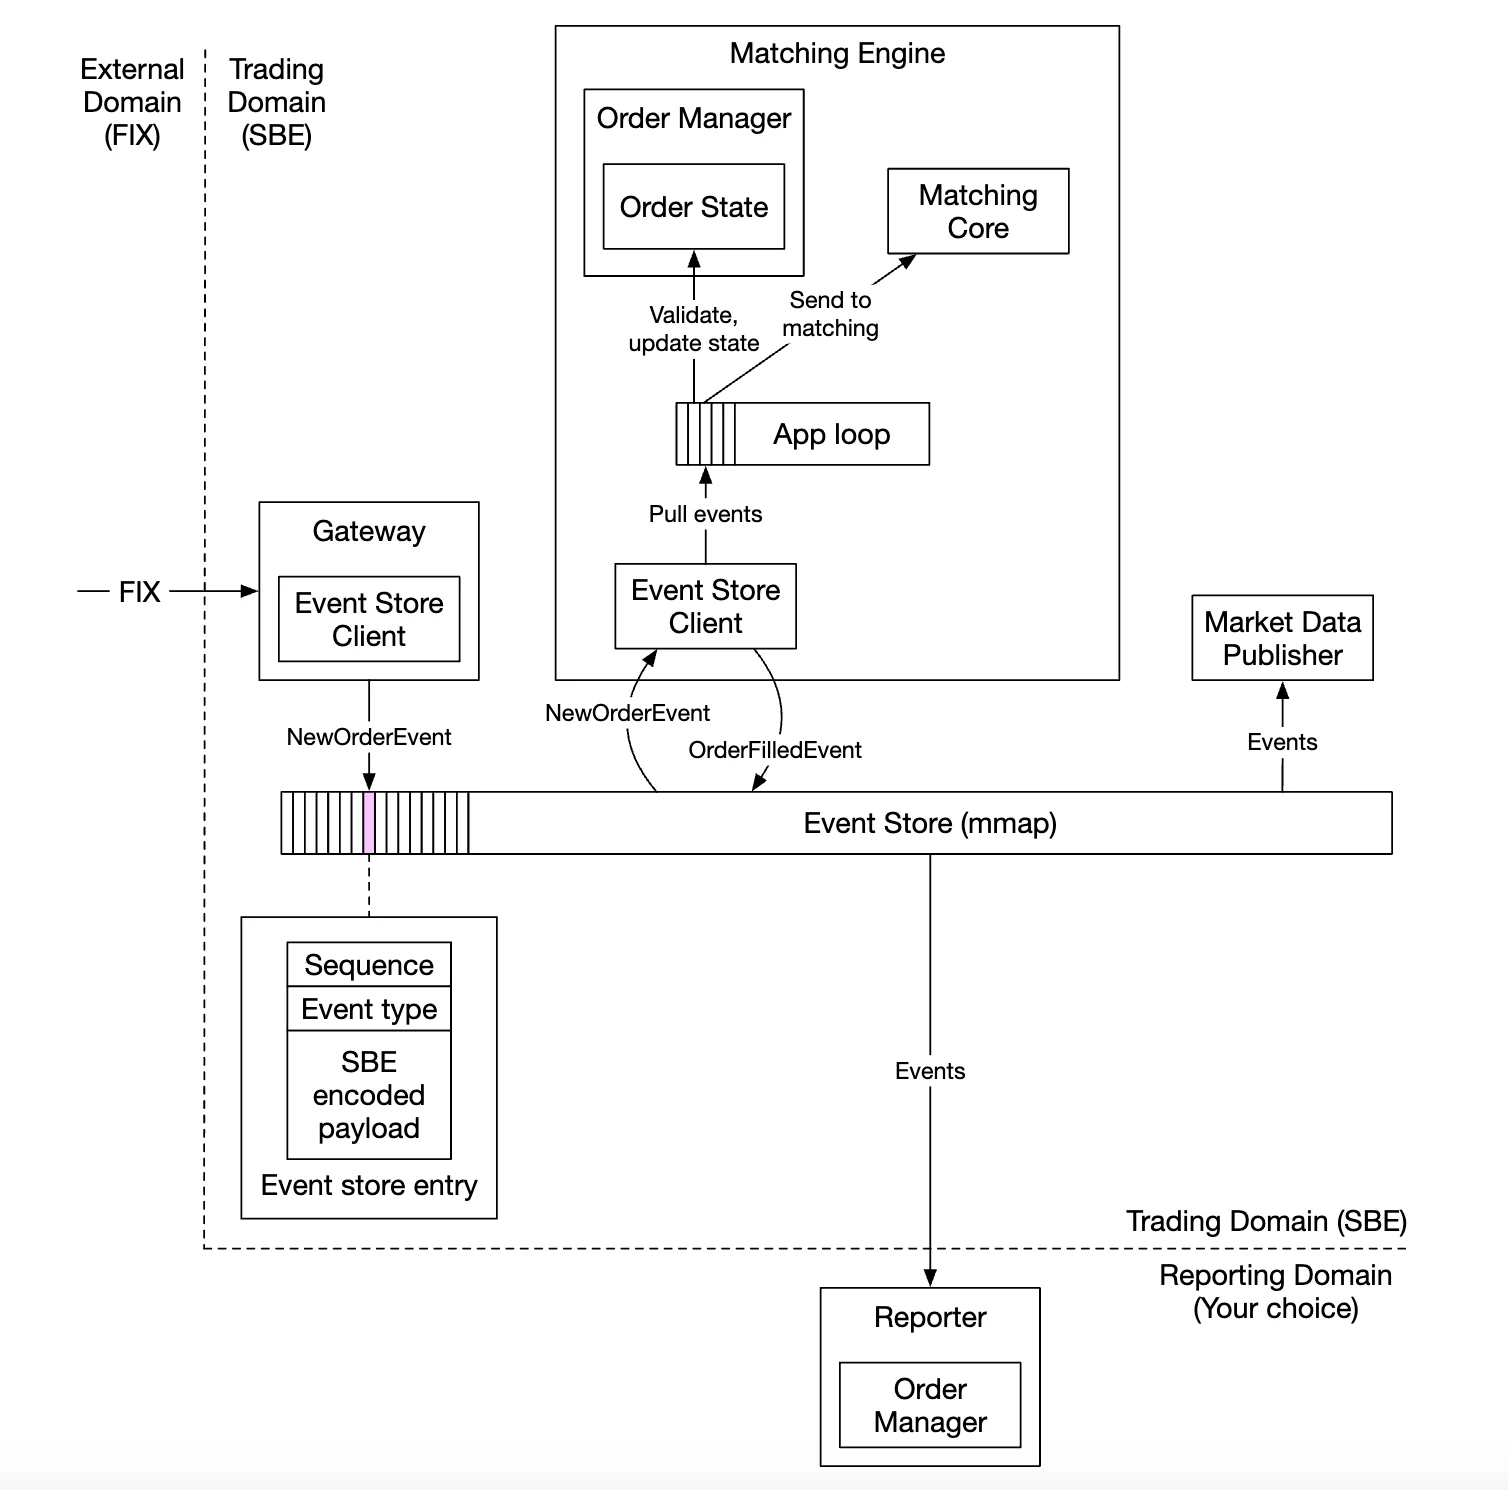
- 外部领域使用 FIX 协议与我们的客户端网关交互
- 订单管理器收到新订单事件,对其进行校验,并将其加入自己的内部状态。随后订单被发送给撮合核心
- 如果订单被撮合,就会生成
OrderFilledEvent并通过 mmap 发送出去 - 其他组件订阅事件存储,并完成各自那部分的处理
另一个额外的优化:所有组件都持有一份订单管理器的副本,订单管理器被打包成一个库,以避免为管理订单而产生的额外调用
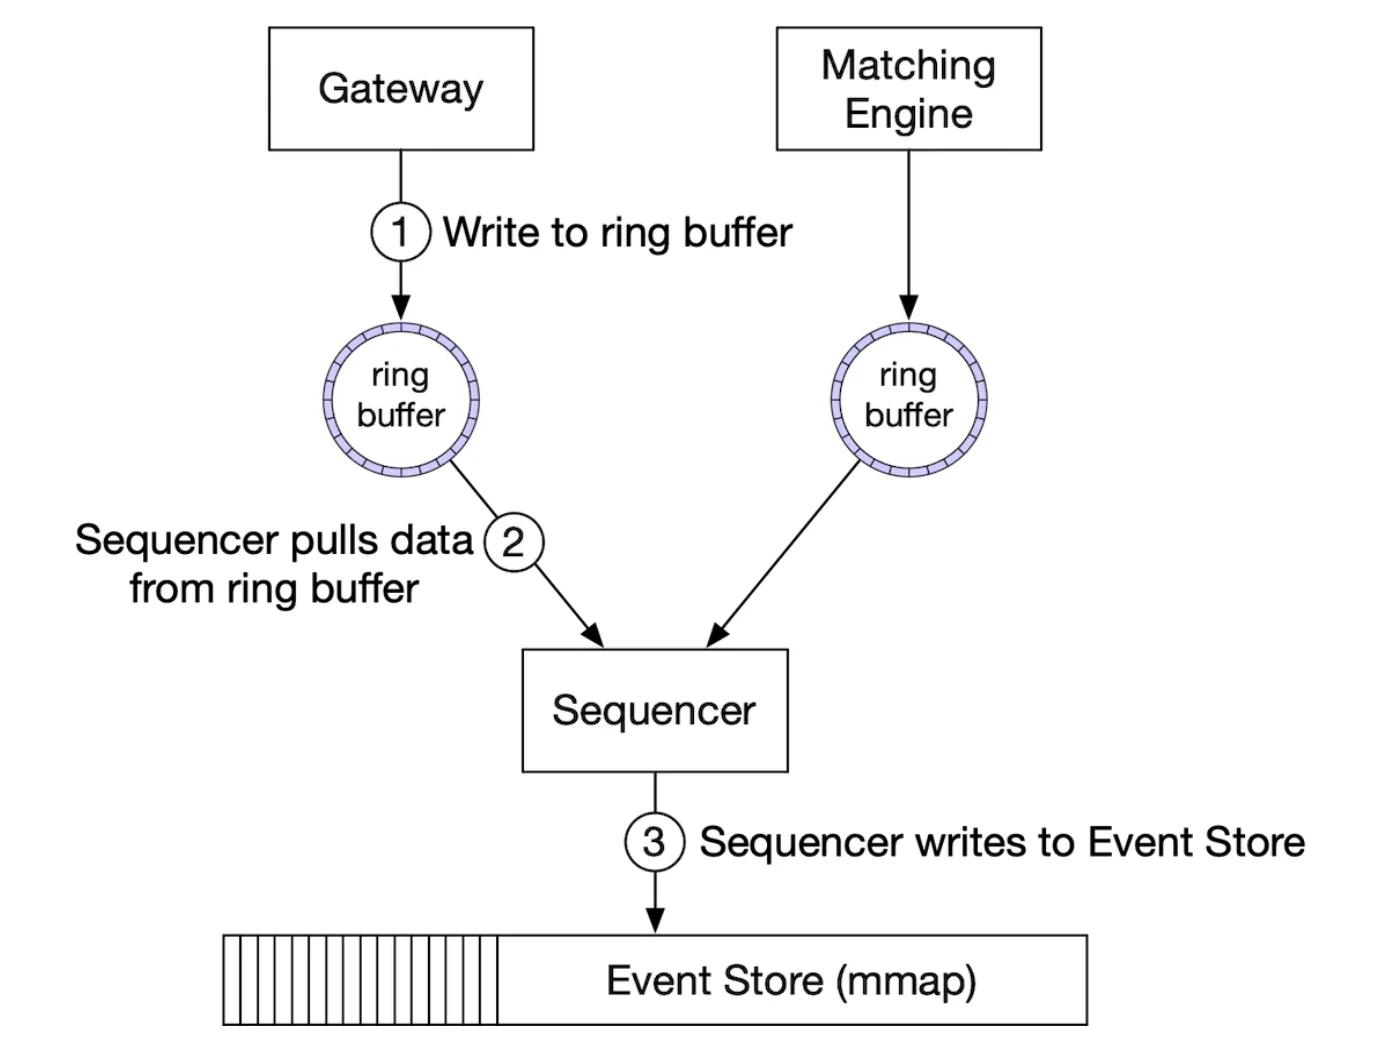
在这个设计中,定序器不再是事件存储,而变成了单一写入者(single writer),在把事件转发给事件存储之前对它们进行排序:
高可用性
我们的目标是 99.99% 的可用性,即每天只有 8.64 秒的停机时间。
为了实现这一点,我们必须识别交易所架构中的单点故障:
- 为关键服务(例如撮合引擎)部署处于待命状态的备份实例
- 积极地自动化故障检测以及向备份实例的故障转移
客户端网关这样的无状态服务可以通过添加更多服务器轻松地水平扩展。
对于有状态的组件,如果自己不是 leader,可以处理入站事件,但不发布出站事件:
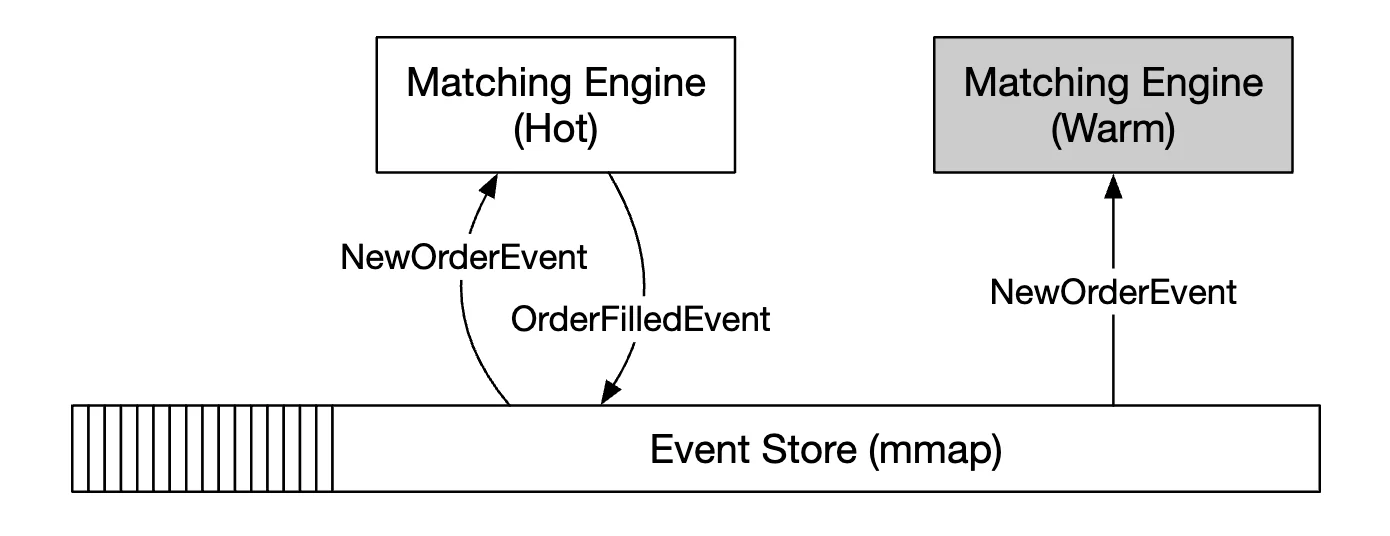
为了检测主副本是否宕机,我们可以发送心跳来判断它是否已不能正常工作。
这种机制只在单台服务器的范围内有效。 如果想要扩展它,我们可以把一整台服务器设置为热/温副本,在发生故障时进行故障转移。
为了在各副本之间复制事件存储,我们可以使用可靠 UDP(Reliable UDP)来实现更快的通信。
容错
如果连温备实例也宕机了怎么办?这是一个低概率事件,但我们应该做好准备。
大型科技公司解决这个问题的做法,是把核心数据复制到多个城市的数据中心,以减轻例如自然灾害的影响。
需要考虑的问题:
- 如果主实例宕机,我们如何、在何时故障转移到备份实例?
- 我们如何在备份实例中选出 leader?
- 需要多长的恢复时间(RTO,恢复时间目标)?
- 哪些功能需要恢复?我们的系统能否在降级状态下运行?
如何解决这些问题:
- 系统可能会因为某个 bug 而宕机(同时影响主实例和副本),我们可以用混沌工程(Chaos Engineering)来暴露此类边界情况和灾难性后果
- 不过一开始,在积累足够多关于系统故障模式的知识之前,我们可以手动执行故障转移
- 可以使用 leader 选举(例如 Raft)来确定在主实例宕机时由哪个副本成为 leader
跨不同服务器复制的工作方式示例:
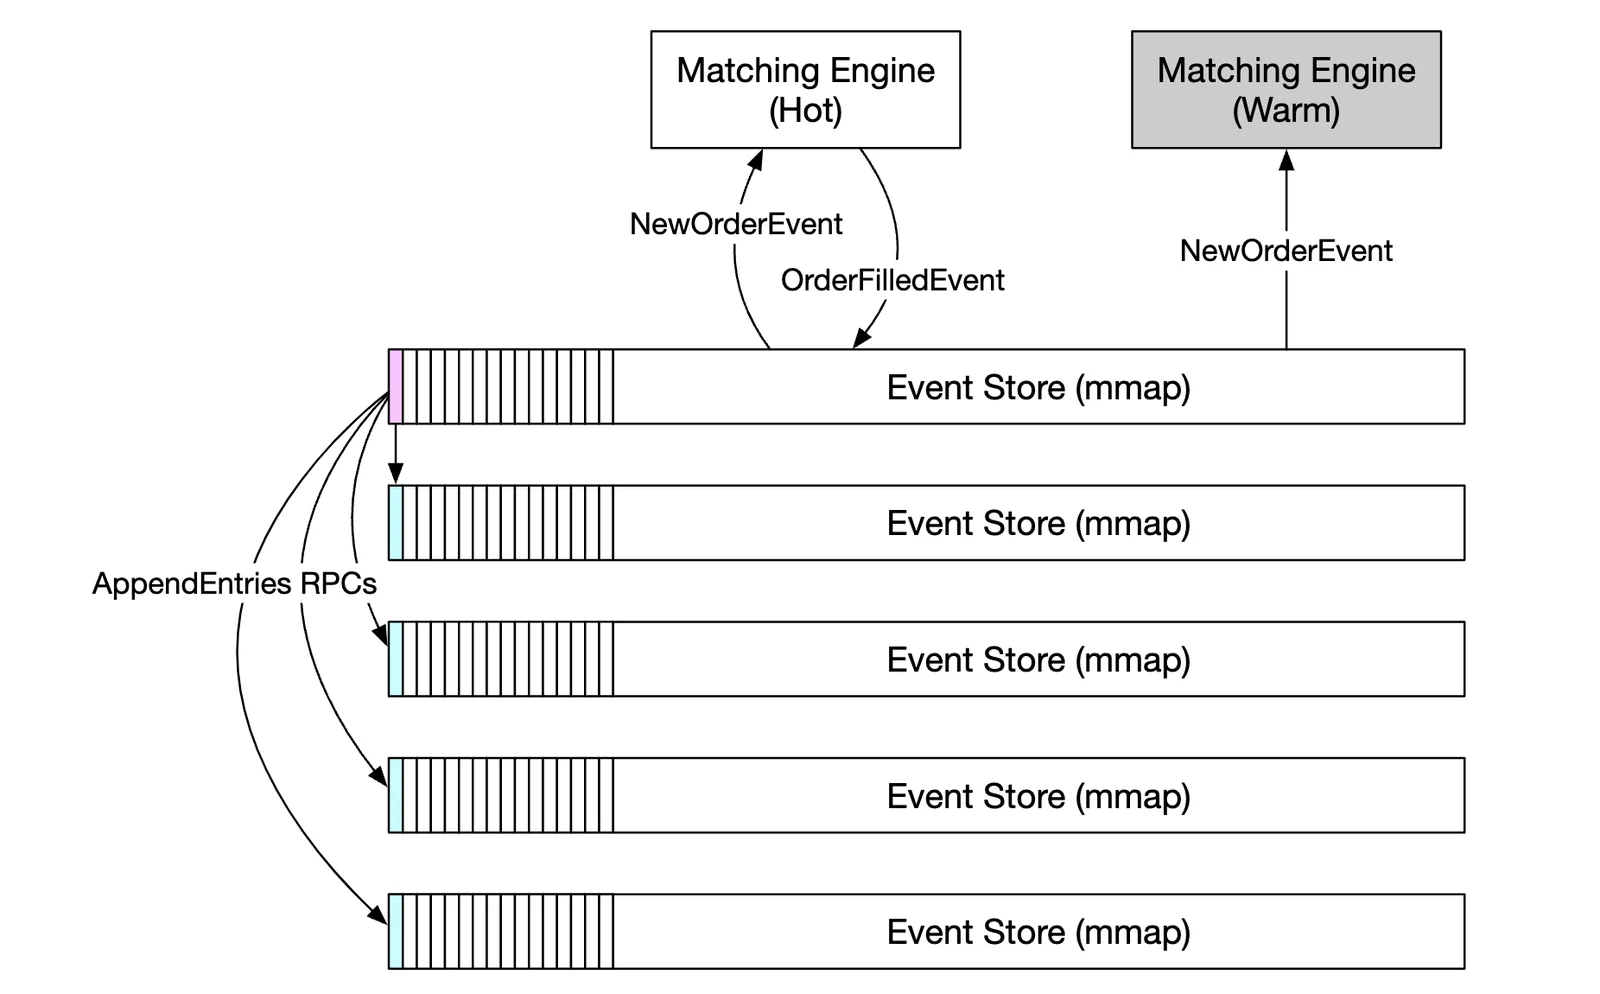
leader 选举任期(term)示例:
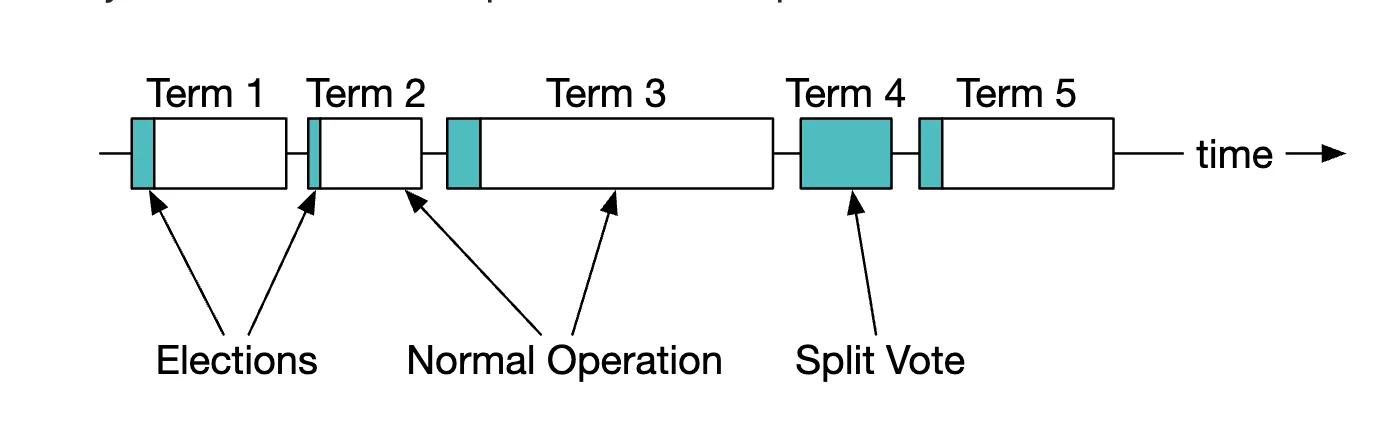
关于 Raft 工作原理的细节,请看这里
最后,我们还需要考虑数据丢失容忍度:在情况变得严重之前,我们能容忍丢失多少数据? 这将决定我们备份数据的频率。
对证券交易所来说,数据丢失是不可接受的,因此我们必须经常备份数据,并依靠 Raft 的复制来降低数据丢失的概率。
撮合算法
稍微岔开一下,用伪代码看看撮合是如何工作的:
Context handleOrder(OrderBook orderBook, OrderEvent orderEvent) {
    if (orderEvent.getSequenceId() != nextSequence) {
        return Error(OUT_OF_ORDER, nextSequence);
    }

    if (!validateOrder(symbol, price, quantity)) {
        return ERROR(INVALID_ORDER, orderEvent);
    }

    Order order = createOrderFromEvent(orderEvent);
    switch (msgType):
        case NEW:
            return handleNew(orderBook, order);
        case CANCEL:
            return handleCancel(orderBook, order);
        default:
            return ERROR(INVALID_MSG_TYPE, msgType);

}

Context handleNew(OrderBook orderBook, Order order) {
    if (BUY.equals(order.side)) {
        return match(orderBook.sellBook, order);
    } else {
        return match(orderBook.buyBook, order);
    }
}

Context handleCancel(OrderBook orderBook, Order order) {
    if (!orderBook.orderMap.contains(order.orderId)) {
        return ERROR(CANNOT_CANCEL_ALREADY_MATCHED, order);
    }

    removeOrder(order);
    setOrderStatus(order, CANCELED);
    return SUCCESS(CANCEL_SUCCESS, order);
}

Context match(OrderBook book, Order order) {
    Quantity leavesQuantity = order.quantity - order.matchedQuantity;
    Iterator<Order> limitIter = book.limitMap.get(order.price).orders;
    while (limitIter.hasNext() && leavesQuantity > 0) {
        Quantity matched = min(limitIter.next.quantity, order.quantity);
        order.matchedQuantity += matched;
        leavesQuantity = order.quantity - order.matchedQuantity;
        remove(limitIter.next);
        generateMatchedFill();
    }
    return SUCCESS(MATCH_SUCCESS, order);
}
这个撮合算法使用 FIFO 算法来决定撮合某个价格档位上的哪些订单。
确定性
功能确定性由我们使用的定序器技术来保证。
事件实际发生的时间并不重要:
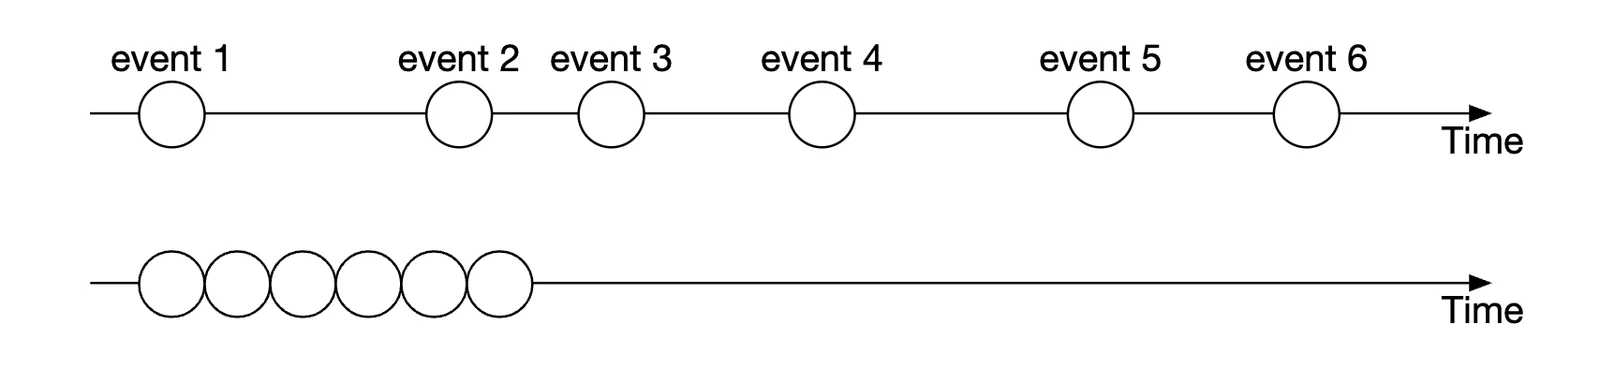
延迟确定性是我们必须跟踪的。可以通过监控第 99 或第 99.99 百分位的延迟来计算它。
可能导致延迟尖刺的因素包括 Java 等语言中的垃圾回收事件。
行情数据发布器的优化
行情数据发布器从撮合引擎接收撮合结果,并据此重建订单簿和 K 线图。
由于内存不是无限的,我们只保留一部分 K 线。客户可以选择想要多细粒度的信息。更细粒度的信息可能需要支付更高的价格:
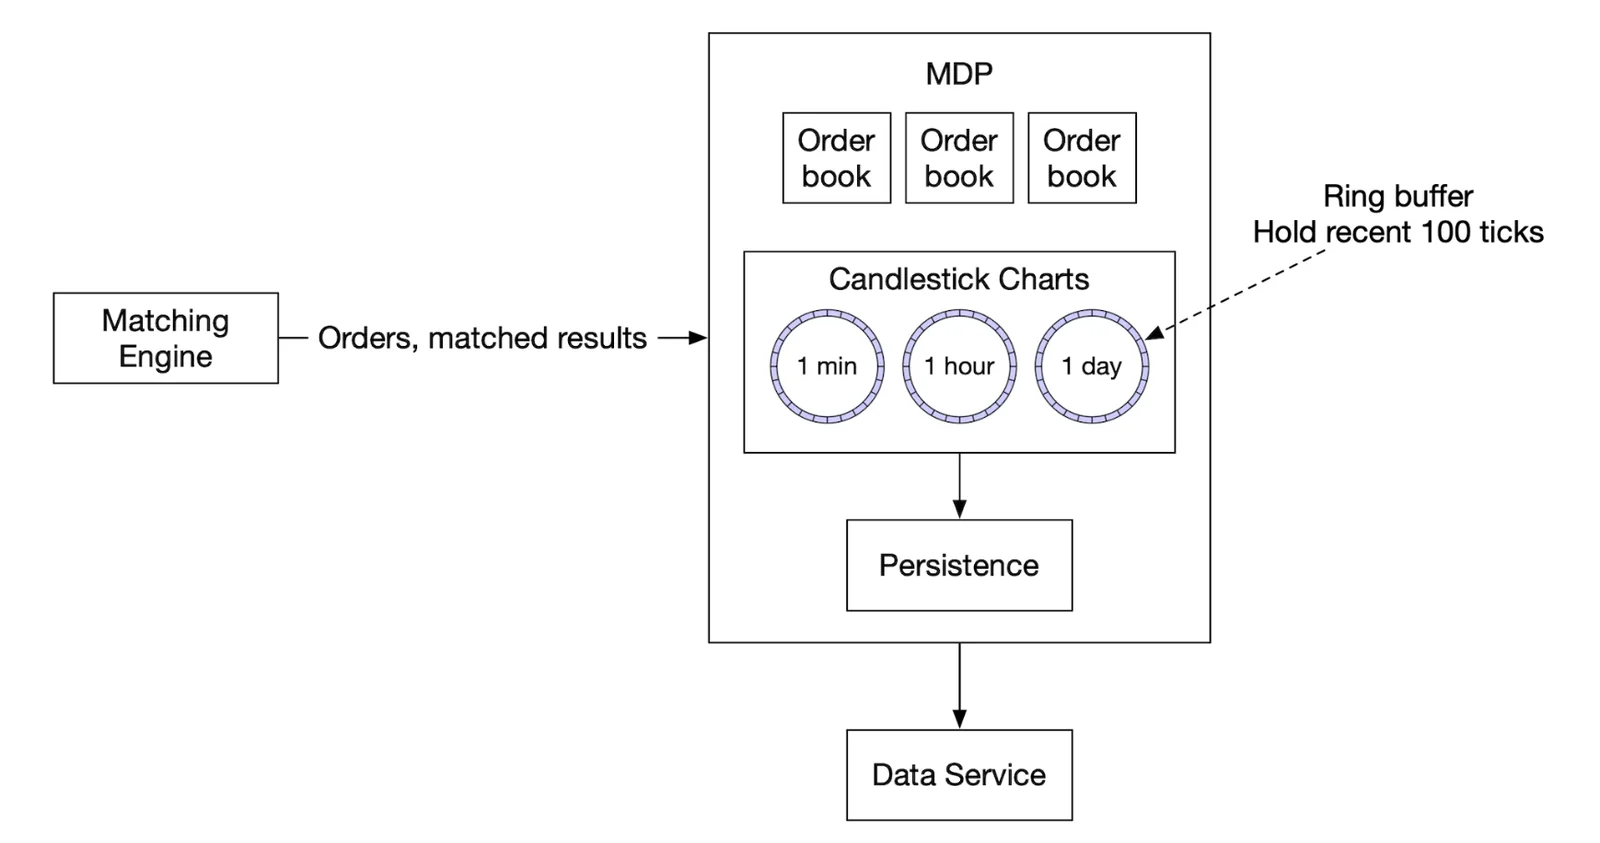
环形缓冲区(Ring Buffer,又称循环缓冲区,Circular Buffer)是一个头尾相连的固定大小队列。空间是预先分配的,以避免内存分配。这种数据结构也是无锁的。
另一种优化环形缓冲区的技术是填充(Padding),它确保序列号永远不会与其他任何数据处于同一个缓存行中。
行情数据分发的公平性与组播
我们需要确保订阅者在同一时间收到数据,因为如果某个订阅者比别人先收到数据,就相当于获得了关键的市场洞察,可以利用它来操纵市场。
为了实现这一点,我们可以在向订阅者发布数据时,基于可靠 UDP 使用组播。
数据在网络上的传输有三种方式:
- 单播(Unicast):一个源,一个目的地
- 广播(Broadcast):一个源发送到整个子网
- 组播(Multicast):一个源发送到位于不同子网中的一组主机
理论上,使用组播时,所有订阅者应该在同一时间收到数据。
不过,UDP 是不可靠的,数据可能无法到达每一个订阅者。但可以通过重传机制来增强它。
主机托管
交易所为经纪商提供主机托管(Colocation)服务,让他们把服务器放在与交易所相同的数据中心内。
这能大幅降低延迟,可以视为一种 VIP 服务。
网络安全
由于有一些面向互联网的服务,DDoS 对交易所来说是一个挑战。以下是我们的选项:
- 把公共服务和数据与私有服务隔离开,这样 DDoS 攻击就不会影响最重要的客户
- 使用缓存层来存储不常更新的数据
- 加固 URL 以抵御 DDoS,例如优先使用
https://my.website.com/data/recent而不是https://my.website.com/data?from=123&to=456,因为前者更容易被缓存 - 需要有效的允许列表/阻止列表机制。
- 可以用限流来缓解 DDoS
第 4 步:总结
其他值得注意的点:
- 并非所有交易所都依赖把所有东西放在一台大服务器上,但有些交易所仍然这样做
- 现代交易所越来越依赖云基础设施,也依赖自动做市商(Automatic Market Maker,AMM)来避免维护订单簿