第 13 章 设计搜索自动补全系统
简介
自动补全(Autocomplete),也称为输入预测(typeahead)或增量搜索(incremental search),会在用户往搜索框中输入时实时提供建议。该系统必须根据历史查询数据,高效地给出前 k 个(top-k)相关且热门的建议。
关键特性
- 最多给出 5 条自动补全结果。
- 依据查询热度(query popularity)(频率)。
- 只支持小写英文字符。
- 响应速度快(<100 ms),且可扩展。
第 1 步:理解问题
需求
- 实时建议: 在用户输入时展示相关的匹配项。
- Top-k 结果: 返回最多 5 条按热度排序的结果。
- 可扩展性: 支撑 1000 万 DAU,峰值 QPS 为 48,000。
- 高可用性(High Availability): 处理故障时系统不停机。
- 数据增长: 支持新查询数据每天 0.4 GB 的存储增长。
第 2 步:高层设计
从高层来看,系统分为两个服务:
-
数据收集服务(Data Gathering Service):
- 收集用户查询,并实时聚合以进行频率分析。
- 对于大规模数据集,实时处理并不现实;不过它是一个不错的起点
-
查询服务(Query Service): 根据用户的输入给出前 k 条建议。
数据收集服务
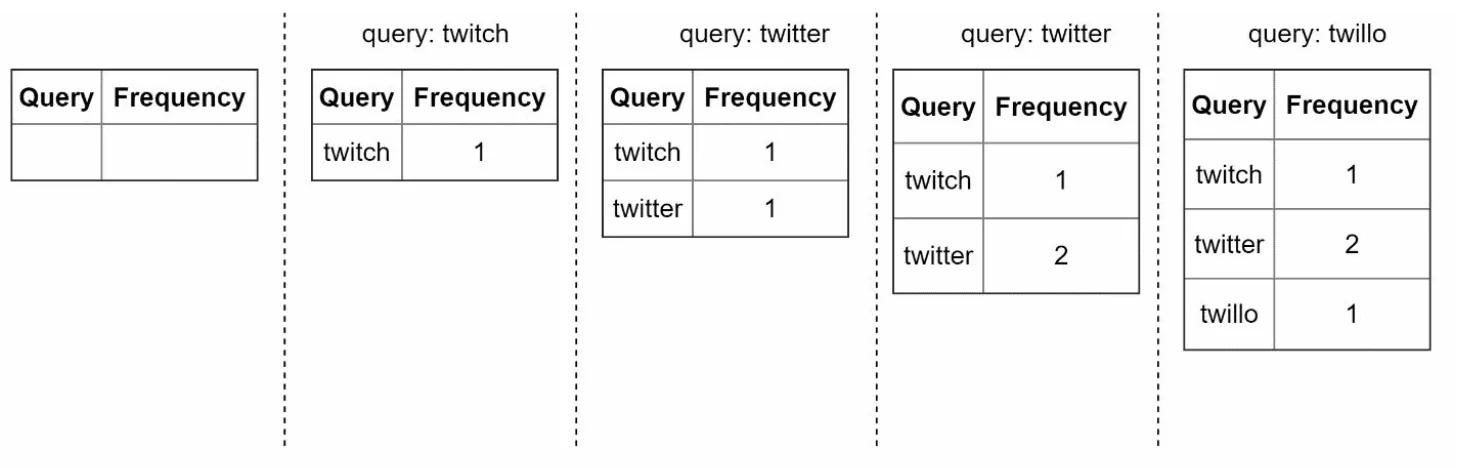
- 从分析日志中聚合查询数据,并更新频率表。
- 每周处理历史数据,构建一棵 trie(前缀树)。
查询服务
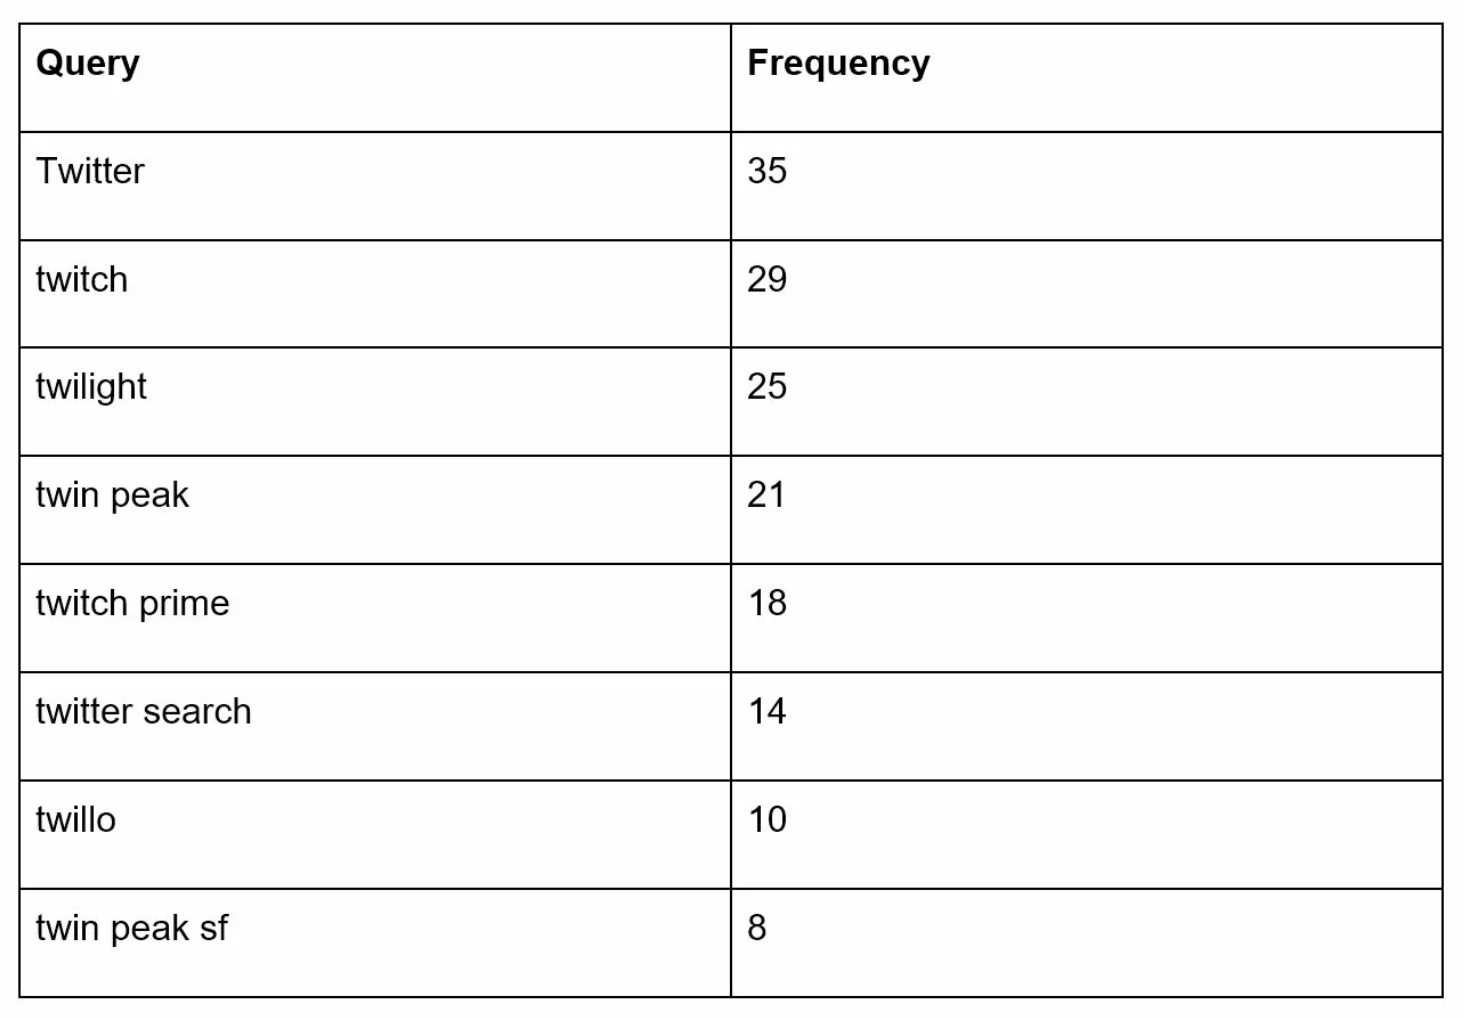
- 使用来自数据收集服务的频率表。
- 处理用户输入,借助 Trie 从频率表中获取前 k 条建议。
- 利用缓存和高效的数据结构进行优化,实现快速查找。
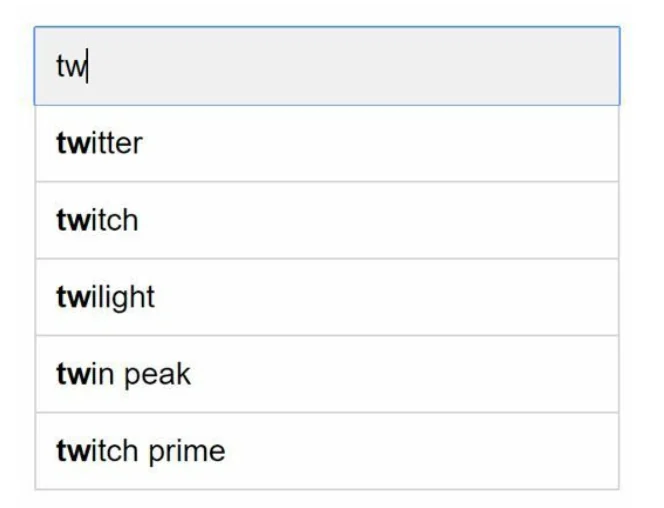
- 例如,当用户在搜索框中输入“tw”时,会显示以下 5 个搜索次数最多的查询。
第 3 步:深入设计
Trie 数据结构
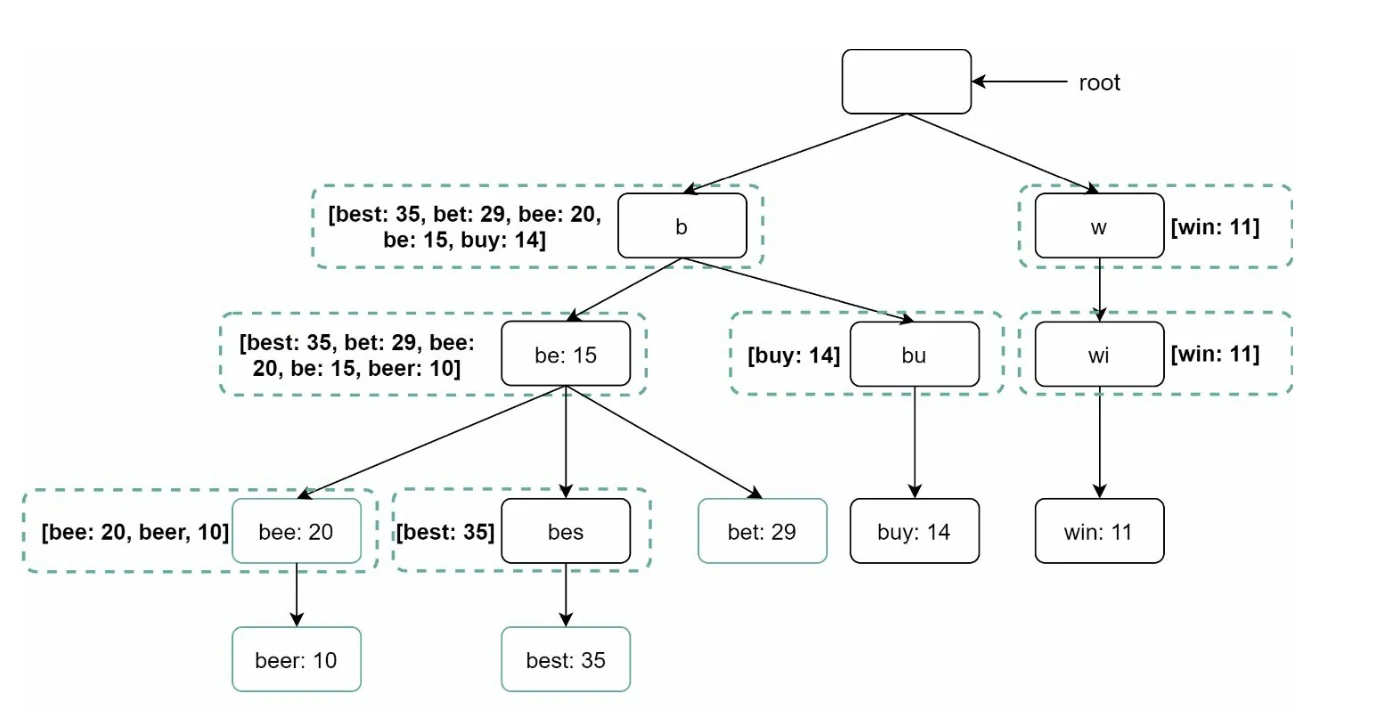
trie 是一种树状数据结构,用于高效地存储和检索查询字符串。
关键特性
- 紧凑存储: 按层级表示前缀,尽量减少冗余。
-
频率信息: 在每个节点上存储查询的热度。
-
获取前 k 个搜索次数最多的查询的步骤
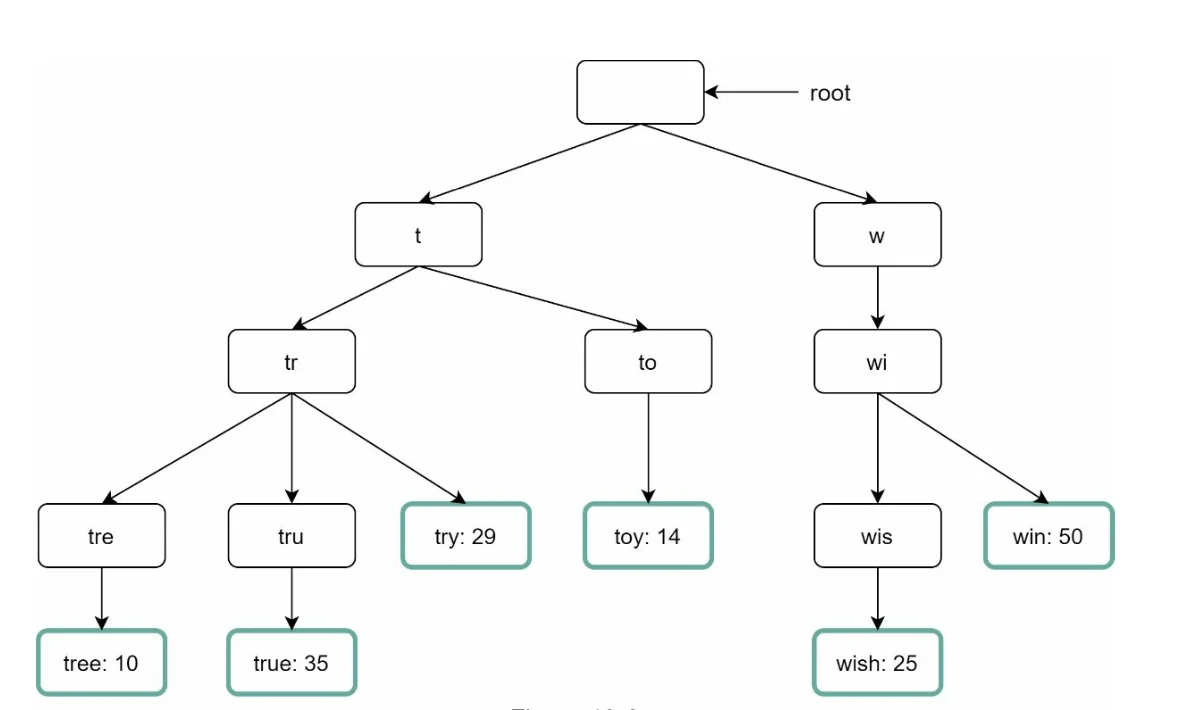
- 找到前缀
- 从前缀节点开始遍历子树,获取所有有效的子节点
- 对子节点排序,取出前 k 个
-
优化:
-
在每个节点上缓存前 k 个查询,以加快检索速度,并避免遍历整棵 trie。
-
限制前缀长度以缩小搜索空间,因为用户很少输入很长的搜索查询(比如 50)。
-
Trie 操作
- 创建:
- 每周使用聚合后的查询数据构建。
- 数据来源是分析日志(Analytics Log)/数据库。
- 更新: 很少实时更新;每周的更新会替换旧数据。
-
删除:
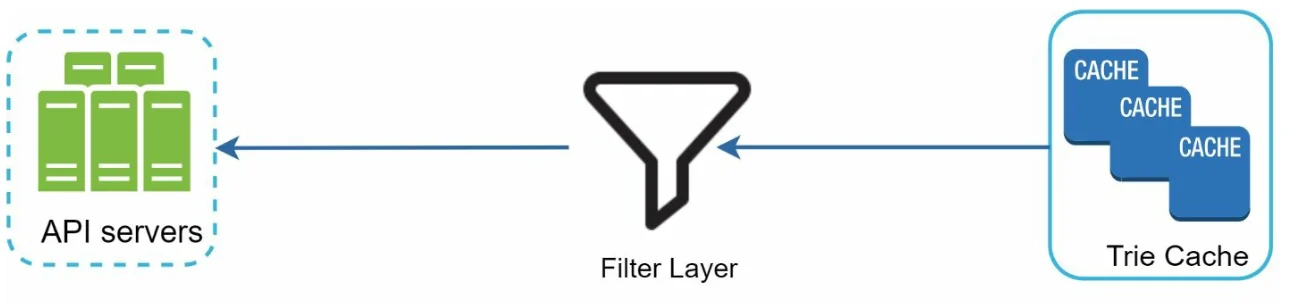
- 过滤器会移除不需要的或有害的建议(例如仇恨言论)。
- 增加一个过滤层,使我们能够根据不同的过滤规则灵活地移除结果。
- 不需要的建议会被异步地从数据库中物理删除。
查询处理流程
- 前缀搜索:
- 找到与用户输入对应的前缀节点。
- 遍历子树,收集有效的建议。
- Top-k 排序:
- 在每个节点上缓存前 k 条建议,尽量减少排序开销。
- 构建响应:
- 使用缓存数据构建结果,以获得快速的响应时间。
优化
- 在每个节点上缓存:
- 存储前 k 个查询,避免冗余的遍历。
- 限制前缀长度:
- 将前缀长度限制在一个较小的值(例如 50 个字符),以加快查找。
- AJAX 请求:
- 使用轻量级的异步请求来实现实时响应。
- 浏览器缓存:
- 将频繁搜索词的自动补全结果保存在浏览器缓存中。
数据收集管道
在高层设计中,每当用户输入一个搜索查询,数据就会被实时更新。这种方法并不现实。
- 用户每天可能输入数十亿个查询。每次查询都更新 trie 是不可行的。
- trie 构建好之后,热门建议可能不会有太大变化。
改进后的设计
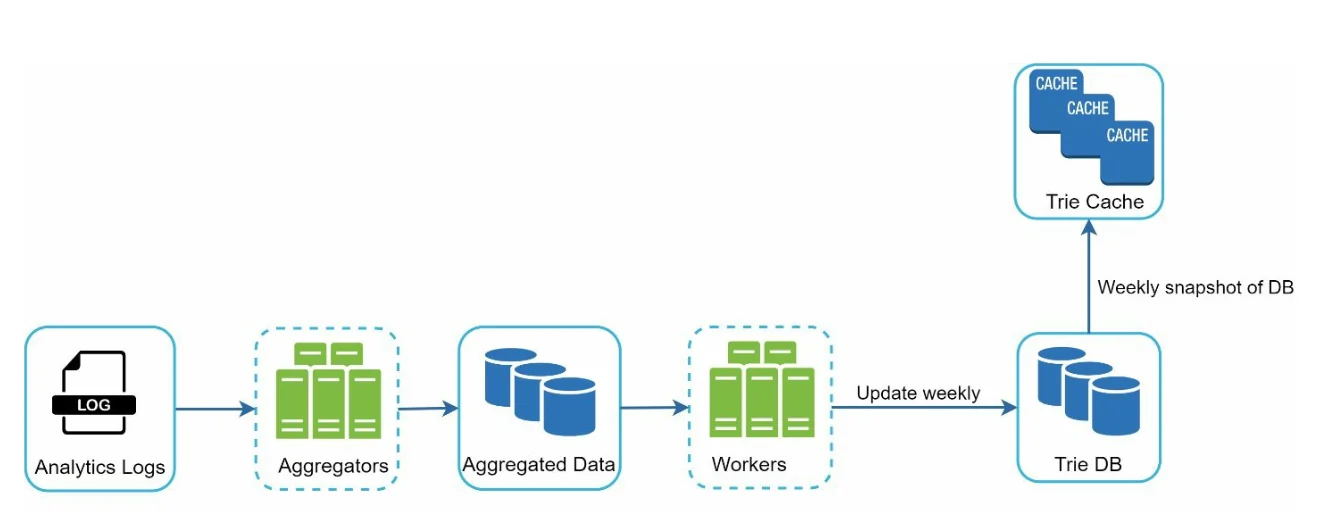
- 分析日志(Analytics Logs):
- 以日志形式存储原始查询数据,用于每周的聚合。
- 日志只追加写入,且不建索引
- 聚合器(Aggregators):
- 将日志处理成适合构建 trie 的频率表。
- 对于 Twitter 这类实时应用,以更短的时间间隔聚合数据。
- 对于其他情况,降低聚合频率(比如每周一次)就足够了。
- 工作节点(Workers):
- 异步服务器重新构建 trie,并将其存储到持久化存储中。
- 存储选项:
- Trie 缓存(Trie Cache):Trie 缓存是一个分布式缓存系统,它将 trie 保存在内存中以实现快速读取。
- Trie 数据库(Trie DB)
- 文档存储(例如 MongoDB):由于每周都会构建一棵新的 trie,我们可以定期为其创建快照,将其序列化,并把序列化后的数据存储到 MongoDB 这样的数据库中
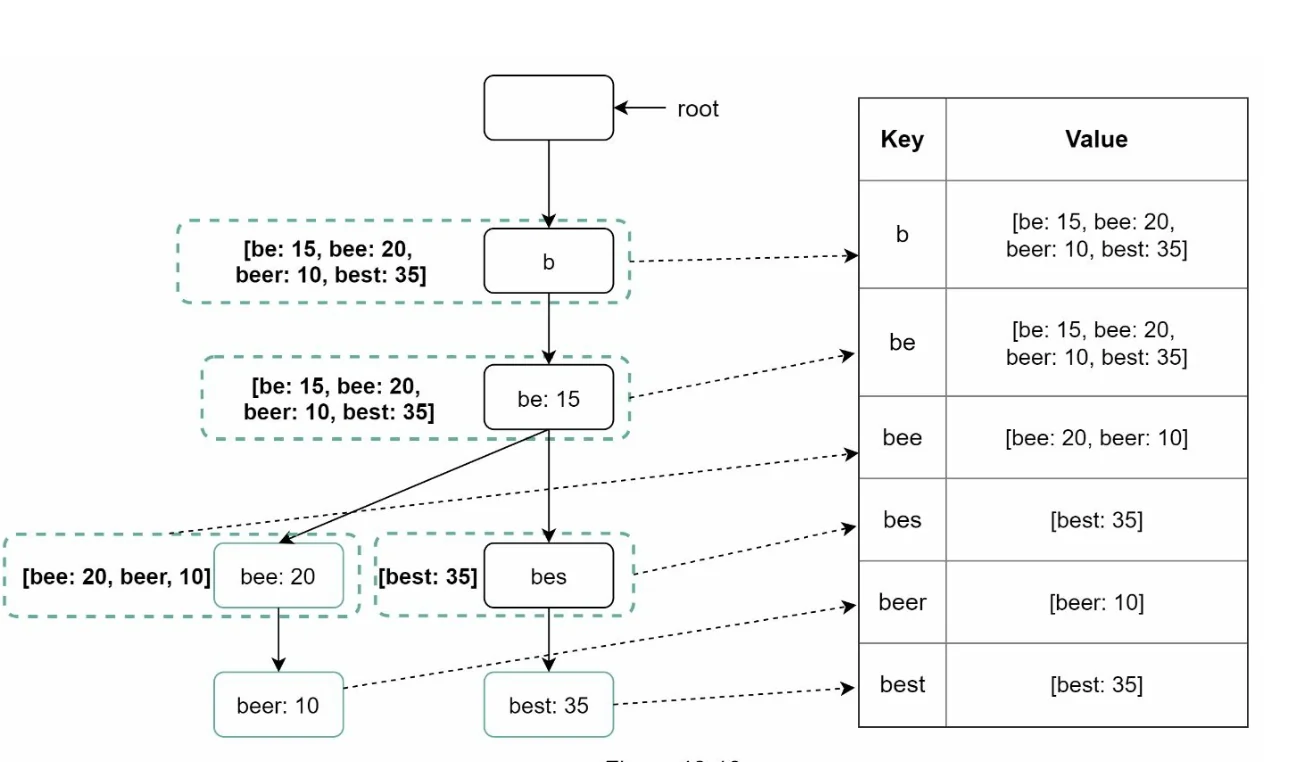
- 键值存储(Key-Value Store):
- 将前缀映射到节点数据,以便快速访问。
- trie 中的每个前缀都映射为哈希表中的一个键。
-
每个 trie 节点上的数据都映射为哈希表中的一个值。
可扩展性
- 分片(Sharding):
- 根据前缀范围将 trie 节点分布到各服务器上(例如
a-m、n-z)。 - 在前缀内部进一步分片,以平衡不均匀的分布(例如
aa-ag、ah-an)。
- 根据前缀范围将 trie 节点分布到各服务器上(例如
-
负载均衡:
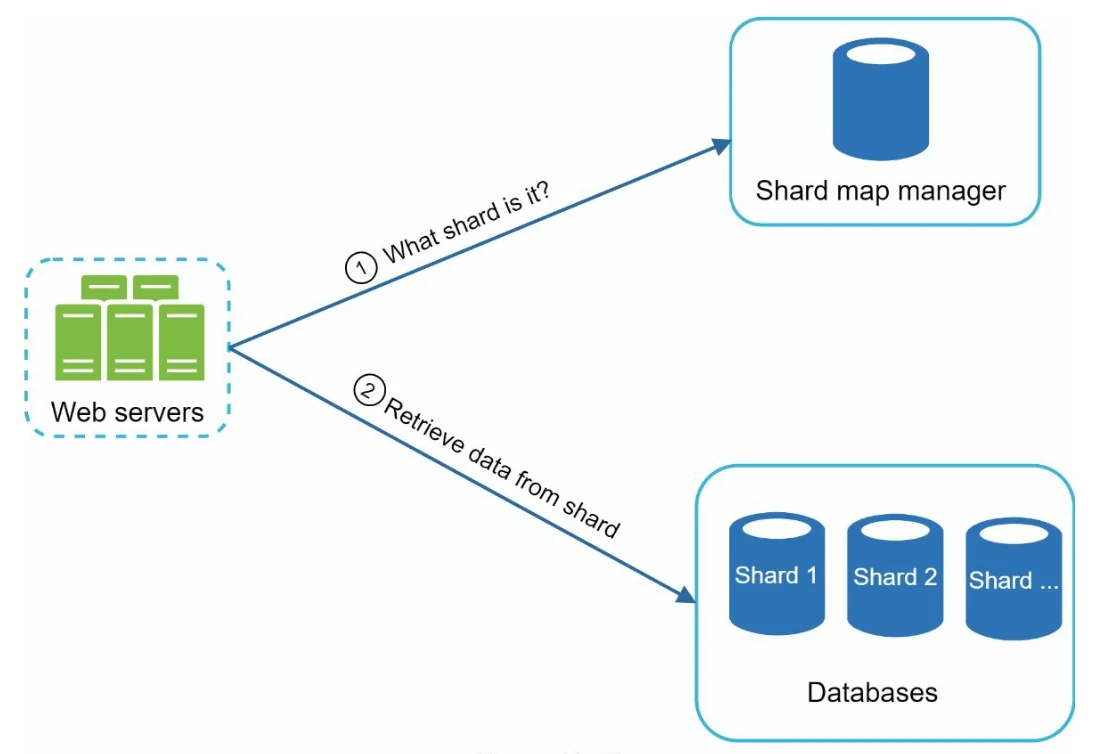
- 使用分片映射管理器(shard map manager)将请求路由到相应的服务器。
第 4 步:高级特性
多语言支持
- Unicode 字符: 使用 Unicode 来支持非英语语言。
- 按国家划分的 Trie: 为不同的国家或地区分别构建 trie。
热门趋势查询
- 通过动态更新 trie 节点,或给近期查询赋予更高的权重,来应对实时事件。