第 21 章 广告点击事件聚合
引言
随着 Facebook、YouTube、TikTok 等平台的兴起,数字广告(Digital Advertising)已成为一个庞大的产业。
因此,追踪广告点击事件非常重要。本章将探讨如何设计一个 Facebook/Google 规模的广告点击事件聚合(Ad Click Event Aggregation)系统。
数字广告中有一个称为实时竞价(Real-Time Bidding,RTB)的流程,数字广告库存就是通过它来买卖的:
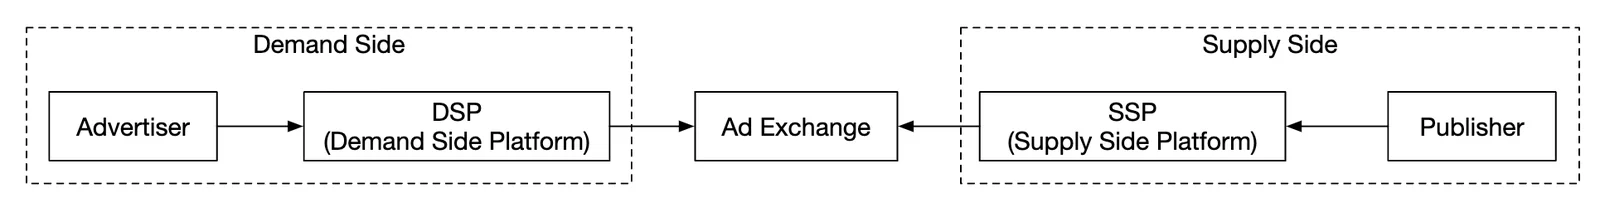
RTB 的速度很重要,因为它通常在一秒之内完成。 数据准确性也非常重要,因为它会影响广告主要支付多少钱。
基于广告点击事件的聚合结果,广告主可以做出调整目标受众和关键词等决策。
第 1 步:理解问题并确定设计范围
- 候选人:输入数据的格式是什么?
- 面试官:每天 10 亿次广告点击,总共 200 万个广告。广告点击事件数量每年增长 30%。
- 候选人:我们的系统需要支持的最重要的查询有哪些?
- 面试官:需要重点考虑的查询有:
- 返回广告 X 在过去 Y 分钟内的点击事件数
- 返回过去 1 分钟内点击次数最多的前 100 个广告。这两个参数都应该是可配置的。每分钟进行一次聚合。
- 上述查询都要支持按
ip、user_id、country过滤数据
- 候选人:我们需要考虑边界情况吗?我能想到的有这些:
- 可能有比预期更晚到达的事件
- 可能有重复的事件
- 系统的不同部分可能会宕机,所以我们需要考虑系统恢复
- 面试官:这个清单不错,把这些都考虑进去
- 候选人:延迟要求是什么?
- 面试官:广告点击聚合的端到端延迟在几分钟以内。RTB 的延迟要小于一秒。广告点击聚合有这样的延迟是可以接受的,因为它们通常用于计费和报表。
功能需求
- 聚合
ad_id在过去 Y 分钟内的点击次数 - 每分钟返回点击次数最多的前 100 个
ad_id - 支持按不同属性过滤聚合结果
- 数据集规模达到 Facebook 或 Google 的级别
非功能需求
- 聚合结果的正确性很重要,因为它会用于 RTB 和广告计费
- 正确处理延迟或重复的事件
- 健壮性:系统应当能抵御部分故障
- 延迟:端到端延迟最多几分钟
粗略估算
- 10 亿 DAU
- 假设每个用户每天点击 1 次广告 -> 每天 10 亿次广告点击
- 广告点击 QPS = 10,000
- 峰值 QPS 是该数值的 5 倍 = 50,000
- 单次广告点击占用 0.1KB 存储空间,每天的存储需求为 100GB
- 每月存储 = 3TB
第 2 步:提出高层设计并获得认可
本节我们讨论查询 API 设计、数据模型和高层设计。
查询 API 设计
API 是客户端和服务器之间的契约。在我们的场景中,客户端是仪表盘的使用者,即数据科学家/分析师、广告主等。
我们的功能需求如下:
- 聚合
ad_id在过去 Y 分钟内的点击次数 - 返回过去 M 分钟内点击次数最多的前 N 个
ad_id - 支持按不同属性过滤聚合结果
我们需要两个端点来实现这些需求。过滤可以通过其中一个端点上的查询参数来实现。
聚合 ad_id 在过去 M 分钟内的点击次数:
GET /v1/ads/{:ad_id}/aggregated_count
查询参数:
- from:起始分钟。默认为当前时间减 1 分钟
- to:结束分钟。默认为当前时间
- filter:不同过滤策略的标识符。例如 001 表示「非美国的点击」。
响应:
- ad_id:广告标识符
- count:起始分钟与结束分钟之间的聚合计数
返回过去 M 分钟内点击次数最多的前 N 个 ad_id
GET /v1/ads/popular_ads
查询参数:
- count:点击次数最多的前 N 个广告
- window:以分钟为单位的聚合窗口大小
- filter:不同过滤策略的标识符
响应:
- ad_id 列表
数据模型
在我们的系统中,有原始数据和聚合数据两种。
原始数据如下所示:
[AdClickEvent] ad001, 2021-01-01 00:00:01, user 1, 207.148.22.22, USA
下面是一个结构化格式的示例: | ad_id | click_timestamp | user | ip | country | |-------|---------------------|-------|---------------|---------| | ad001 | 2021-01-01 00:00:01 | user1 | 207.148.22.22 | USA | | ad001 | 2021-01-01 00:00:02 | user1 | 207.148.22.22 | USA | | ad002 | 2021-01-01 00:00:02 | user2 | 209.153.56.11 | USA |
下面是聚合后的版本: | ad_id | click_minute | filter_id | count | |-------|--------------|-----------|-------| | ad001 | 202101010000 | 0012 | 2 | | ad001 | 202101010000 | 0023 | 3 | | ad001 | 202101010001 | 0012 | 1 | | ad001 | 202101010001 | 0023 | 6 |
filter_id 帮助我们实现过滤需求。
| filter_id | region | IP | user_id |
|-----------|--------|-----------|---------|
| 0012 | US | * | * |
| 0013 | * | 123.1.2.3 | * |
为了支持快速返回过去 M 分钟内点击次数最多的前 N 个广告,我们还会维护如下结构: | most_clicked_ads | | | |--------------------|-----------|--------------------------------------------------| | window_size | integer | 以分钟为单位的聚合窗口大小(M) | | update_time_minute | timestamp | 最后更新时间戳(以 1 分钟为粒度) | | most_clicked_ads | array | JSON 格式的广告 ID 列表。 |
存储原始数据和存储聚合数据各有哪些优缺点?
- 原始数据可以使用完整的数据集,并支持数据过滤和重新计算
- 另一方面,聚合数据让我们拥有更小的数据集和更快的查询
- 原始数据意味着更大的数据存储和更慢的查询
- 然而,聚合数据是派生数据,因此会有一定的数据丢失。
在我们的设计中,会结合使用这两种方式:
- 保留原始数据用于调试是个好主意。如果聚合中存在 bug,我们可以发现 bug 并回填(backfill)数据。
- 也应当存储聚合数据,以获得更快的查询性能。
- 原始数据可以存放在冷存储中,以避免额外的存储成本。
说到数据库,需要考虑以下几个因素:
- 数据是什么样的?是关系型、文档还是 blob?
- 工作负载是读密集、写密集,还是两者兼有?
- 是否需要事务?
- 查询是否依赖 SUM、COUNT 这类 OLAP 函数?
对于原始数据,平均 QPS 为 1 万,峰值 QPS 为 5 万,因此系统是写密集的。 另一方面,读流量很低,因为原始数据主要用作出问题时的备份。
关系型数据库可以胜任这项工作,但扩展写入能力可能很有挑战。 另一种选择是使用 Cassandra 或 InfluxDB,它们对高写入负载有更好的原生支持。
还有一种选择是使用 Amazon S3,配合 ORC、Parquet 或 AVRO 这样的列式数据格式。由于这种方案不太常见,我们还是选用 Cassandra。
对于聚合数据,工作负载既是读密集也是写密集的,因为仪表盘和告警会不断查询聚合数据。 同时它也是写密集的,因为聚合服务每分钟都会聚合并写入数据。 因此,这里我们也使用同一个数据存储(Cassandra)。
高层设计
我们的系统如下所示:
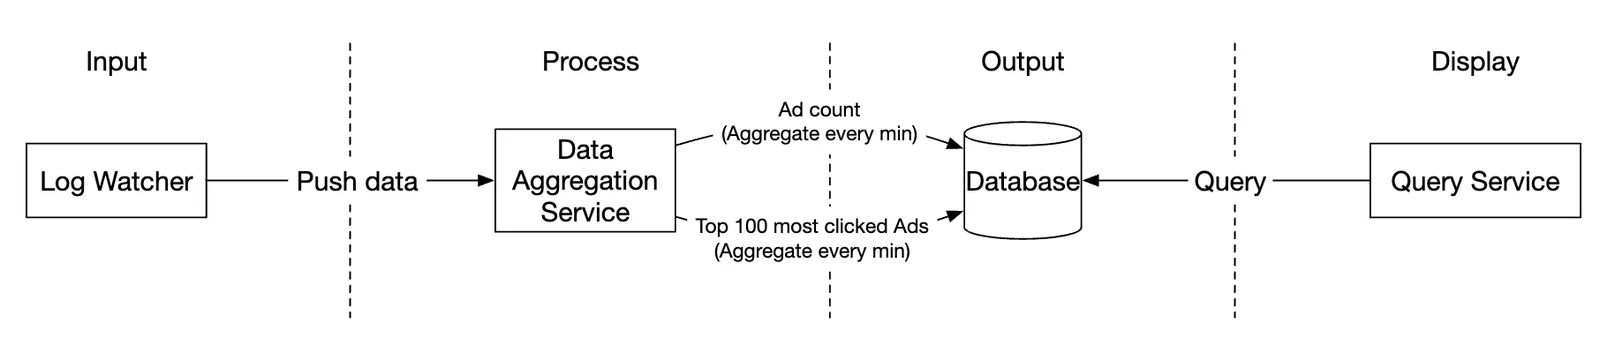
数据在输入和输出两端都以无界数据流(unbounded data stream)的形式流动。
为了避免同步汇聚(synchronous sink)带来的问题,即某个消费者崩溃会导致整个系统停滞, 我们会利用消息队列(Kafka)进行异步处理,从而把消费者和生产者解耦。
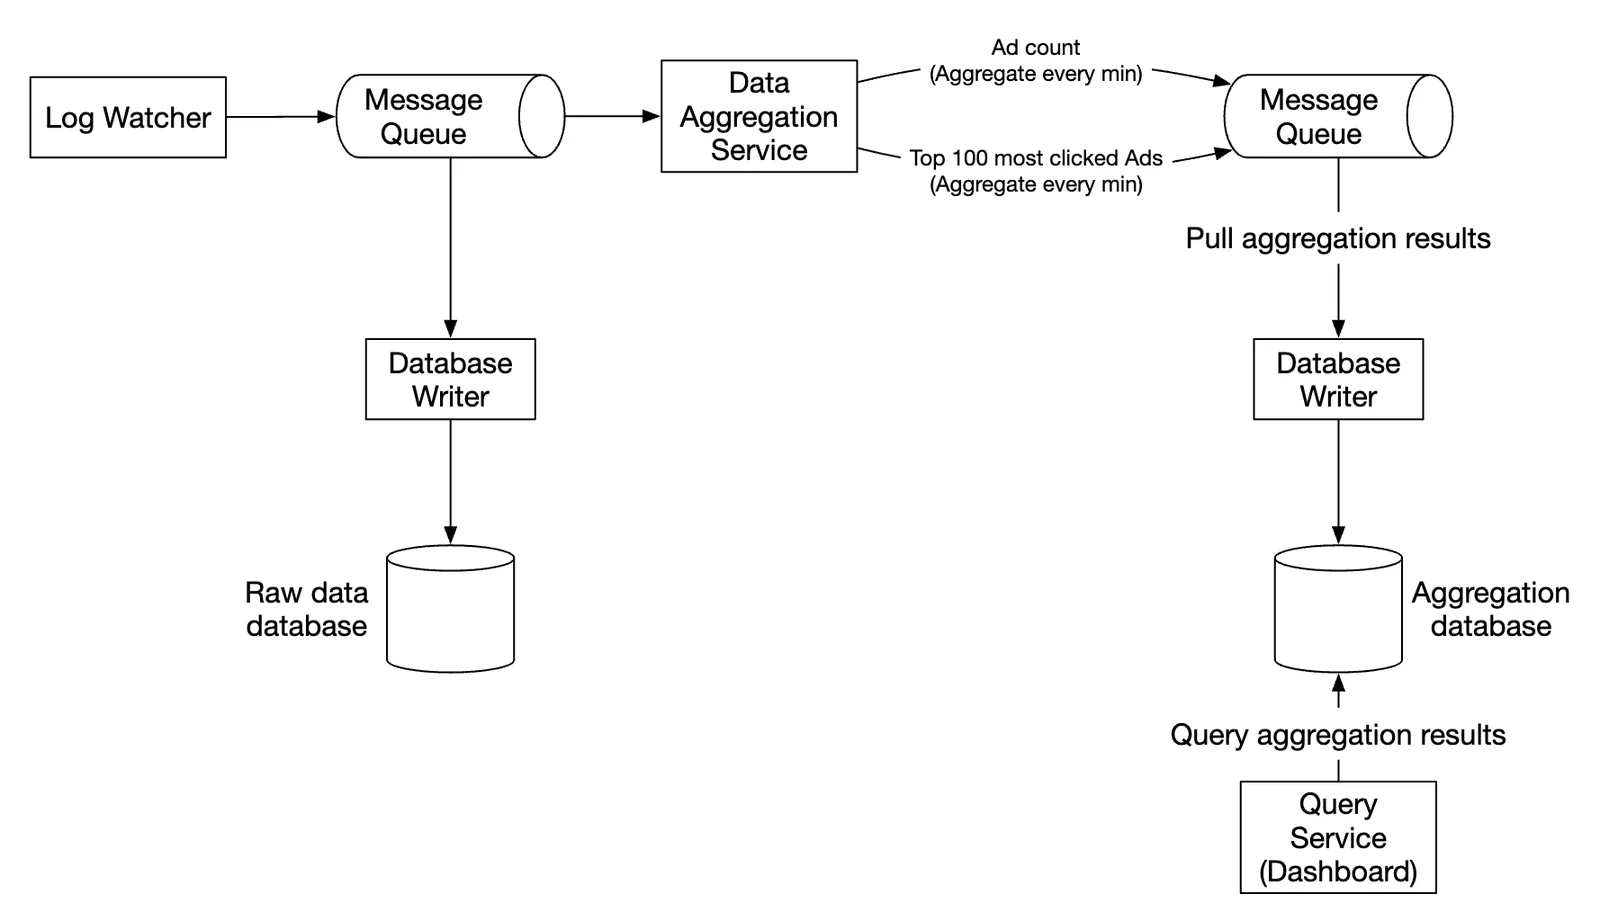
第一个消息队列存储广告点击事件数据: | ad_id | click_timestamp | user_id | ip | country | |-------|-----------------|---------|----|---------|
第二个消息队列包含按分钟聚合的广告点击计数: | ad_id | click_minute | count | |-------|--------------|-------|
以及按分钟聚合的点击次数最多的前 N 个广告: | update_time_minute | most_clicked_ads | |--------------------|------------------|
设置第二个消息队列是为了实现端到端的恰好一次(exactly-once)原子提交语义:
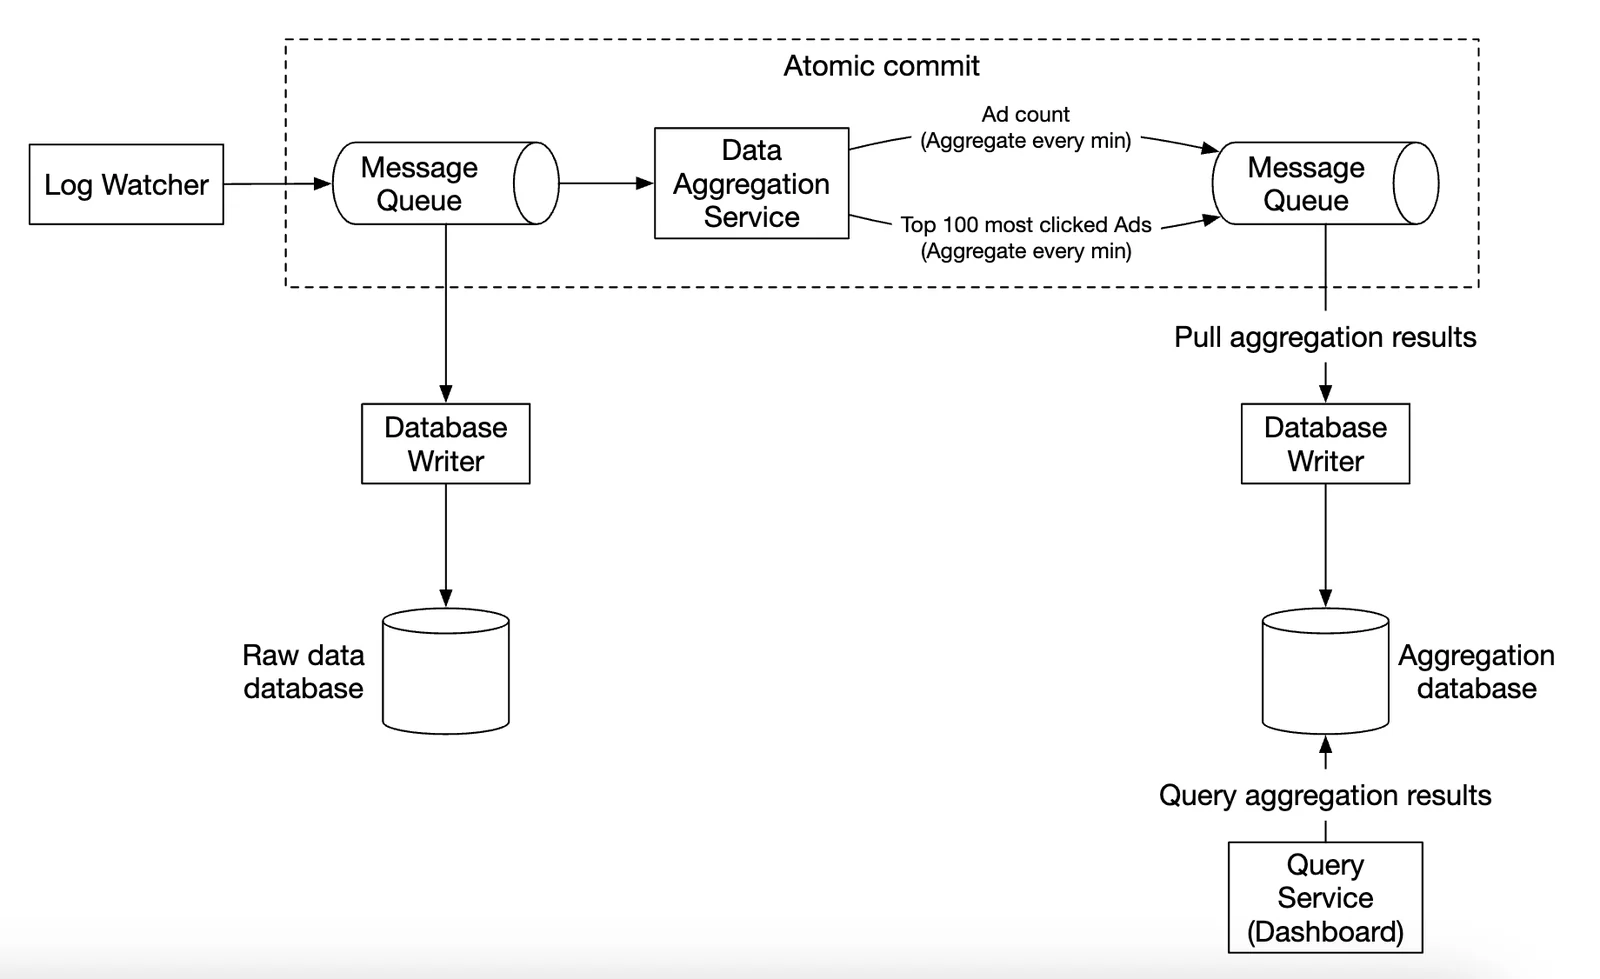
对于聚合服务,使用 MapReduce 框架是个不错的选择:
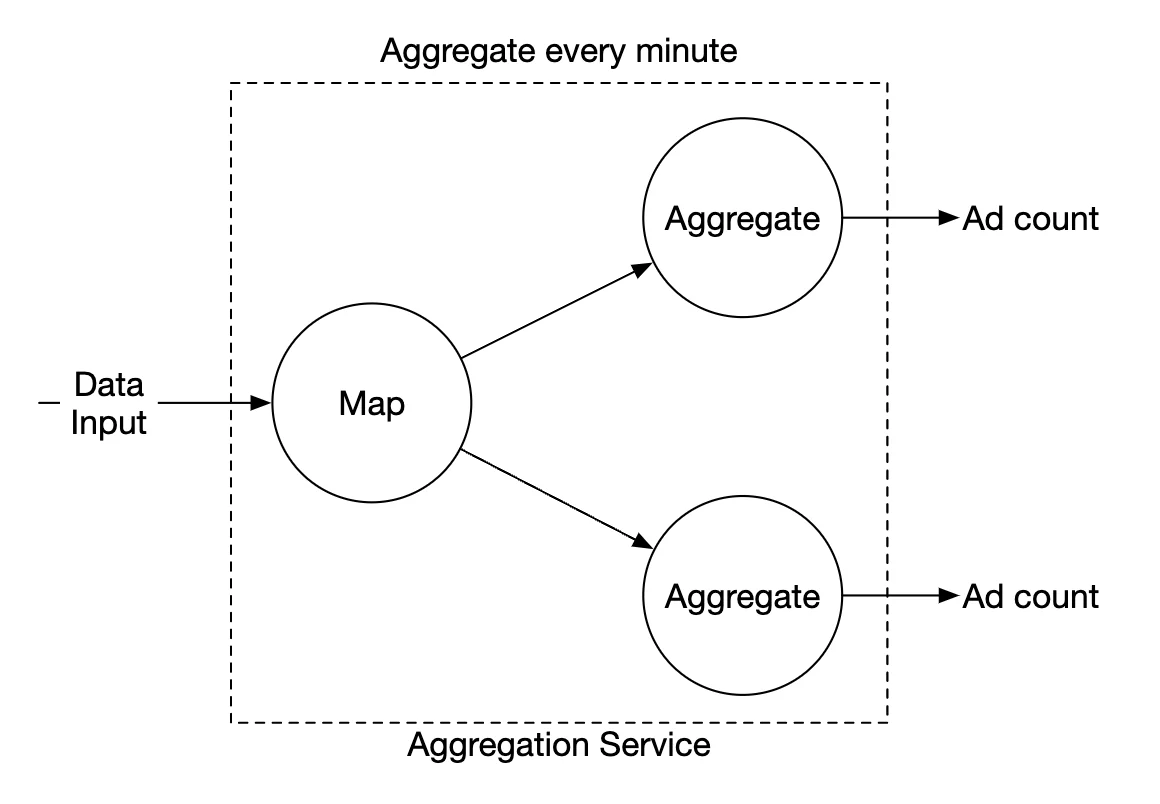
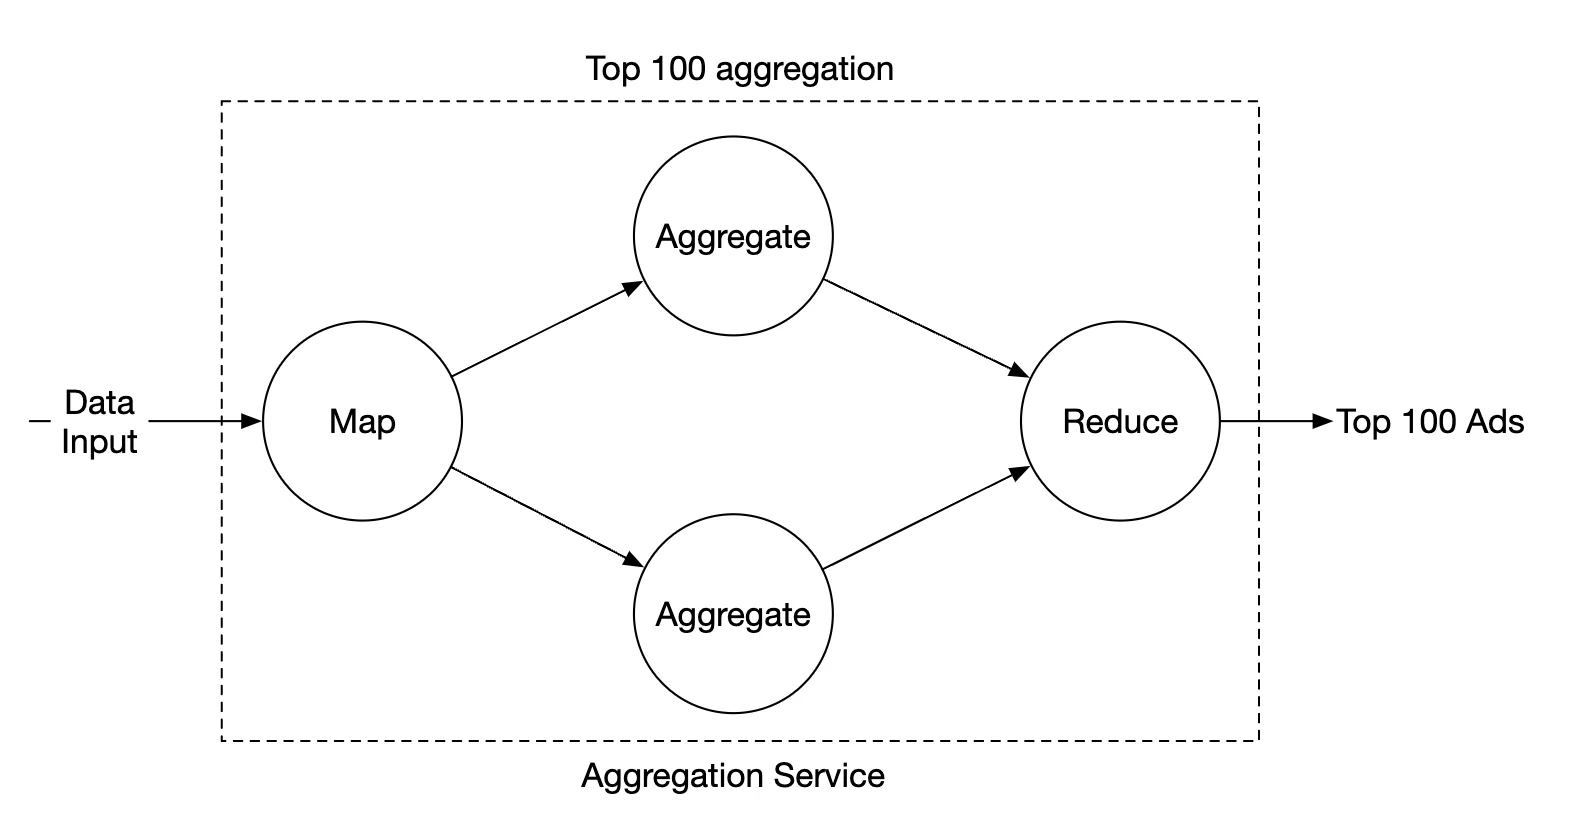
每个节点只负责一项任务,并把处理结果发送给下游节点。
Map 节点负责从数据源读取数据,然后对数据进行过滤和转换。
例如,Map 节点可以根据 ad_id 把数据分配到不同的聚合节点:
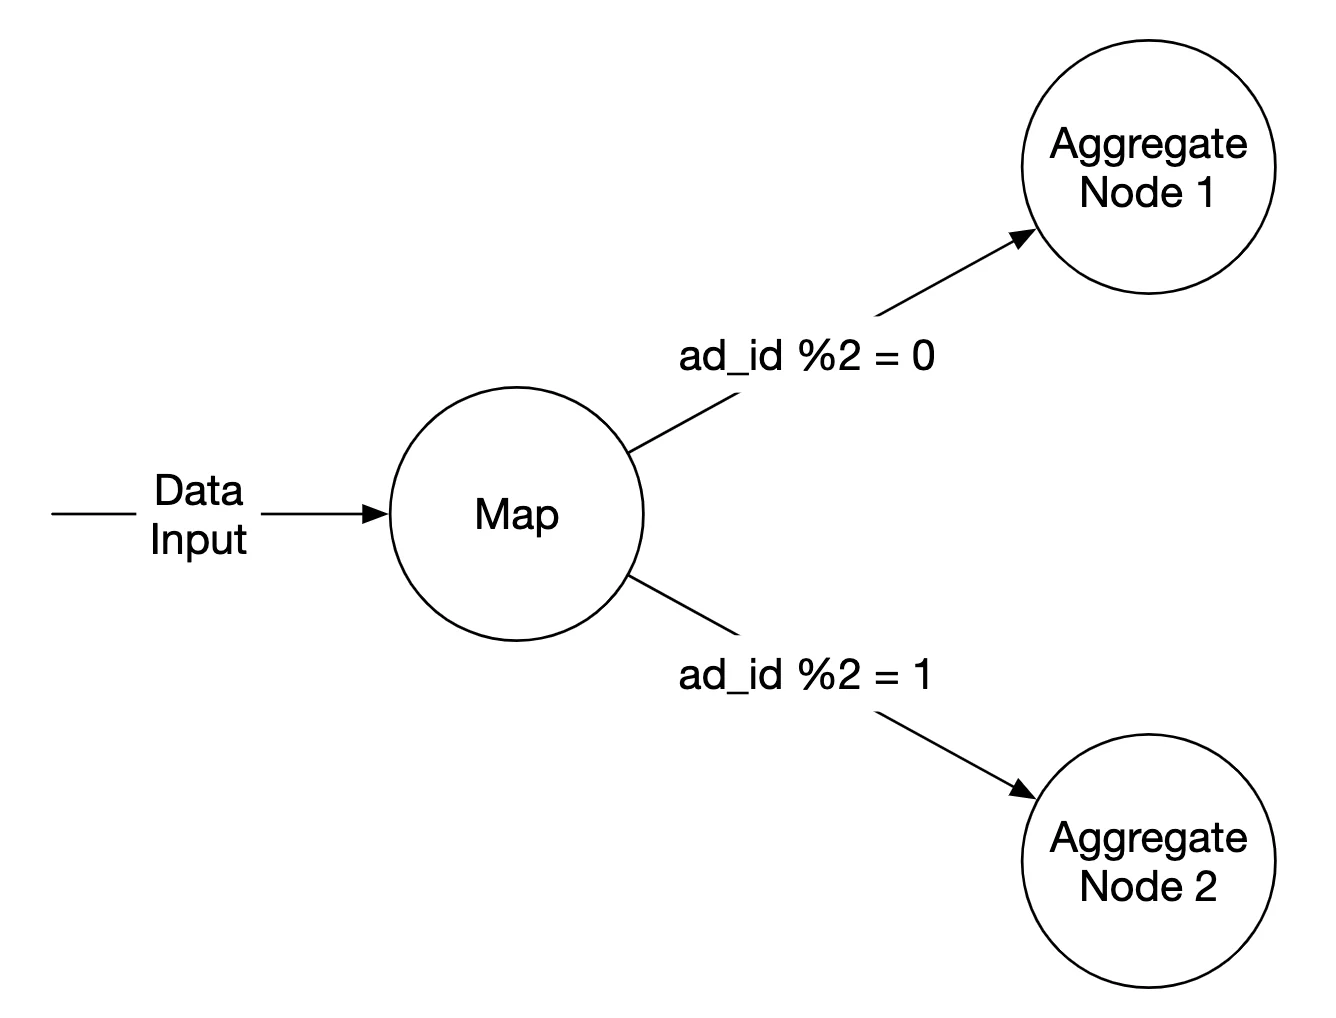
另一种做法是,我们把广告分布到不同的 Kafka 分区上,让聚合节点在一个消费者组内直接订阅。 不过,Map 节点让我们能够在后续处理之前对数据进行清洗或转换。
另一个原因可能是我们无法控制数据的生产方式,
因此与同一个 ad_id 相关的事件可能会进入不同的分区。
聚合(Aggregate)节点每分钟在内存中按 ad_id 统计广告点击事件。
Reduce 节点从聚合节点收集聚合结果,并生成最终结果:
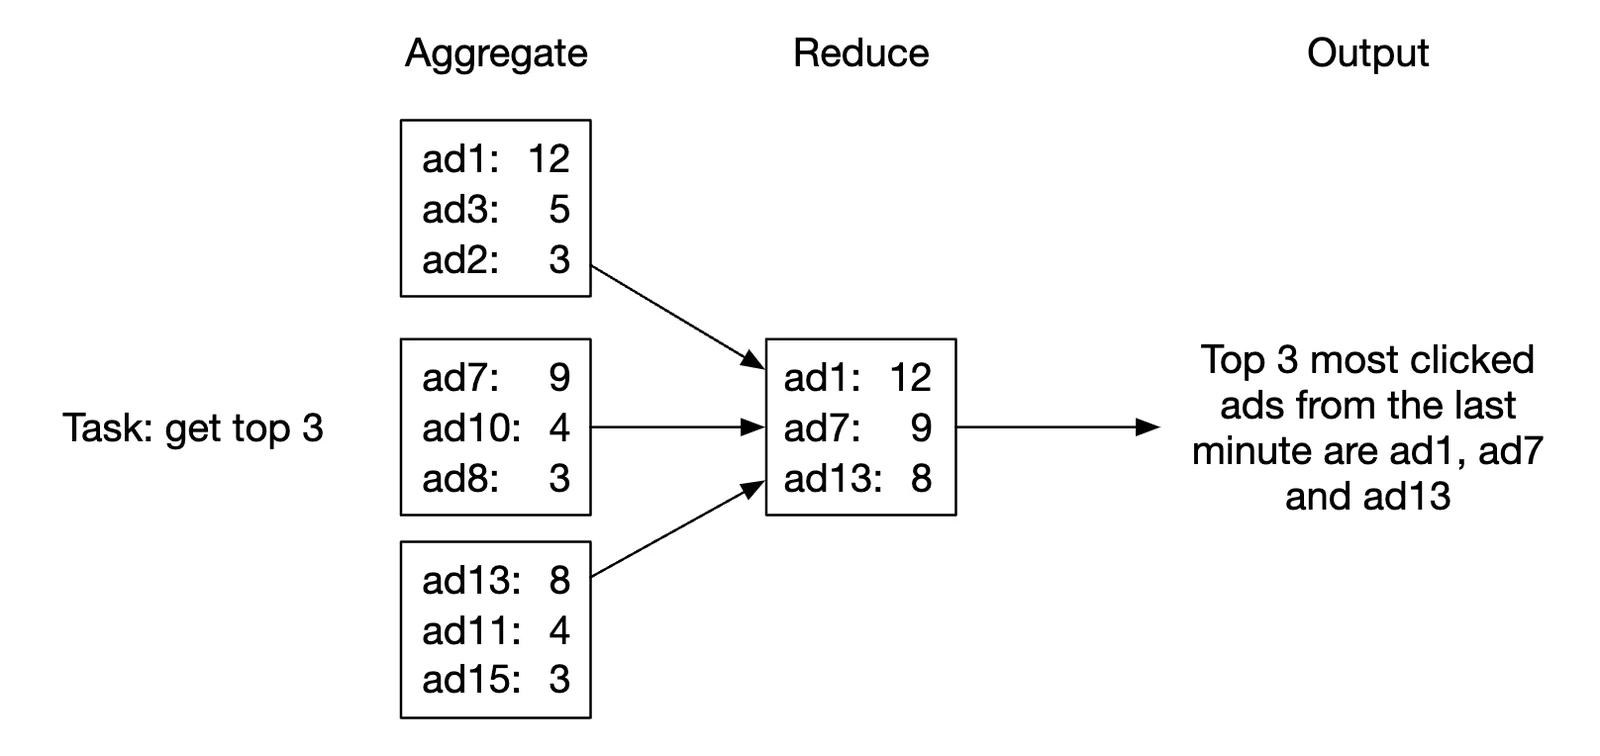
这个 DAG 模型采用了 MapReduce 范式。它接收大数据,并利用并行分布式计算把它变成常规大小的数据。
在 DAG 模型中,中间数据存储在内存中,不同节点之间通过 TCP 或共享内存进行通信。
我们来看看这个模型如何帮助我们实现各种用例。
用例 1:聚合点击次数:
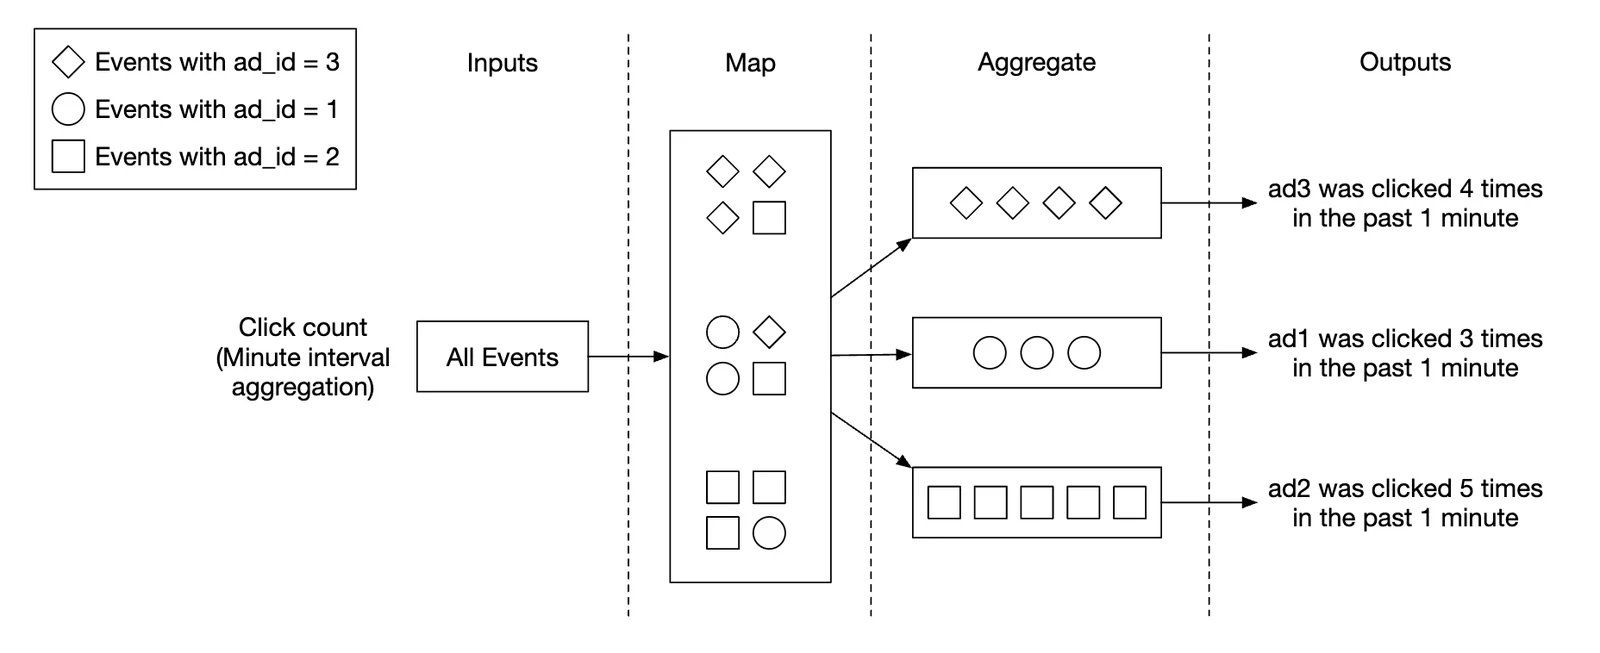
- 广告使用
ad_id % 3进行分区
用例 2:返回点击次数最多的前 N 个广告:
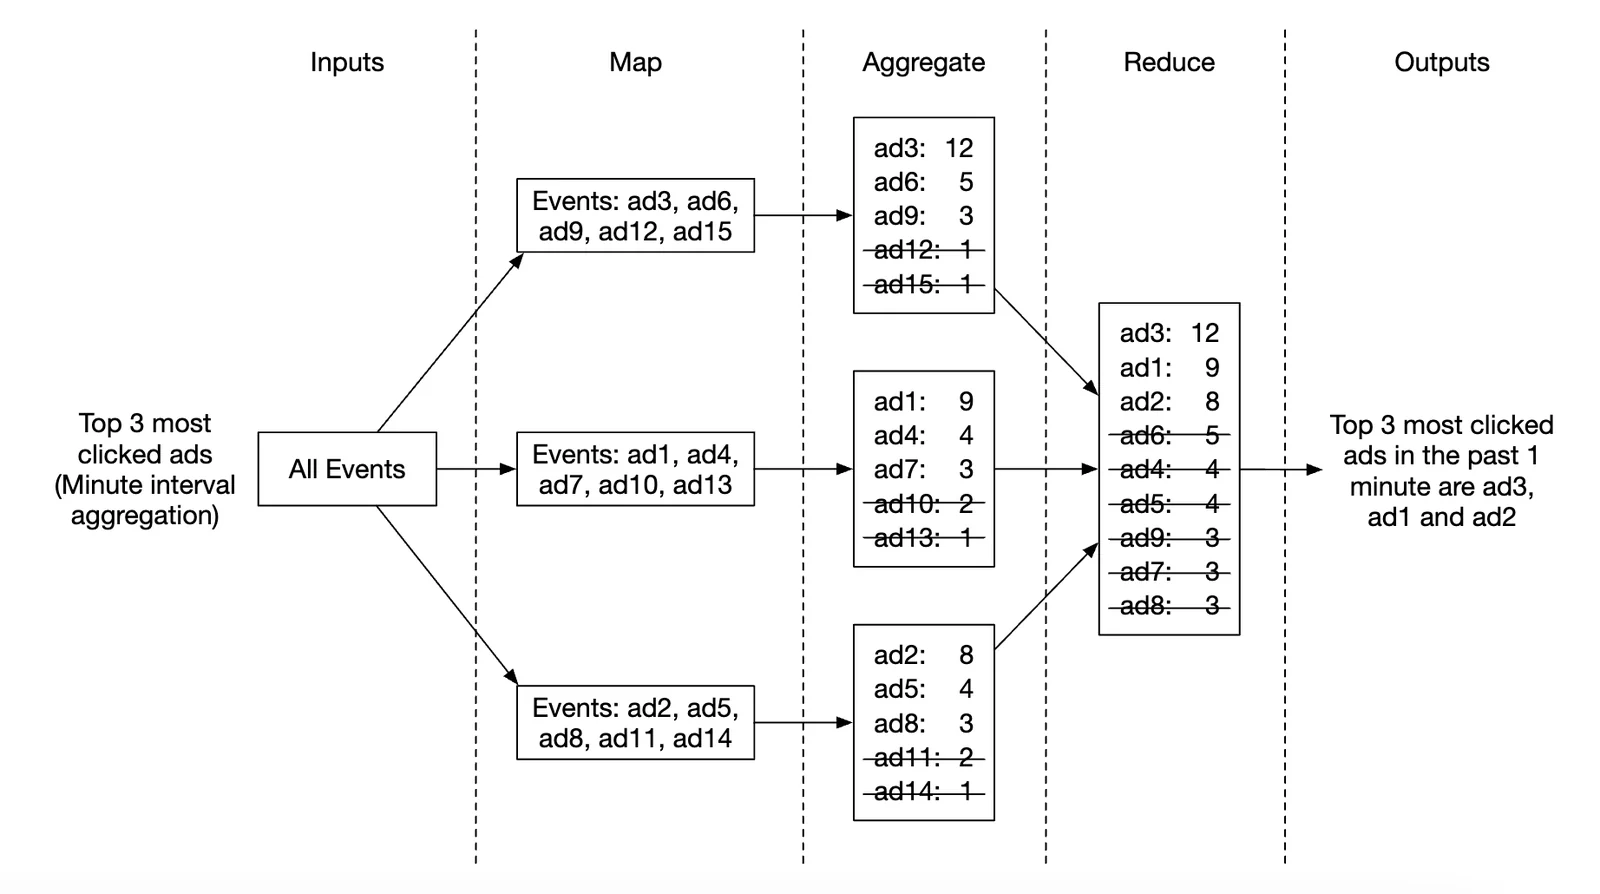
- 在这个例子中,我们聚合的是前 3 个广告,但它可以很容易地扩展到前 N 个广告
- 每个节点维护一个堆数据结构,以便快速获取前 N 个广告
用例 3:数据过滤: 为了支持快速的数据过滤,我们可以预先定义过滤条件,并基于这些条件进行预聚合: | ad_id | click_minute | country | count | |-------|--------------|---------|-------| | ad001 | 202101010001 | USA | 100 | | ad001 | 202101010001 | GPB | 200 | | ad001 | 202101010001 | others | 3000 | | ad002 | 202101010001 | USA | 10 | | ad002 | 202101010001 | GPB | 25 | | ad002 | 202101010001 | others | 12 |
这种技术称为星型模式(Star Schema),在数据仓库中被广泛使用。 用于过滤的字段称为维度(Dimension)。
这种方式有以下好处:
- 易于理解和构建
- 可以复用现有的聚合服务,在星型模式中创建更多维度。
- 由于结果是预先计算好的,按过滤条件访问数据速度很快
这种方式的一个局限是会产生多得多的桶和记录,尤其是在过滤条件很多的时候。
第 3 步:设计深入探讨
我们来深入探讨一些更有意思的话题。
流处理与批处理
我们提出的高层架构属于一种流处理系统。 下面是三类系统的比较: | | 服务(在线系统) | 批处理系统(离线系统) | 流处理系统(近实时系统) | |-------------------------|-------------------------------|--------------------------------------------------------|----------------------------------------------| | 响应性 | 快速响应客户端 | 无需响应客户端 | 无需响应客户端 | | 输入 | 用户请求 | 大小有限的有界输入,数据量很大 | 输入没有边界(无限流) | | 输出 | 对客户端的响应 | 物化视图、聚合指标等 | 物化视图、聚合指标等 | | 性能衡量 | 可用性、延迟 | 吞吐量 | 吞吐量、延迟 | | 示例 | 在线购物 | MapReduce | Flink [13] |
在我们的设计中,混合使用了批处理和流处理。
我们用流处理在数据到达时进行处理,并以近实时的方式生成聚合结果。 另一方面,我们用批处理进行历史数据备份。
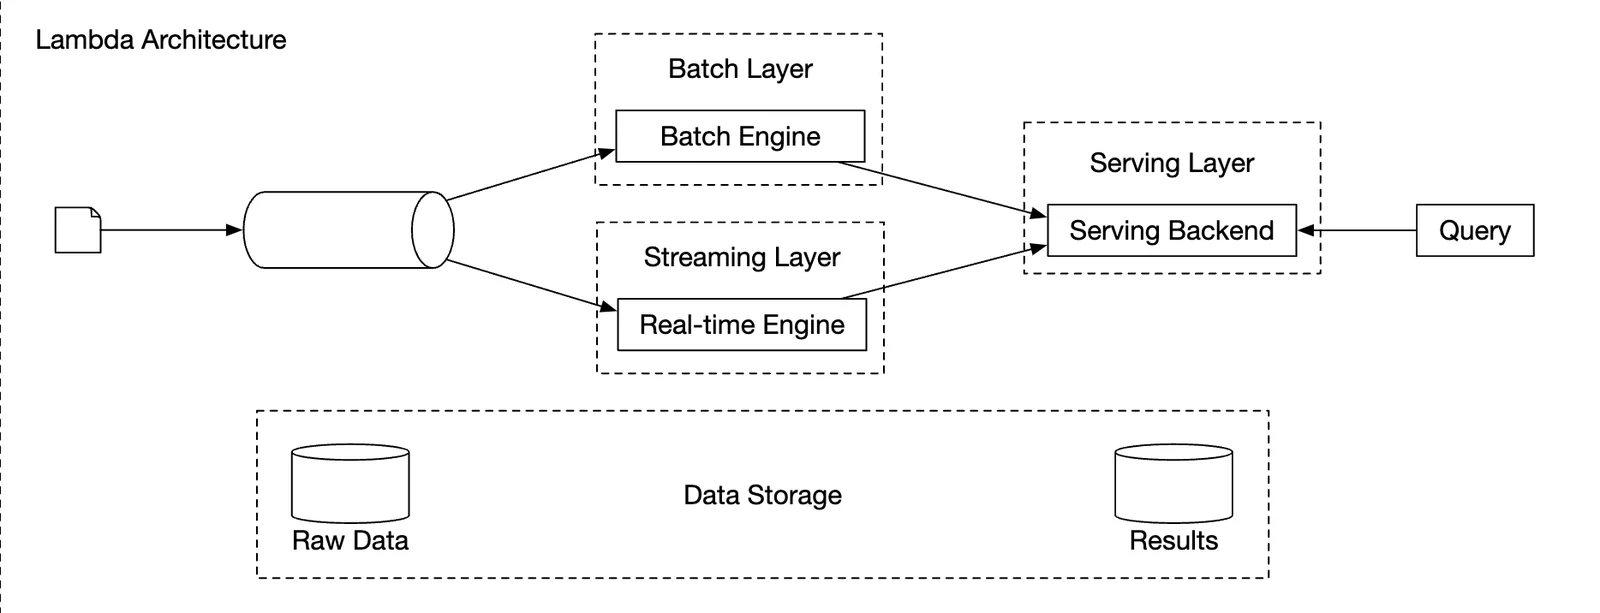
同时包含批处理和流处理两条处理路径的系统,这种架构称为 Lambda 架构。 它的一个缺点是你有两条处理路径,需要维护两套不同的代码库。
Kappa 是另一种架构,它把批处理和流处理合并到一条处理路径中。 其核心思想是使用单一的流处理引擎。
Lambda 架构:
Kappa 架构:
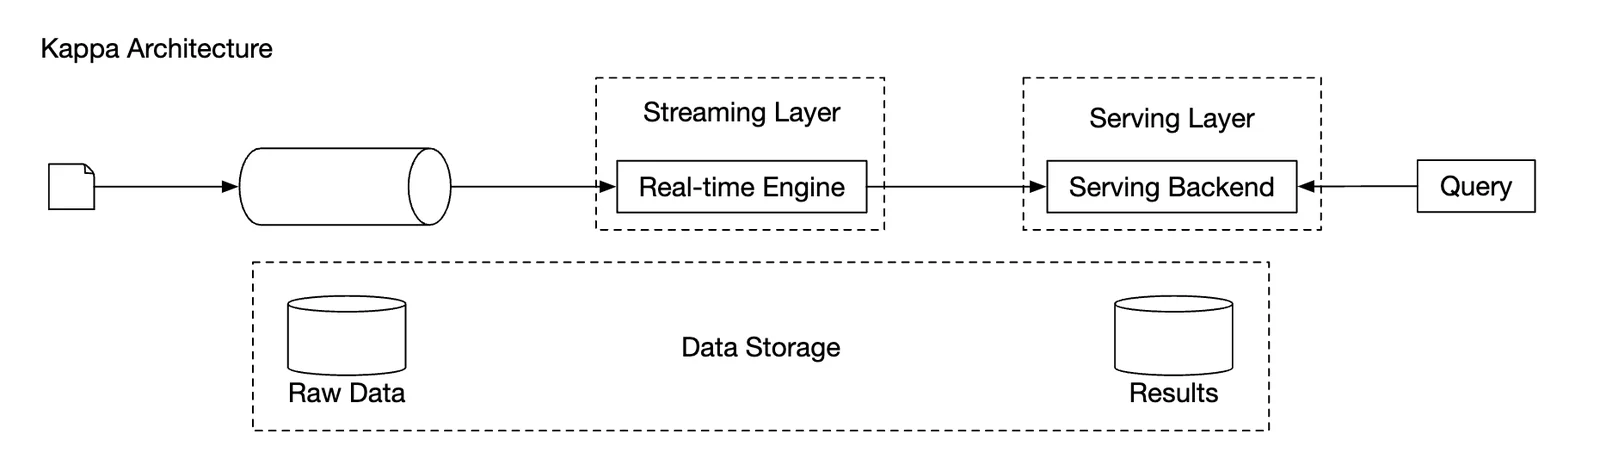
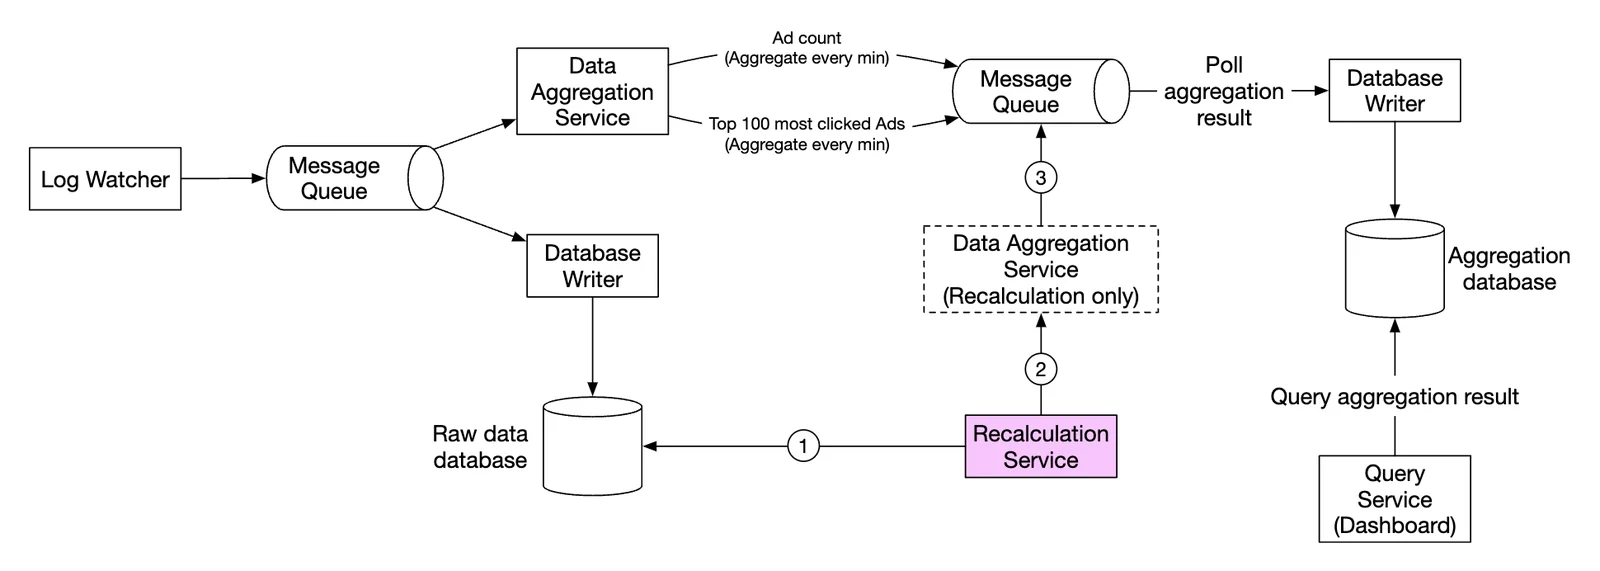
我们的高层设计采用的是 Kappa 架构,因为历史数据的重新处理同样经过聚合服务。
每当需要重新计算聚合数据时(例如聚合逻辑中出现重大 bug),我们都可以从存储的原始数据重新计算聚合结果。
- 重新计算服务从原始存储中获取数据。这是一个批处理作业。
- 获取到的数据被发送到一个专用的聚合服务,这样就不会影响实时处理的聚合服务。
- 聚合结果被发送到第二个消息队列,之后我们再更新聚合数据库中的结果。
时间
我们需要一个时间戳来进行聚合。它可以在两个地方生成:
- 事件时间(event time):广告点击发生的时间
- 处理时间(processing time):服务器处理该事件时的系统时间
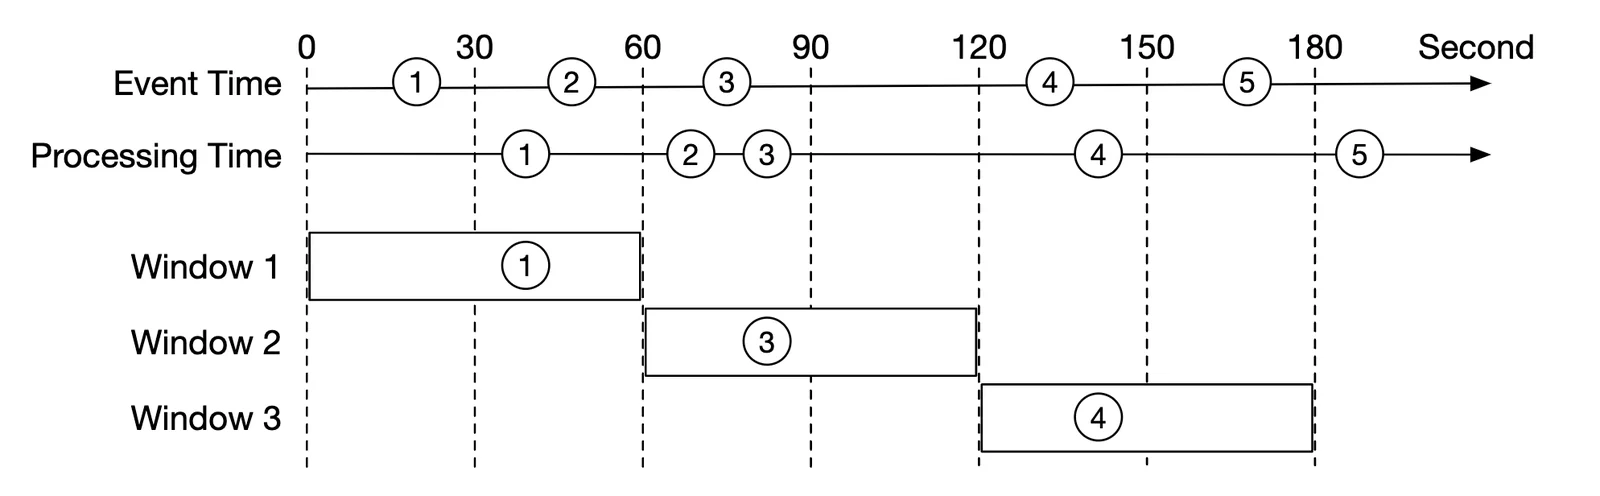
由于使用了异步处理(消息队列)以及存在网络延迟,事件时间和处理时间之间可能存在显著差异。
- 如果使用处理时间,聚合结果可能不准确
- 如果使用事件时间,就必须处理延迟到达的事件
没有完美的解决方案,我们需要权衡利弊: | | 优点 | 缺点 | |-----------------|---------------------------------------|--------------------------------------------------------------------------------------| | 事件时间 | 聚合结果更准确 | 客户端的时间可能不对,或者时间戳可能由恶意用户生成 | | 处理时间 | 服务器时间戳更可靠 | 如果事件延迟到达,时间戳就不准确 |
由于数据准确性很重要,我们将使用事件时间进行聚合。
为了缓解事件延迟的问题,可以利用一种称为「水位线(watermark)」的技术。
在下面的例子中,事件 2 错过了它本应被聚合进去的窗口:
然而,如果我们有意延长聚合窗口,就可以降低错过事件的可能性。 窗口中被延长的部分称为「水位线」:
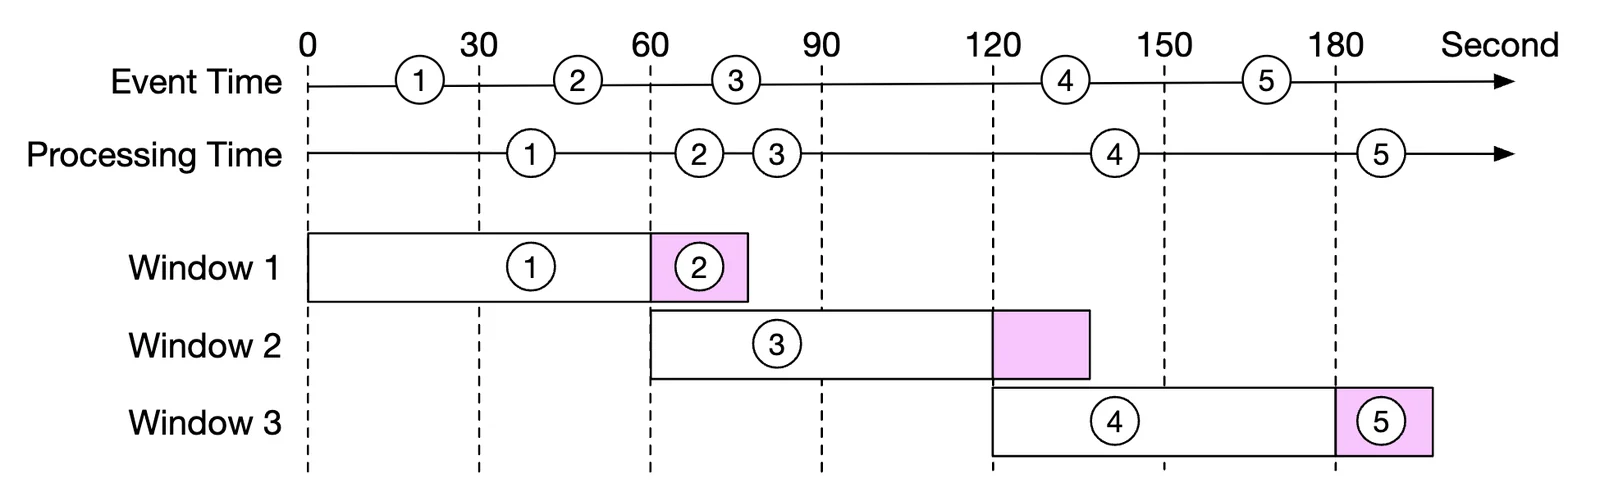
- 较短的水位线会增加错过事件的可能性,但能降低延迟
- 较长的水位线会降低错过事件的可能性,但会增加延迟
无论水位线有多长,总是存在错过事件的可能。但为这种低概率事件做优化没有意义。
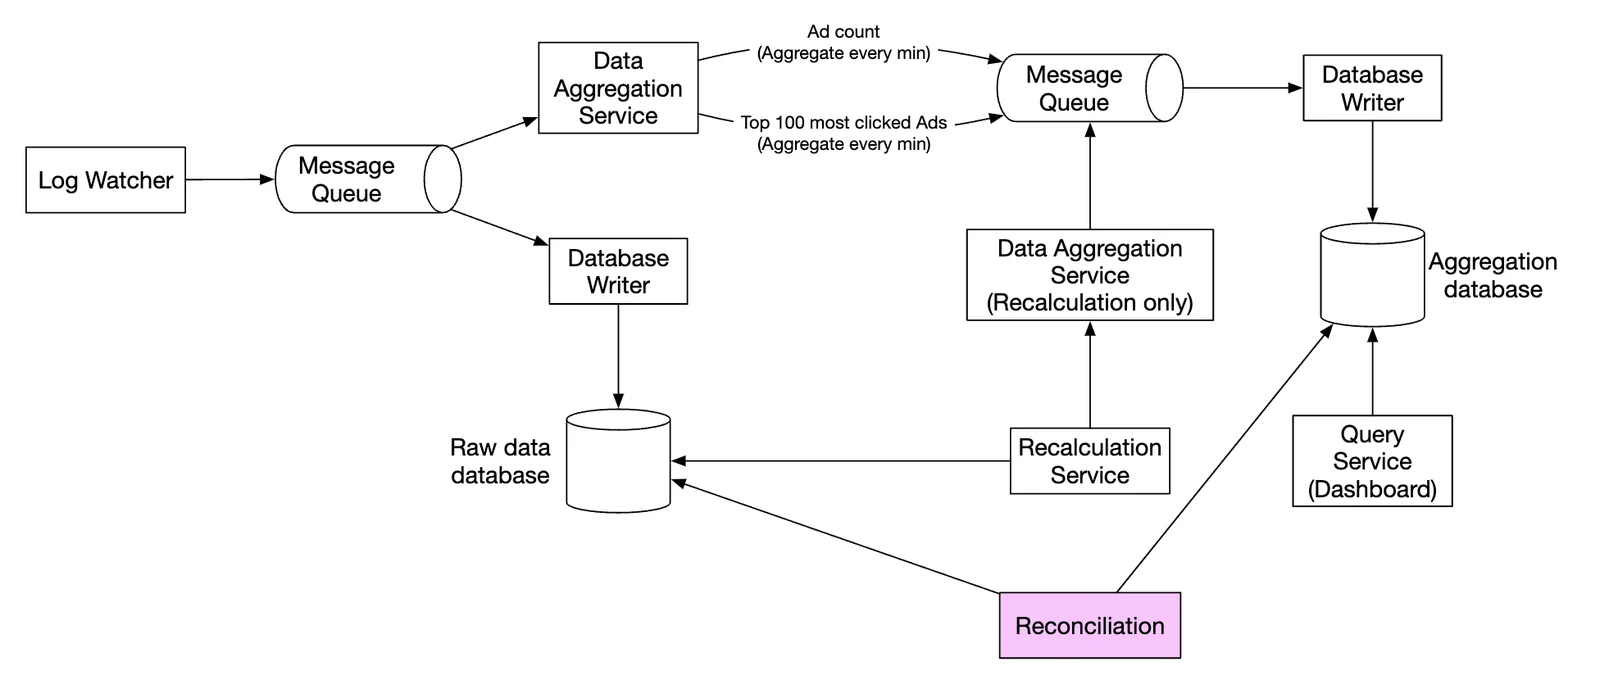
我们可以改为通过每日结束时的对账(reconciliation)来解决这类不一致。
聚合窗口
窗口函数有四种类型:
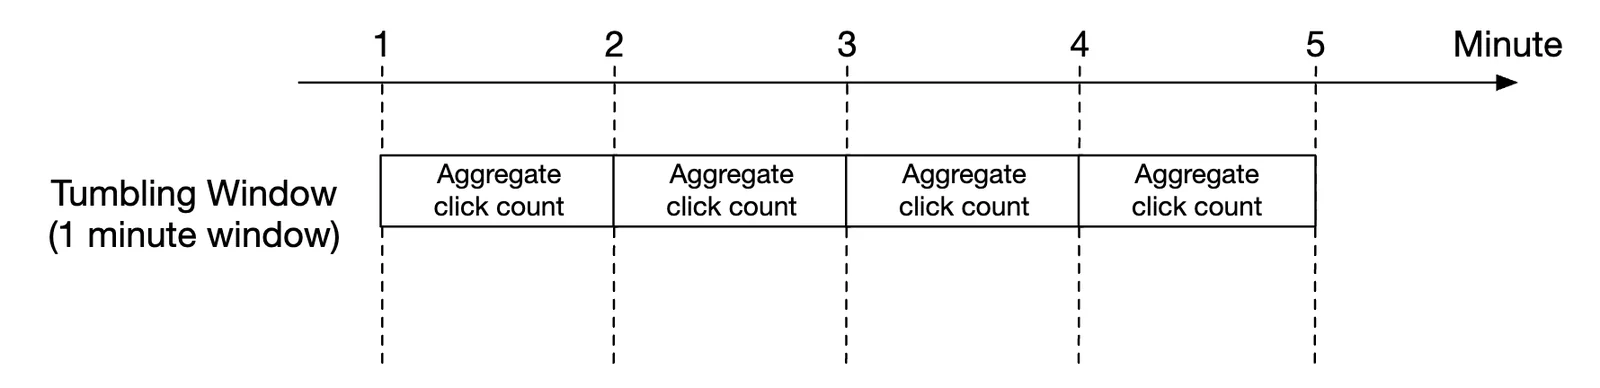
- 滚动(固定)窗口(Tumbling Window)
- 跳跃窗口(Hopping Window)
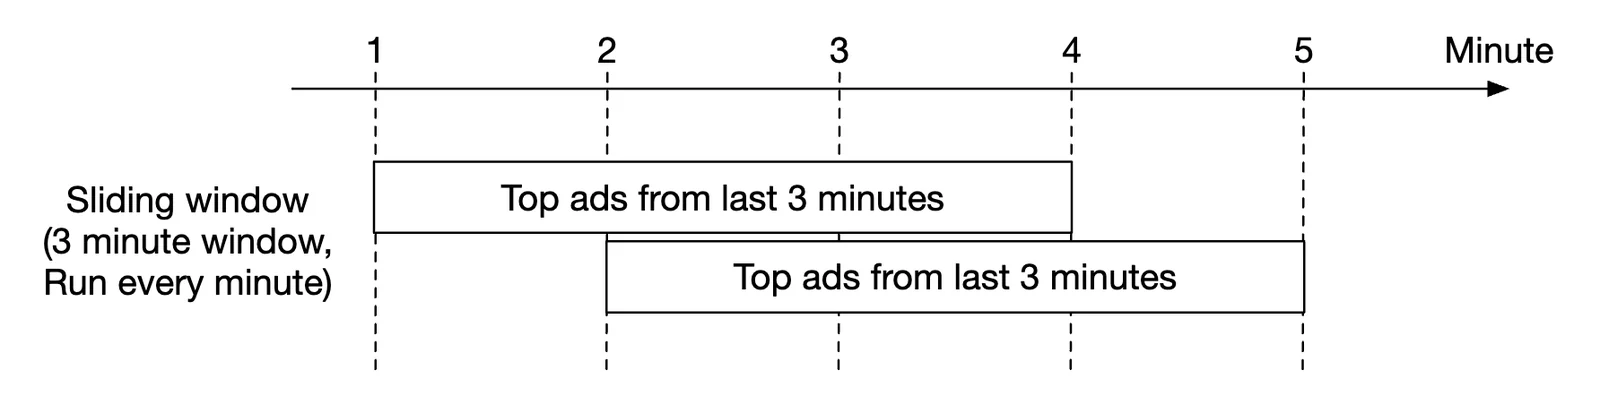
- 滑动窗口(Sliding Window)
- 会话窗口(Session Window)
在我们的设计中,广告点击聚合使用滚动窗口:
而 M 分钟内点击次数最多的前 N 个广告的聚合则使用滑动窗口:
投递保证
由于我们聚合的数据将用于计费,数据准确性是首要任务。
因此,我们需要讨论:
- 如何避免处理重复的事件
- 如何确保所有事件都被处理
我们可以使用三种投递保证(delivery guarantee):至多一次(at-most-once)、至少一次(at-least-once)和恰好一次(exactly-once)。
在大多数情况下,如果可以接受少量重复,至少一次就足够了。 但我们的系统并非如此,因为很小的百分比差异就可能导致数百万美元的偏差。 因此,我们需要使用恰好一次的投递语义。
数据去重
最常见的数据质量问题之一就是数据重复。
重复数据的来源多种多样:
- 客户端:客户端可能会多次重发同一个事件。出于恶意目的发送的重复事件最好交由风控引擎处理。
- 服务器宕机:某个聚合服务节点在聚合过程中宕机,上游服务没有收到确认,于是重发了事件。
下面这个例子展示了由于最后一跳未能确认事件而导致的数据重复:
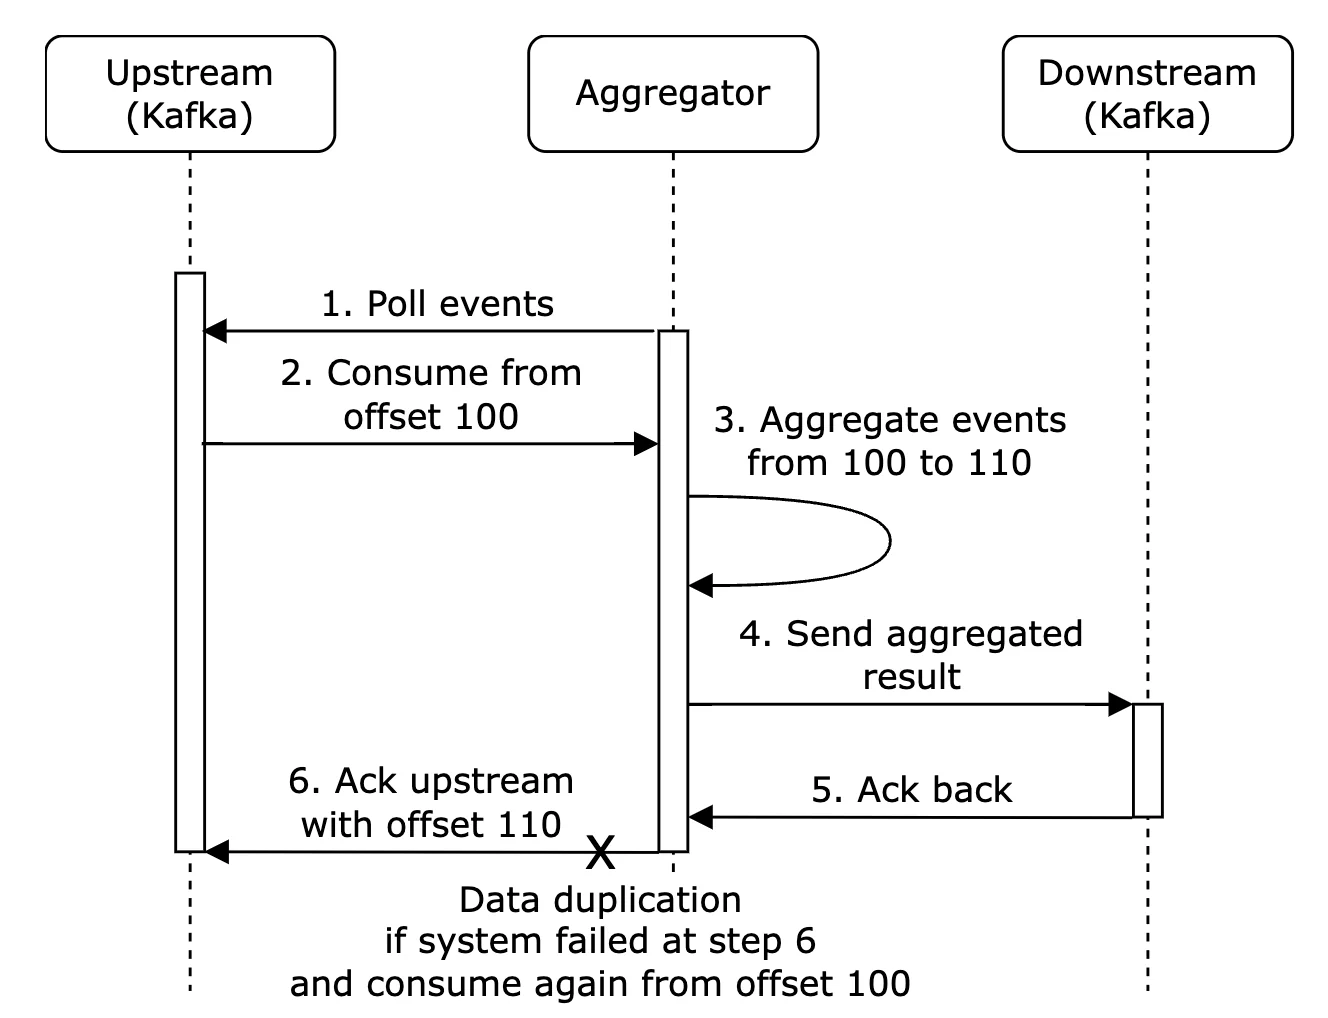
在这个例子中,偏移量 100 会被多次处理并发送到下游。
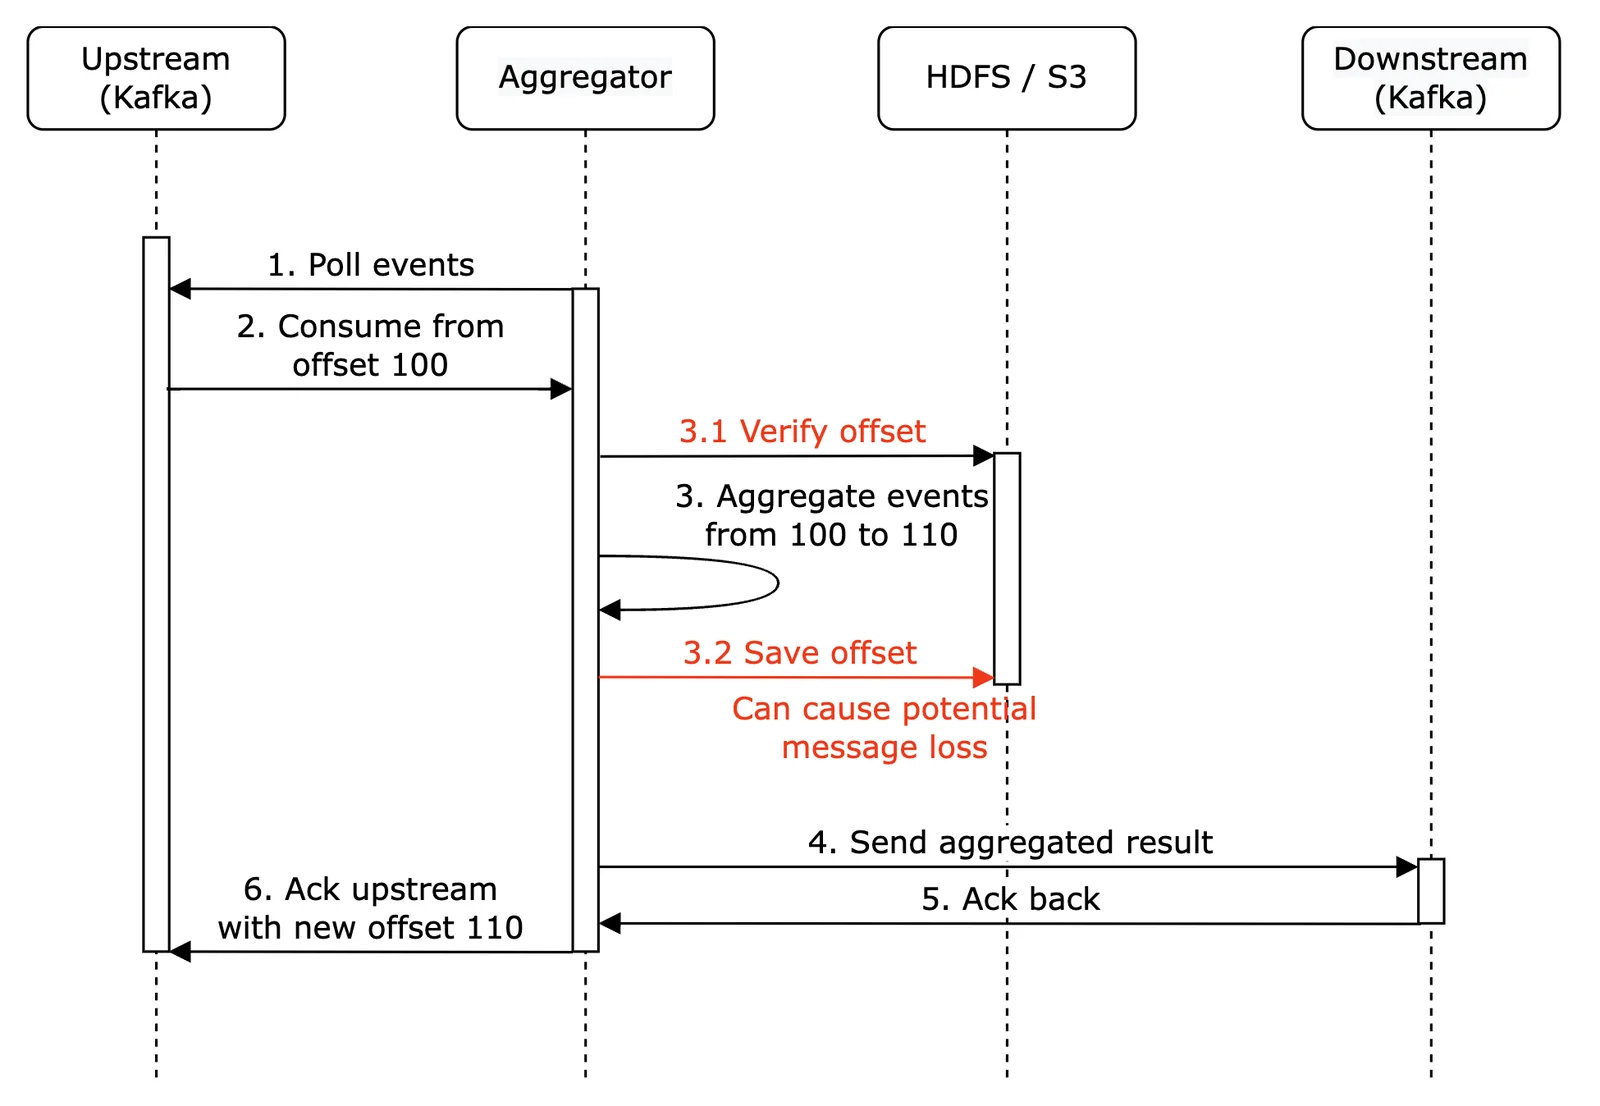
缓解这个问题的一种做法是把最后看到的偏移量存储在 HDFS/S3 中,但这样可能导致结果永远到不了下游:
最终,我们可以在与下游交互的同时以原子方式存储偏移量。要做到这一点,我们需要实现分布式事务:
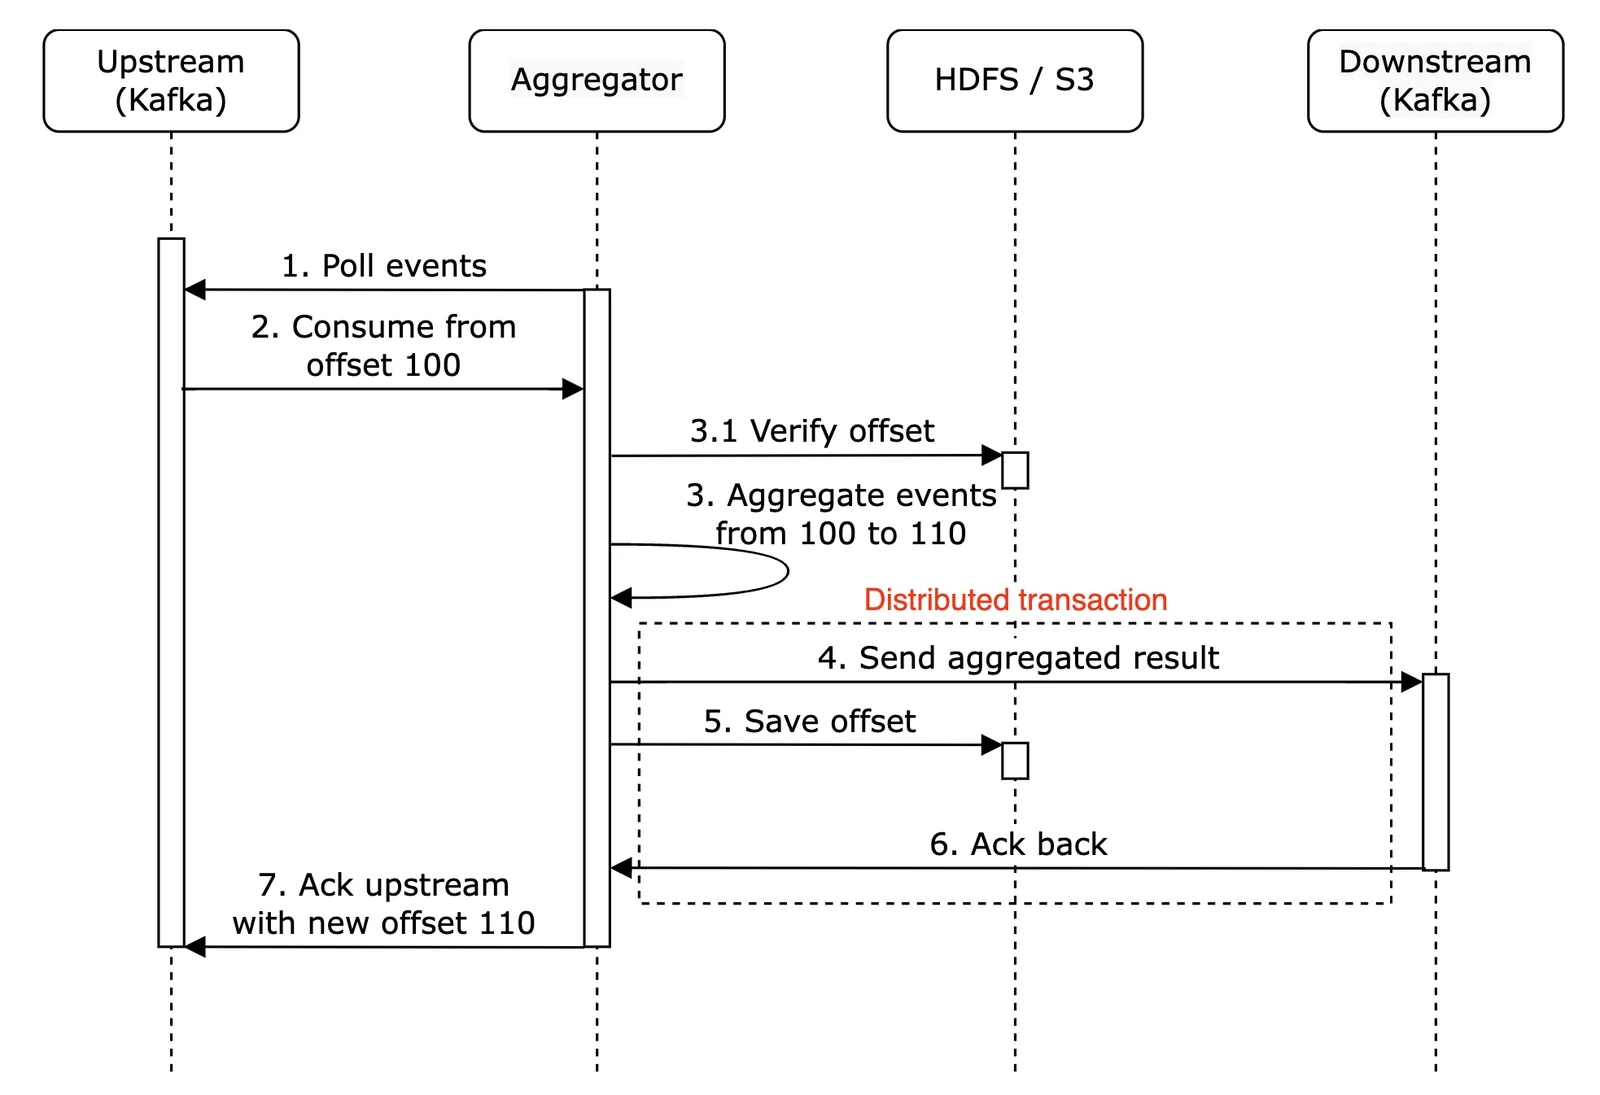
个人备注:另外,如果下游系统以幂等(idempotent)的方式处理聚合结果,就不需要分布式事务了。
系统扩展
我们来讨论随着系统增长该如何扩展它。
我们有三个独立的组件:消息队列、聚合服务和数据库。 由于它们是解耦的,我们可以独立地扩展它们。
如何扩展消息队列:
- 我们不限制生产者,因此生产者可以很容易地扩展
- 可以通过把消费者分配到消费者组并增加消费者数量来扩展消费者。
- 要做到这一点,我们还需要确保预先创建了足够多的分区
- 此外,当有数千个消费者时,消费者再平衡(rebalancing)可能会花费一些时间,因此建议在非高峰时段进行
- 我们还可以考虑按地理位置对主题(topic)进行分区,例如
topic_na、topic_eu等。
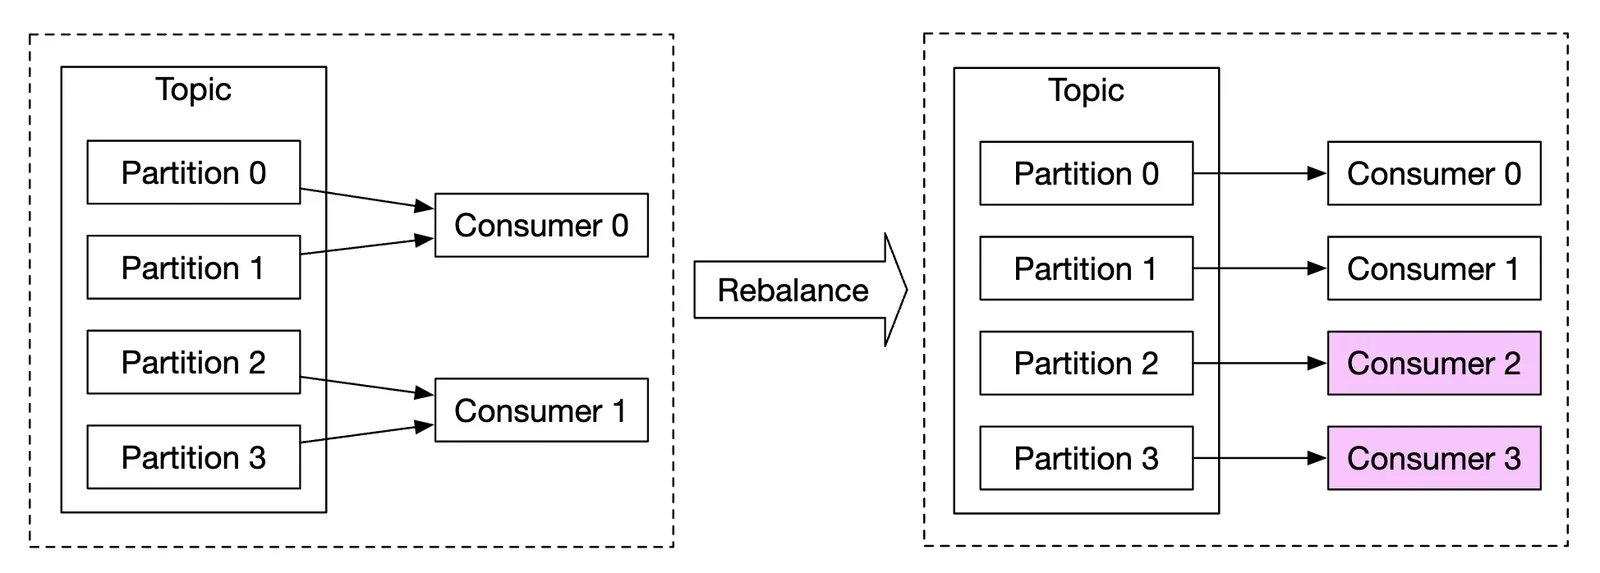
如何扩展聚合服务:
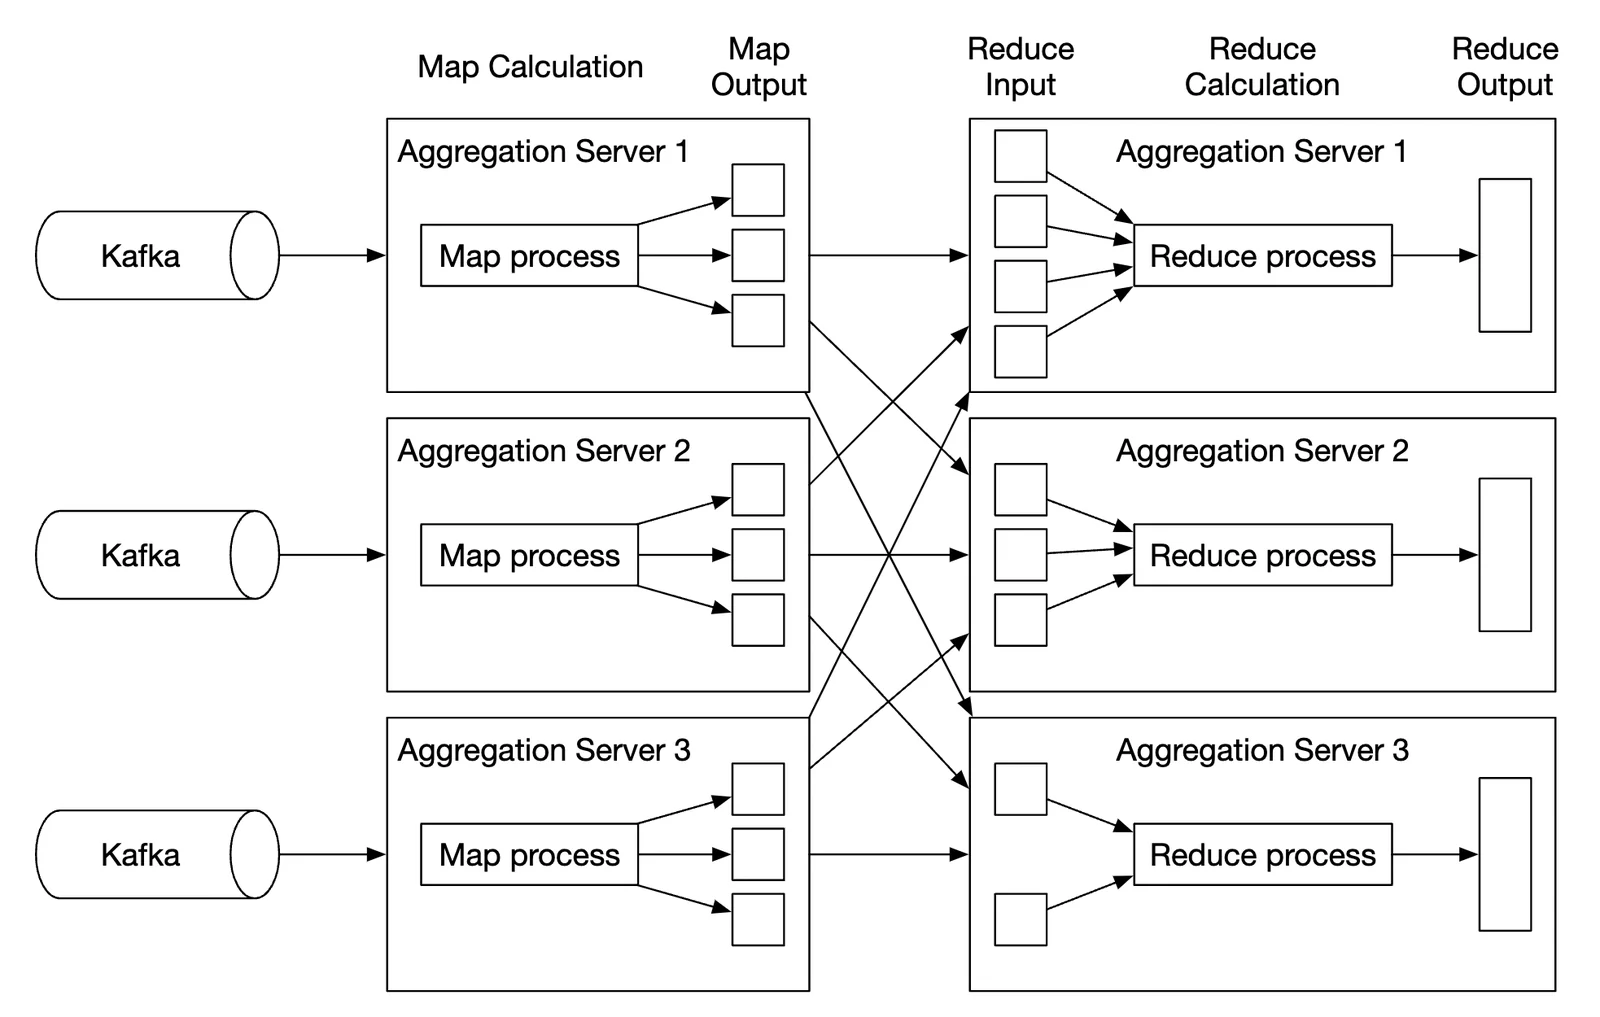
- Map-Reduce 节点可以通过添加更多节点轻松扩展
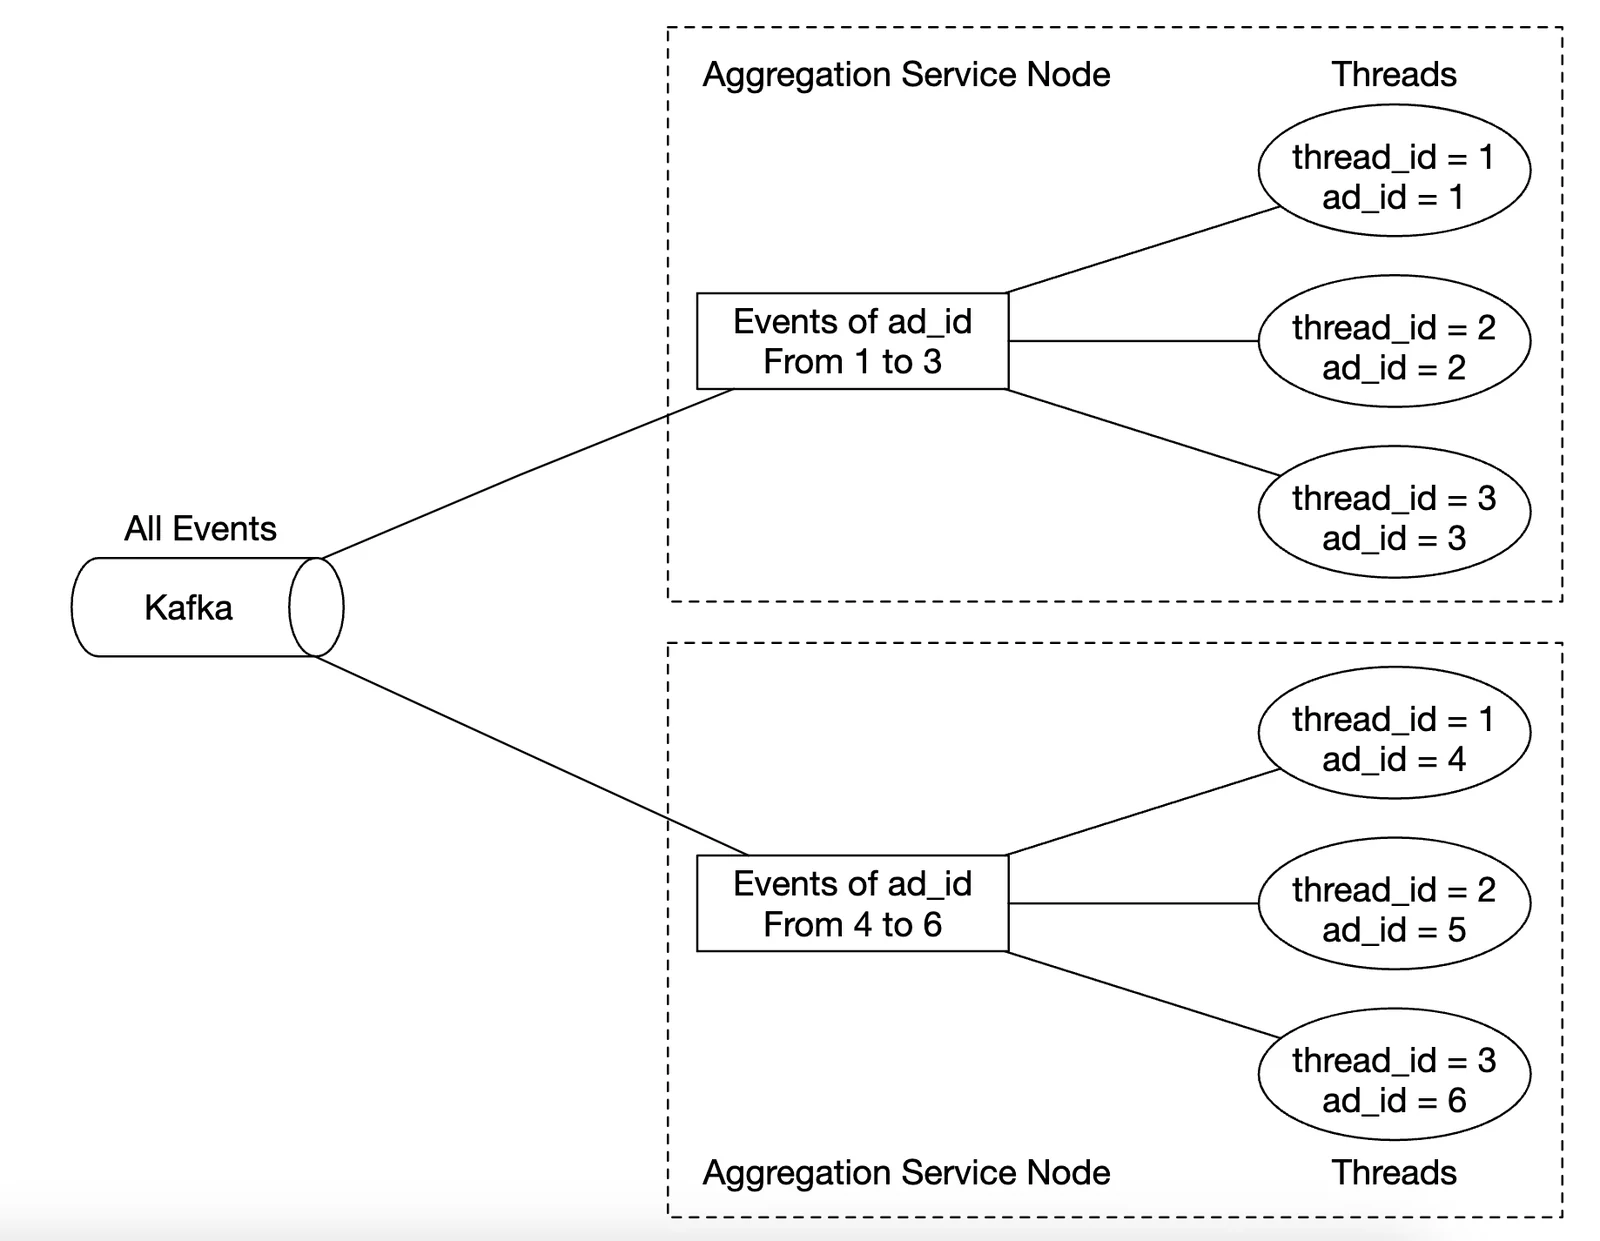
- 可以利用多线程来提升聚合服务的吞吐量
- 另外,我们也可以利用 Apache YARN 这样的资源提供者来使用多进程
- 方案 1 更简单,但方案 2 在实践中使用得更广泛,因为它的可扩展性更好
- 下面是多线程的示例:
如何扩展数据库:
- 如果我们使用 Cassandra,它原生支持利用一致性哈希进行水平扩展
- 如果向集群添加新节点,数据会自动在所有(虚拟)节点之间重新平衡
- 采用这种方式,不需要手动(重新)分片
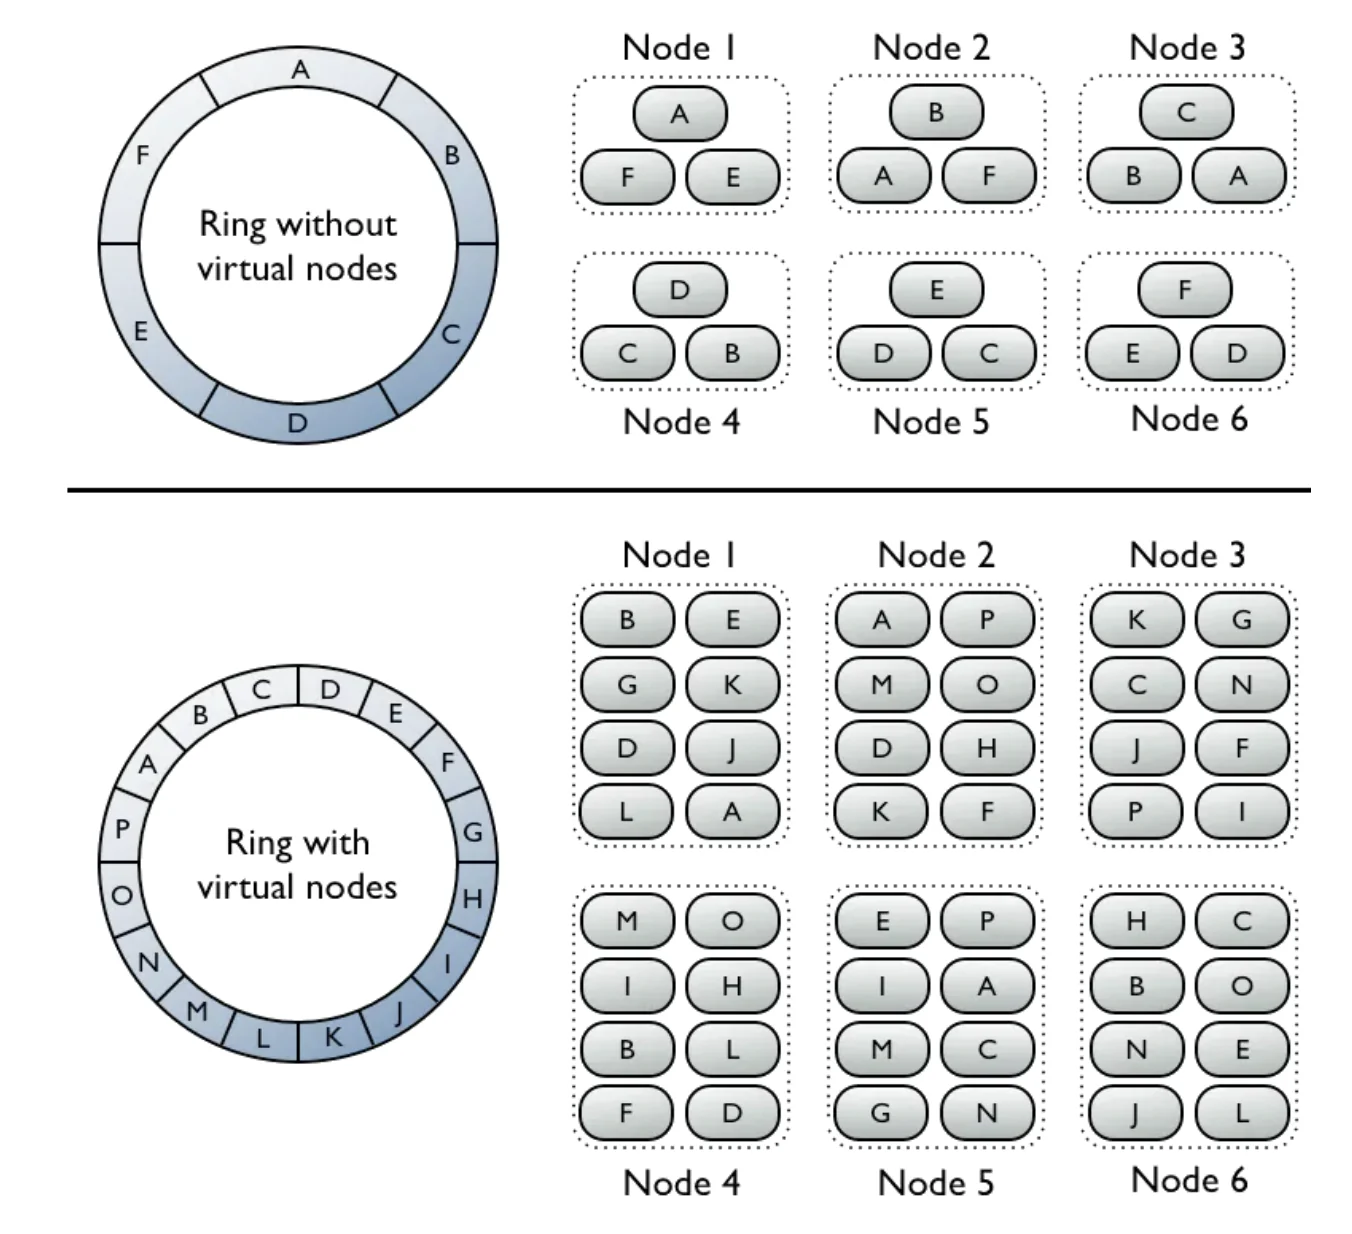
另一个需要考虑的可扩展性问题是热点(hotspot)问题:如果某个广告比其他广告更受欢迎、获得更多关注怎么办?
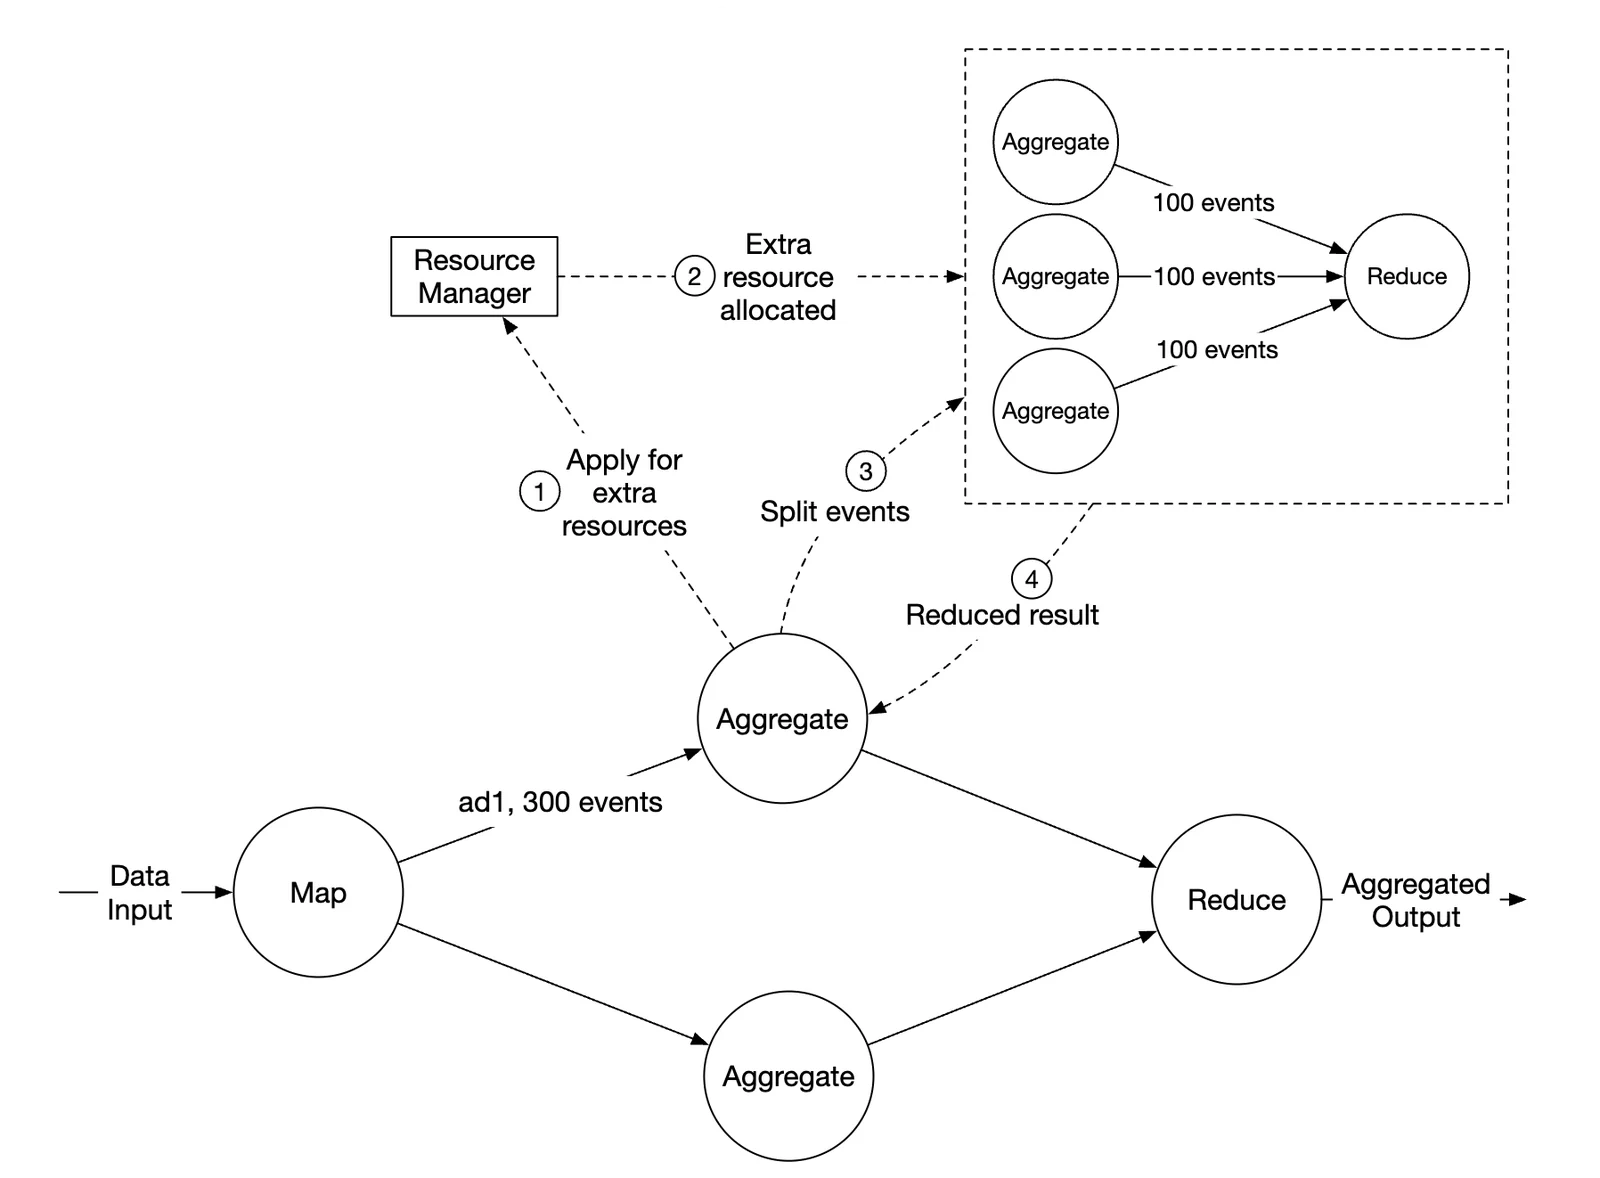
- 在上面的例子中,聚合服务节点可以通过资源管理器申请额外的资源
- 资源管理器分配更多资源,这样原节点就不会过载
- 原节点把事件分成 3 组,每个聚合节点处理 100 个事件
- 结果被写回原来的聚合节点
处理热点问题的其他更复杂的方法:
- 全局-本地聚合(Global-Local Aggregation)
- 拆分去重聚合(Split Distinct Aggregation)
容错
在聚合节点内部,我们是在内存中处理数据的。如果某个节点宕机,已处理的数据就会丢失。
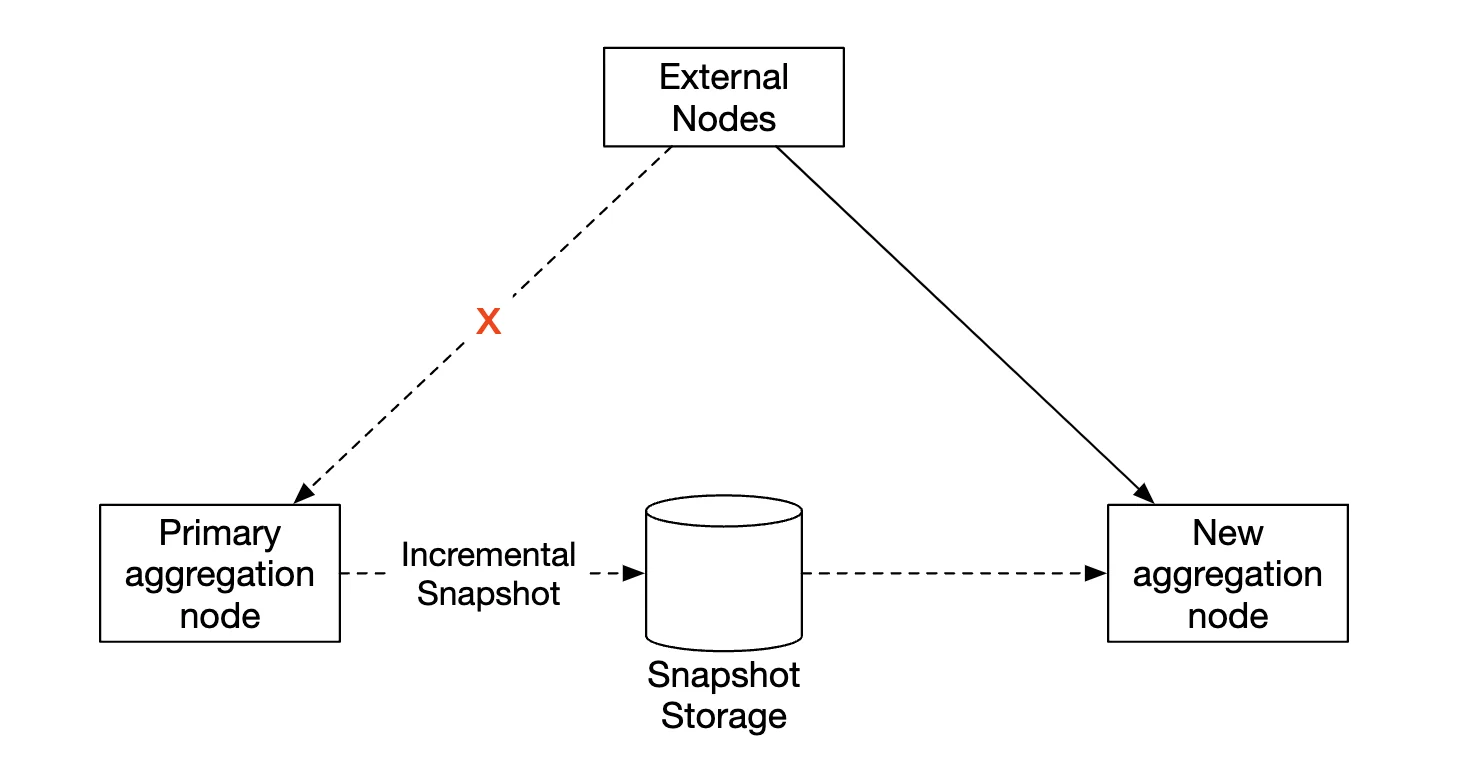
当另一个节点接手工作时,我们可以利用 Kafka 中的消费者偏移量从中断的地方继续。 不过,由于我们要聚合 M 分钟内的前 N 个广告,还需要维护额外的中间状态。
我们可以在某个特定分钟为正在进行的聚合生成快照:
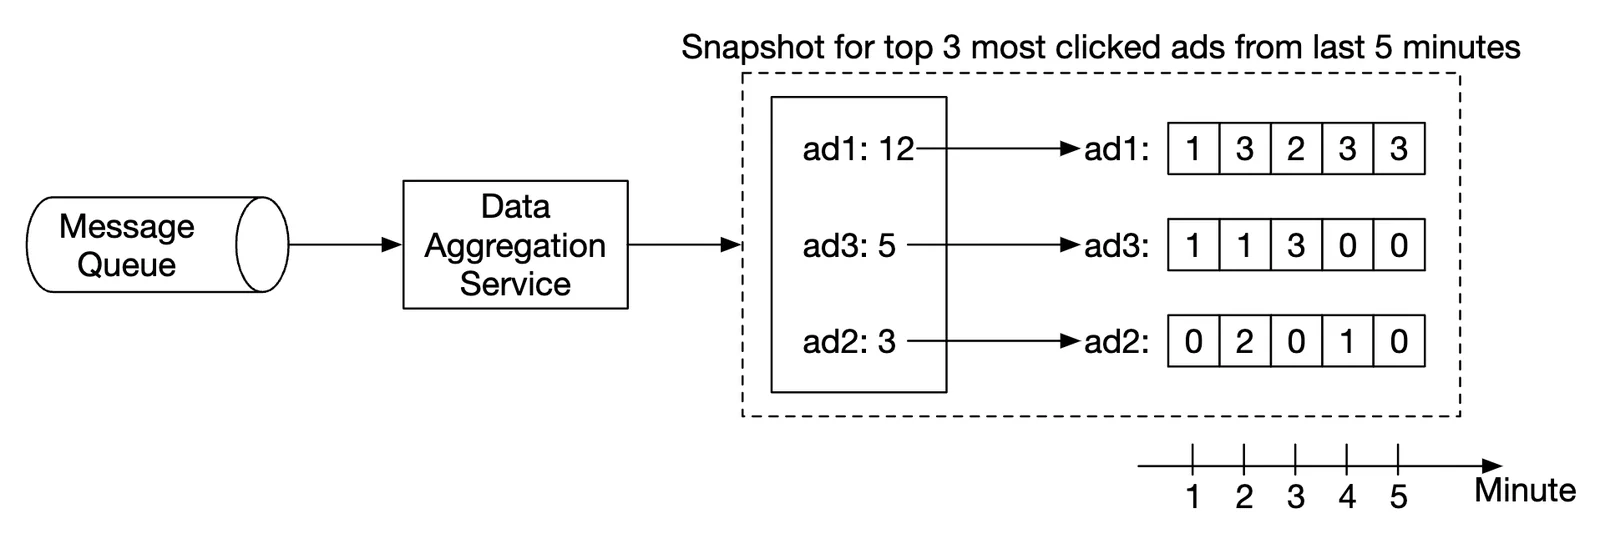
如果某个节点宕机,新节点可以读取最新提交的消费者偏移量以及最新的快照,继续执行作业:
数据监控与正确性
由于我们聚合的数据用于计费,非常关键,因此建立严格的监控来确保正确性非常重要。
我们可能需要监控的一些指标:
- 延迟:可以追踪不同事件的时间戳,以了解系统的端到端延迟
- 消息队列大小:如果队列大小突然增加,我们就需要添加更多聚合节点。由于 Kafka 是通过分布式提交日志实现的,我们需要改为追踪 records-lag 指标。
- 聚合节点上的系统资源:CPU、磁盘、JVM 等。
我们还需要实现一个对账流程,它是一个在每天结束时运行的批处理作业。 它根据原始数据计算聚合结果,并与聚合数据库中实际存储的数据进行比较:
替代设计
在通用的系统设计面试中,并不要求你了解大数据处理中所用专业软件的内部原理。
解释思考过程并讨论权衡比了解具体工具更重要,这也是本章介绍通用解决方案的原因。
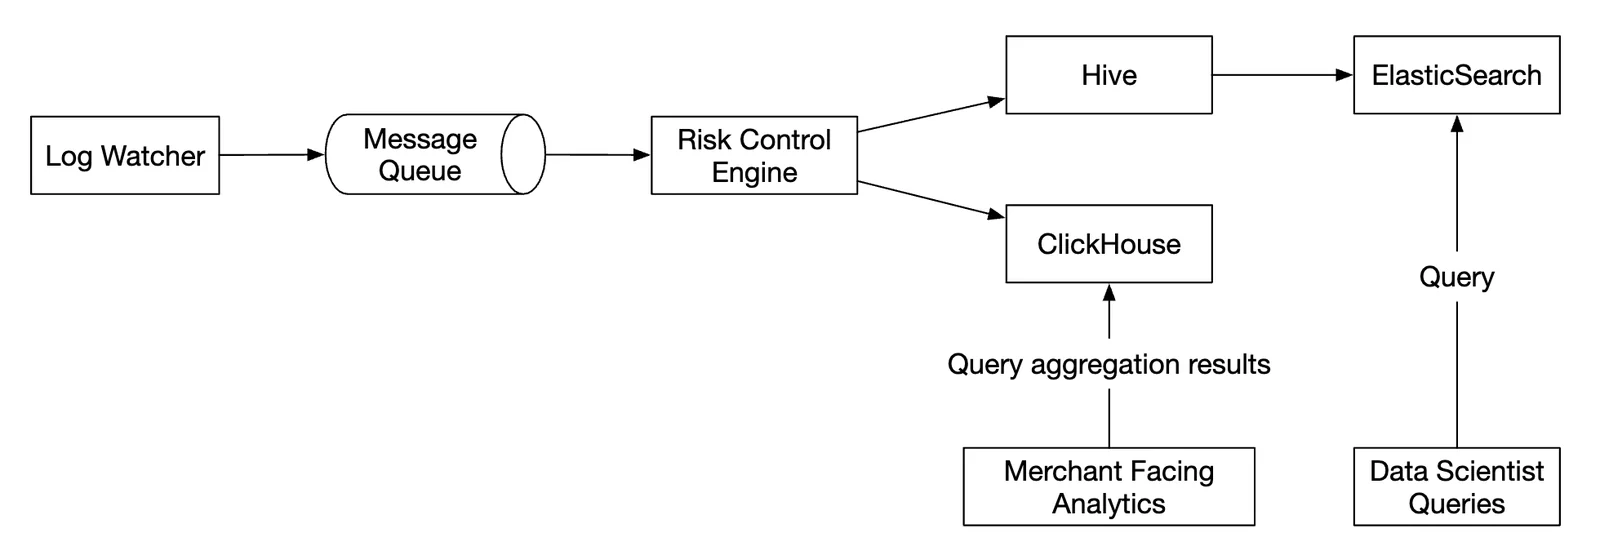
另一种利用现成工具的替代设计是:把广告点击数据存储在 Hive 中,并在其上构建一层 ElasticSearch 以加快查询。
聚合通常在 ClickHouse 或 Druid 这样的 OLAP 数据库中完成。
第 4 步:总结
我们讨论了以下内容:
- 数据模型与 API 设计
- 使用 MapReduce 聚合广告点击事件
- 扩展消息队列、聚合服务和数据库
- 缓解热点问题
- 持续监控系统
- 通过对账确保正确性
- 容错
广告点击事件聚合是一个典型的大数据处理系统。
如果你事先了解以下相关技术,会更容易理解和设计它:
- Apache Kafka
- Apache Spark
- Apache Flink