第 22 章 酒店预订系统
引言
本章我们要设计一个酒店预订系统(Hotel Reservation System),类似万豪国际(Marriott International)。
这套设计同样适用于其他类型的系统:Airbnb、机票预订、电影票预订。
第 1 步:理解问题并确定设计范围
在动手设计系统之前,我们应该先向面试官提问,明确范围:
- 候选人:系统的规模有多大?
- 面试官:我们要为一家拥有 5000 家酒店、共 100 万间客房的连锁酒店集团搭建网站。
- 候选人:客户是在预订时付款,还是到店时付款?
- 面试官:预订时全额付款。
- 候选人:客户只通过网站预订客房吗?是否需要支持电话等其他预订方式?
- 面试官:只通过网站或 App 预订。
- 候选人:客户可以取消预订吗?
- 面试官:可以。
- 候选人:还有其他需要考虑的吗?
- 面试官:有,我们允许 10% 的超额预订(Overbooking)。酒店会卖出比实际数量更多的房间。酒店这样做,是预计会有客户取消预订。
- 候选人:由于时间有限,我们将重点关注:展示酒店相关页面、客房详情页、预订房间、管理后台、支持超额预订。
- 面试官:听起来不错。
- 面试官:还有一点:酒店价格一直在变。假设酒店客房的价格每天都会变化。
- 候选人:好的。
非功能性需求
- 支持高并发:旺季时可能有大量客户试图预订同一家酒店。
- 适中的延迟:用户预订时最好能做到低延迟,但系统花几秒钟处理也是可以接受的。
粗略估算
- 共 5000 家酒店、100 万间客房
- 假设 70% 的客房有人入住,平均入住时长为 3 天
- 估算每日预订量:100 万 * 0.7 / 3 = 约 24 万次预订/天
- 每秒预订量:24 万 / 一天约 10^5 秒 = 约 3。平均预订 TPS 很低。
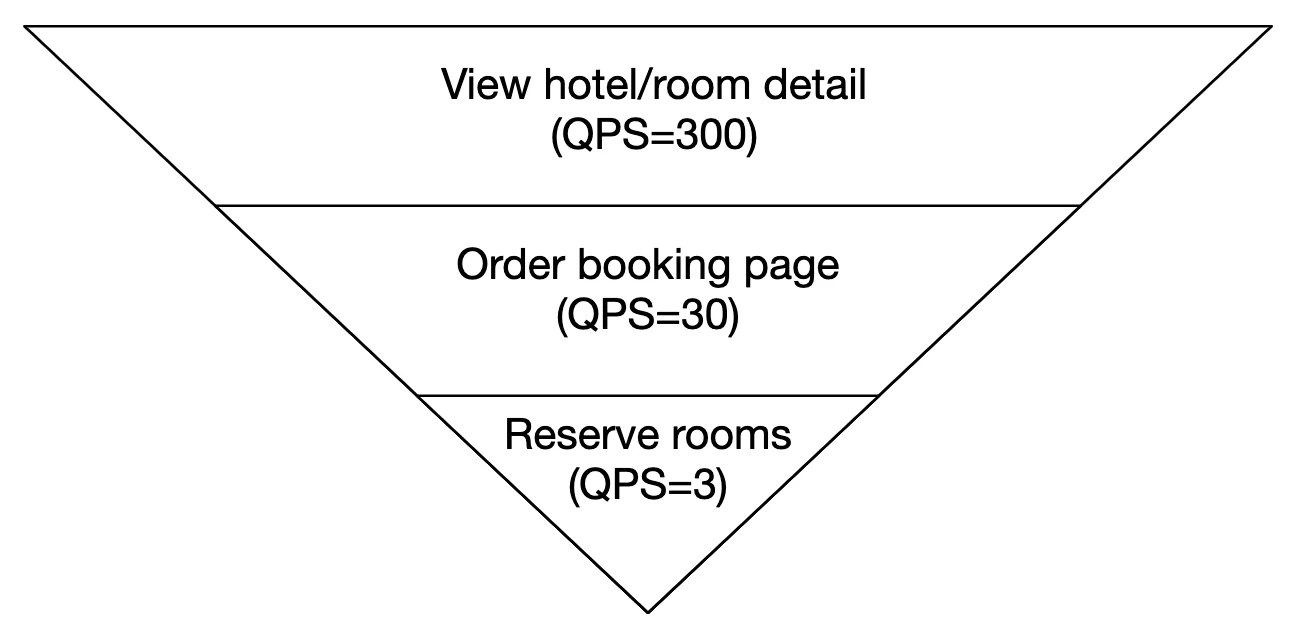
我们来估算一下 QPS。假设到达预订页面需要经过三个步骤,并且每个页面的转化率为 10%, 那么可以估算出:如果有 3 次预订,就必须有 30 次预订页面浏览和 300 次客房详情页浏览。
第 2 步:提出高层设计并获得认可
我们将探讨:API 设计、数据模型、高层设计。
API 设计
这里的 API 设计聚焦于支撑酒店预订系统所需的核心端点(遵循 RESTful 实践)。
一个功能完整的系统需要更全面的 API,例如支持按各种条件搜索房间,但本节不会关注这些。 原因是它们在技术上没有什么挑战,因此不在讨论范围内。
酒店相关 API
GET /v1/hotels/{id}:获取某家酒店的详细信息POST /v1/hotels:新增一家酒店。仅对运营人员开放PUT /v1/hotels/{id}:更新酒店信息。仅对运营人员开放DELETE /v1/hotels/{id}:删除一家酒店。该 API 仅对运营人员开放
客房相关 API
GET /v1/hotels/{id}/rooms/{id}:获取某间客房的详细信息POST /v1/hotels/{id}/rooms:新增一间客房。仅对运营人员开放PUT /v1/hotels/{id}/rooms/{id}:更新客房信息。仅对运营人员开放DELETE /v1/hotels/{id}/rooms/{id}:删除一间客房。仅对运营人员开放
预订相关 API
GET /v1/reservations:获取当前用户的预订历史GET /v1/reservations/{id}:获取某个预订的详细信息POST /v1/reservations:创建一个新预订DELETE /v1/reservations/{id}:取消一个预订
下面是一个创建预订的请求示例:
{
  "startDate":"2021-04-28",
  "endDate":"2021-04-30",
  "hotelID":"245",
  "roomID":"U12354673389",
  "reservationID":"13422445"
}
注意,reservationID 是用来避免重复预订(Double Booking)的幂等键(Idempotency Key)。详见并发问题一节。
数据模型
在选择使用哪种数据库之前,我们先考虑一下访问模式。
我们需要支持以下查询:
- 查看某家酒店的详细信息
- 给定日期范围,查找可用的房型
- 记录一个预订
- 查询某个预订或过往的预订历史
根据估算,我们知道系统的规模并不大,但需要为流量激增做好准备。
基于这些认识,我们选择关系型数据库,原因如下:
- 关系型数据库很适合读多写少的系统。
- NoSQL 数据库通常针对写入做了优化,但我们知道写入不会很多,因为访问网站的用户中只有一小部分会下单预订。
- 关系型数据库提供 ACID 保证。这对此类系统很重要,没有它,我们就无法防止余额为负、重复扣款等问题。
- 数据结构非常清晰,关系型数据库可以轻松地对其建模。
下面是我们的表结构设计:
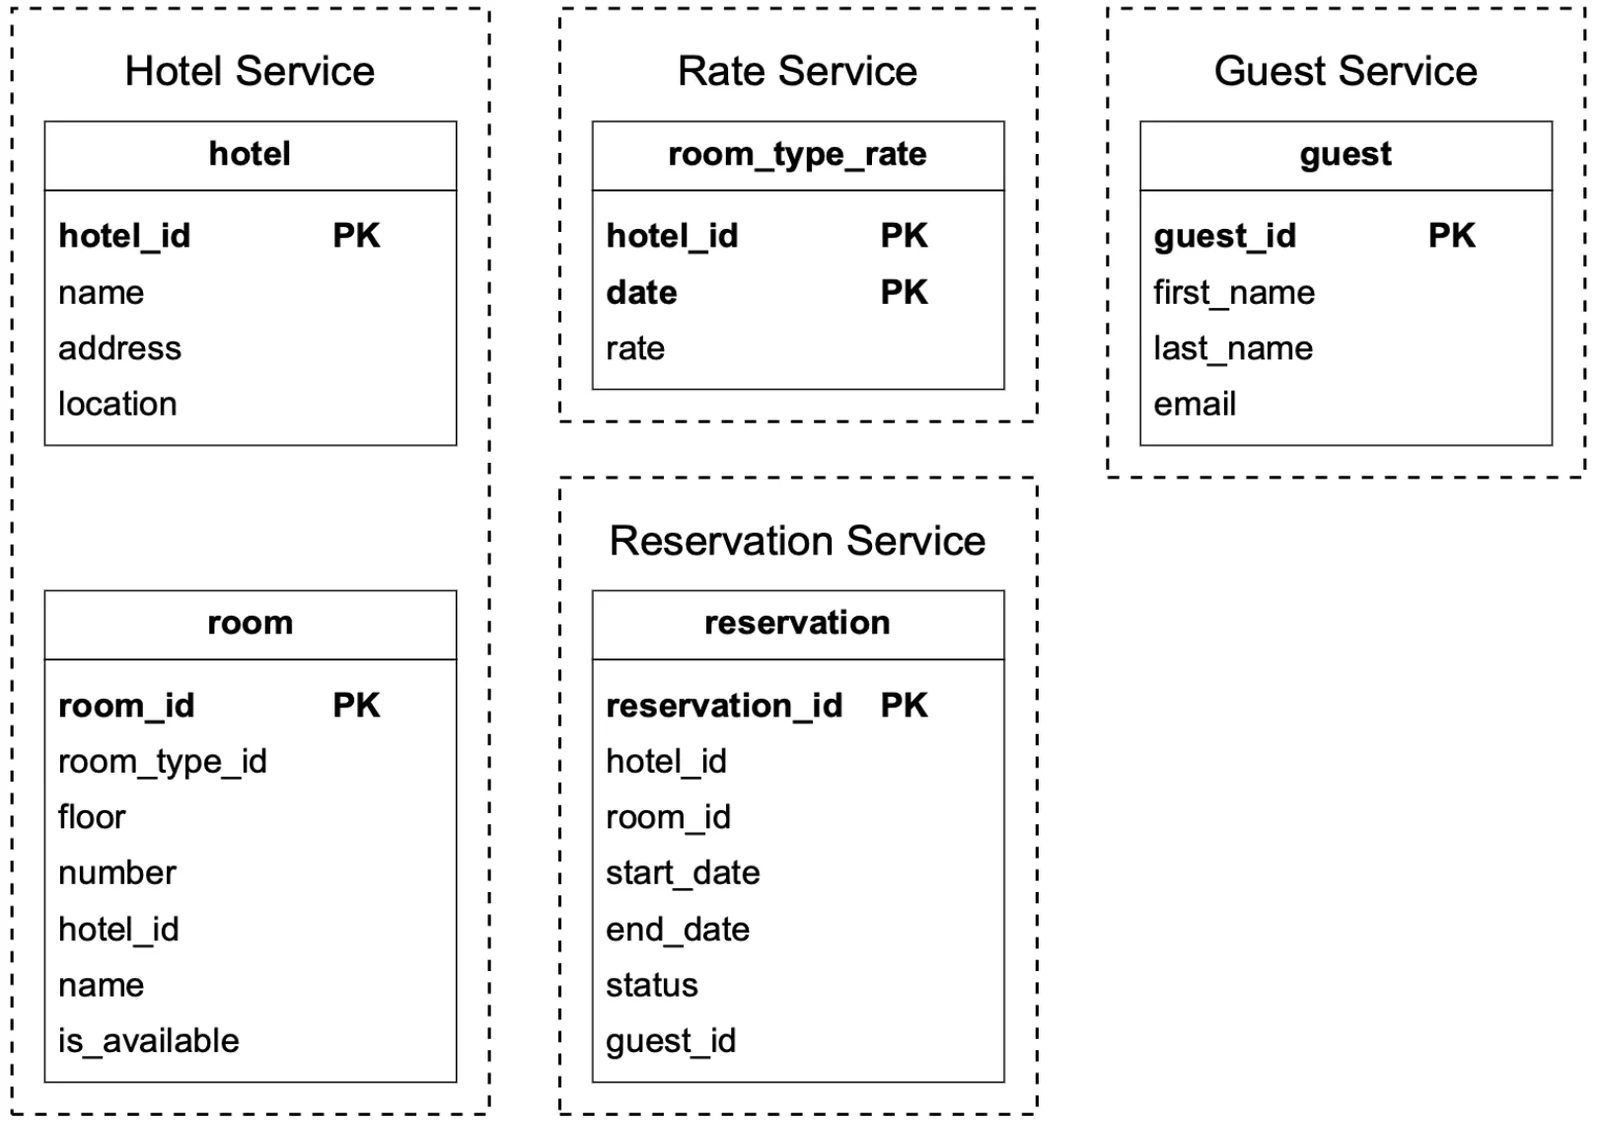
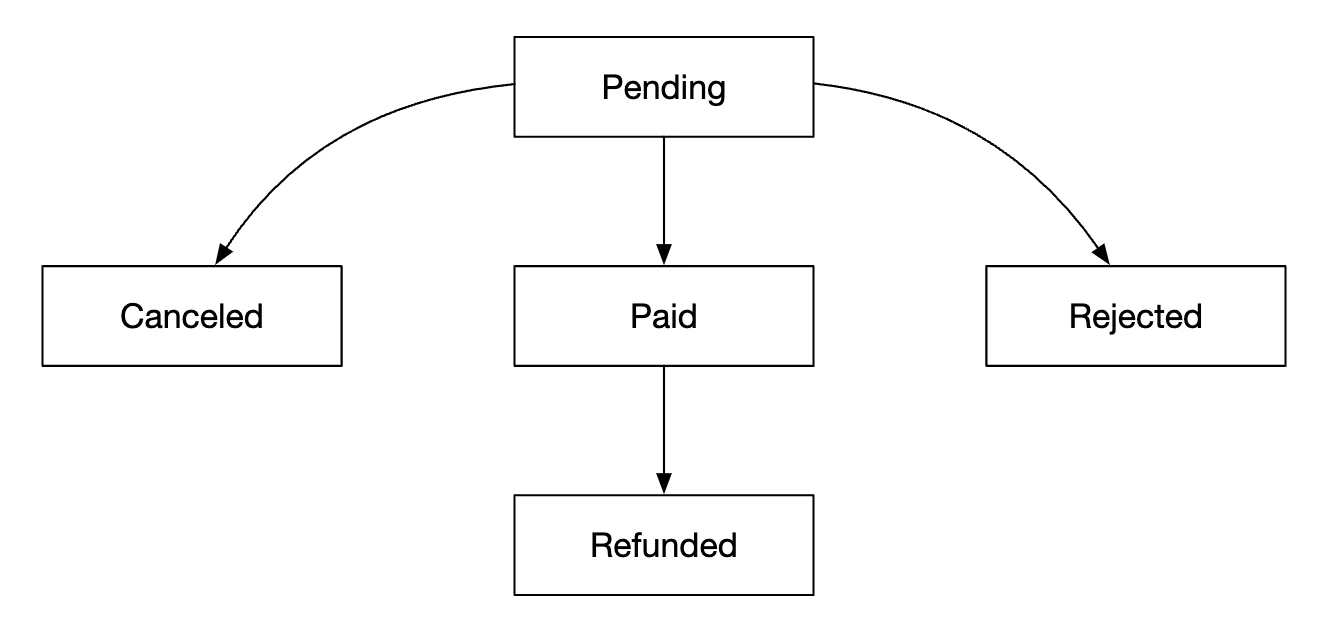
大部分字段一看便知含义。唯一值得一提的是 status 字段,它表示某间客房的状态机:
这个数据模型很适合 Airbnb 这样的系统,但不适合酒店,因为酒店用户预订的不是某间特定的房间,而是某种房型。 他们预订的是一种房型,房间号则在预订时才分配。
这个不足将在改进的数据模型一节中解决。
高层设计
本设计选择了微服务架构,它近年来非常流行:
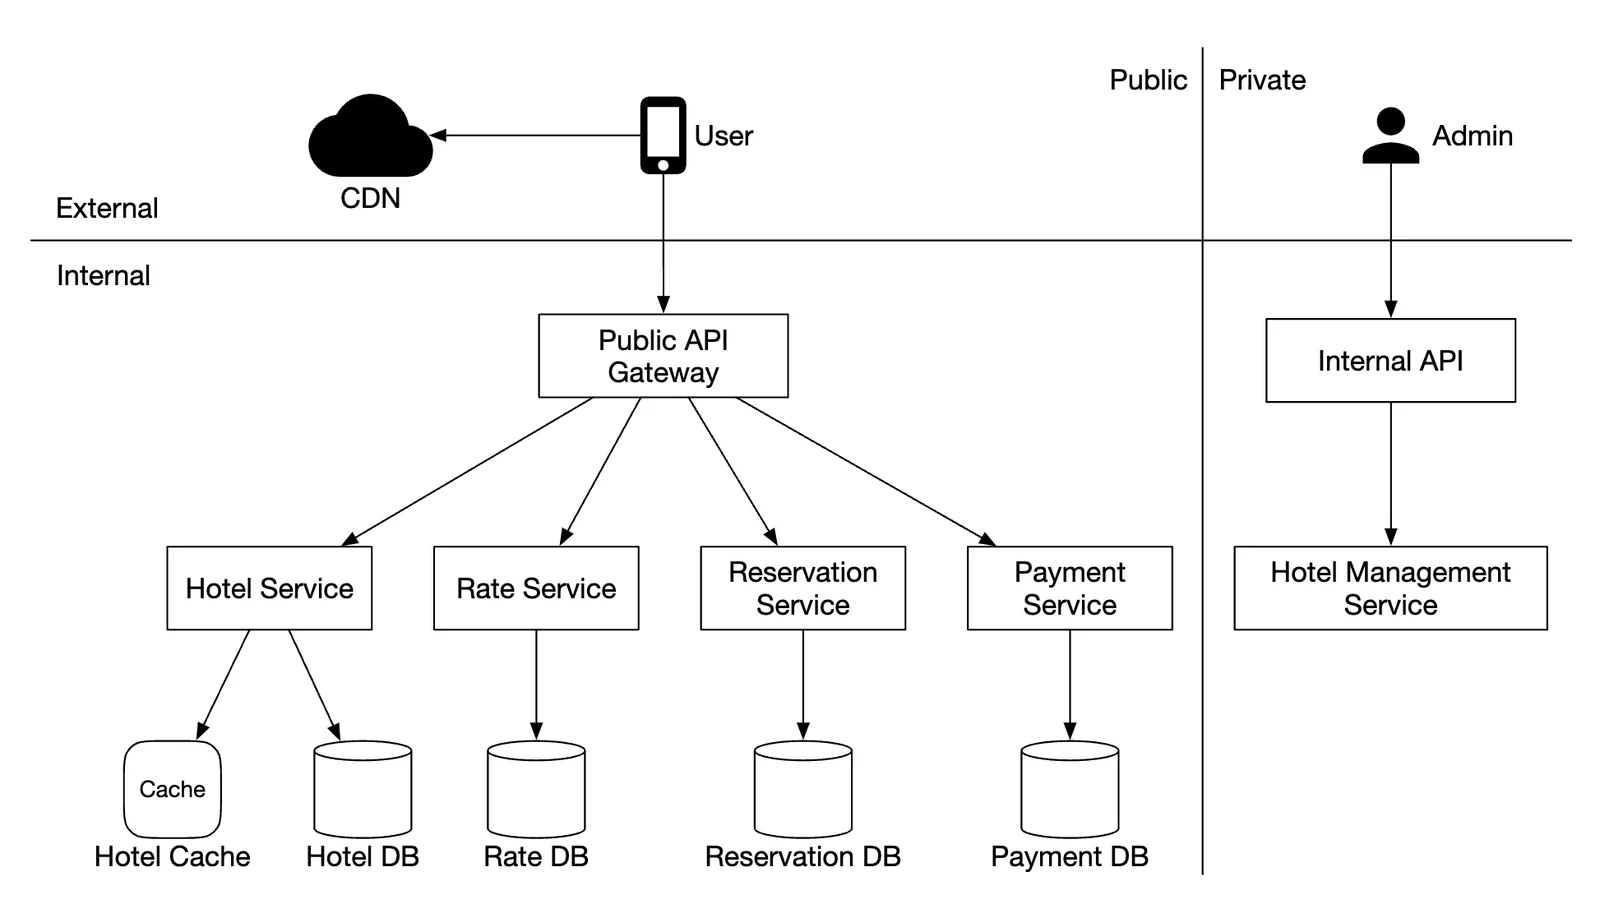
- 用户:在手机或电脑上预订酒店客房
- 管理员:执行退款、取消付款等管理操作
- CDN:缓存 JS 包、图片、视频等静态资源
- 公共 API 网关:全托管服务,支持限流、身份认证等功能。
- 内部 API:仅对授权人员可见,通常由 VPN 保护。
- 酒店服务:提供酒店和客房的详细信息。酒店和客房数据是静态的,因此可以大量缓存。
- 房价服务:提供未来不同日期的客房价格。这个领域有个有意思的地方:价格取决于酒店在某一天的入住率。
- 预订服务:接收预订请求并预留酒店客房。同时在预订创建或取消时跟踪客房库存。
- 支付服务:处理付款,并在付款成功后更新预订状态。
- 酒店管理服务:仅对授权人员开放。提供某些管理功能,用于管理和查看预订、酒店等。
服务间通信可以借助 RPC 框架实现,例如 gRPC。
第 3 步:设计深入探讨
我们将深入探讨:
- 改进的数据模型
- 并发问题
- 可扩展性
- 解决微服务中的数据不一致问题
改进的数据模型
如前文所述,我们需要修改 API 和表结构,以支持预订某种房型,而不是某间特定的房间。
对于预订 API,我们不再预订某个 roomID,而是预订某个 roomTypeID:
POST /v1/reservations
{
  "startDate":"2021-04-28",
  "endDate":"2021-04-30",
  "hotelID":"245",
  "roomTypeID":"12354673389",
  "roomCount":"3",
  "reservationID":"13422445"
}
下面是更新后的表结构:
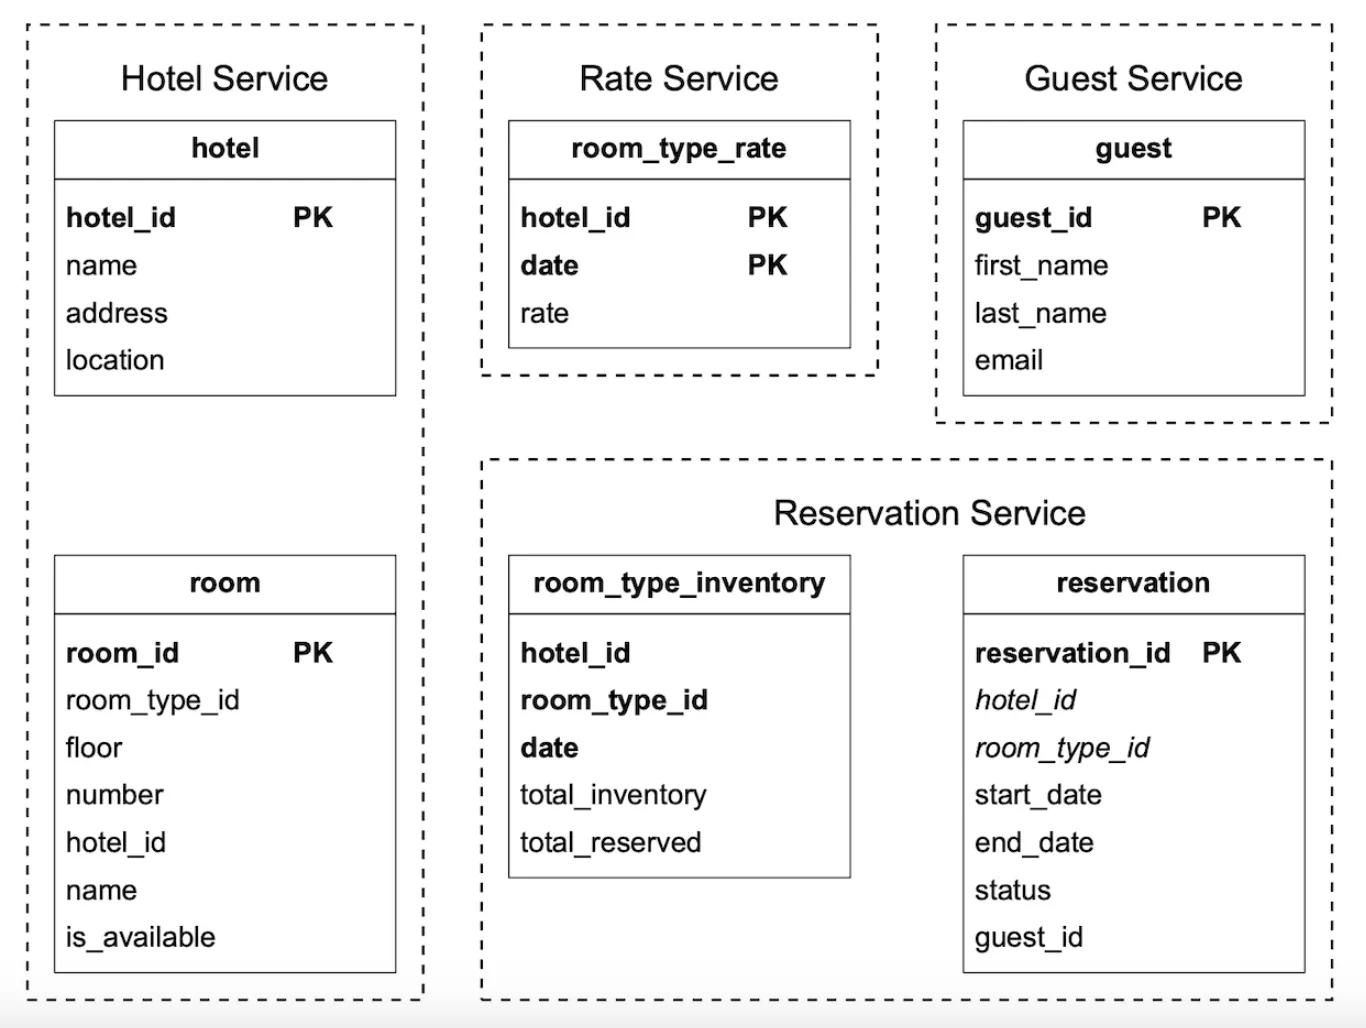
- room:包含客房的信息
- room_type_rate:包含某种房型的价格信息
- reservation:记录客人的预订数据
- room_type_inventory:存储酒店客房的库存数据。
我们来看看 room_type_inventory 表的各列,因为这张表更有意思:
- hotel_id:酒店 ID
- room_type_id:房型 ID
- date:单个日期
- total_inventory:客房总数减去暂时下架的房间数。
- total_reserved:给定 (hotel_id, room_type_id, date) 下已预订的客房总数
这张表还有其他设计方式,但每个 (hotel_id, room_type_id, date) 对应一行,可以让预订管理更简单、 查询也更容易。
表中的行由每日运行的 CRON 任务预先填充。
示例数据: | hotel_id | room_type_id | date | total_inventory | total_reserved | |----------|--------------|------------|-----------------|----------------| | 211 | 1001 | 2021-06-01 | 100 | 80 | | 211 | 1001 | 2021-06-02 | 100 | 82 | | 211 | 1001 | 2021-06-03 | 100 | 86 | | 211 | 1001 | ... | ... | | | 211 | 1001 | 2023-05-31 | 100 | 0 | | 211 | 1002 | 2021-06-01 | 200 | 16 | | 2210 | 101 | 2021-06-01 | 30 | 23 | | 2210 | 101 | 2021-06-02 | 30 | 25 |
检查某种房型可用性的 SQL 查询示例:
SELECT date, total_inventory, total_reserved
FROM room_type_inventory
WHERE room_type_id = ${roomTypeId} AND hotel_id = ${hotelId}
AND date between ${startDate} and ${endDate}
如何利用这些数据检查指定数量的房间是否可订(注意我们支持超额预订):
if (total_reserved + ${numberOfRoomsToReserve}) <= 110% * total_inventory
现在来估算一下存储量。
- 我们有 5000 家酒店。
- 每家酒店有 20 种房型。
- 5000 * 20 * 2(年)* 365(天)= 7300 万行
7300 万行数据并不多,单台数据库服务器就能处理。 不过,设置读副本(可以跨不同可用区)来实现高可用是合理的。
追问:如果预订数据量大到单个数据库放不下,你会怎么做?
- 只存储当前和未来的预订数据。历史预订可以迁移到冷存储。
- 数据库分片(Sharding):由于我们的查询总是会带上
hotel_id,可以按hash(hotel_id) % servers_cnt对数据分片。
并发问题
另一个需要解决的重要问题是重复预订。
有两个问题需要处理:
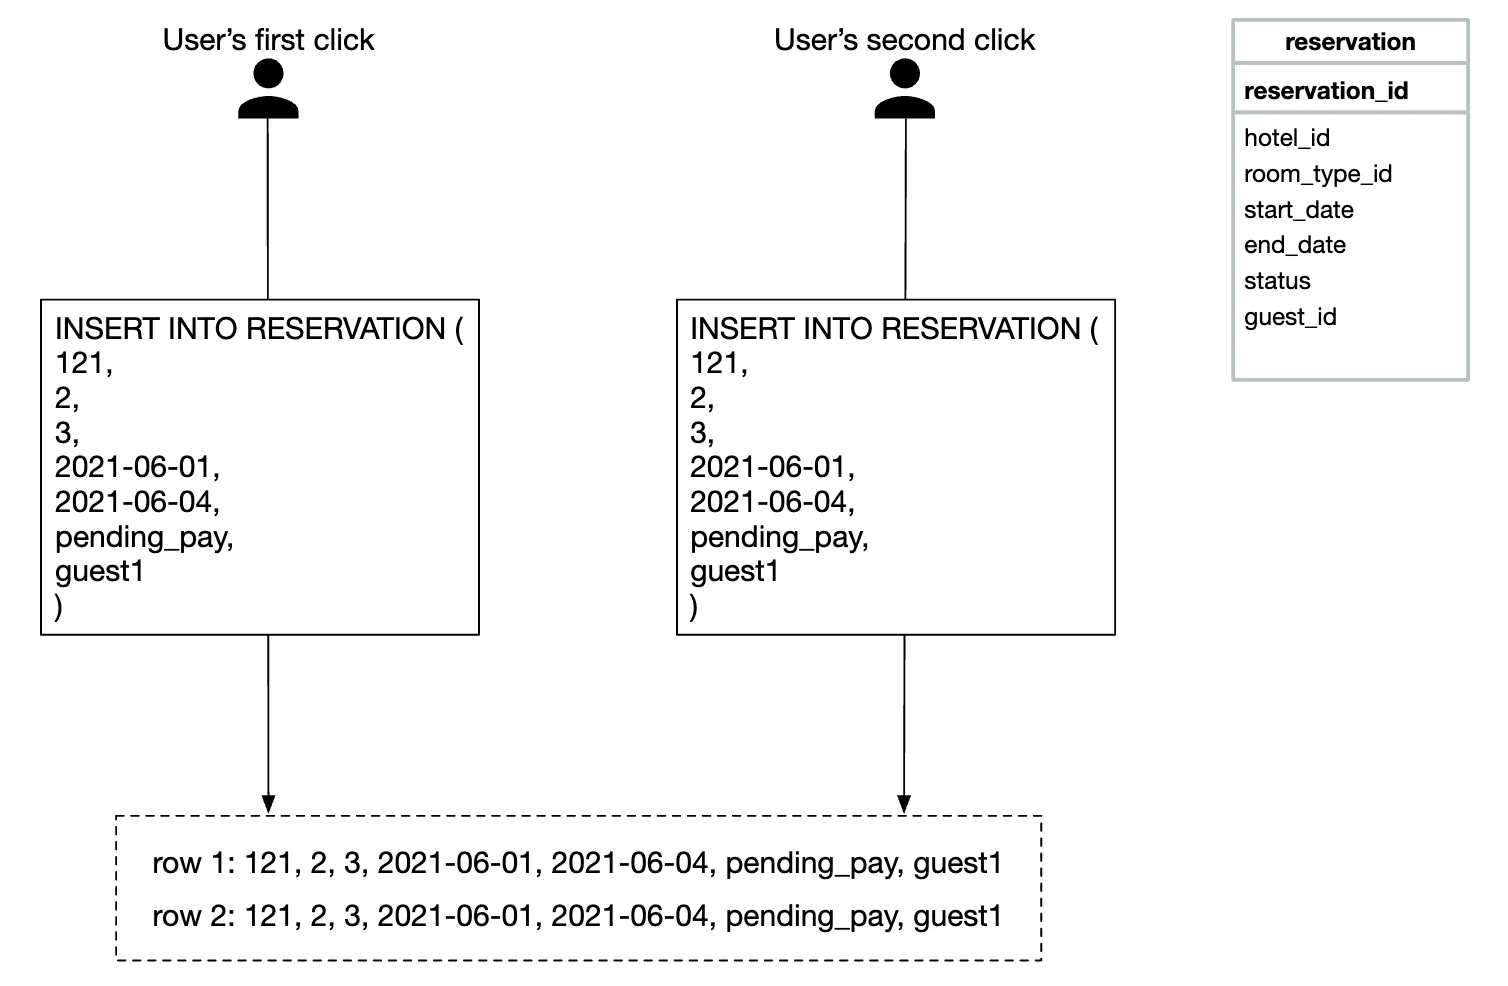
- 同一用户点击了两次「预订」
- 多个用户同时尝试预订同一个房间
下面是第一个问题的示意图:
解决这个问题有两种方法:
- 客户端处理:前端可以在预订按钮被点击后将其禁用。但如果用户禁用了 JavaScript,就看不到按钮变灰。
- 幂等 API:在 API 中加入幂等键,使得无论端点被调用多少次,用户的某个操作都只会执行一次:
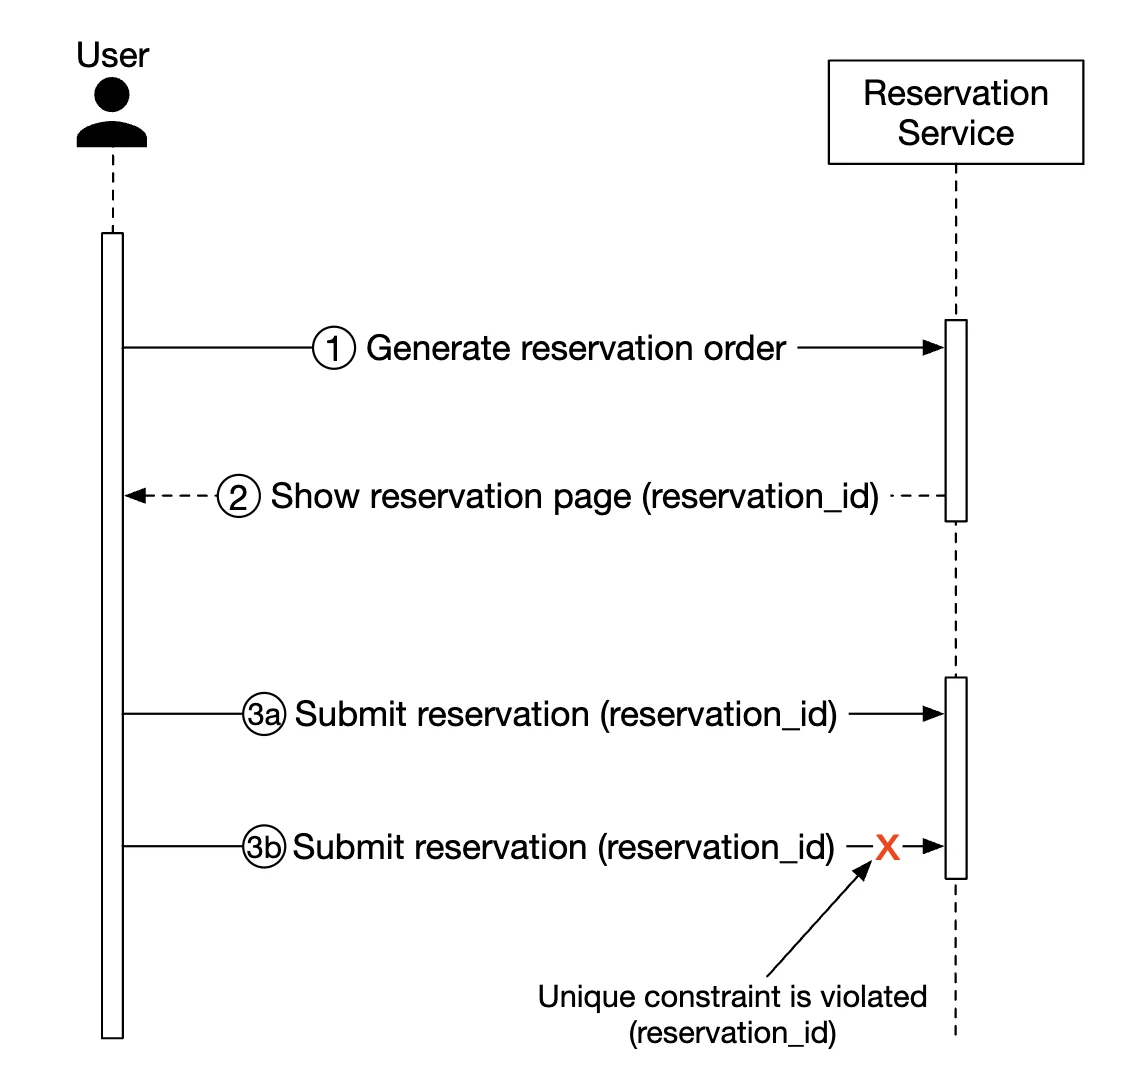
这个流程的工作方式如下:
- 当你填写信息、准备预订时,系统会生成一个预订单。预订单使用全局唯一标识符生成。
- 使用上一步生成的
reservation_id提交预订 1。 - 如果第二次点击「完成预订」,发送的仍是同一个
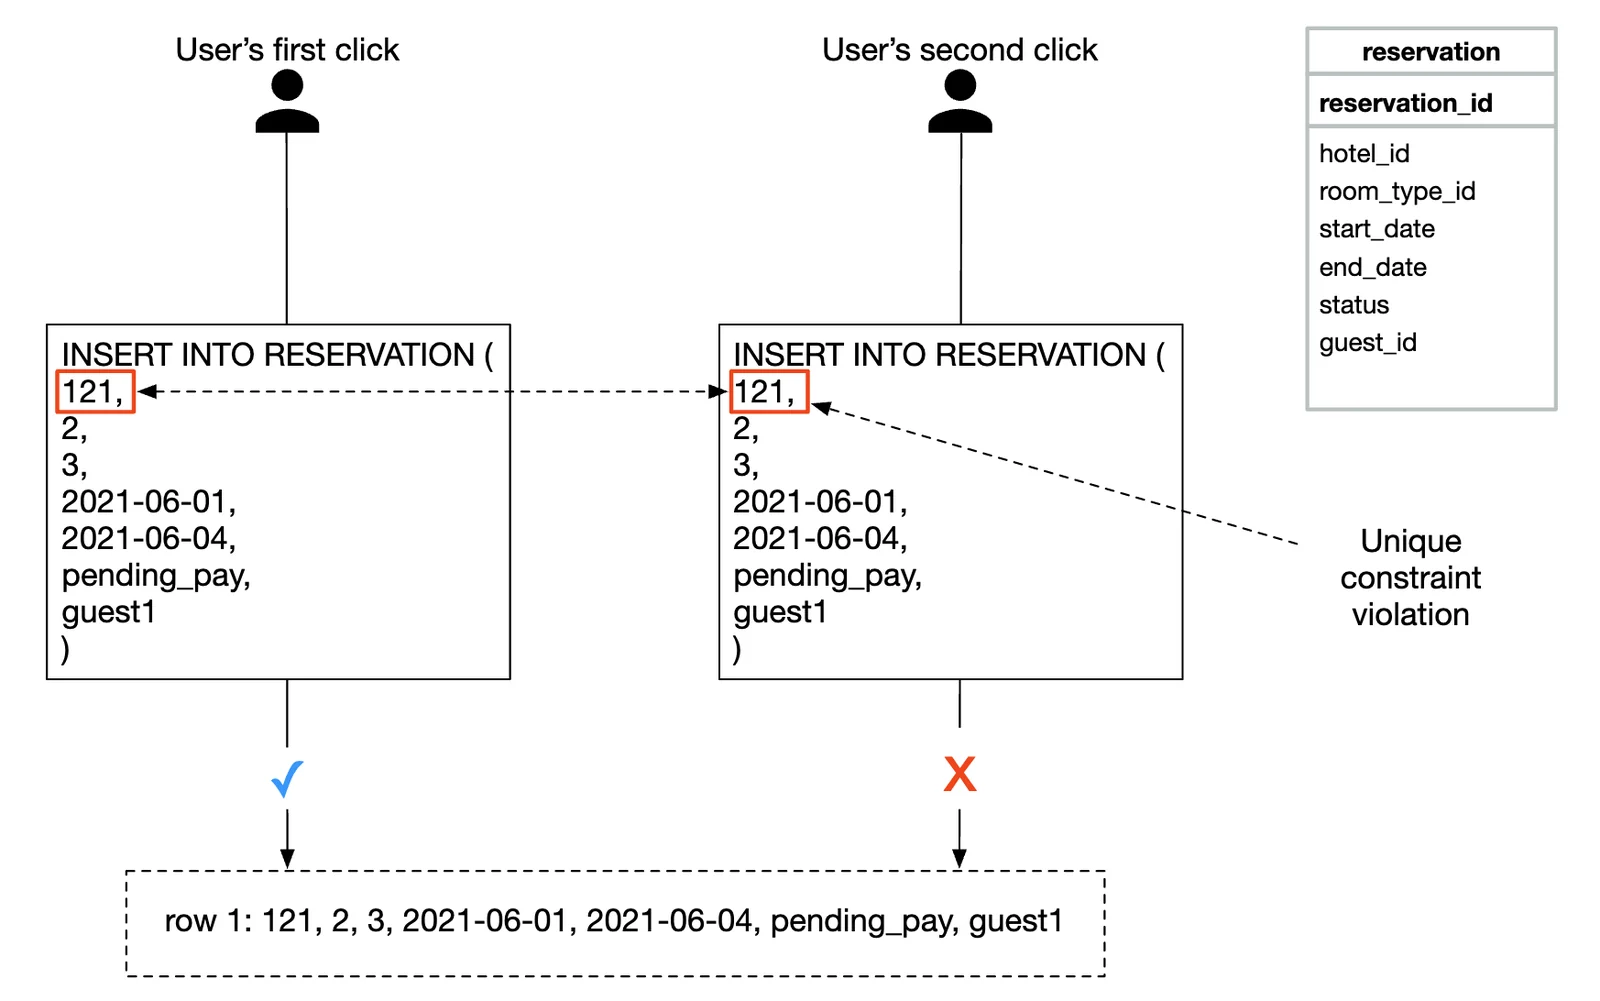
reservation_id,后端会检测出这是一个重复预订。 - 通过给
reservation_id列加上唯一约束来避免重复,防止数据库中存入多条具有相同 ID 的记录。
如果有多个用户同时发起相同的预订呢?
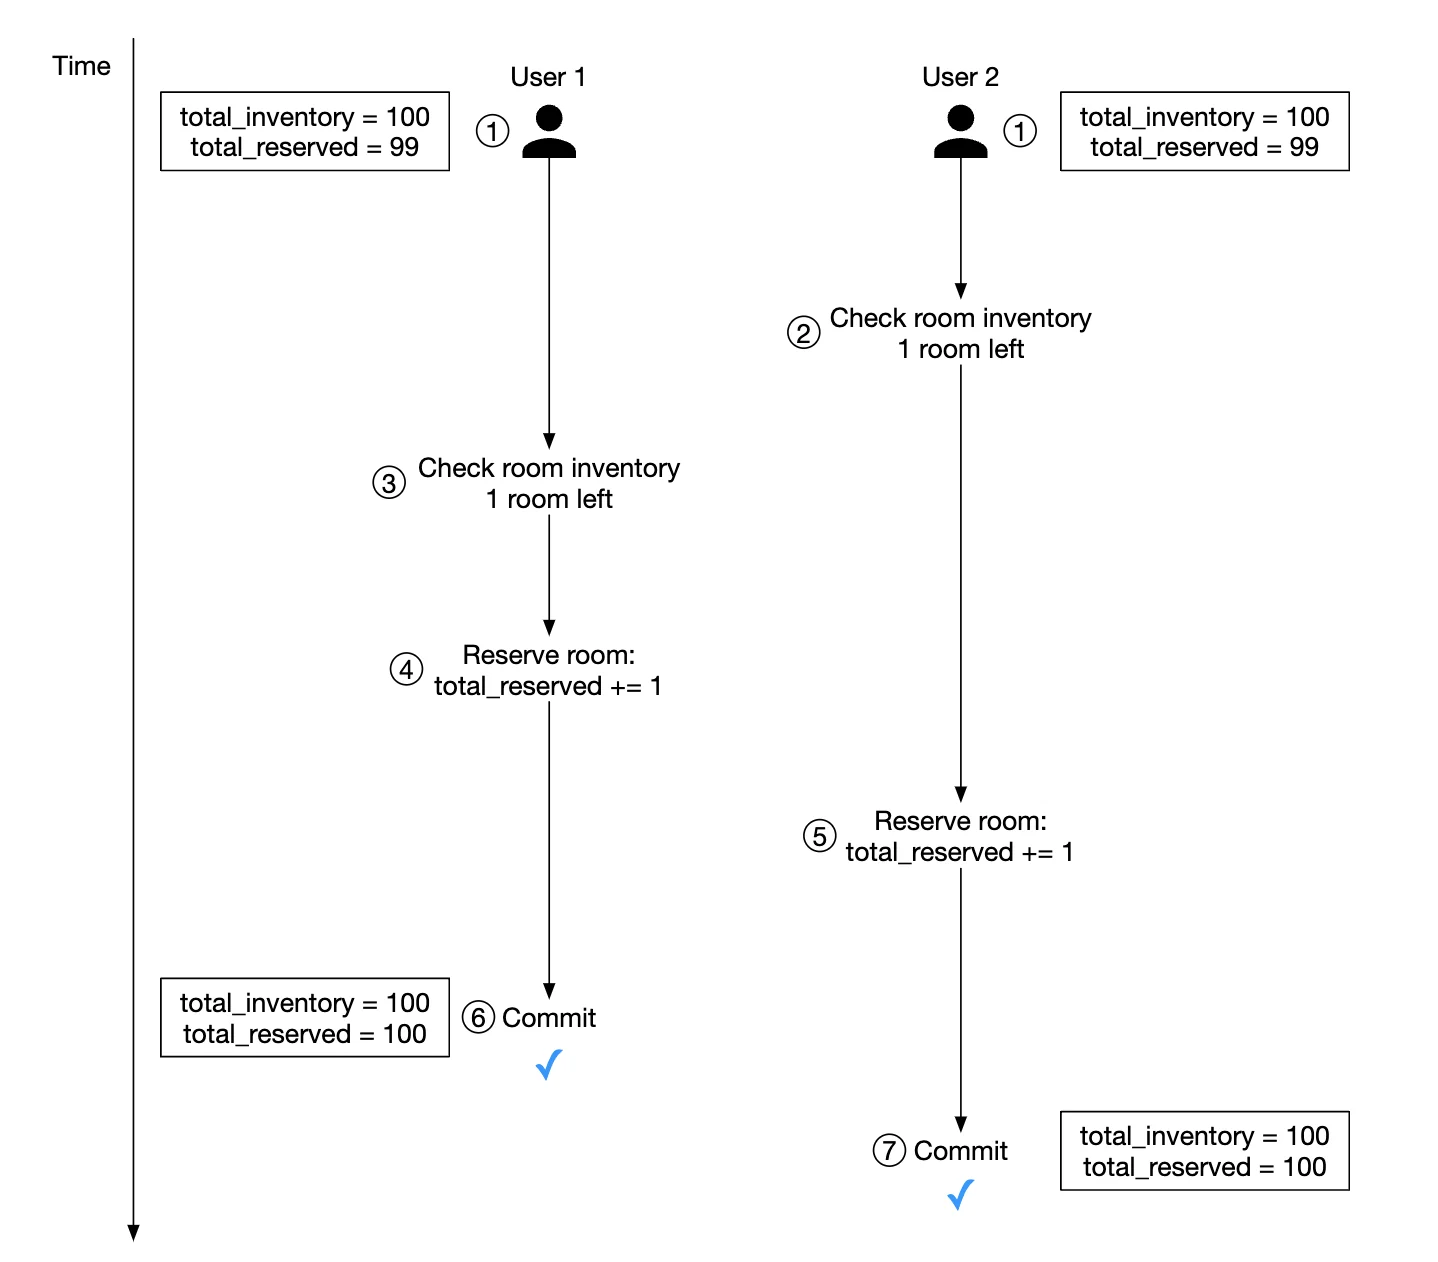
- 假设事务隔离级别不是可串行化(Serializable)
- 用户 1 和用户 2 同时尝试预订同一个房间。
- 事务 1 检查是否有足够的房间:有
- 事务 2 检查是否有足够的房间:有
- 事务 2 预订了房间并更新库存
- 事务 1 也预订了房间,因为它看到的仍是 100 间中已预订 99 间(
total_reserved)。 - 两个事务都成功提交了修改
这个问题可以用某种形式的锁机制来解决:
- 悲观锁(Pessimistic Locking)
- 乐观锁(Optimistic Locking)
- 数据库约束(Database Constraints)
下面是我们用来预订房间的 SQL:
# 第 1 步:检查客房库存
SELECT date, total_inventory, total_reserved
FROM room_type_inventory
WHERE room_type_id = ${roomTypeId} AND hotel_id = ${hotelId}
AND date between ${startDate} and ${endDate}

# 对第 1 步返回的每一条记录
if((total_reserved + ${numberOfRoomsToReserve}) > 110% * total_inventory) {
  Rollback
}

# 第 2 步:预订房间
UPDATE room_type_inventory
SET total_reserved = total_reserved + ${numberOfRoomsToReserve}
WHERE room_type_id = ${roomTypeId}
AND date between ${startDate} and ${endDate}

Commit
方案 1:悲观锁
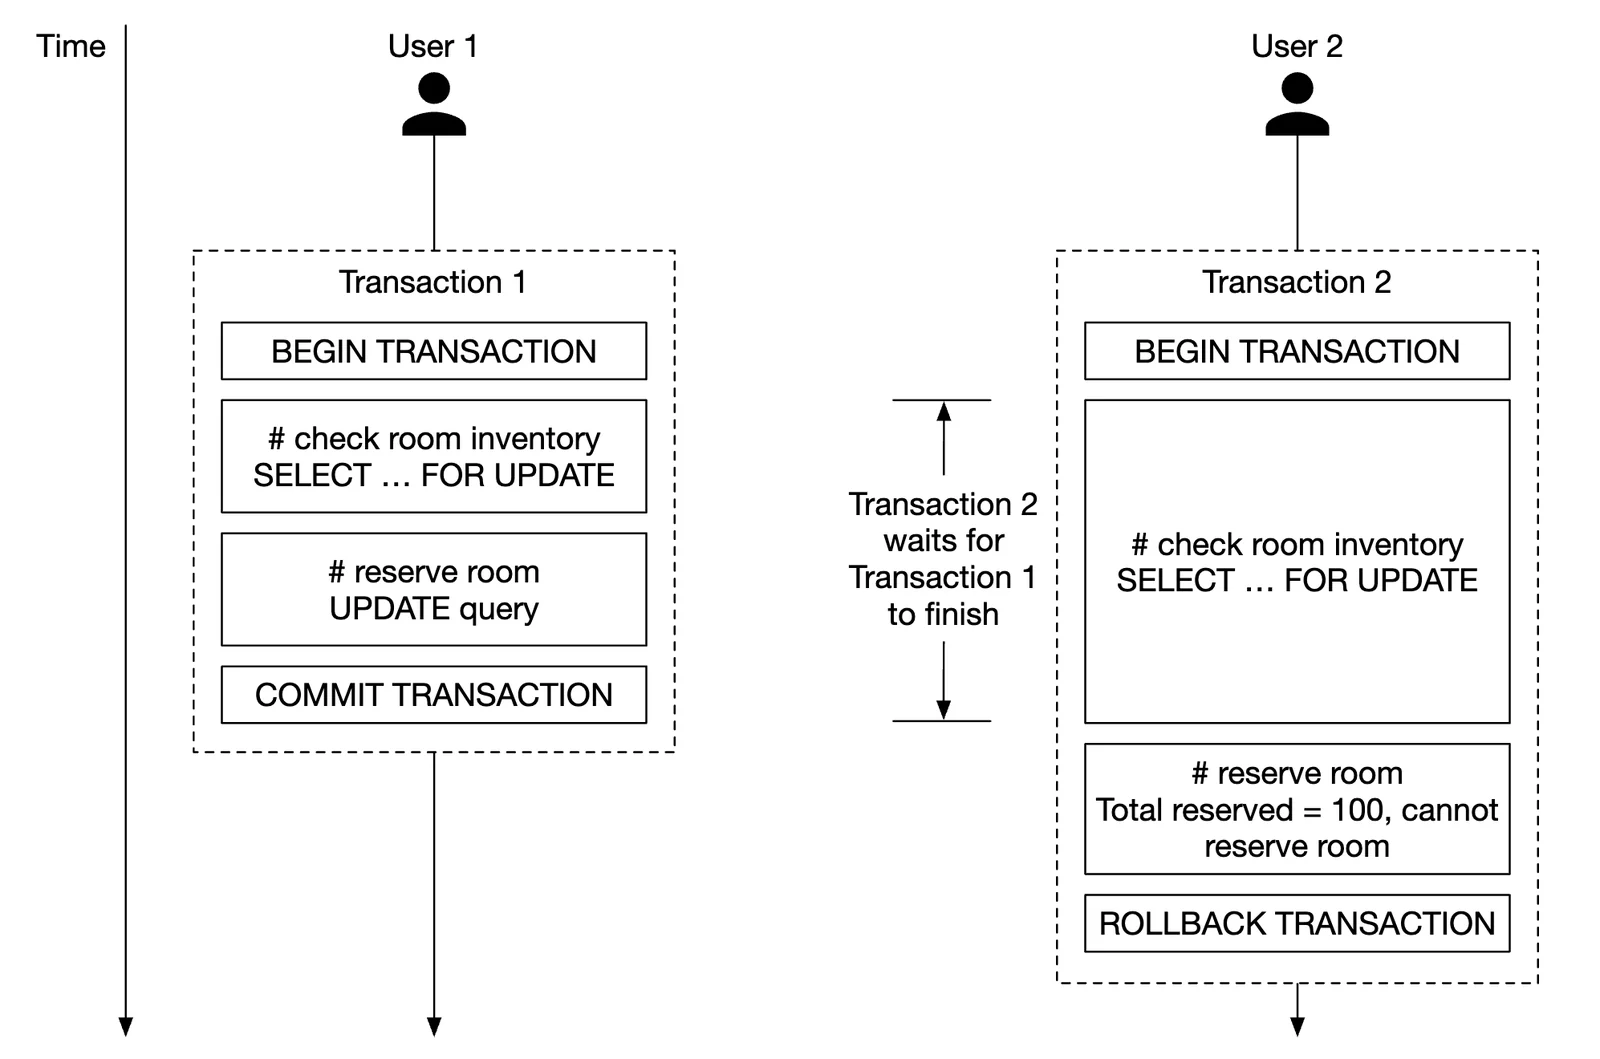
悲观锁在记录被更新时对其加锁,从而防止同时更新。
在 MySQL 中可以通过 SELECT... FOR UPDATE 查询实现,它会锁住查询选中的行,直到事务提交。
优点:
- 防止应用程序更新正在被修改的数据
- 易于实现,并通过串行化更新来避免冲突。在数据争用激烈时很有用。
缺点:
- 锁定多个资源时可能发生死锁。
- 这种方法不可扩展:如果事务持有锁的时间过长,会影响所有其他试图访问该资源的事务。
- 当查询选中大量资源且事务持续时间很长时,影响会很严重。
由于存在可扩展性问题,作者不推荐这种方法。
方案 2:乐观锁
乐观锁允许多个用户同时尝试更新同一条记录。
常见的实现方式有两种:版本号和时间戳。推荐使用版本号,因为服务器时钟可能不准确。
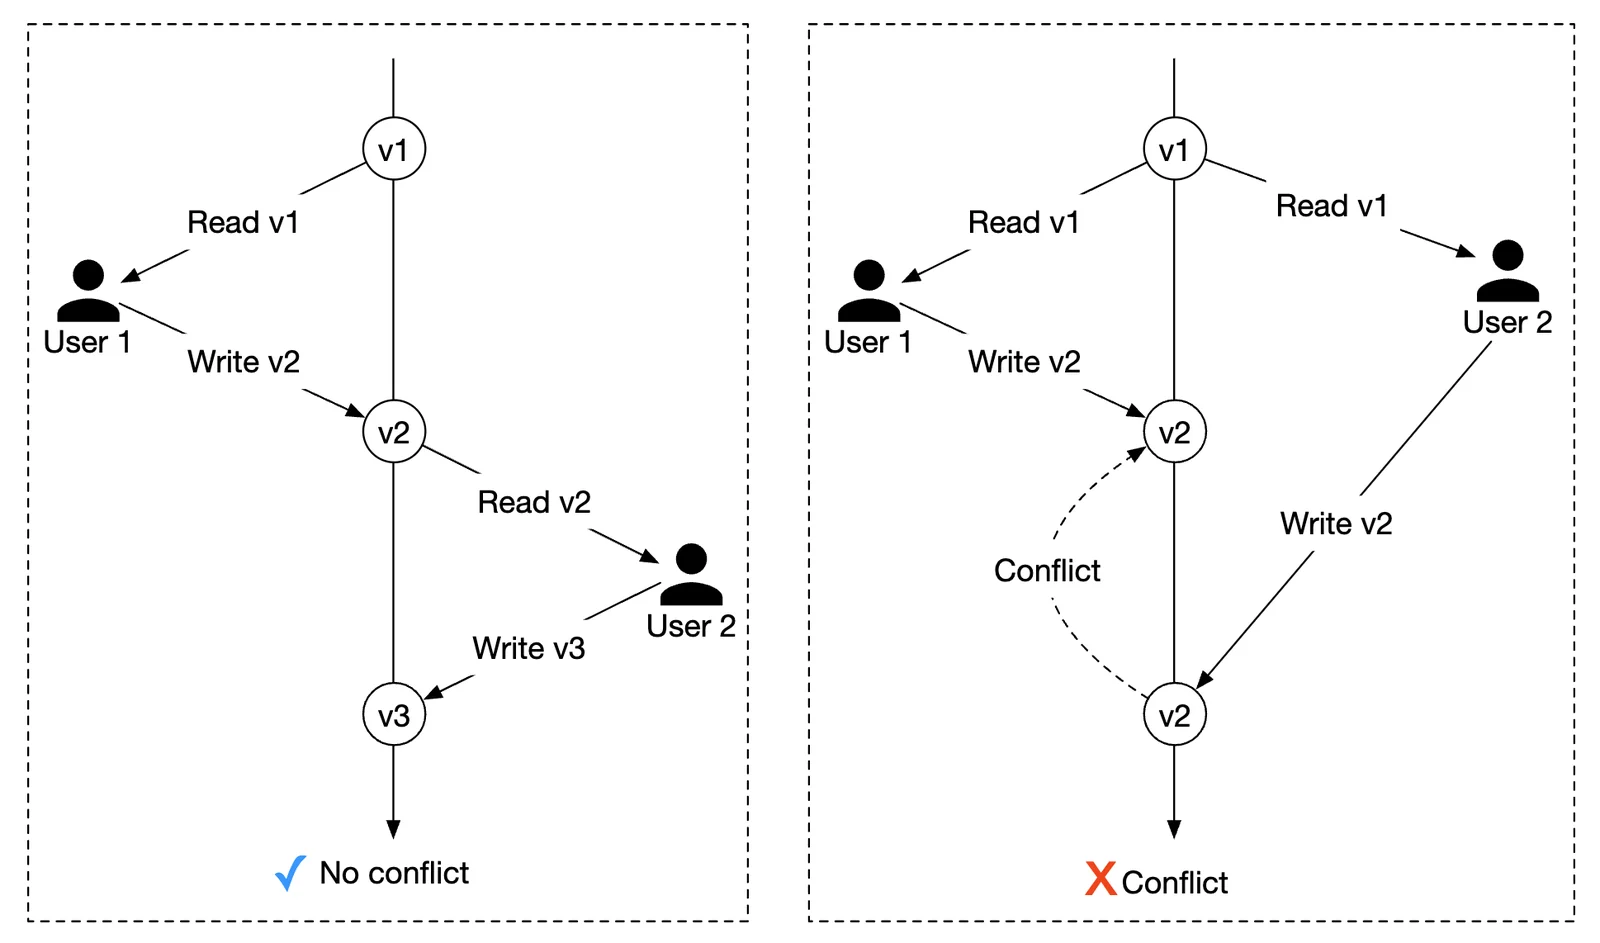
- 在数据库表中新增一个
version列 - 用户修改某个数据库行之前,先读取其版本号
- 用户更新该行时,将版本号加 1 并写回数据库
- 如果新版本号没有大于之前的版本号,数据库校验会阻止这次写入
乐观锁通常比悲观锁更快,因为我们没有锁住数据库。 但在并发很高时,它的性能往往会下降,因为这会导致大量回滚。
优点:
- 防止应用程序编辑过期的数据
- 不需要在数据库中获取锁
- 在数据争用较低(即很少发生更新冲突)时是首选方案
缺点:
- 数据争用激烈时性能较差
由于预订 QPS 并不是特别高,乐观锁对我们的系统来说是个不错的选择。
方案 3:数据库约束
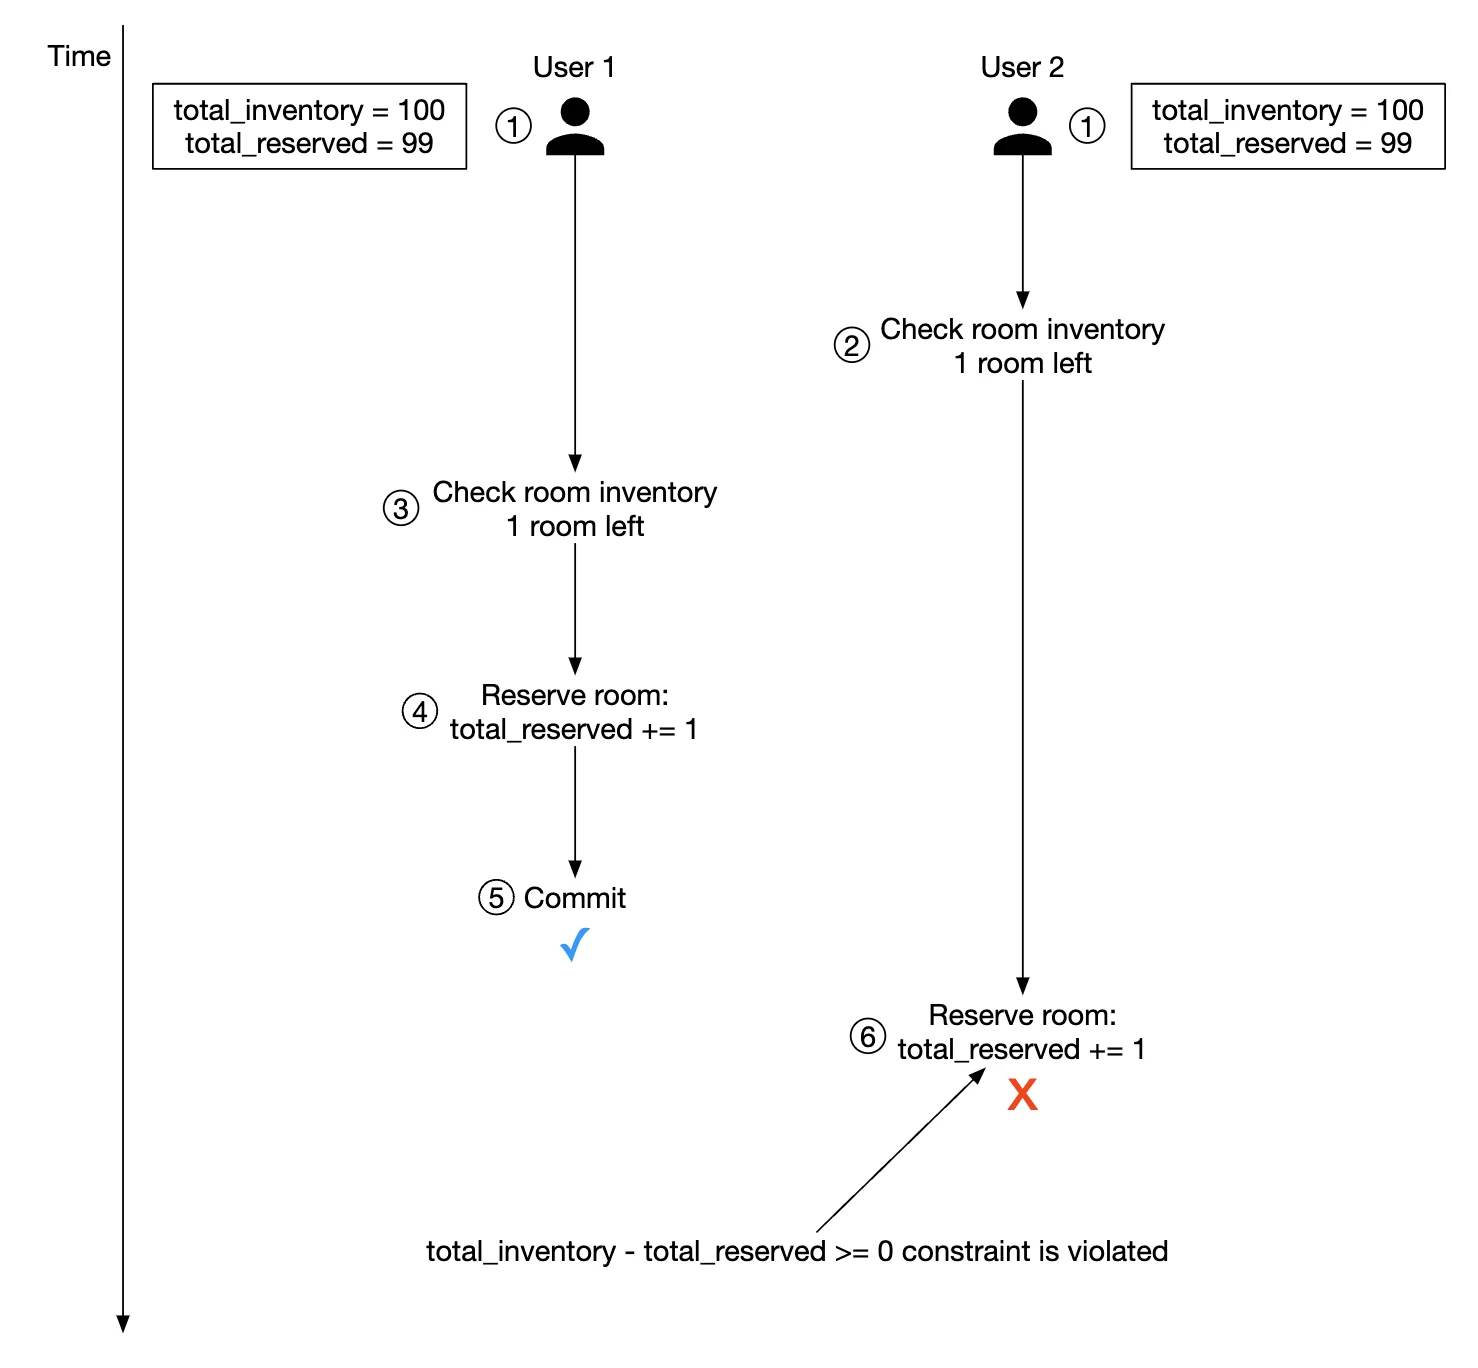
这种方法与乐观锁非常相似,只不过防护是通过数据库约束实现的:
CONSTRAINT `check_room_count` CHECK((`total_inventory - total_reserved` >= 0))
优点:
- 易于实现
- 数据争用较小时效果很好
缺点:
- 与乐观锁类似,数据争用激烈时性能较差
- 数据库约束不像应用代码那样容易做版本控制
- 并非所有数据库都支持约束
由于易于实现,这也是酒店预订系统的另一个好选择。
可扩展性
通常,酒店预订系统的负载并不高。
不过,面试官可能会问:如果系统被 booking.com 这样更大、更热门的旅游网站采用,你会如何应对? 在这种情况下,QPS 可能会高出 1000 倍。
遇到这种情况,关键是弄清楚瓶颈在哪里。所有服务都是无状态的,因此可以很容易地通过复制来扩展。
然而,数据库是有状态的,如何扩展它就没那么显而易见了。
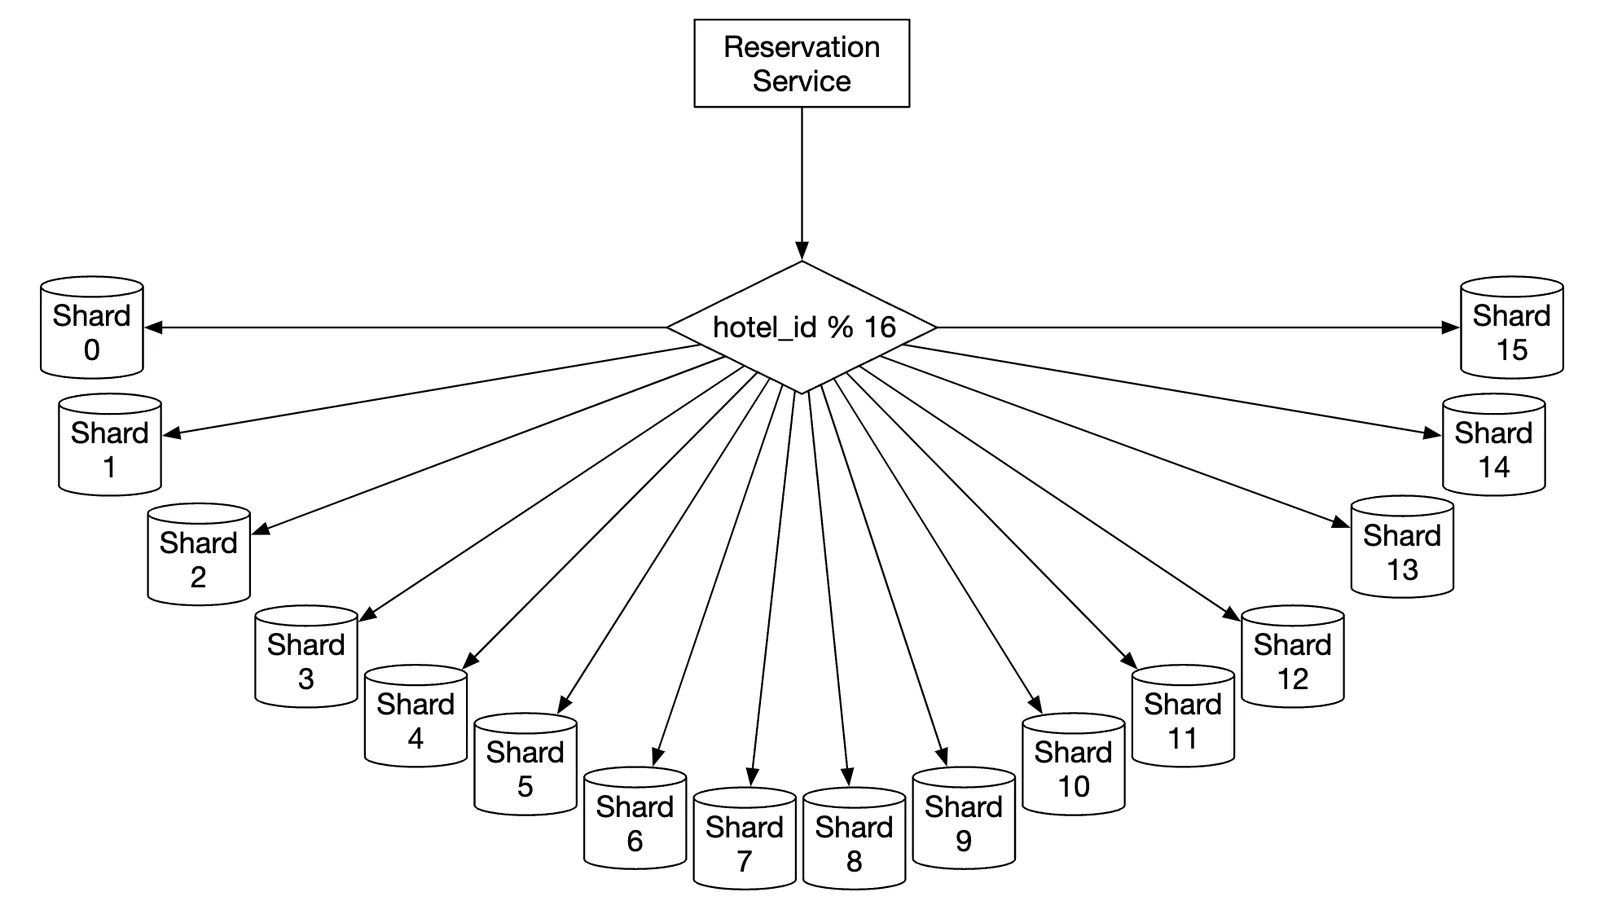
一种扩展方式是实施数据库分片:把数据拆分到多个数据库中,每个数据库存放一部分数据。
由于所有查询都会按 hotel_id 过滤,我们可以基于 hotel_id 分片。
假设 QPS 为 30,000,将数据库分成 16 个分片后,每个分片处理 1875 QPS,在单个 MySQL 集群的负载能力之内。
我们还可以借助 Redis 缓存客房库存和预订数据。可以设置 TTL,让已经过去的日期的旧数据自动过期。
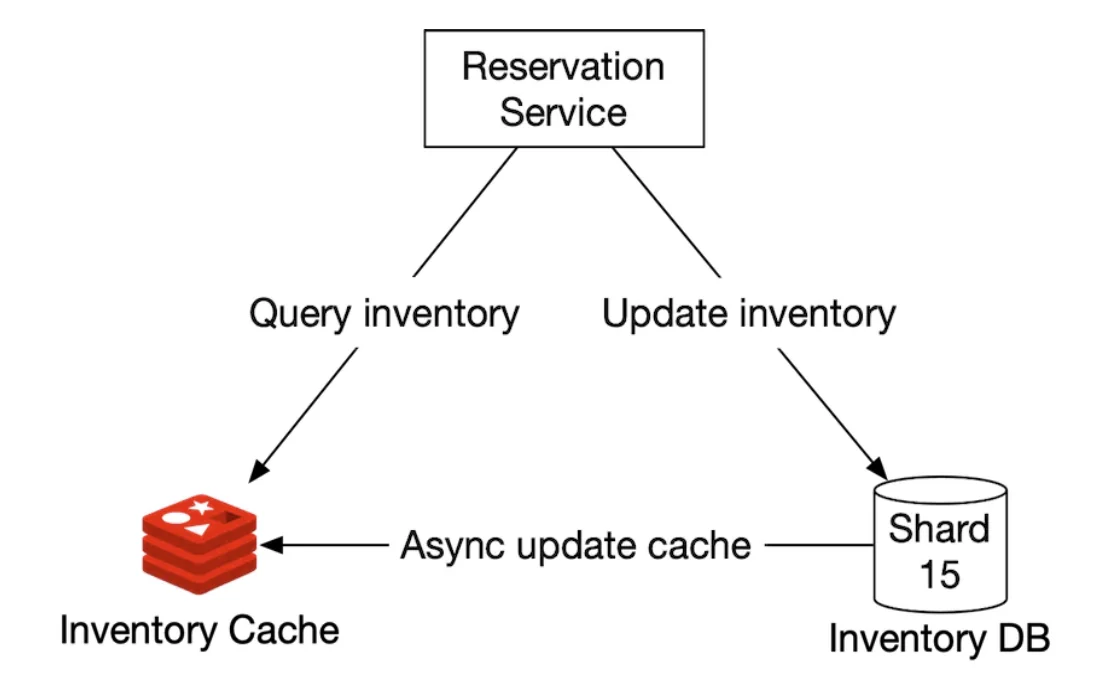
库存按 hotel_id、room_type_id 和 date 存储:
key: hotelID_roomTypeID_{date}
value: 给定酒店 ID、房型 ID 和日期下的可用房间数。
数据同步是异步进行的,由 CDC(变更数据捕获,Change Data Capture)流式机制管理:读取数据库的变更并应用到另一个系统。 Debezium 是将数据库变更同步到 Redis 的常用选择。
采用这种机制,缓存和数据库有可能在一段时间内不一致。 这在我们的场景下没有问题,因为数据库会阻止我们创建无效的预订。
这会在 UI 上造成一些问题:用户需要刷新页面才能看到「没有剩余房间了」, 但即使没有这个问题,这种情况也可能发生,例如某人在预订前犹豫了很久。
缓存的优点:
- 降低数据库负载
- 高性能,因为 Redis 在内存中管理数据
缓存的缺点:
- 维护缓存与数据库之间的数据一致性很难。我们需要考虑不一致会如何影响用户体验。
服务间的数据一致性
单体应用可以使用共享的关系型数据库来保证数据一致性。
在我们的微服务设计中,我们选择了一种混合方式:一些服务是独立的, 但预订 API 和库存 API 由同一个服务处理。
这样做是因为我们想利用关系型数据库的 ACID 保证来确保一致性。
然而,面试官可能会质疑这种做法,因为它不是纯粹的微服务架构(每个服务都有专属的数据库):
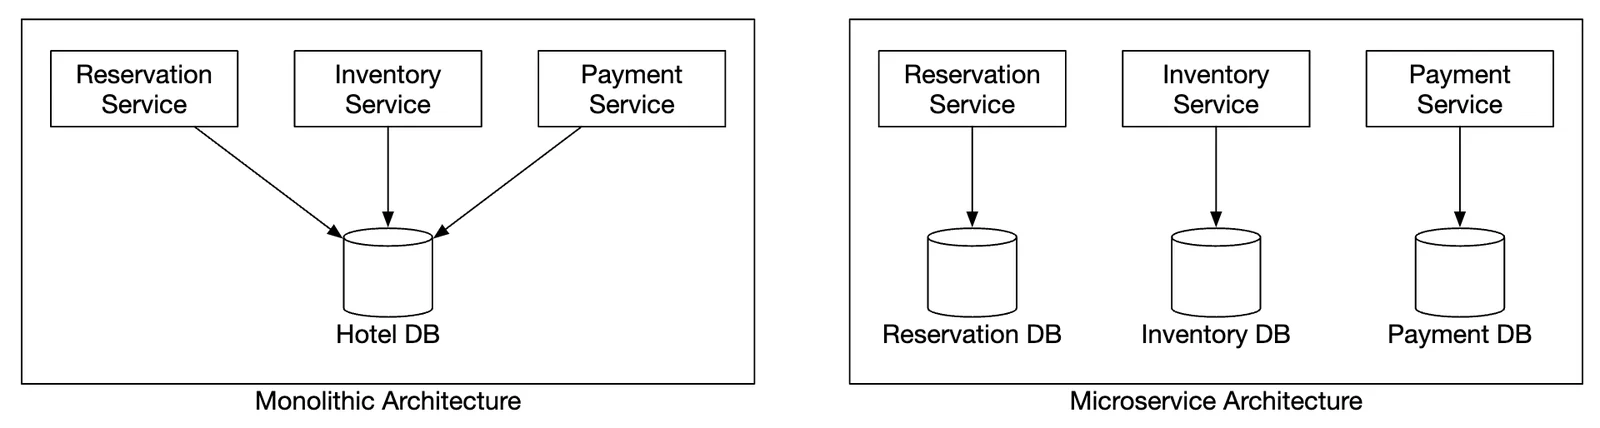
这可能导致一致性问题。在单体服务器中,我们可以利用关系型数据库的事务能力来实现原子操作:
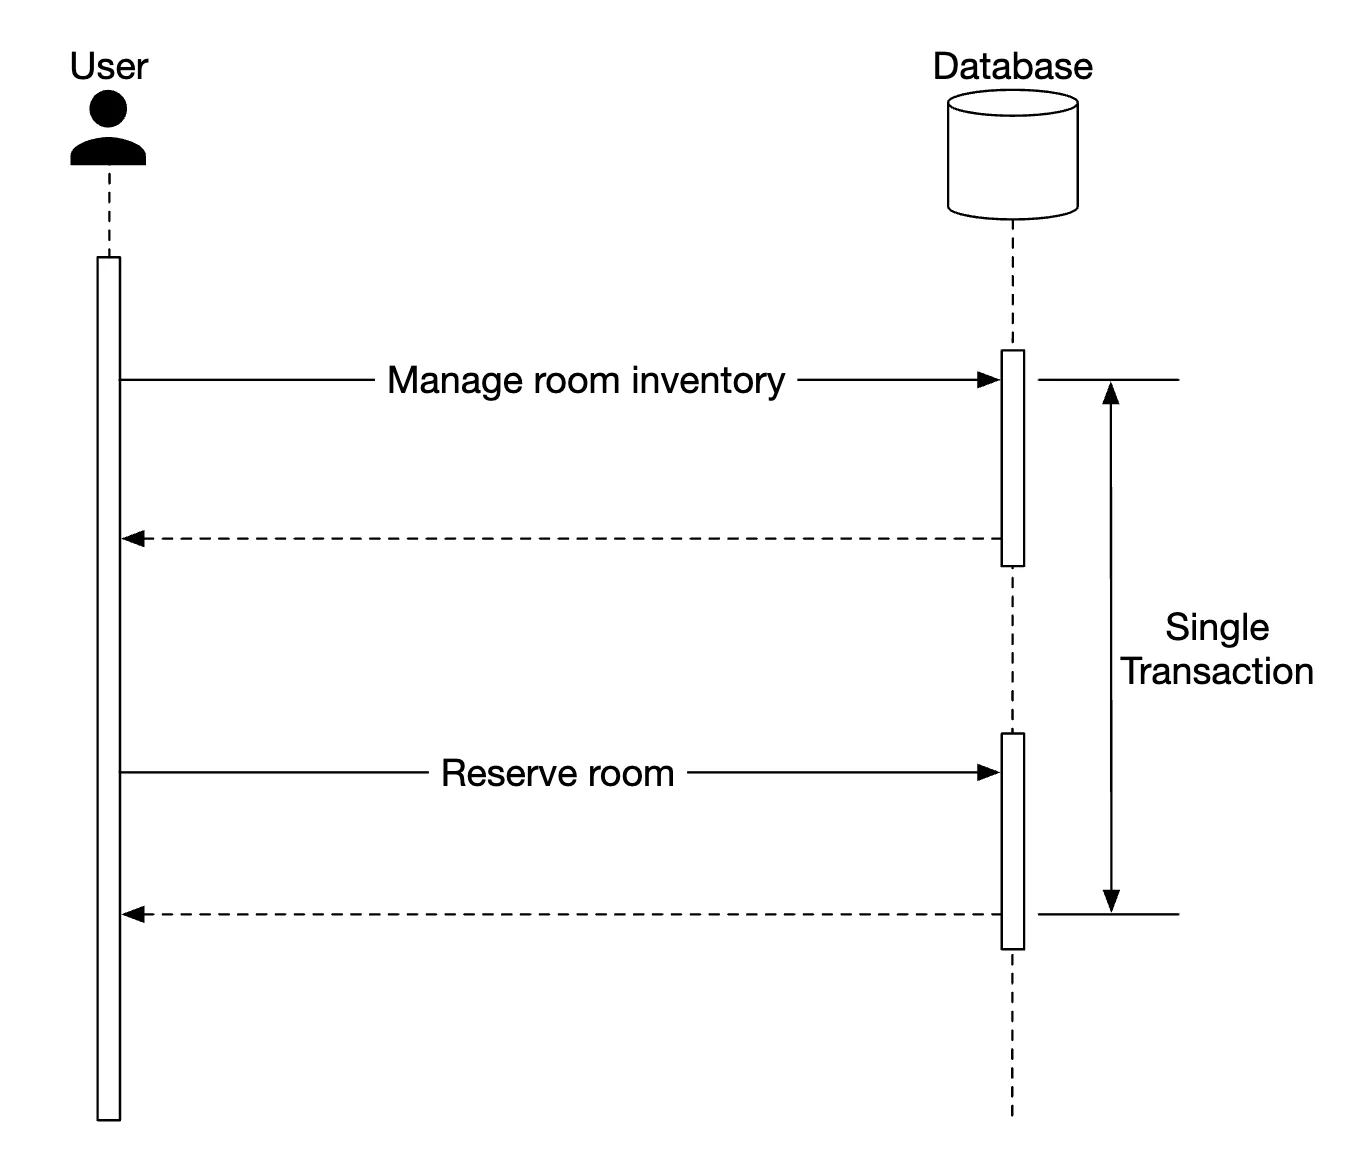
但当操作跨越多个服务时,保证这种原子性就更具挑战性了:
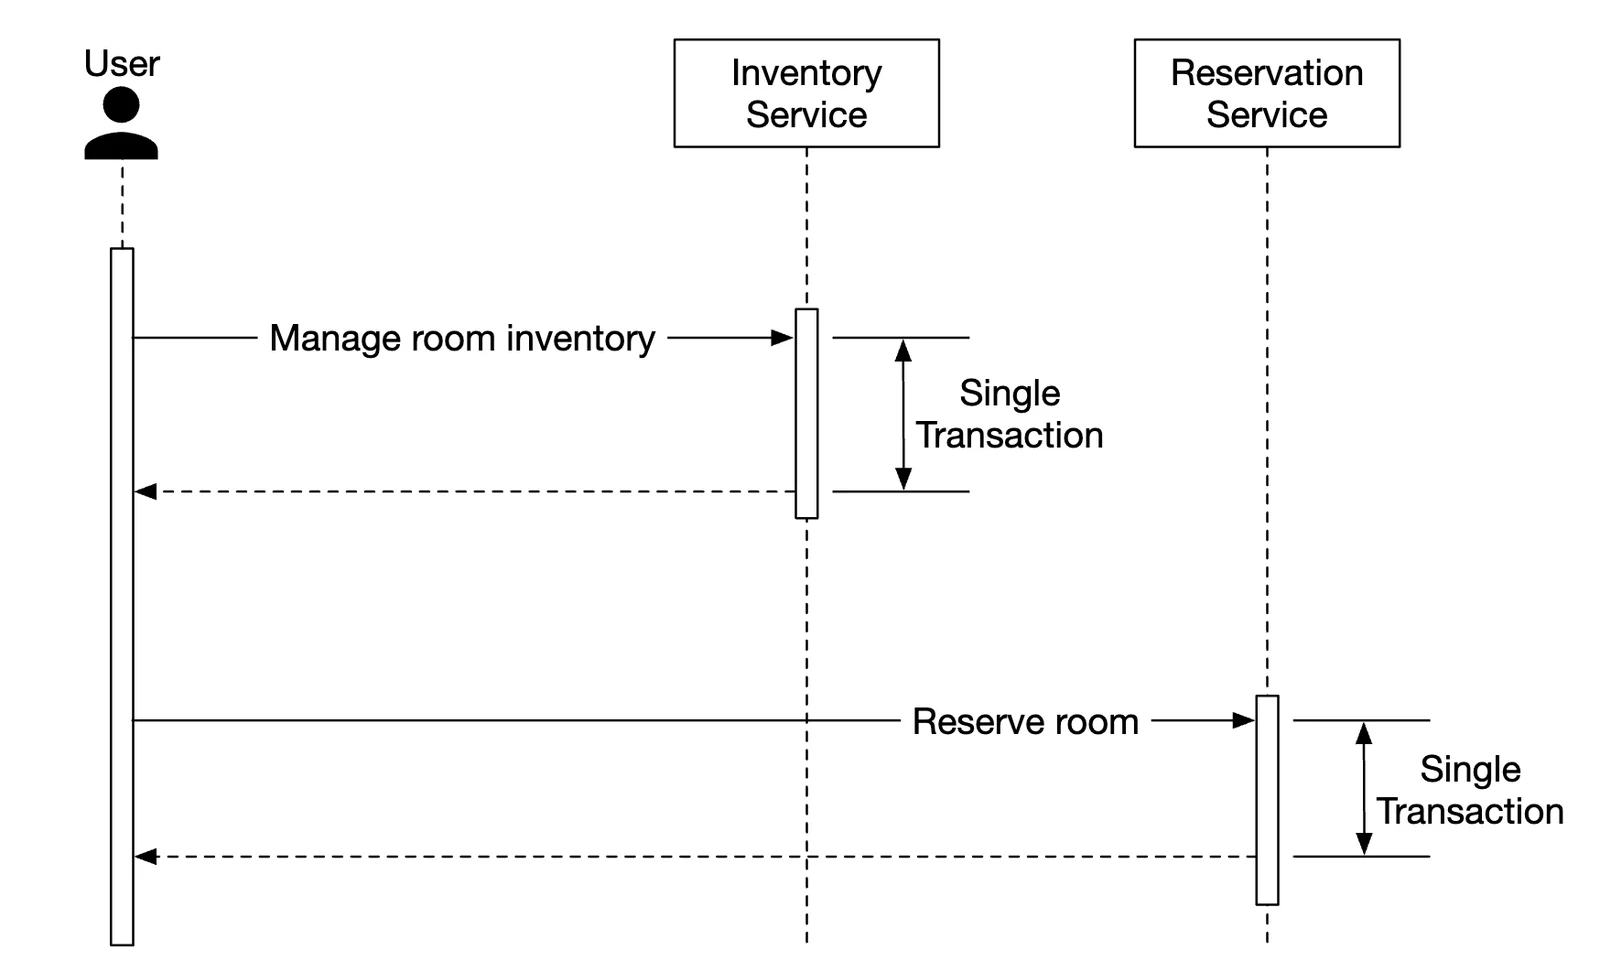
有一些广为人知的技术可以处理这类数据不一致:
- 两阶段提交(Two-phase Commit):一种数据库协议,保证跨多个节点的事务原子提交。 不过它的性能不佳,因为只要一个节点滞后,所有节点都会被阻塞。
- Saga:由一系列本地事务组成,如果工作流中的任何一步失败,就会触发补偿事务。这是一种最终一致性(Eventual Consistency)的方法。
值得注意的是,解决微服务之间的数据不一致是一个有挑战性的问题,会提高系统复杂度。 考虑到我们采用了更务实的方法(把相互依赖的操作封装在同一个关系型数据库中),最好想一想付出这种代价是否值得。
第 4 步:总结
我们给出了一个酒店预订系统的设计。
我们经历了以下步骤:
- 收集需求并进行粗略估算,以了解系统的规模
- 在高层设计中给出了 API 设计、数据模型和系统架构
- 在深入探讨中,随着需求的变化,我们探索了其他数据库表结构设计
- 讨论了竞态条件并提出了解决方案:悲观锁/乐观锁、数据库约束
- 通过数据库分片和缓存扩展系统的方法
- 最后讨论了如何处理多个微服务之间的数据一致性问题