第 23 章 分布式邮件服务
引言
本章我们将设计一个类似 Gmail 的分布式邮件服务(Distributed Email Service)。
2020 年,Gmail 在全球拥有 18 亿活跃用户,而 Outlook 拥有 4 亿用户。
第 1 步:理解问题并确定设计范围
- 候选人:有多少用户使用这个系统?
- 面试官:10 亿用户
- 候选人:我认为以下功能比较重要:认证、发送 / 接收邮件、获取邮件、过滤邮件、搜索邮件、反垃圾邮件防护。
- 面试官:列得不错。认证暂时不用考虑。
- 候选人:用户如何与邮件服务器连接?
- 面试官:通常邮件客户端通过 SMTP、POP、IMAP 连接,但在本题中我们使用 HTTP。
- 候选人:邮件可以带附件吗?
- 面试官:可以
非功能性需求
- 可靠性:我们不应该丢失数据
- 可用性:我们应该通过复制来避免单点故障,还应该能够容忍系统的局部故障。
- 可扩展性:随着用户群增长,系统应该能够承载这些用户。
- 灵活性和可扩展性:系统应该灵活,易于扩展新功能。这也是我们选择 HTTP 而不是 SMTP / 其他邮件协议的原因之一。
粗略估算
- 10 亿用户
- 假设每人每天发送 10 封邮件 -> 每秒 10 万封邮件。
- 假设每人每天接收 40 封邮件,每封邮件的元数据平均为 50 KB -> 每年 730 PB 存储。
- 假设 20% 的邮件带有附件,附件平均大小为 500 KB -> 每年 1,460 PB。
第 2 步:提出高层设计并获得认可
邮件基础知识
收发邮件会用到多种协议:
- SMTP:将邮件从一台服务器发送到另一台服务器的标准协议。
- POP:从远程邮件服务器接收并下载邮件到本地客户端的标准协议。邮件一旦被取回,就会从远程服务器上删除。
- IMAP:与 POP 类似,用于从远程服务器接收并下载邮件,但它会把邮件保留在服务器端。
- HTTPS:严格来说并不是邮件协议,但可以用于基于 Web 的邮件客户端。
除了邮件协议之外,我们还需要为邮件服务器配置一些 DNS 记录,即 MX 记录(MX Record):
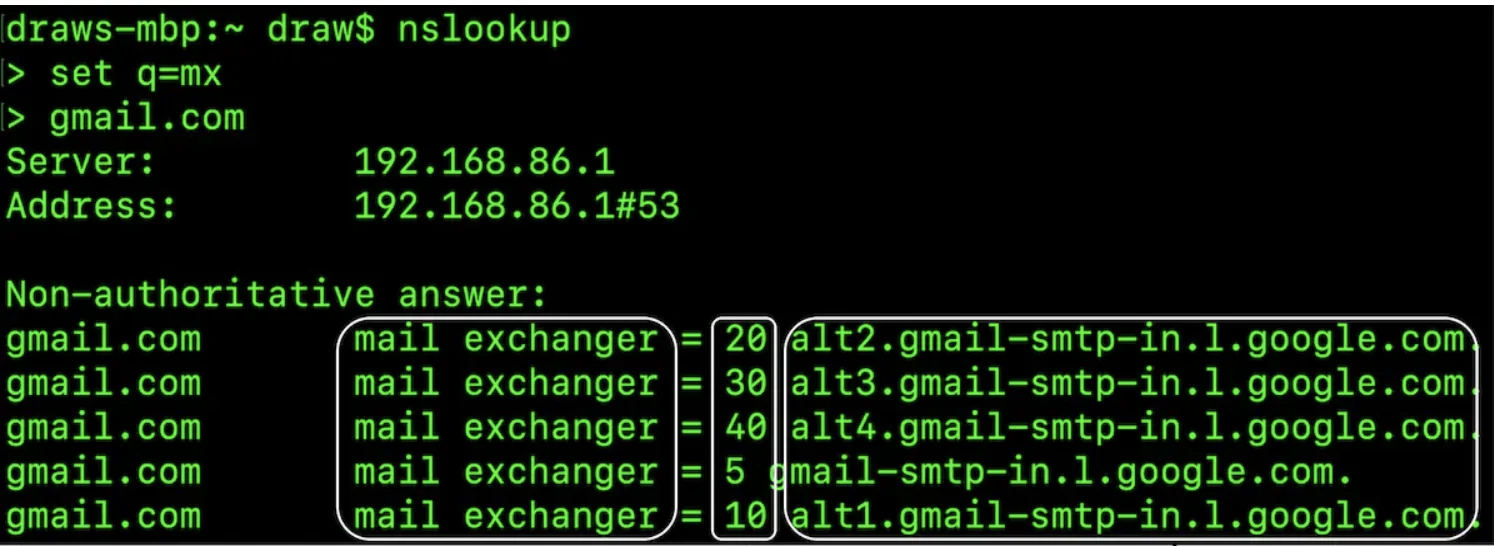
邮件附件以 base64 编码发送,大多数邮件服务通常都有 25 MB 的大小限制。 这个限制是可配置的,个人账户和企业账户各不相同。
传统邮件服务器
当用户数量有限、都连接到单台服务器时,传统邮件服务器工作得很好。
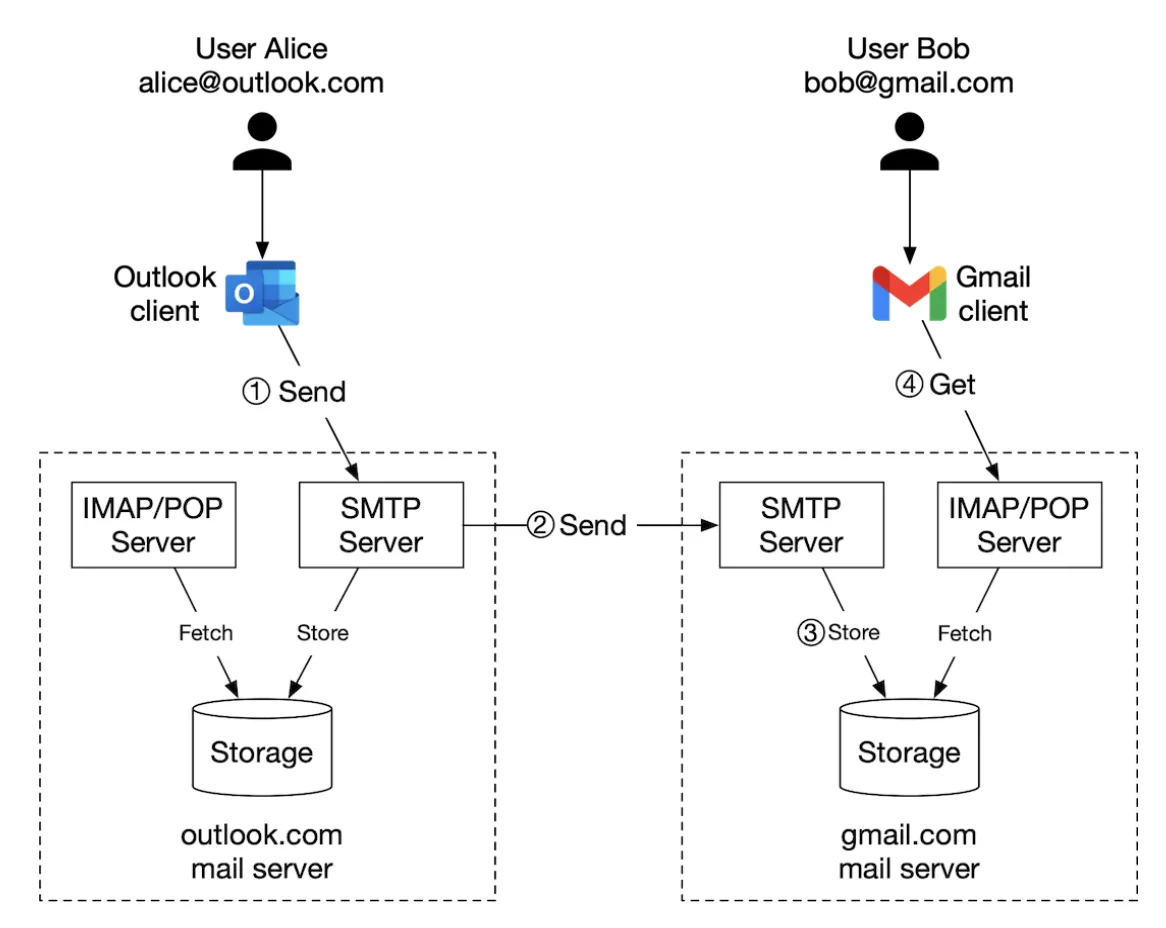
- Alice 登录她的 Outlook 邮箱并点击「发送」。邮件被发送到 Outlook 邮件服务器,通信通过 SMTP 进行。
- Outlook 服务器查询 DNS,找到 gmail.com 的 MX 记录,并将邮件传送到对方的服务器,通信通过 SMTP 进行。
- Bob 通过 IMAP/POP 从他的 Gmail 服务器获取邮件。
在传统邮件服务器中,邮件存储在本地文件系统上,每封邮件都是一个单独的文件。
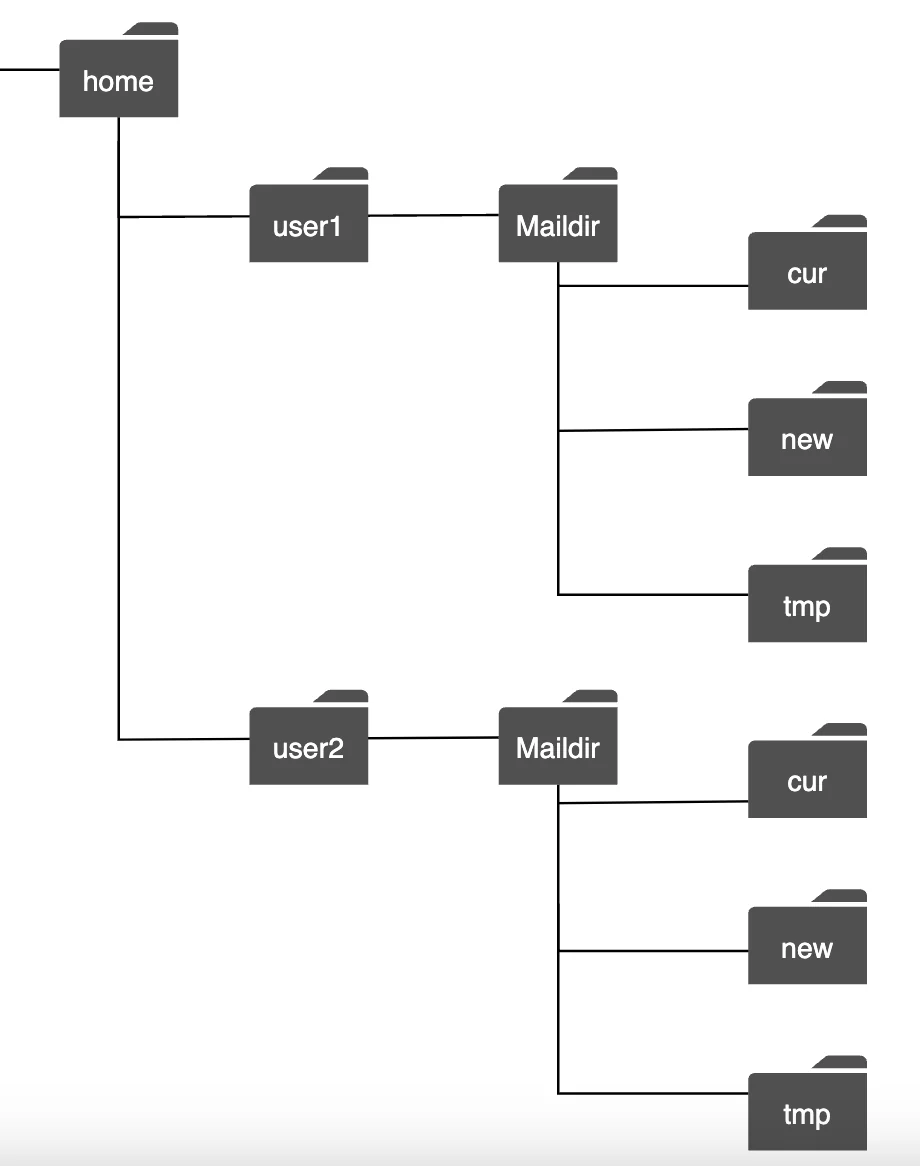
随着规模的增长,磁盘 I/O 成为了瓶颈。此外,这种方式也无法满足我们对高可用性和可靠性的要求。 磁盘可能损坏,服务器也可能宕机。
分布式邮件服务器
分布式邮件服务器旨在支持现代的使用场景,并解决现代的可扩展性问题。
这些服务器仍然可以为原生邮件客户端支持 IMAP/POP,并使用 SMTP 在服务器之间交换邮件。
但对于功能丰富的 Web 邮件客户端,通常使用基于 HTTP 的 RESTful API。
API 示例:
POST /v1/messages:向 To、Cc、Bcc 头中的收件人发送一条消息。GET /v1/folders:返回某个邮件账户的所有文件夹
响应示例:
[{id: string        唯一的文件夹标识符。
  name: string      文件夹的名称。
                    根据 RFC6154 [9],默认文件夹可以是以下之一:
                    All、Archive、Drafts、Flagged、Junk、Sent
                    和 Trash。
  user_id: string   指向账户所有者的引用
}]
GET /v1/folders/{:folder_id}/messages:分页返回某个文件夹下的所有消息GET /v1/messages/{:message_id}:获取某条消息的全部信息
响应示例:
{
  user_id: string                      // 指向账户所有者的引用。
  from: {name: string, email: string}  // 发件人的 <name, email> 对。
  to: [{name: string, email: string}]  // <name, email> 对的列表
  subject: string                      // 邮件主题
  body: string                         // 消息正文
  is_read: boolean                     // 表示消息是否已读。
}
下面是分布式邮件服务器的高层设计:
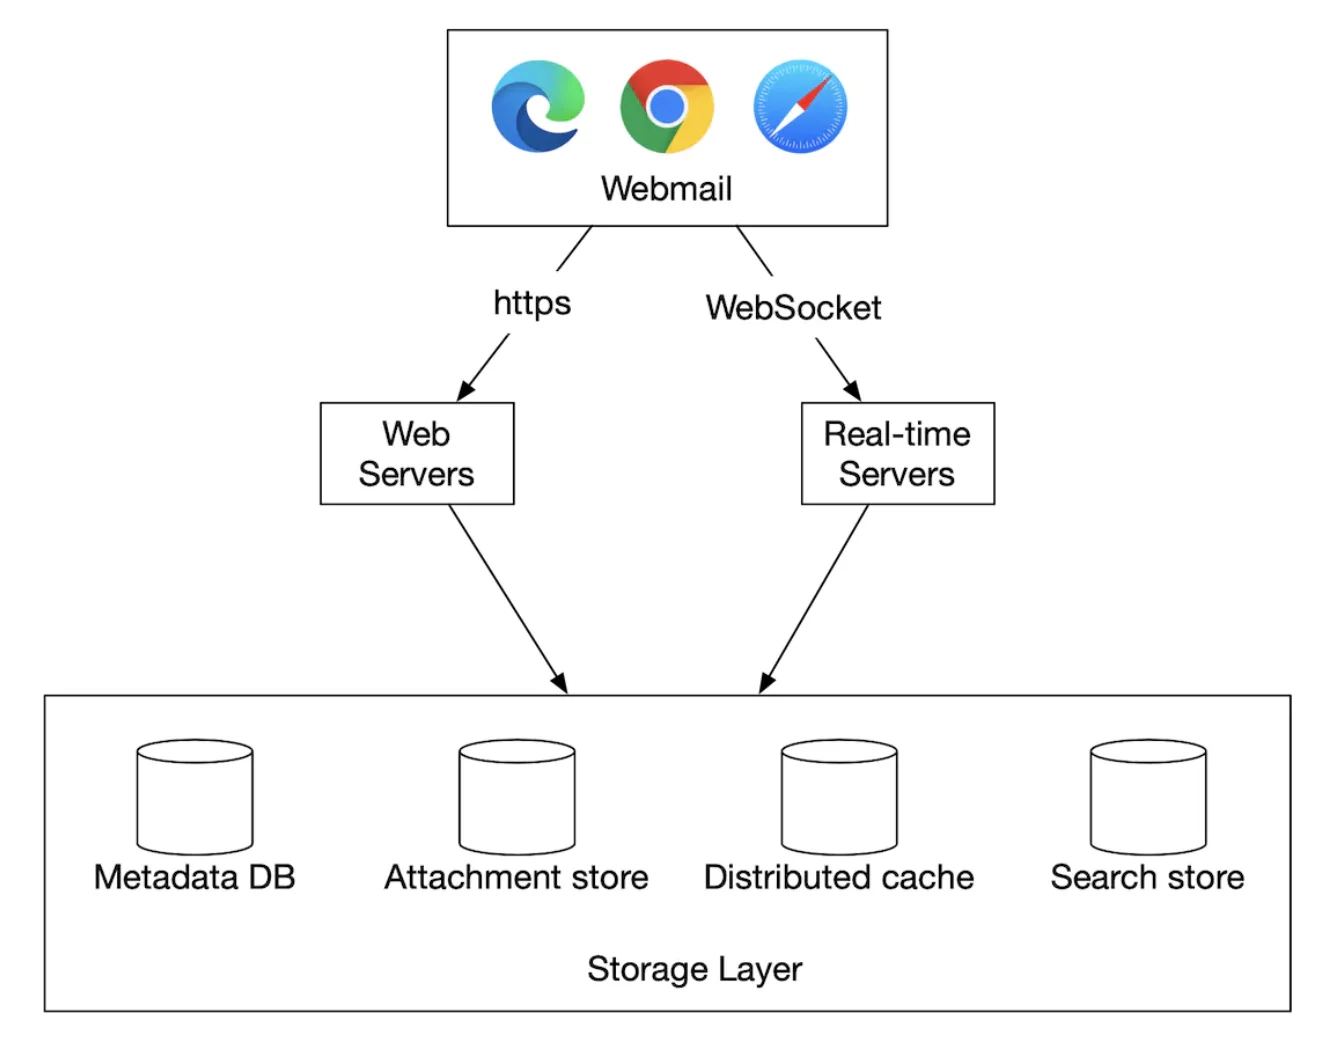
- Webmail:用户使用 Web 浏览器收发邮件
- Web 服务器:面向公网的请求 / 响应服务,用于管理登录、注册、用户资料等。
- 实时服务器:用于将新邮件的更新实时推送给客户端。我们使用 WebSocket 进行实时通信,对于不支持它的旧版浏览器则回退到长轮询(Long Polling)。
- 元数据数据库:存储邮件的元数据,例如主题、正文、发件人、收件人等。
- 附件存储:对象存储(例如 Amazon S3),适合存储大文件。
- 分布式缓存:我们可以把最近的邮件缓存在 Redis 中,以改善用户体验。
- 搜索存储:分布式文档存储,用于支持全文搜索。
邮件发送流程如下:
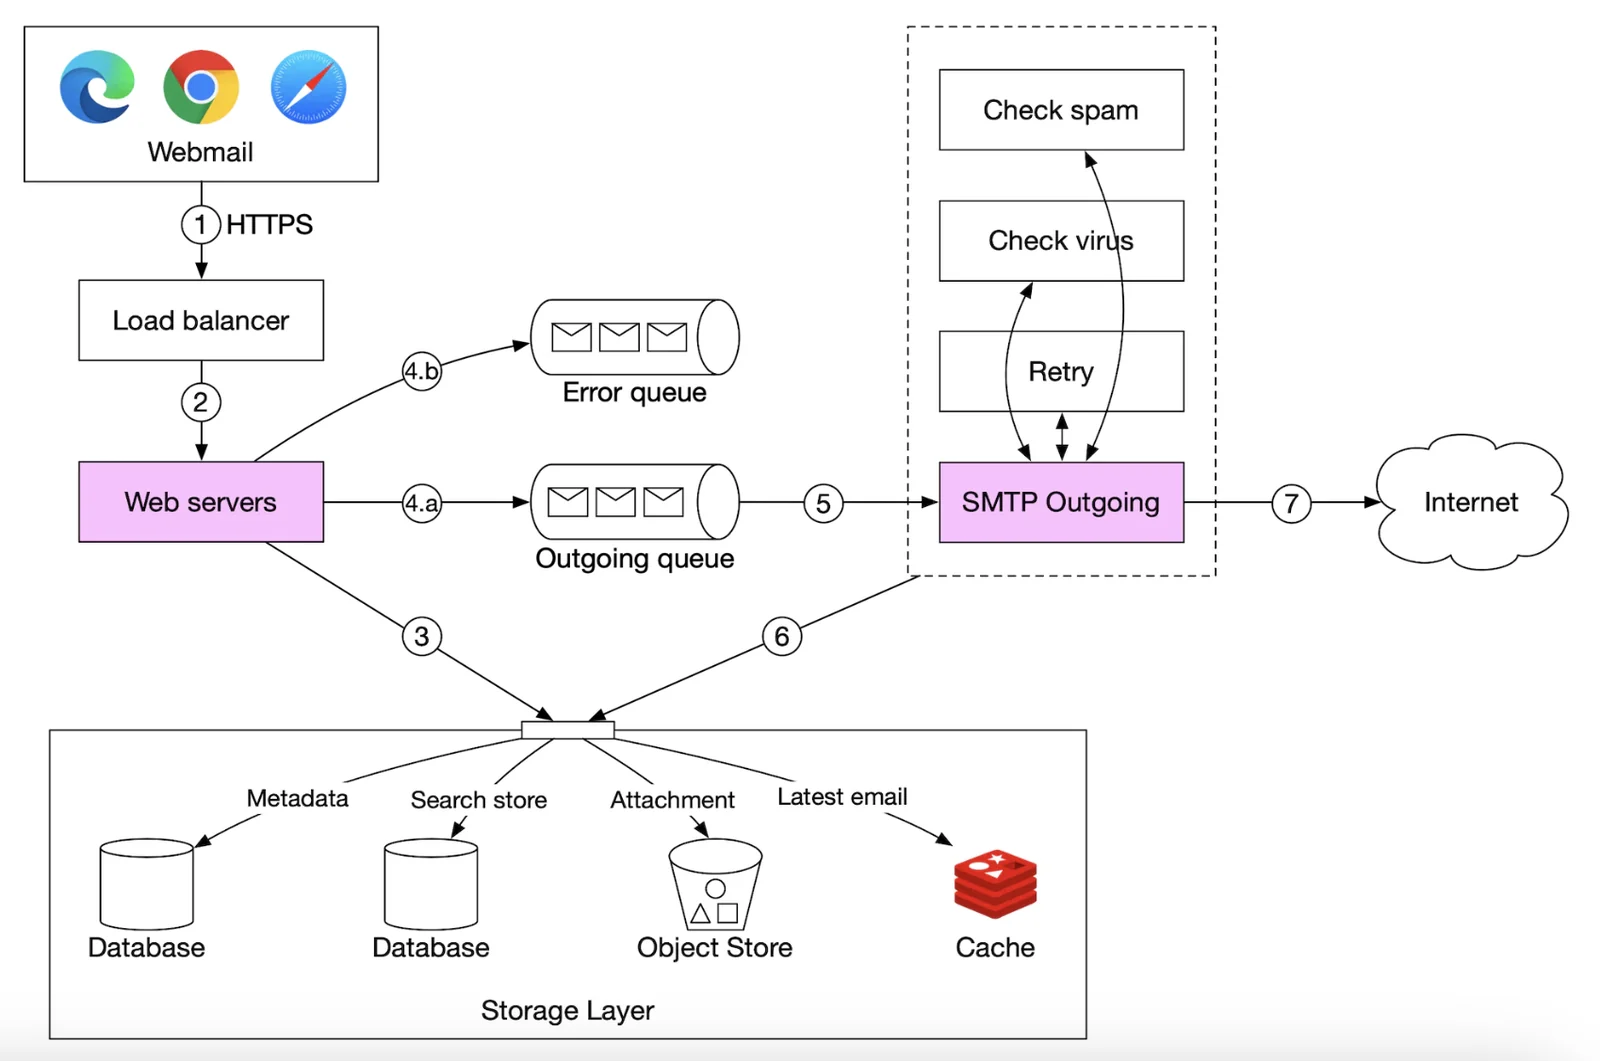
- 用户撰写邮件并点击「发送」,邮件被发送到负载均衡器(Load Balancer)。
- 负载均衡器对过量的邮件发送进行限流,并将请求路由到某台 Web 服务器。
- Web 服务器进行基本的邮件校验(例如邮件大小),如果收件人域名与发件人相同,则直接短路外发流程,但会先做垃圾邮件检查。
- 如果基本校验通过,邮件会被发送到消息队列(附件通过引用指向对象存储)
- 如果基本校验失败,邮件会被发送到错误队列
- SMTP 外发 worker 从外发队列中拉取消息,进行垃圾邮件 / 病毒检查,并将其路由到目标邮件服务器。
- 邮件被存储到「已发送邮件」文件夹中
我们还需要监控外发消息队列的大小。队列增长过大可能意味着出现了问题:
- 收件人的邮件服务器不可用。我们可以使用指数退避(Exponential Backoff)在稍后重试发送邮件。
- 消费者不足以处理负载,我们可能需要扩容消费者。
邮件接收流程如下:
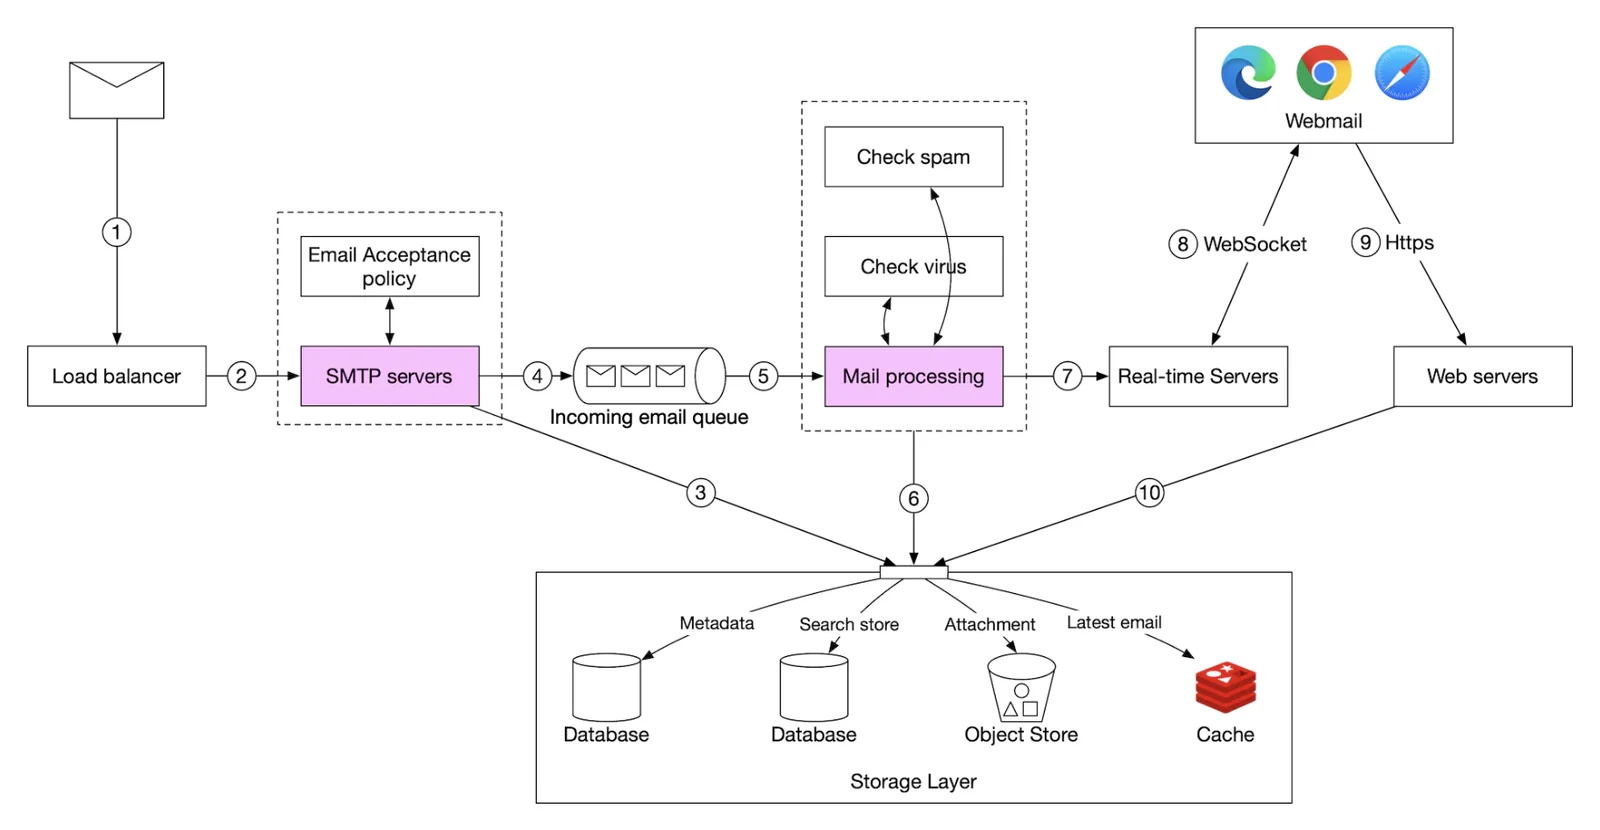
- 收到的邮件先到达 SMTP 负载均衡器。邮件被分发到各台 SMTP 服务器,在那里执行邮件接收策略(例如直接丢弃无效邮件)。
- 如果邮件附件太大,我们可以把它放进对象存储(S3)。
- 邮件处理 worker 进行初步检查,之后邮件被转发到存储、缓存、对象存储和实时服务器。
- 离线用户重新上线后,通过 HTTP API 获取他们的新邮件。
第 3 步:设计深入
现在我们来深入了解其中的一些组件。
元数据数据库
邮件元数据有以下一些特点:
- 邮件头通常很小,且访问频繁
- 正文大小有小有大,但通常只读一次
- 大多数邮件操作都局限于单个用户,例如获取邮件、标记为已读、搜索。
- 数据的新旧程度会影响数据的使用。用户通常只阅读最近的邮件
- 数据有很高的可靠性要求,数据丢失是不可接受的。
在 Gmail/Outlook 这样的规模下,数据库通常是定制开发的,以降低每秒输入 / 输出操作数(IOPS)。
我们来看看有哪些数据库选项:
- 关系型数据库:我们可以为邮件头和正文建立索引,但这类数据库通常是针对小块数据优化的。
- 分布式对象存储:可以作为备份存储的不错选择,但无法高效地支持搜索、标记为已读等操作。
- NoSQL:Gmail 使用的是 Google BigTable,但它没有开源。
根据以上分析,现有方案中似乎很少有能完全满足我们需求的。 在面试中,设计一个全新的分布式数据库方案是不现实的,但重要的是要提到它应具备的特性:
- 单列可以达到个位数 MB
- 强数据一致性
- 设计上要减少磁盘 I/O
- 高可用且容错
- 应该易于创建增量备份
为了对数据进行分区,我们可以用 user_id 作为分区键(Partition Key),这样一个用户的数据就存储在同一个分片上。
这使得我们无法在多个用户之间共享同一封邮件,但这并不是本次面试的需求。
我们来定义表结构:
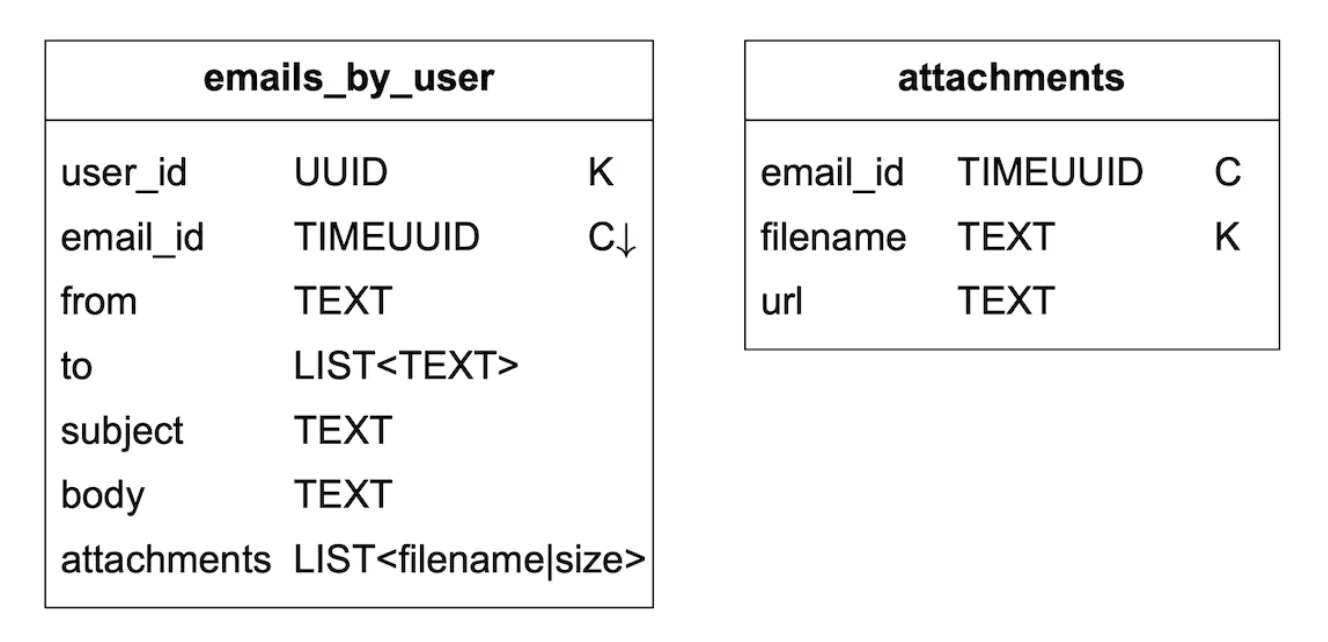
- 主键由分区键(决定数据分布)和聚簇键(Clustering Key,决定数据排序)组成
- 我们需要支持的查询:获取某个用户的所有文件夹、显示某个文件夹下的所有邮件、创建 / 获取 / 删除邮件、获取已读 / 未读邮件、获取会话线程(加分项)
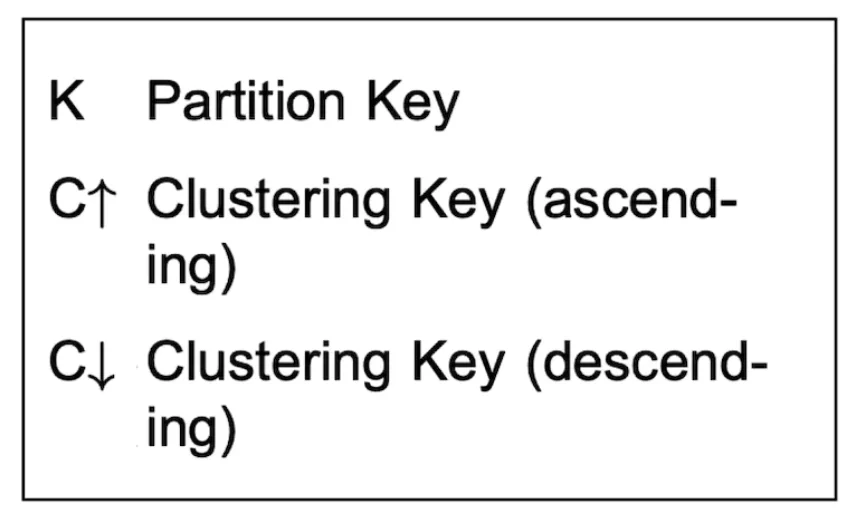
下文表格的图例:
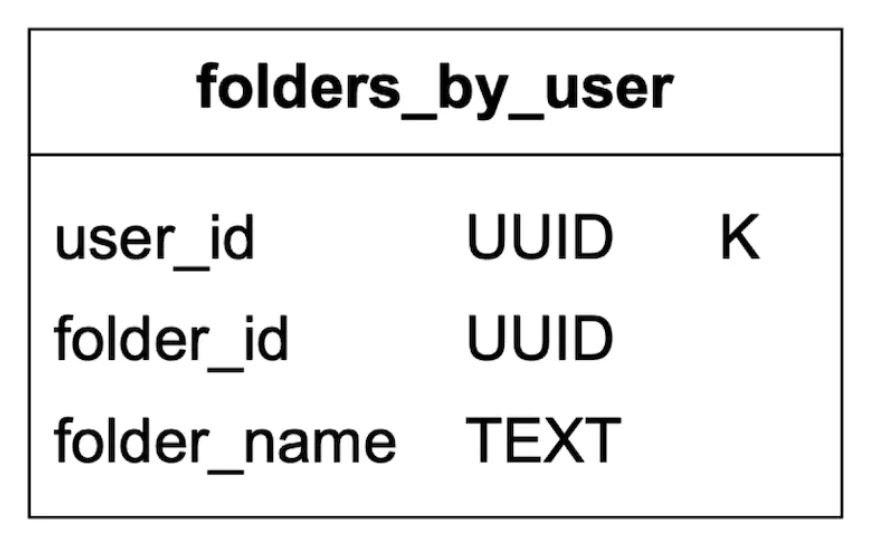
下面是 folders 表:
emails 表:
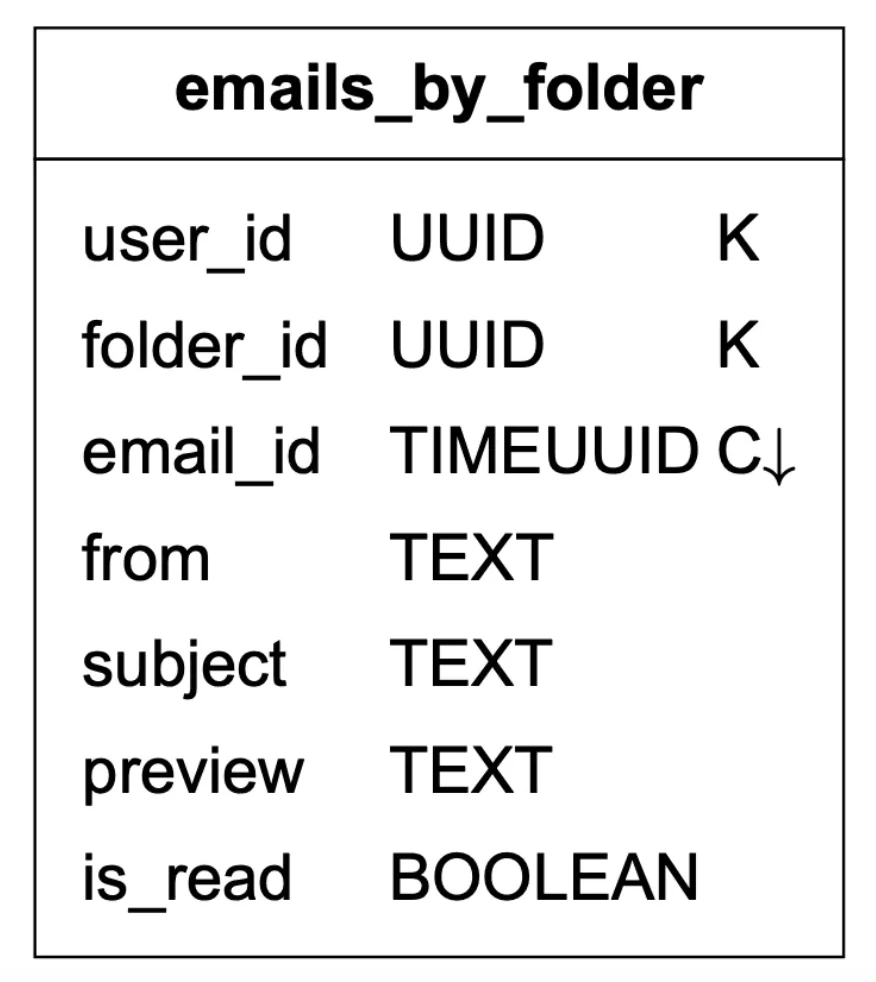
- email_id 是 timeuuid,可以根据邮件创建时的时间戳进行排序
附件存储在一张单独的表中,以文件名标识:
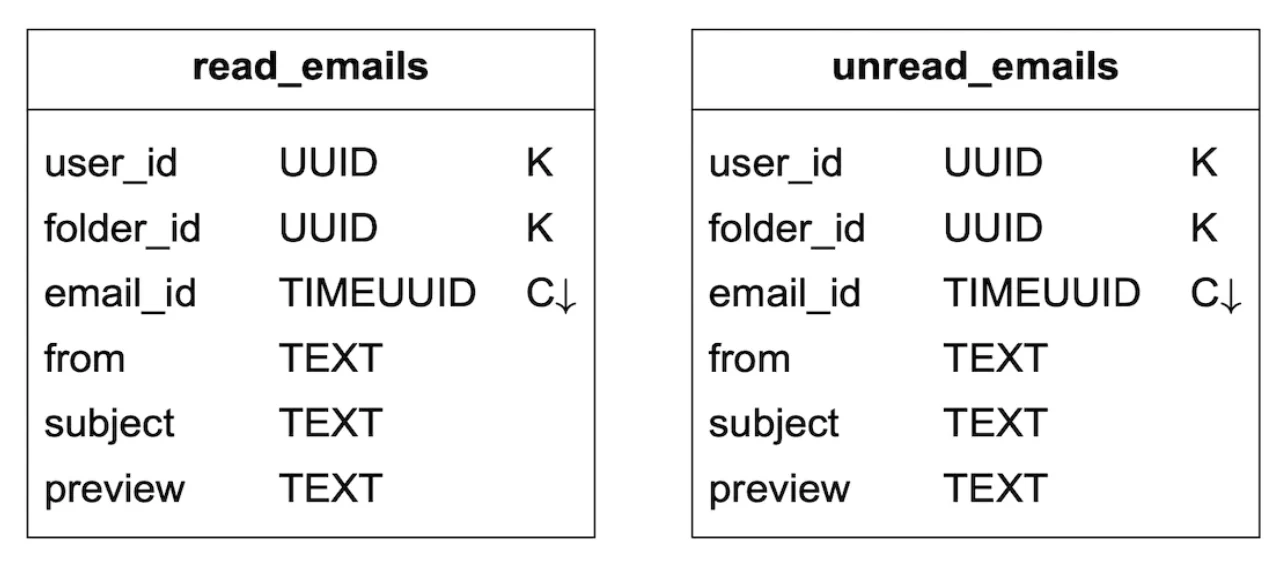
在传统关系型数据库中,支持获取已读 / 未读邮件很容易,但在 Cassandra 中却不行,因为它禁止在非分区键 / 聚簇键上进行过滤。 一种变通方法是获取文件夹中的所有邮件,然后在内存中过滤,但对于规模足够大的应用,这种做法效果不佳。
我们可以做的是将 emails 表反范式化(Denormalize),拆分为已读邮件表和未读邮件表:
为了支持会话线程,我们可以加入一些邮件头,邮件客户端会解析这些邮件头并用它们重建会话线程:
{
  "headers" {
     "Message-Id": "<7BA04B2A-430C-4D12-8B57-862103C34501@gmail.com>",
     "In-Reply-To": "<CAEWTXuPfN=LzECjDJtgY9Vu03kgFvJnJUSHTt6TW@gmail.com>",
     "References": ["<7BA04B2A-430C-4D12-8B57-862103C34501@gmail.com>"]
  }
}
最后,对于我们的分布式数据库,我们将牺牲可用性来换取一致性,因为一致性是本题的硬性要求。
因此,在发生故障转移或网络分区时,受影响的用户将短暂无法进行同步 / 更新操作。
邮件送达率
搭建一台发送邮件的服务器很容易,但由于反垃圾邮件算法的存在,要让邮件进入收件人的收件箱却很难。
如果我们只是新搭建一台邮件服务器并开始用它发送邮件,我们的邮件很可能会进入垃圾邮件文件夹。
为了避免这种情况,我们可以这样做:
- 专用 IP:使用专用 IP 发送邮件,否则收件方服务器不会信任你。
- 邮件分类:避免从同一批服务器发送营销邮件,以防更重要的邮件被归类为垃圾邮件
- 预热你的 IP 地址:慢慢预热,以便在大型邮件服务商那里建立良好的信誉。预热一个新 IP 需要 2 到 6 周
- 封禁垃圾邮件发送者:要迅速封禁,以免损害你的信誉
- 反馈处理:与 ISP 建立反馈回路,跟踪投诉率并迅速封禁垃圾邮件账户。
- 邮件认证:使用常见的技术来防范钓鱼,例如发件人策略框架(Sender Policy Framework)、域名密钥识别邮件(DomainKeys Identified Mail)等。
这些你不需要全部记住,只要知道构建一个好的邮件服务器需要大量的领域知识即可。
搜索
搜索既包括基于邮件内容的全文搜索,也包括基于发件人、收件人、主题、未读等过滤条件的更高级查询。
邮件搜索的一个特点是它只局限于用户自己的邮件,而且写多于读,因为每次操作都需要重建索引,但用户很少使用搜索功能。
我们来比较一下 Google 搜索和邮件搜索:
| 范围 | 排序 | 准确性 | |
|---|---|---|---|
| Google 搜索 | 整个互联网 | 按相关性排序 | 建立索引需要一些时间,因此结果不是即时的。 |
| 邮件搜索 | 用户自己的邮箱 | 按属性排序,例如时间、日期等 | 索引应当很快建立,结果要准确。 |
为了实现这种搜索功能,一种选择是使用 Elasticsearch 集群。我们可以用 user_id 作为分区键,把同一用户的数据归到同一个节点上:
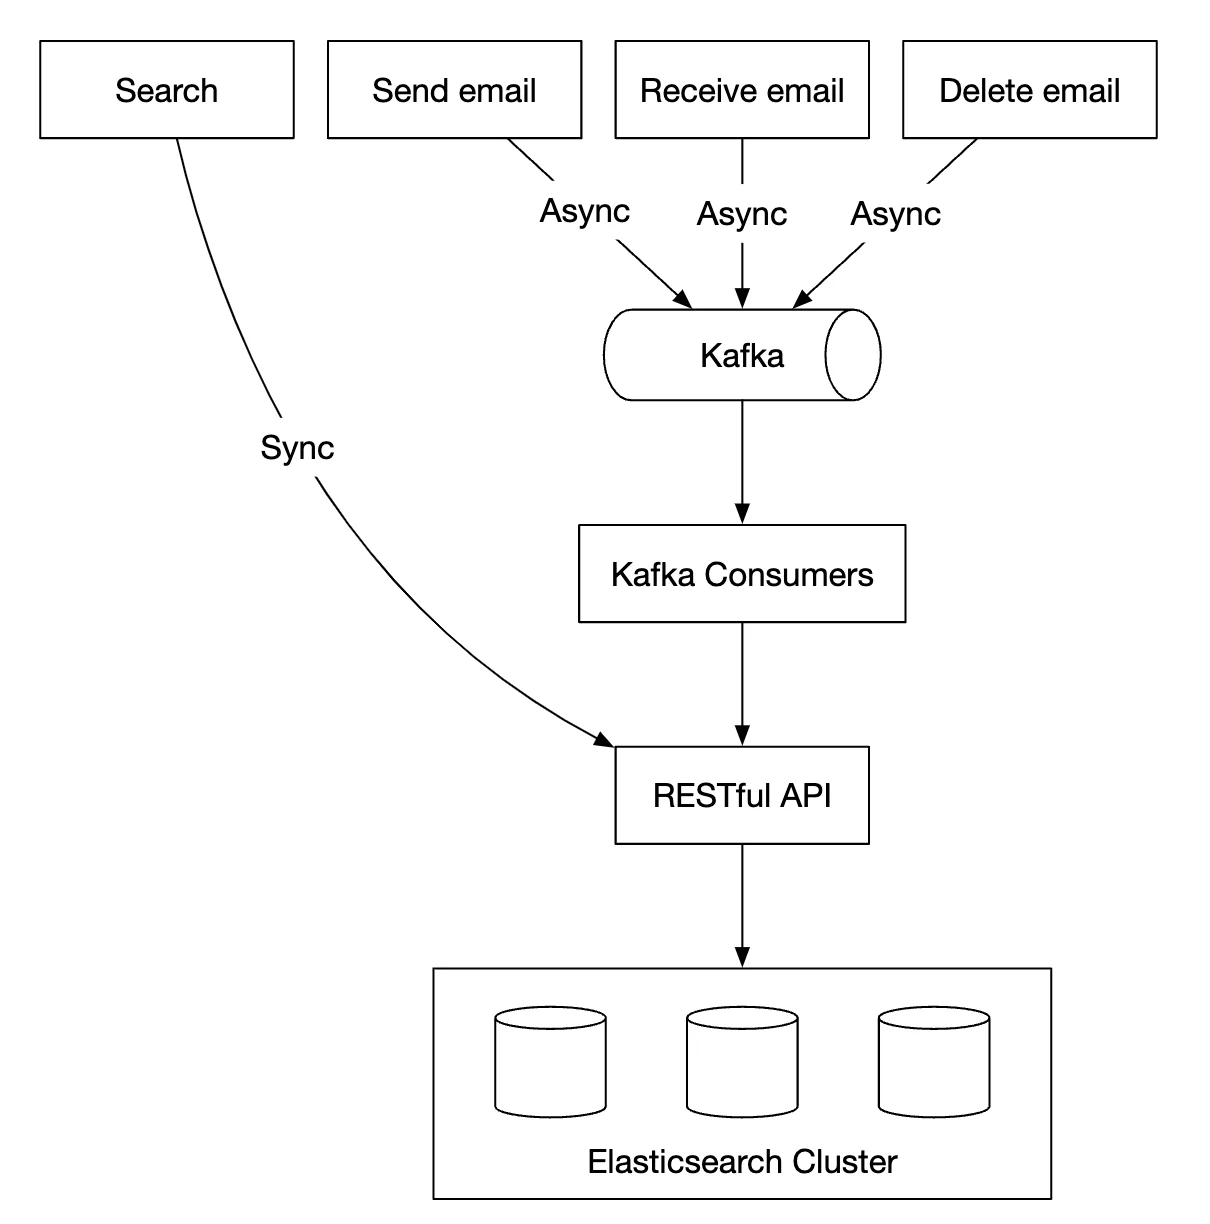
变更类操作通过 Kafka 异步进行,以便将各个服务与重建索引的流程解耦。 而真正的数据搜索是同步进行的。
Elasticsearch 是最流行的搜索引擎数据库之一,对邮件全文搜索的支持非常好。
另一种选择是,我们可以尝试开发自己的定制搜索方案,以满足我们的特定需求。
设计这样一个系统超出了本章的范围。构建它的核心挑战之一,是针对写密集型负载对其进行优化。
为此,我们可以使用日志结构合并树(Log-Structured Merge-Tree,LSM)来组织磁盘上的索引数据。写路径只针对顺序写入进行优化。 Cassandra、BigTable 和 RocksDB 都使用了这项技术。
它的核心思想是:先把数据存储在内存中,直到达到预先定义的阈值,然后再将其合并到下一层(磁盘):
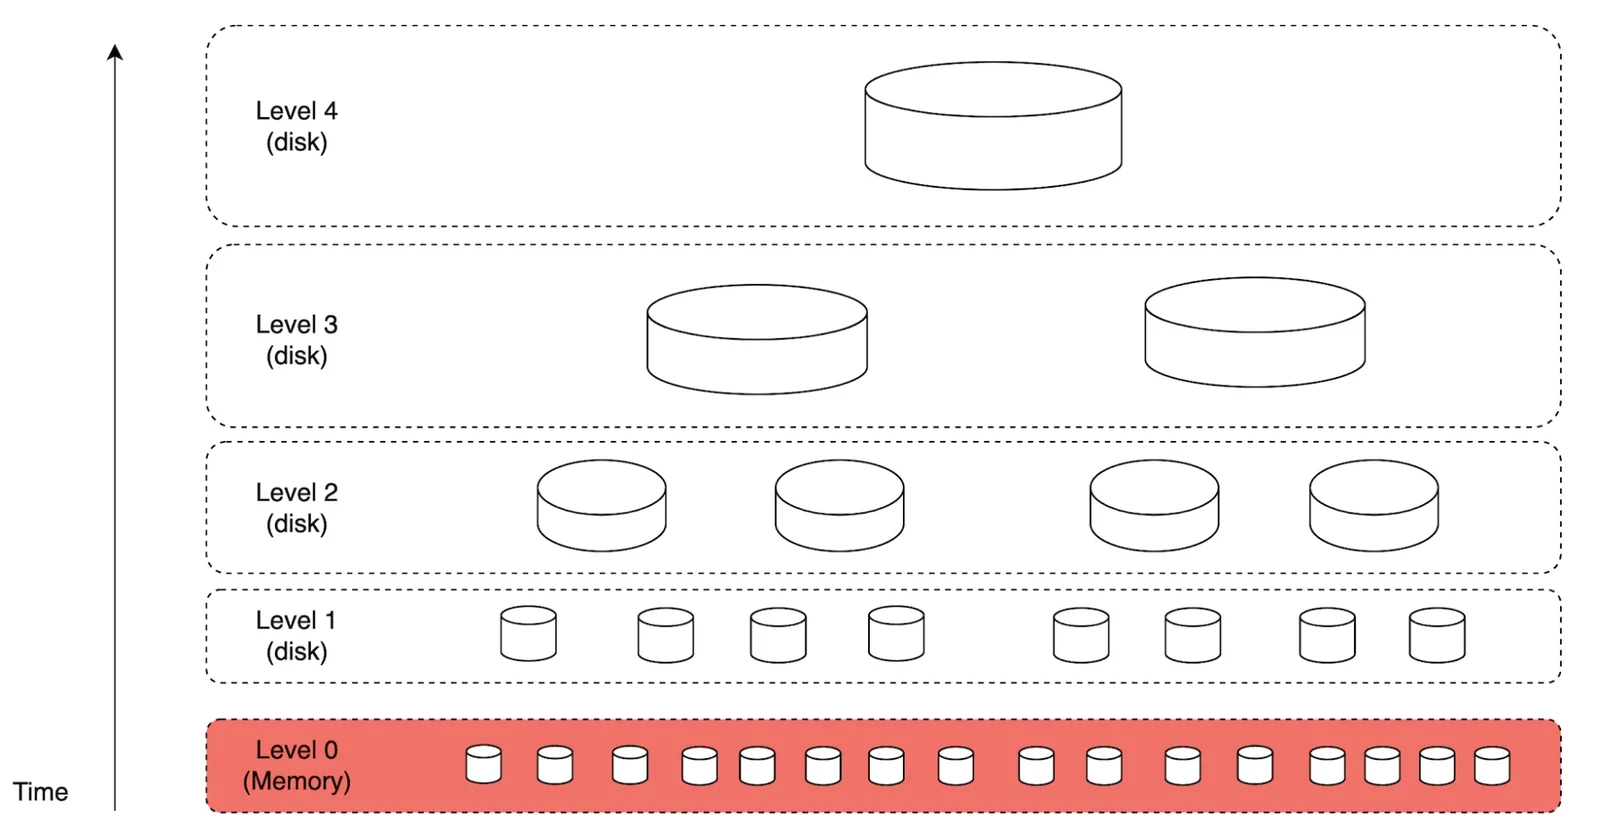
两种方案之间的主要权衡(Trade-off):
- Elasticsearch 只能扩展到一定程度,而定制的搜索引擎可以针对邮件场景进行精细调优,从而可以扩展得更远。
- Elasticsearch 是一个单独的服务,我们需要在元数据存储之外额外维护它。而定制方案本身就可以是数据存储。
- Elasticsearch 是现成的方案,而定制搜索引擎则需要大量的工程投入来构建。
可扩展性与可用性
由于单个用户的操作不会与其他用户冲突,大多数组件都可以独立扩展。
为了确保高可用,我们还可以采用多数据中心部署,在发生故障时进行 leader-follower 故障转移:
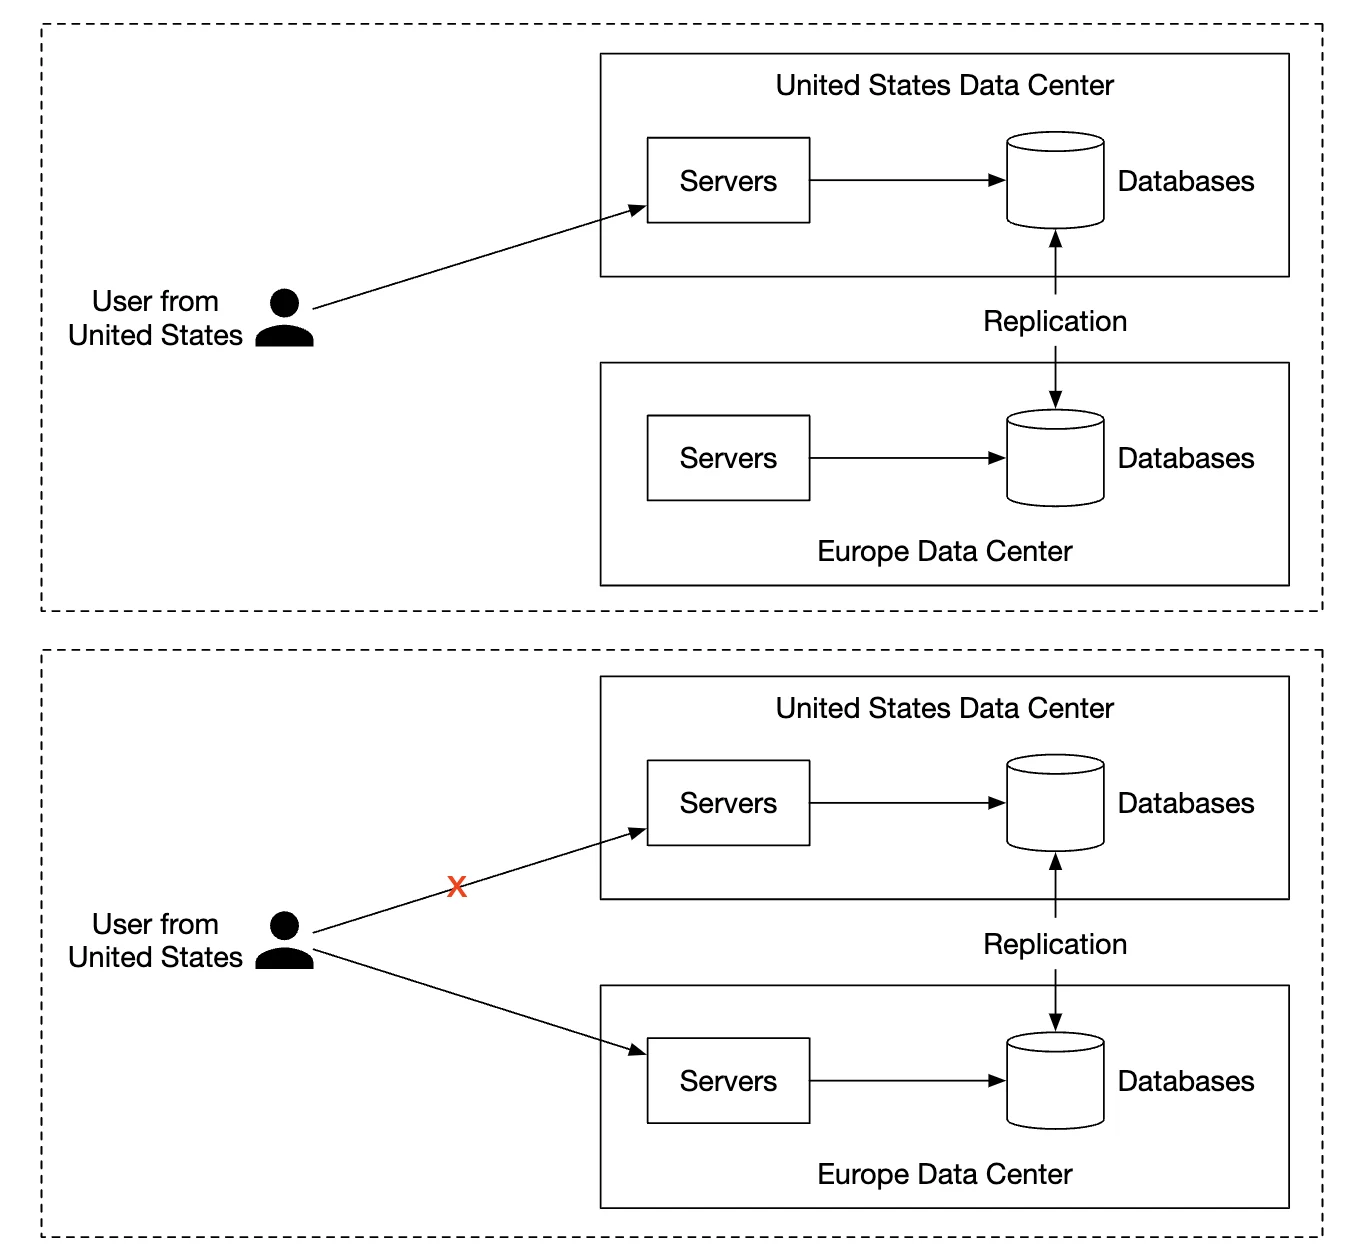
第 4 步:总结
其他可以讨论的要点:
- 容错:系统的许多部分都可能发生故障,值得讨论一下我们会如何处理节点故障。
- 合规:鉴于欧洲的 GDPR 法规,个人身份信息(PII)需要以合理的方式存储。
- 安全:邮件加密、钓鱼防护、安全浏览等。
- 优化:例如避免同一份附件被不同用户多次发送时产生重复存储。