第 6 章 设计键值存储
引言
键值存储(Key-Value Store) 是一种非关系型数据库,数据以键值对的形式存储。每个键都是唯一的,通过键来访问对应的值。本章详细介绍如何设计一个可扩展、高可用的分布式键值存储,它支持以下操作:
put(key, value)用于插入数据。get(key)用于获取数据。
设计的特点
- 键值对较小(小于 10 KB)。
- 支持大数据量,具备高可用性和可扩展性。
- 自动扩展,一致性可调。
- 低延迟。
单服务器键值存储
实现
- 使用哈希表在内存中存储键值对。
- 优化手段:
- 数据压缩。
- 把不常访问的数据存储在磁盘上。
局限
单台服务器的内存有限,要实现可扩展就需要采用分布式方案。
分布式键值存储
分布式键值存储把数据分区到多台服务器上,并且必须应对 CAP 定理(CAP Theorem) 所描述的权衡。
CAP 定理
- 一致性(Consistency): 所有客户端在同一时刻看到的数据都相同。
- 可用性(Availability): 即使部分节点宕机,系统也会对每个请求作出响应。
- 分区容错性(Partition Tolerance): 即使出现网络分区,系统也能继续运行。
权衡: 根据 CAP 定理,这三项保证最多只能同时满足其中两项。
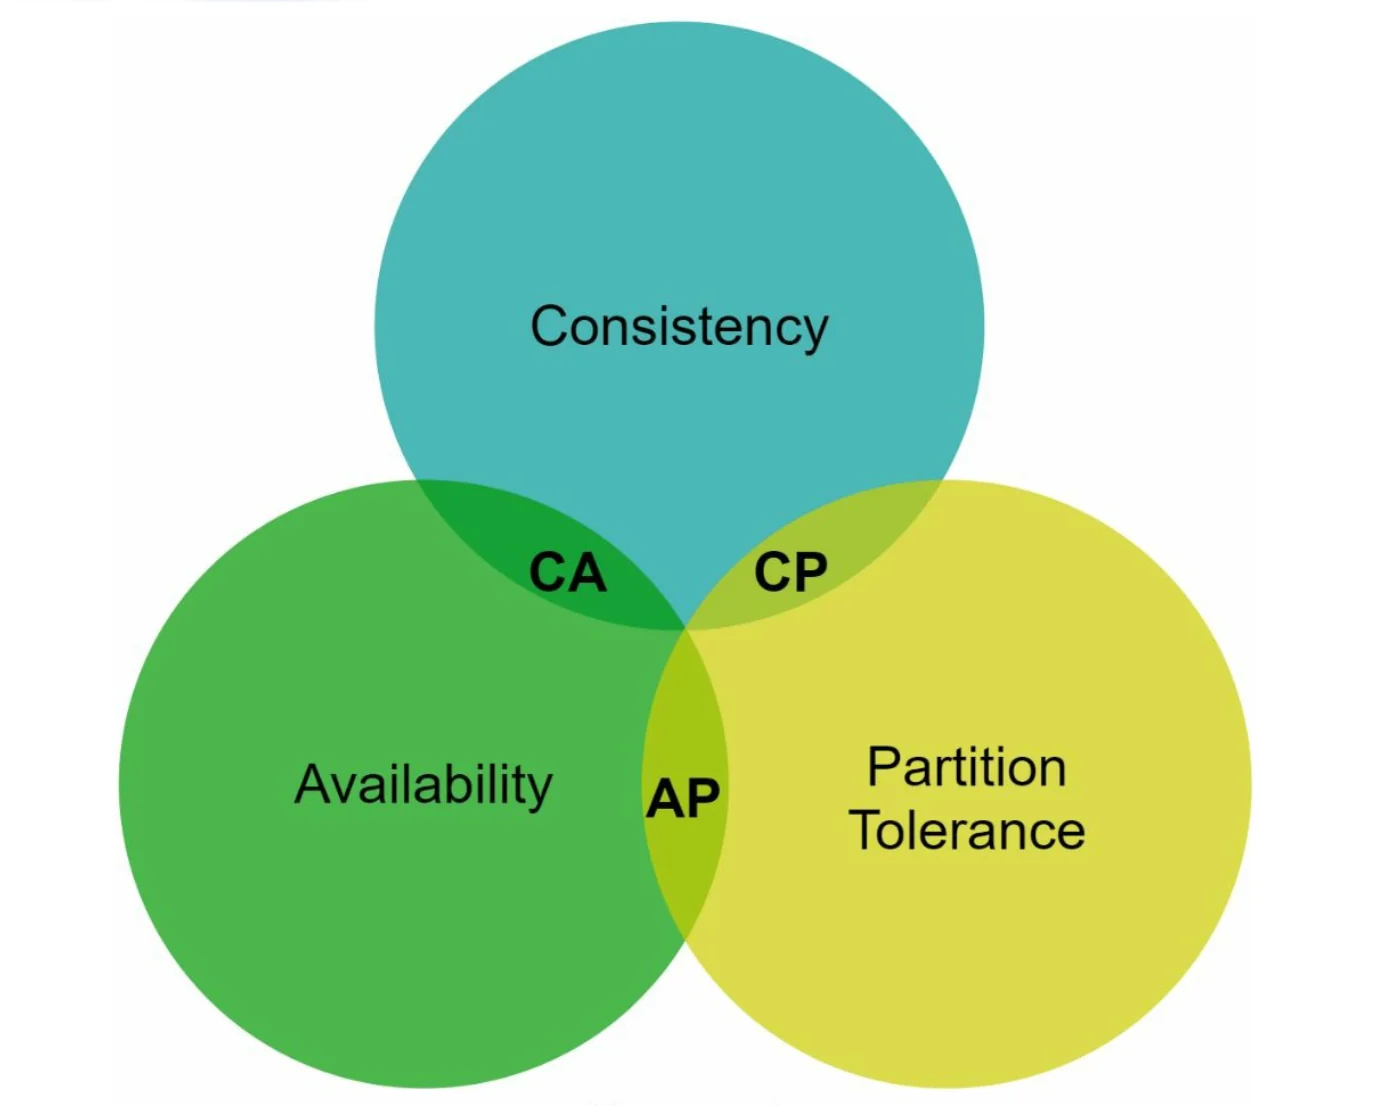
系统类型:
- CP 系统: 保证一致性和分区容错性,牺牲可用性(例如银行系统)。
- AP 系统: 保证可用性和分区容错性,牺牲一致性(例如最终一致性)。
-
CA 系统: 保证一致性和可用性,牺牲分区容错性。
由于网络故障无法避免,分布式系统必须容忍网络分区。因此,CA 系统在现实应用中并不存在。
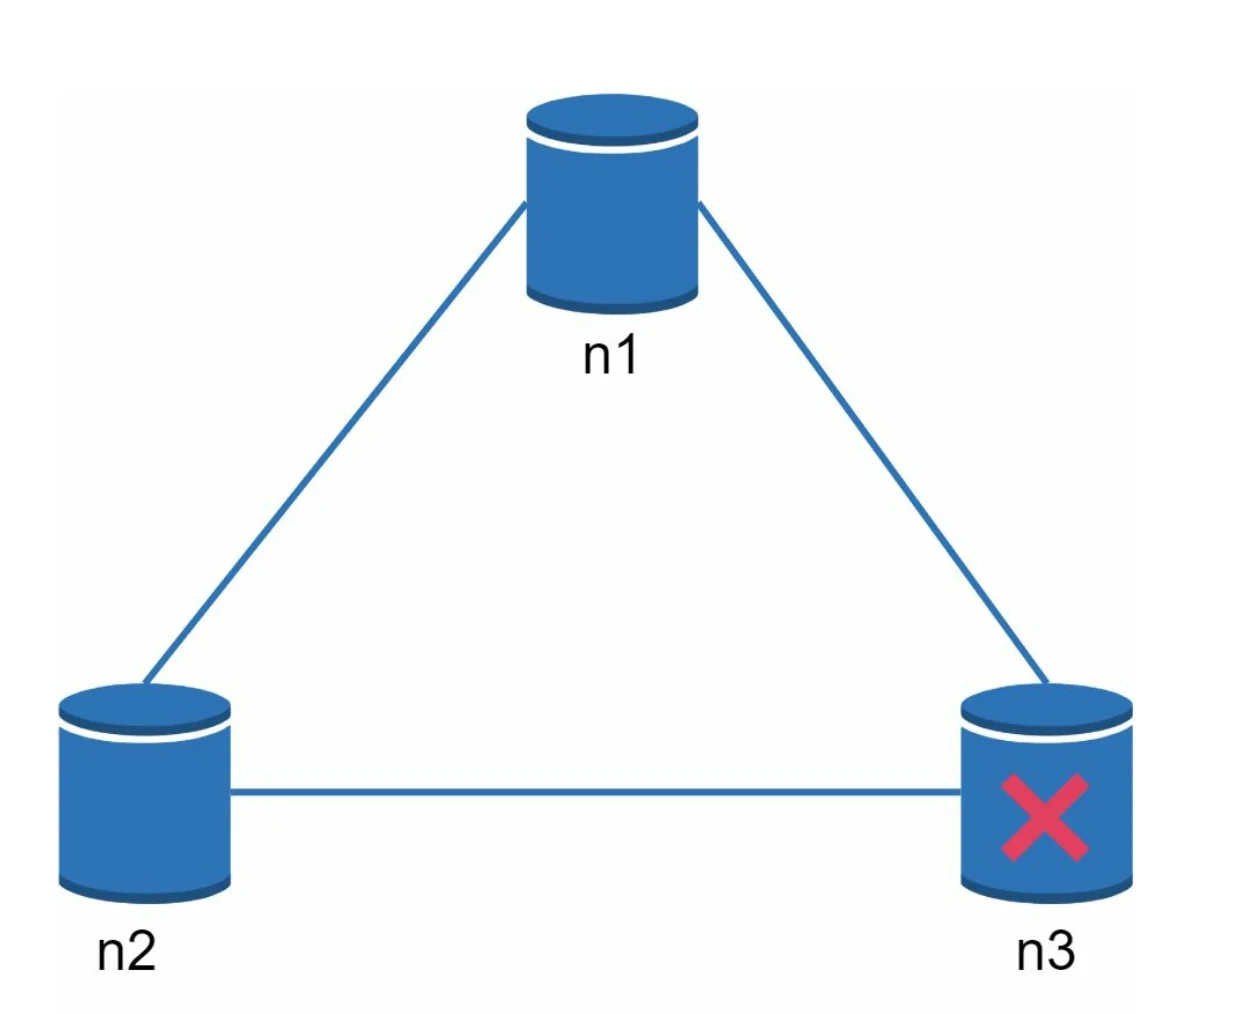
在分布式系统中,分区是不可避免的。发生分区时,我们必须在一致性和可用性之间作出选择。例如,如果节点 n3 宕机, 写入节点 n1 或 n2 的任何数据都无法传播到 n3。反过来,如果数据写入了 n3 但尚未传播到 n1 和 n2,那么 n1 和 n2 上的数据就是过时的。
-
如果选择 CP 系统,就必须阻塞所有对 n1 和 n2 的写操作,以避免数据不一致。
- 如果选择 AP 系统,系统会继续接受读请求,即使可能返回过时的数据。 对于写操作,n1 和 n2 继续接受写入, 等网络分区恢复后,数据会同步到 n3。
系统组件
1. 数据分区
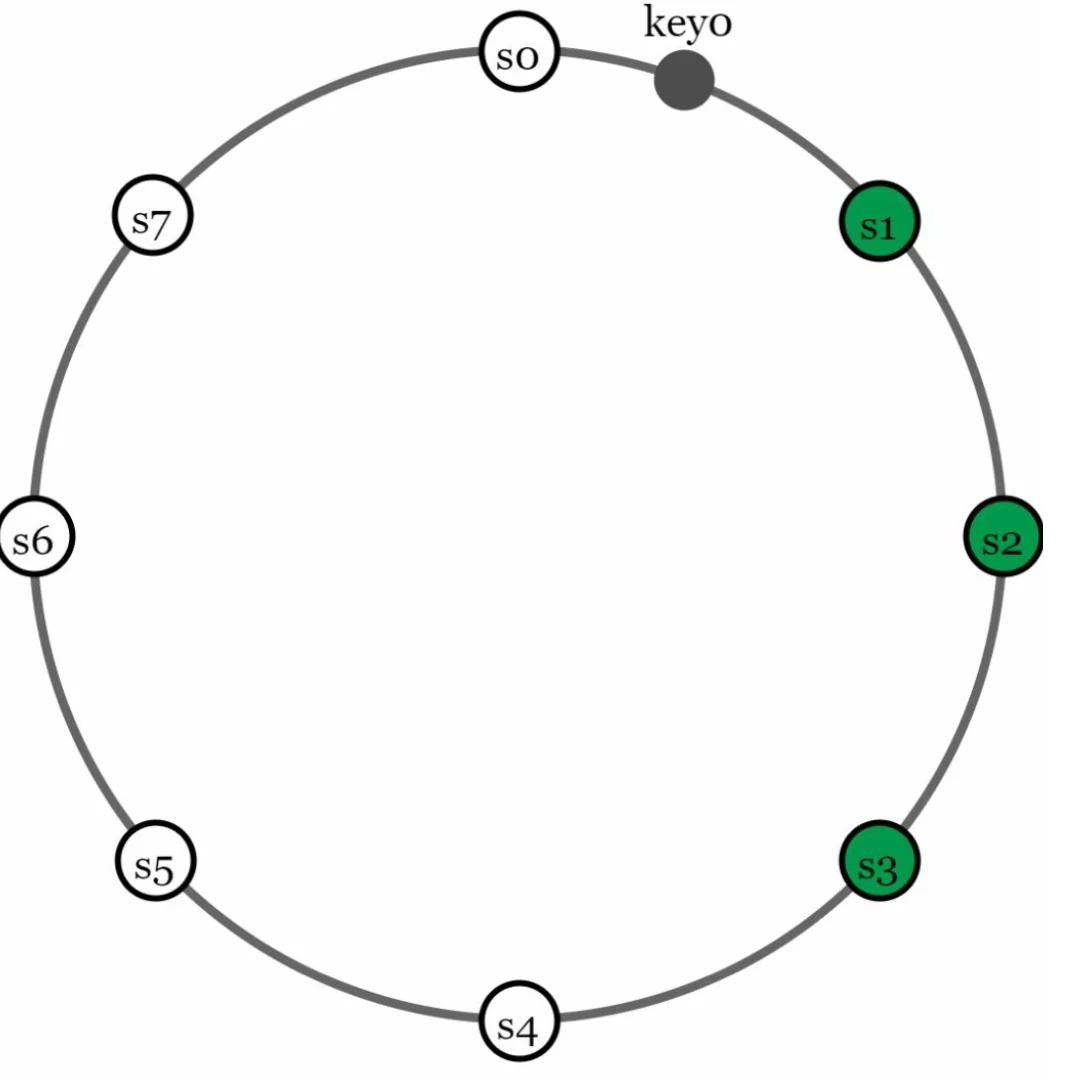
- 技术: 使用一致性哈希把数据均匀地分布到多台服务器上。
- 优点:
- 增加或移除服务器时可以自动扩展。
- 通过虚拟节点支持异构性。一台服务器的虚拟节点数量与该服务器的容量成正比。
2. 数据复制
- 把数据复制到
N台服务器上,以实现高可用。 -
选择这 N 台服务器的方法是:从数据所在位置沿环顺时针前进,选择环上遇到的前 N 台服务器来存储数据副本。在使用虚拟节点的情况下,把副本放在不同的数据中心以提高可靠性。
3. 一致性
由于数据被复制到多个节点上,因此必须在各副本之间进行同步。
-
法定人数共识(Quorum Consensus):
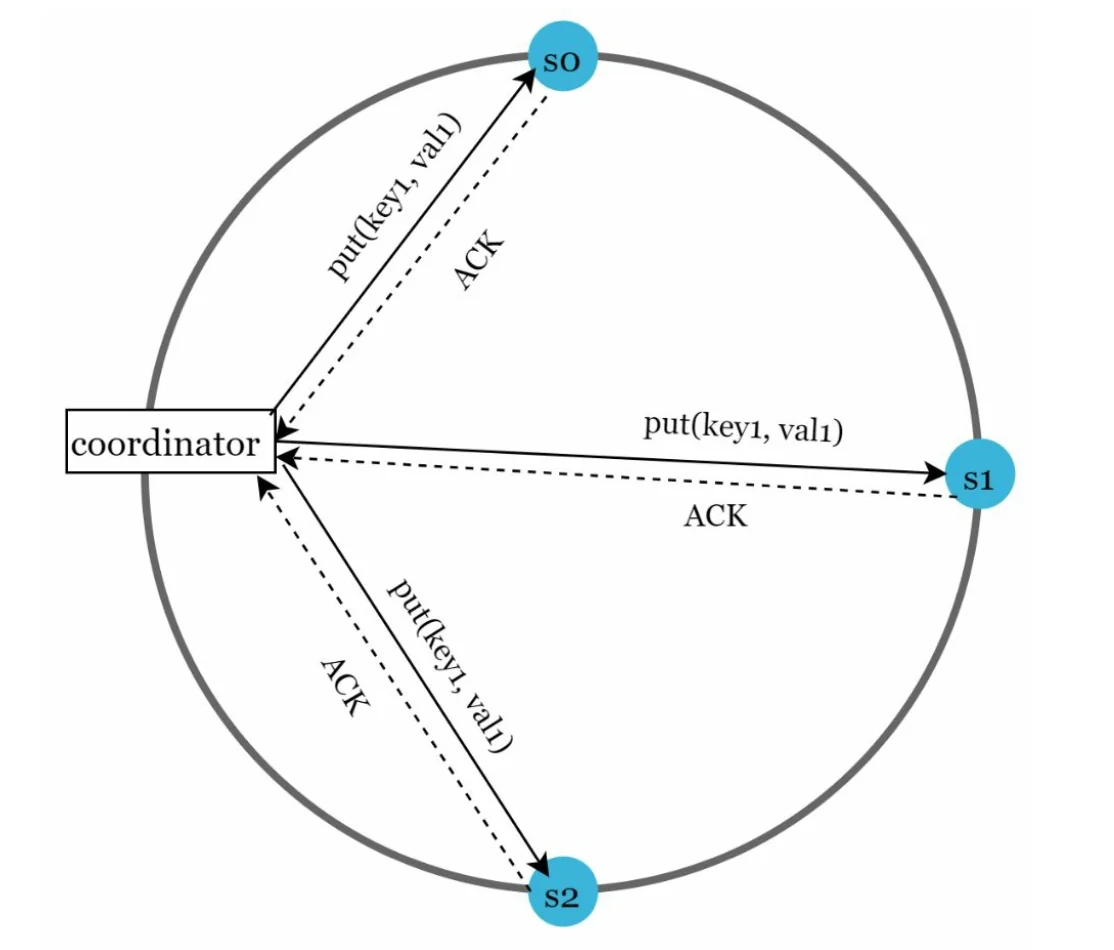
N:副本总数。W:写操作的法定人数。要认定一次写操作成功,必须得到 W 个副本的确认。R:读操作的法定人数。要认定一次读操作成功,必须等待至少 R 个副本的响应。- 规则:
W + R > N可以保证强一致性。 -
W、R 和 N 的配置是延迟与一致性之间的典型权衡。
- 如果 R = 1 且 W = N,系统针对快速读取进行了优化。
- 如果 W = 1 且 R = N,系统针对快速写入进行了优化。
- 如果 W + R > N,可以保证强一致性(通常 N = 3,W = R = 2)。
- 如果 W + R <= N,则无法保证强一致性。
-
一致性模型:
- 强一致性: 读操作返回的值与最新一次写入的数据项的结果一致。
- 弱一致性: 后续的读操作可能看不到最新的值。
- 最终一致性(Eventual Consistency): 只要给予足够的时间,所有更新都会传播出去,所有副本最终达成一致。
4. 不一致的解决
复制带来了高可用,但也会导致副本之间出现不一致。版本控制和向量锁被用来解决不一致问题。
-
版本控制:
- 使用向量时钟(Vector Clock)来跟踪数据版本并解决冲突。
-
版本控制是指把每一次数据修改都视为一个新的、不可变的数据版本。
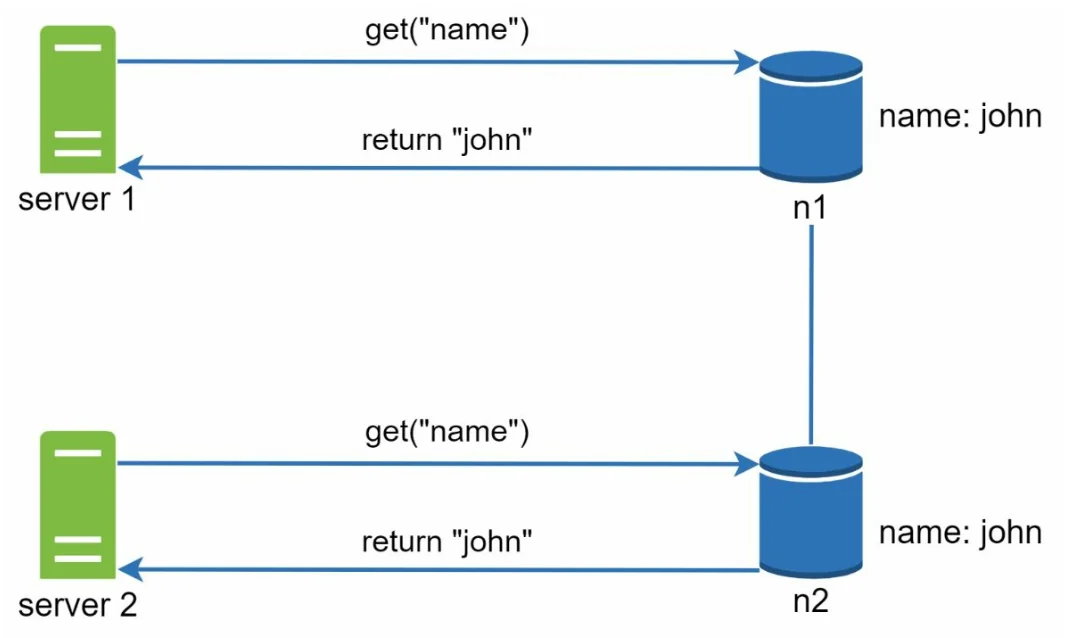
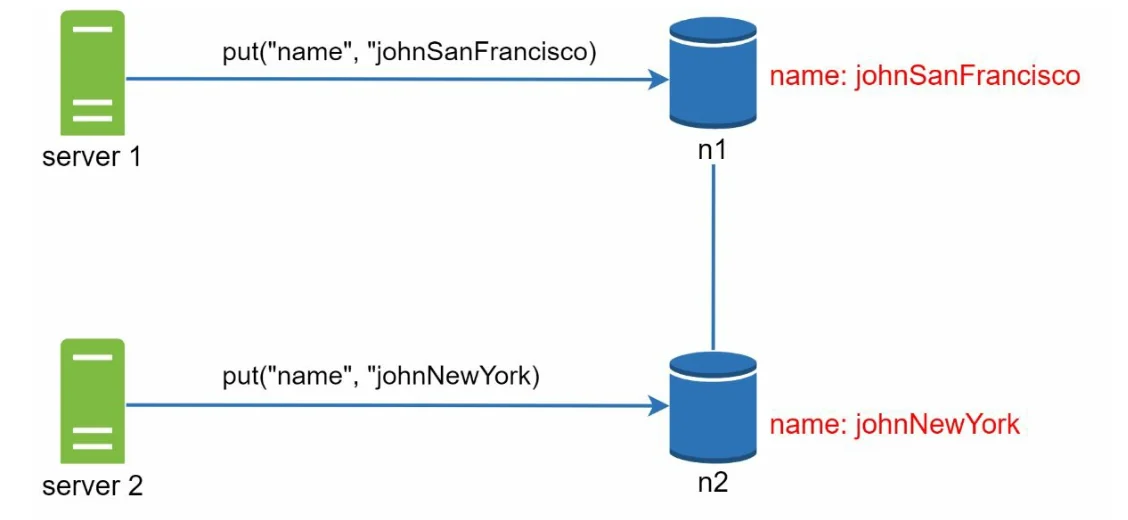
-
服务器 1 修改了 name,服务器 2 也修改了 name。这两次修改是同时进行的。现在我们得到了相互冲突的值,分别称为版本 v1 和 v2。
-
向量时钟
-
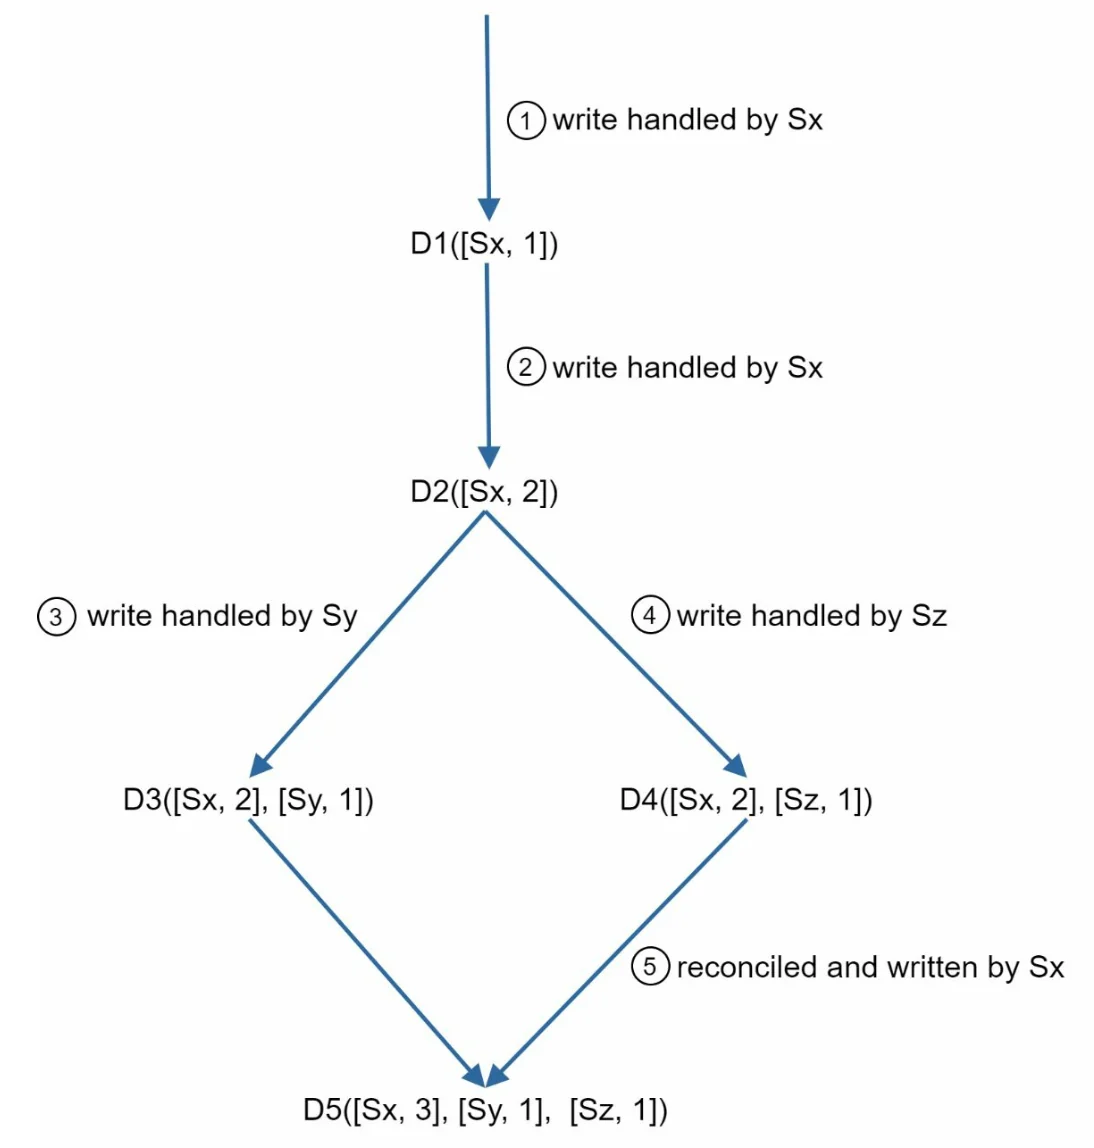
定义:向量时钟是与某个数据项关联的 [服务器, 版本] 对。它可以用来判断一个版本是先于、后于其他版本,还是与其他版本存在冲突。
- 假设向量时钟表示为 D([S1, v1], [S2, v2], …, [Sn, vn]),如果数据项 D 被写入服务器 Si,系统必须执行以下任务之一。
- 其中:
D是数据项。Si是服务器标识。vi是服务器Si上该数据的版本计数器。
-
更新向量时钟: 当某个数据项在一台服务器上被修改时:
- 如果该服务器已存在于向量时钟中,就将其版本计数器加一。
- 否则,在向量时钟中新增一个条目。
-
冲突检测:
- 无冲突: 如果版本 X 中的所有计数器都小于或等于版本 Y 中对应的计数器,那么 X 是 Y 的祖先。
- 存在冲突: 如果 Y 中至少有一个计数器小于 X 中对应的计数器,那么这两个版本互为兄弟版本。
-
冲突解决: 检测到冲突(兄弟版本)时,系统依靠应用特定的逻辑或客户端介入来协调数据。
-
-
挑战:
- 增加了客户端的复杂度。
- 向量时钟的大小可能随着大量更新而增长,需要采用裁剪策略来限制其大小。
5. 故障处理
a. 故障检测
仅仅因为另一台服务器说某台服务器宕机了,就认定它宕机,这是不够的。通常需要至少两个独立的信息来源,才能把一台服务器标记为宕机。
-
Gossip 协议(Gossip Protocol):
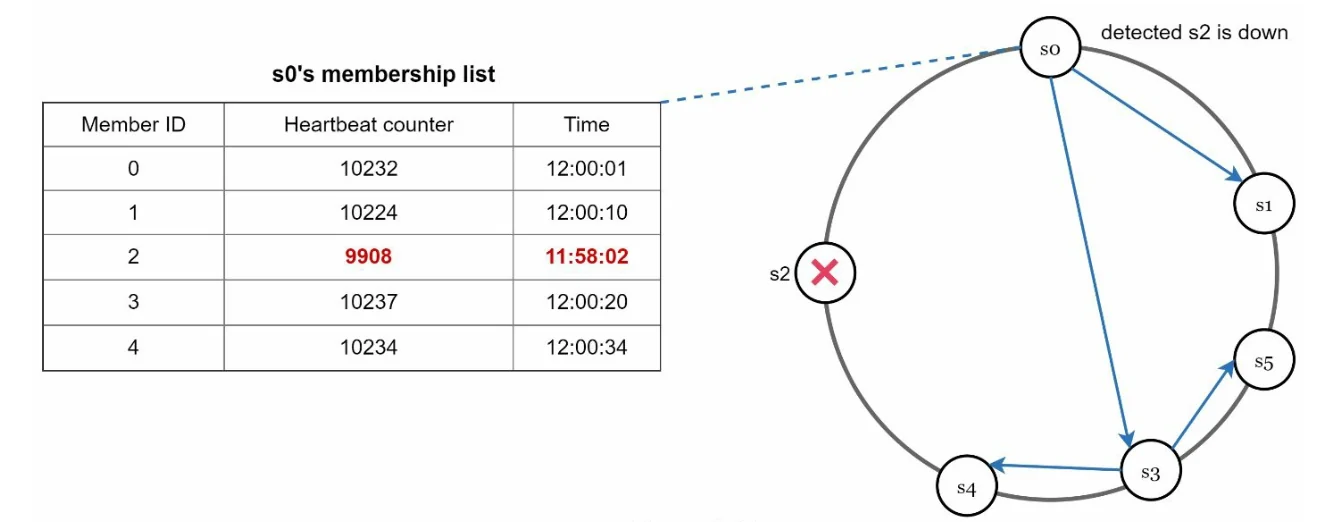
- 每个节点维护一份成员 ID 和心跳计数器的列表。
- 每个节点定期递增自己的心跳计数器。
- 每个节点定期向一组随机节点发送心跳。
- 如果某个成员的心跳在超过预定义的时间段内都没有增加,该成员就被视为离线。
b. 临时故障
-
宽松法定人数(Sloppy Quorum): 临时使用健康的节点来维持运行。
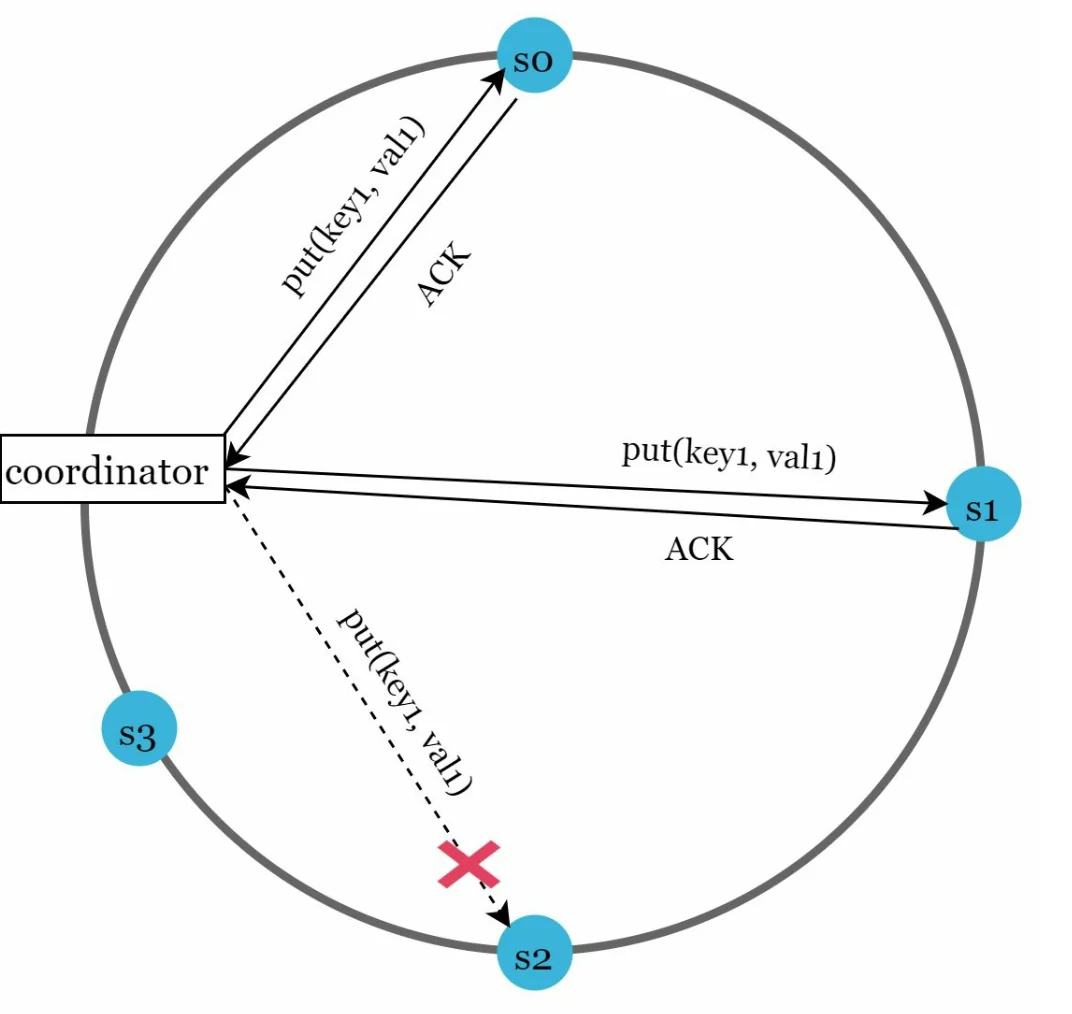
- 检测到故障后,系统需要部署一些机制来保证可用性。
- 系统不再强制执行法定人数要求,而是在哈希环上选择前 W 台健康的服务器进行写操作,选择前 R 台健康的服务器进行读操作。
- 离线的服务器会被忽略。如果某台服务器不可用,会由另一台服务器临时处理请求。
-
提示移交(Hinted Handoff): 离线的服务器恢复后会补上期间的变更。
- 当宕机的服务器恢复后,变更会被推送回去,以实现数据一致性。
c. 永久故障
-
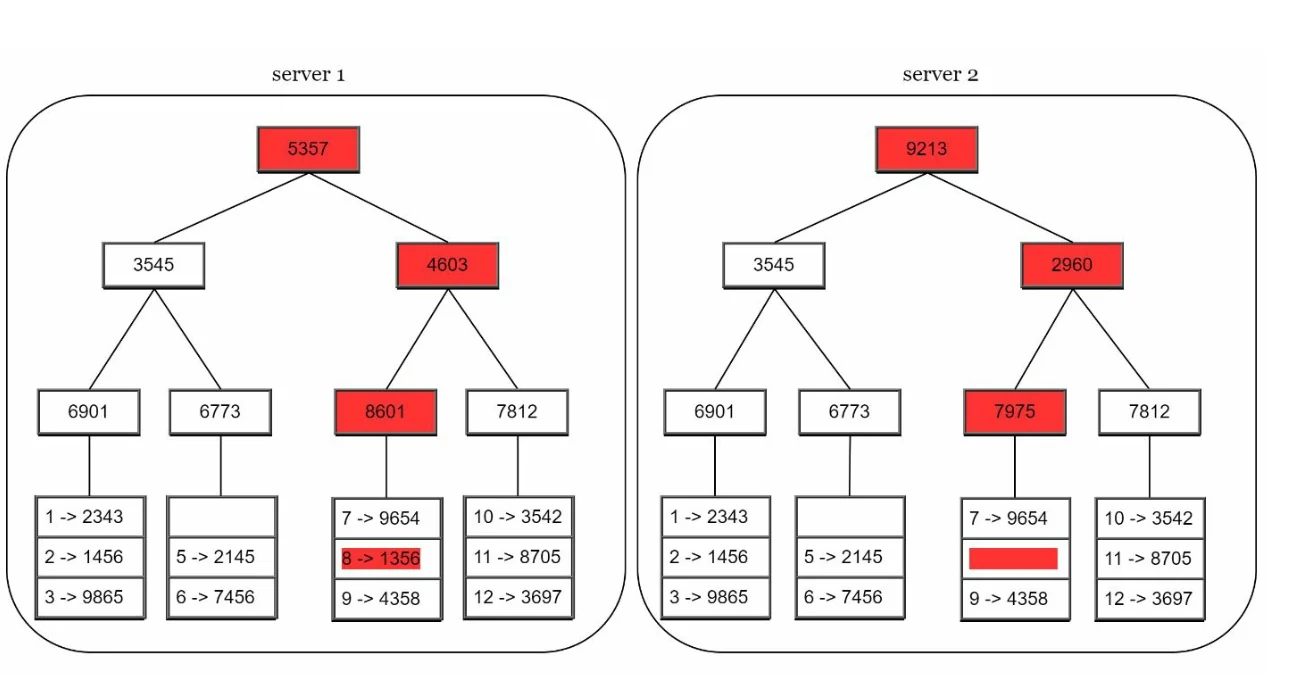
使用 Merkle 树(Merkle Tree) 在副本之间进行高效同步。 Merkle 树(又称哈希树)是一种数据结构,用于在发生永久故障时高效地检测并解决副本之间的不一致。
-
工作原理
-
结构:
- 叶子节点存储单个数据块的哈希值。
- 非叶子节点存储其子节点的哈希值。
- 根哈希代表树中所有数据的整体状态。
-
构建 Merkle 树:
-
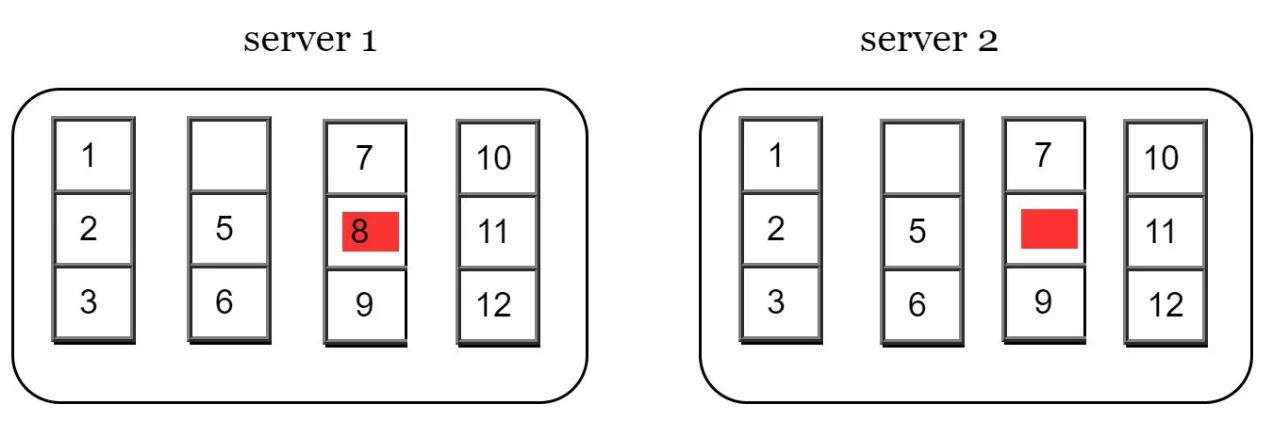
第 1 步: 把键空间划分为多个桶。
-
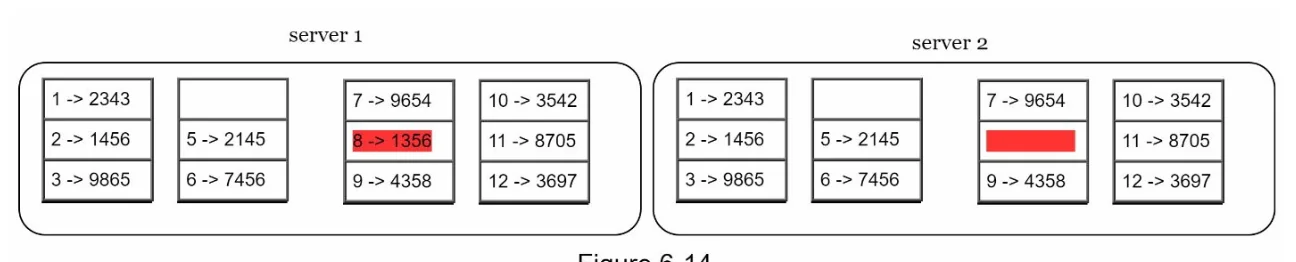
第 2 步: 使用统一的哈希方法对桶中的每个键进行哈希。
-
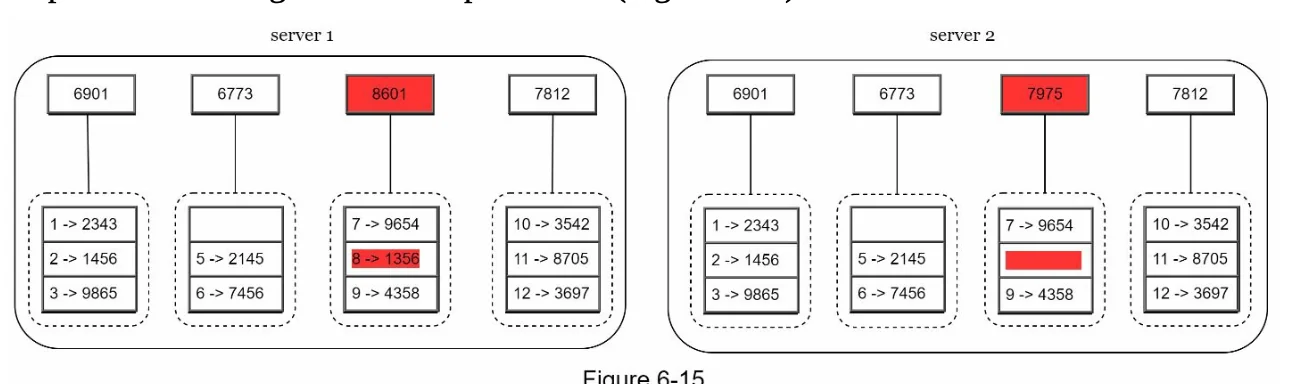
第 3 步: 为每个桶生成一个哈希值。
-
第 4 步: 合并各个桶的哈希值来计算更上层的哈希值,最终得到根哈希。
-
-
同步:
- 同步两个副本的步骤:
- 比较它们的根哈希。
- 如果根哈希相同,说明两个副本一致。
- 如果根哈希不同,就递归比较子节点的哈希值,找出不一致的桶。
- 只同步不一致的数据。
- 同步两个副本的步骤:
-
-
优点
- 高效: 只同步不一致的数据,减少了数据传输量。
- 可扩展: 对大规模数据集同样有效,同步开销极小。
- 可靠: 保证各副本之间的数据一致性。
6. 处理数据中心故障
- 把数据复制到多个数据中心,以保证在故障期间的可用性。
写入路径与读取路径
1. 写入路径(基于 Cassandra 架构)
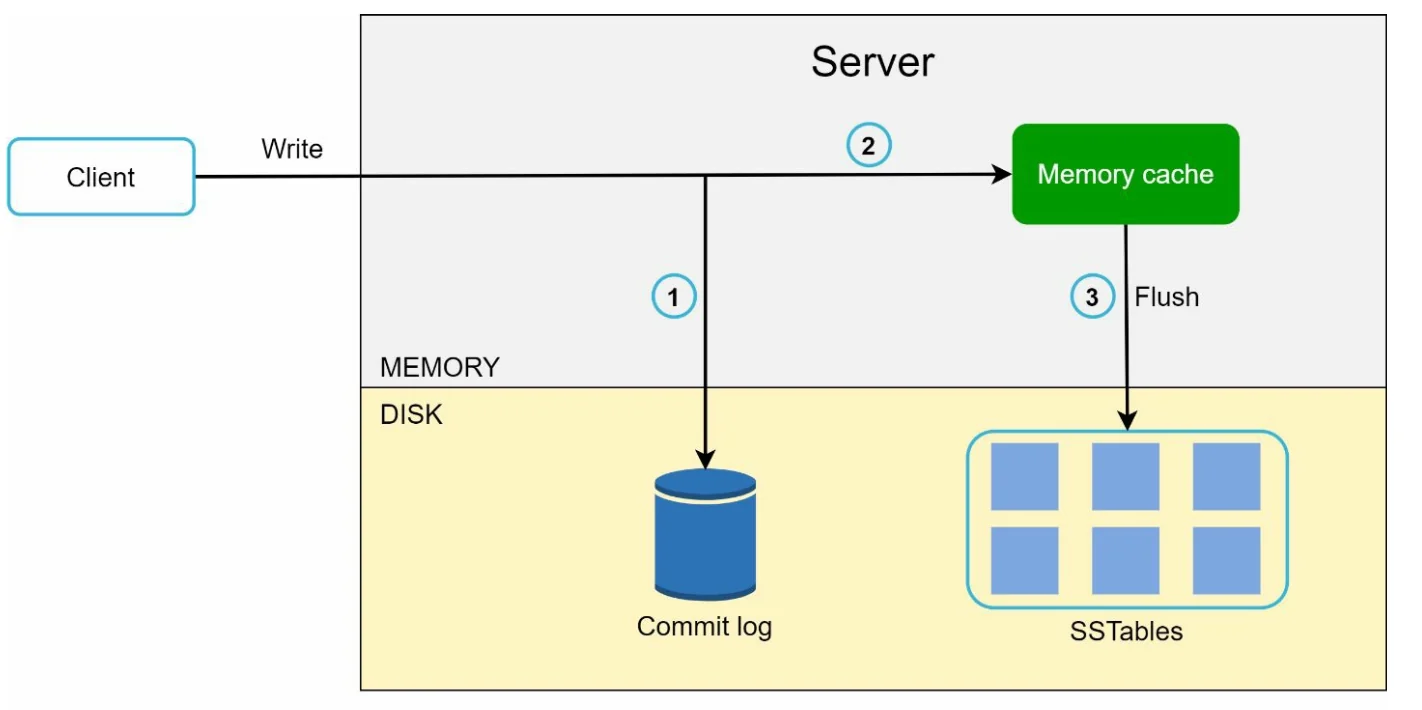
- 把写操作持久化到提交日志(commit log)中。
- 把数据保存到内存缓存中。
- 当缓存满了时,把数据刷写到磁盘上的 SSTable(Sorted String Table,有序字符串表)中。
2. 读取路径
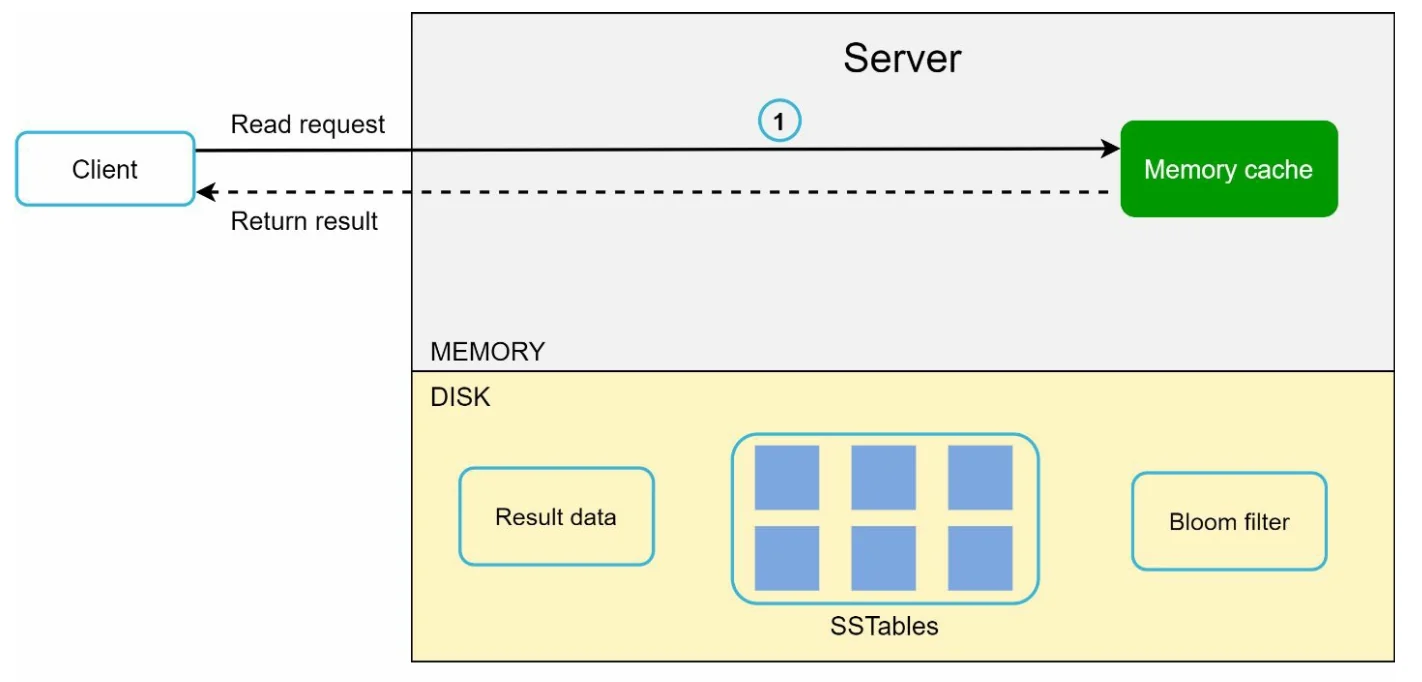
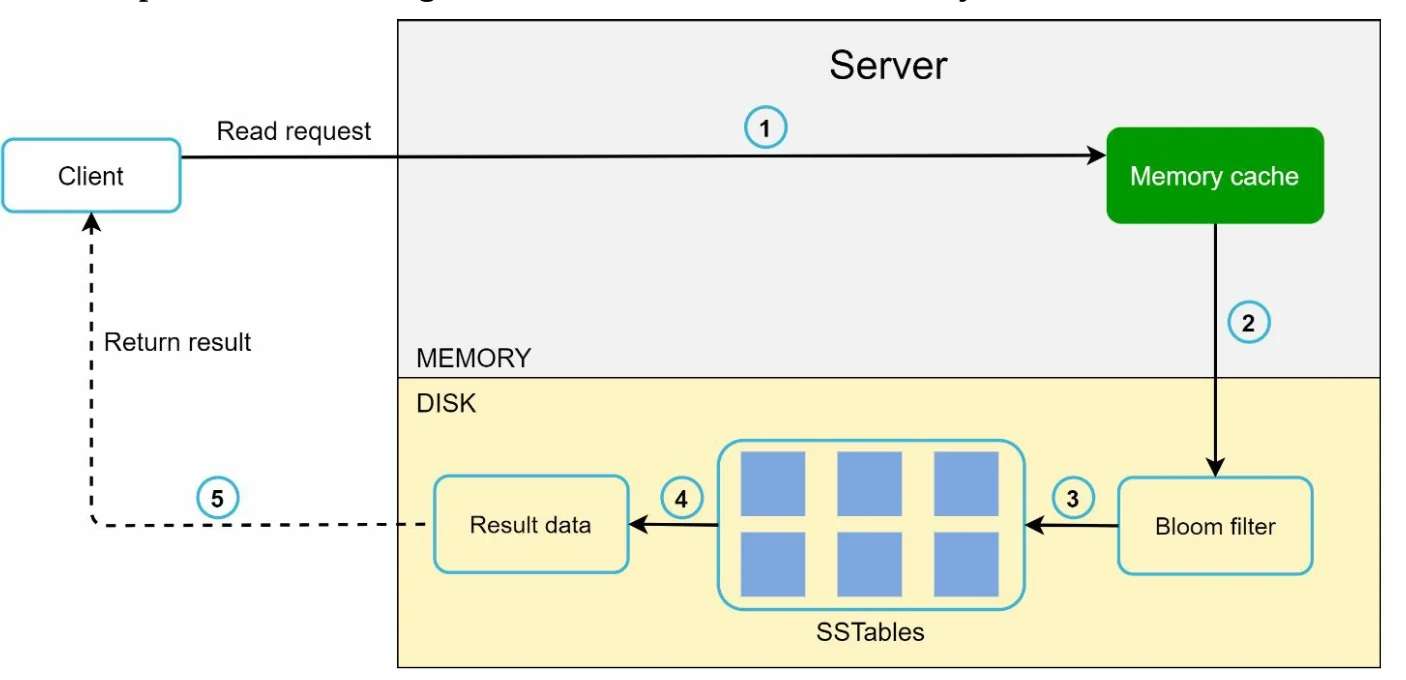
- 先在内存缓存中查找数据。
- 如果不在缓存中,使用布隆过滤器(Bloom Filter)定位数据所在的 SSTable。
- 获取数据并返回。
最终架构
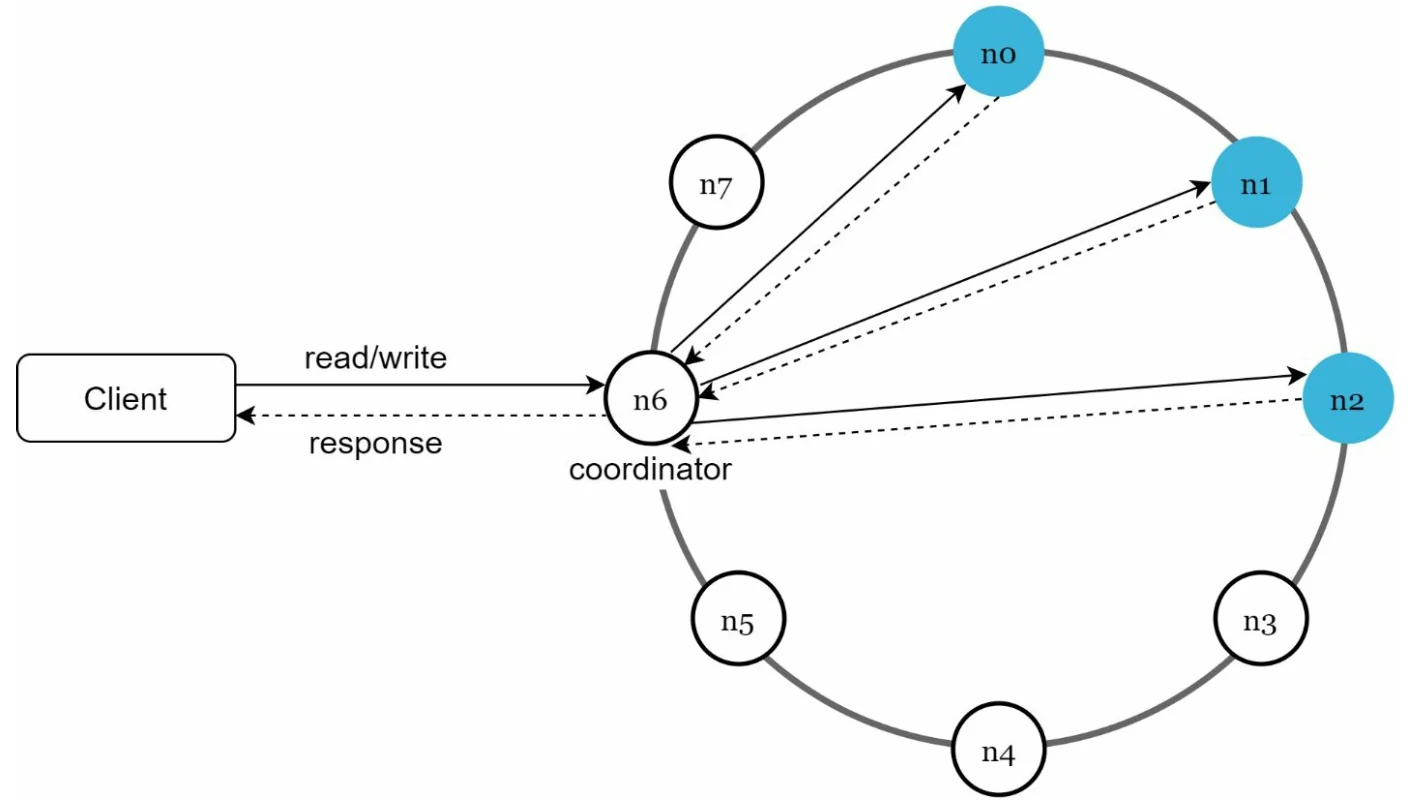
-
客户端通过简单的 API 与键值存储通信:get(key) 和 put(key, value)。
-
协调者(coordinator)是一个节点,充当客户端与键值存储之间的代理。
- 节点通过一致性哈希分布在环上。
- 系统完全去中心化,因此增加和移动节点都可以自动完成。
- 数据被复制到多个节点上。
- 由于每个节点承担的职责都相同,因此不存在单点故障。