第 7 章 设计分布式系统中的唯一 ID 生成器
引言
本章讨论如何为分布式系统设计一个唯一 ID 生成器(Unique ID Generator)。由于在可扩展性和同步方面存在困难,传统的自增主键并不适用于分布式环境。本章的重点是生成唯一、可排序的 64 位数字 ID,并满足以下要求:
- ID 必须唯一,并且按日期有序。
- ID 必须能用 64 位表示。
- 系统每秒应能生成超过 10,000 个 ID。
第 1 步:理解问题
基本需求
- ID 必须唯一且为数字,并且能用 64 位表示。
- ID 随时间递增,但不一定严格按
+1递增。 - ID 应能按日期排序。
- 系统必须支撑高吞吐量(每秒 10,000 个 ID)。
第 2 步:高层设计方案
1. 多主复制
-
做法: 使用数据库的
auto_increment,并按步长递增(例如有 k 台服务器时每次+k)。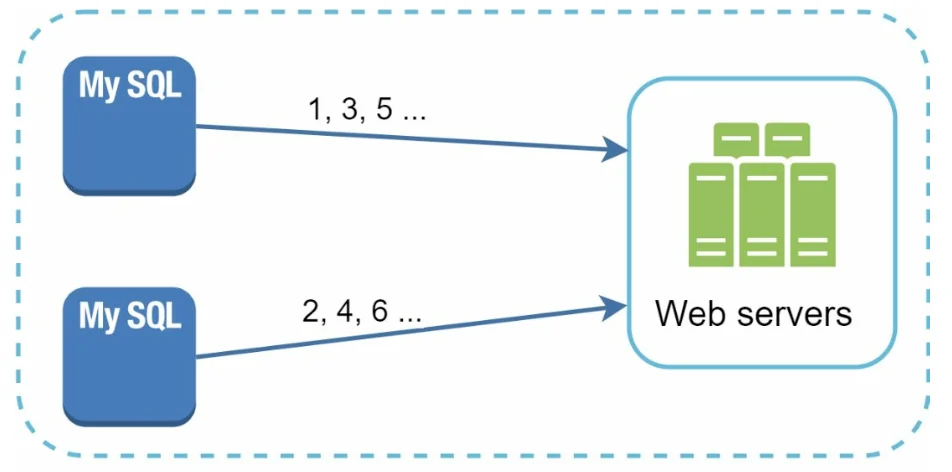
-
缺点:
- 难以跨多个数据中心扩展。
- ID 并不总是随时间递增。
- 增加或移除服务器时存在扩展问题。
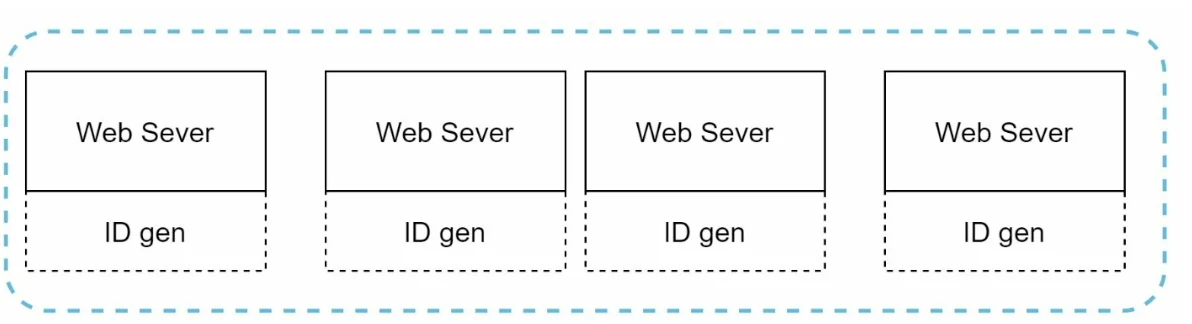
2. UUID(通用唯一识别码,Universally Unique Identifier)
-
做法:
- 在每台服务器上使用 UUID 独立生成 128 位的唯一标识符。
-
UUID 可以独立生成,服务器之间无需协调。
-
优点:
- 服务器之间无需协调。
- 很容易随 Web 服务器一起扩展。
- 缺点:
- 超出了 64 位的要求。
- ID 无法按时间排序,而且可能不是纯数字。
3. 票据服务器
-
做法: 使用一台集中式数据库服务器来递增并分配 ID。
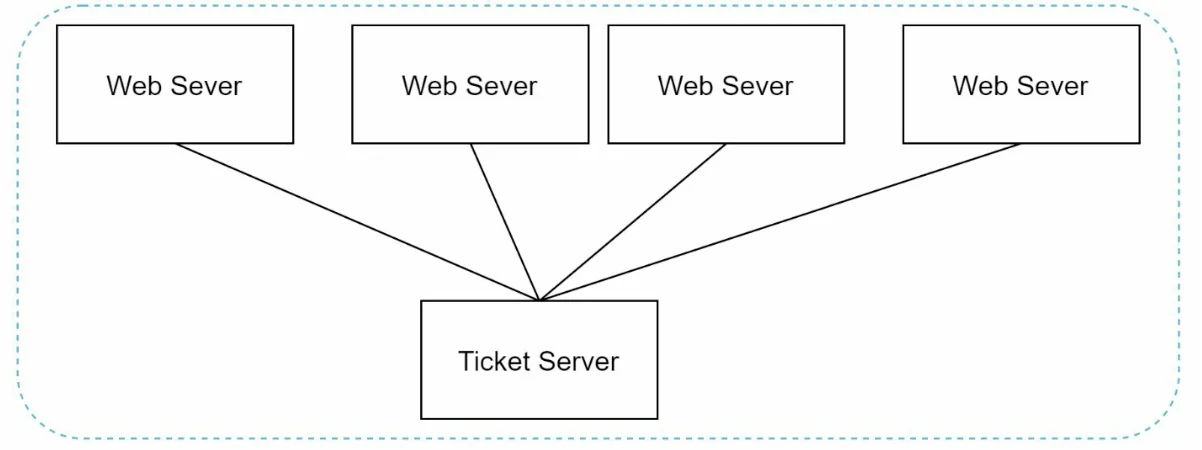
-
优点:
- 对于小规模系统,实现起来很简单。
- 生成的是数字 ID。
- 缺点:
- 存在单点故障。
- 在多服务器部署下存在同步难题。
4. Twitter Snowflake 方案
-
做法:
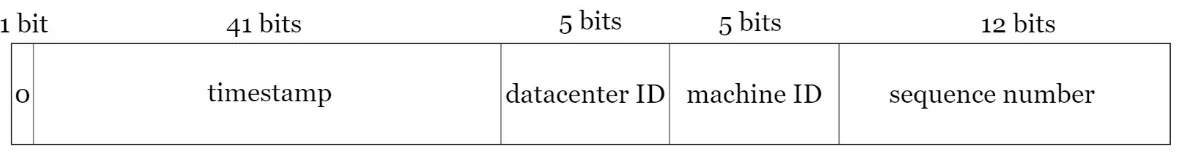
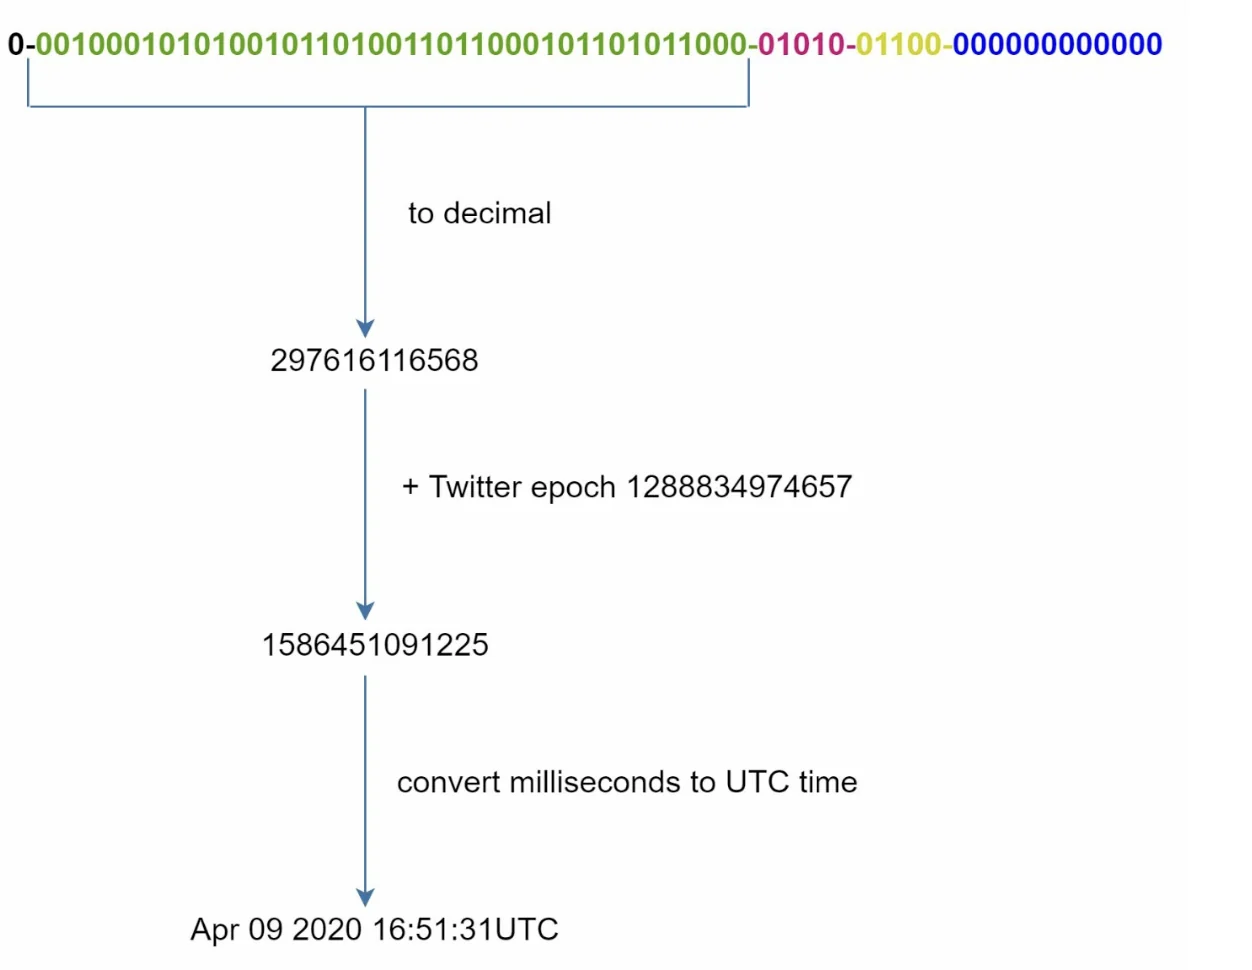
- 把 ID 划分为几个部分,以保证唯一性和可扩展性。
- 符号位(1 位): 始终为
0,可能用于区分有符号数和无符号数。 - 时间戳(41 位): 自定义纪元以来经过的毫秒数(Twitter 的默认纪元是
1288834974657,相当于 UTC 时间 2010 年 11 月 4 日 01:42:54)。它保证了 ID 按时间有序。 - 数据中心 ID(5 位): 最多可以标识
2^5 = 32个数据中心。 - 机器 ID(5 位): 每个数据中心内最多可以标识
2^5 = 32台机器。 - 序列号(12 位): 记录同一台机器在同一毫秒内生成的 ID,每毫秒最多支持
2^12 = 4096个 ID。序列号每毫秒重置为0。
-
优点:
- 可扩展性: 在多台服务器上每秒可生成超过 10,000 个 ID。
- 时间有序: 保证 ID 可以按时间排序。
- 去中心化: 没有单点故障。
第 4 步:其他考虑
1. 时钟同步
- 挑战: ID 生成的前提是各服务器的时钟是同步的。
- 解决方案: 使用网络时间协议(Network Time Protocol,NTP)来尽量减小时钟漂移。
2. 调整各部分的长度
- 根据使用场景调整各部分的长度(例如减少序列号的位数,增加时间戳的位数)。
3. 高可用
- ID 生成器是关键任务组件,必须具备容错能力。
- 需要考虑冗余和故障转移机制。