第 9 章 设计网络爬虫
简介
网络爬虫(Web Crawler),也称为蜘蛛(spider)或机器人(robot),用于发现和收集网络内容,例如网页、图片和视频。本章重点设计一个可扩展的网络爬虫,用于搜索引擎索引(Search Engine Indexing)。
网络爬虫的应用
- 搜索引擎索引: 收集网页以建立可搜索的索引(例如 Googlebot)。
- 网页存档(Web Archiving): 保存网络数据以备将来使用(例如美国国会图书馆)。
- 网络挖掘(Web Mining): 从网络数据中提取知识(例如对股东报告进行财务分析)。
- 网络监控(Web Monitoring): 检测版权或商标侵权行为。
设计挑战
一个好的网络爬虫必须解决以下问题:
- 可伸缩性(Scalability): 通过并行化处理数十亿个网页。
- 健壮性(Robustness): 应对糟糕的 HTML、崩溃和恶意链接。
- 礼貌性(Politeness): 避免用过多请求压垮服务器。
- 可扩展性(Extensibility): 只需极少改动即可支持新的内容类型。
第 1 步:理解问题
需求
- 每月抓取 10 亿个网页(每秒 400 个网页,峰值 800 QPS)。
- 只收集 HTML 内容。
- 追踪新增和更新的网页。
- 忽略重复内容。
- 抓取的数据保存 5 年,约需 30 PB 存储空间。
第 2 步:高层设计
组件
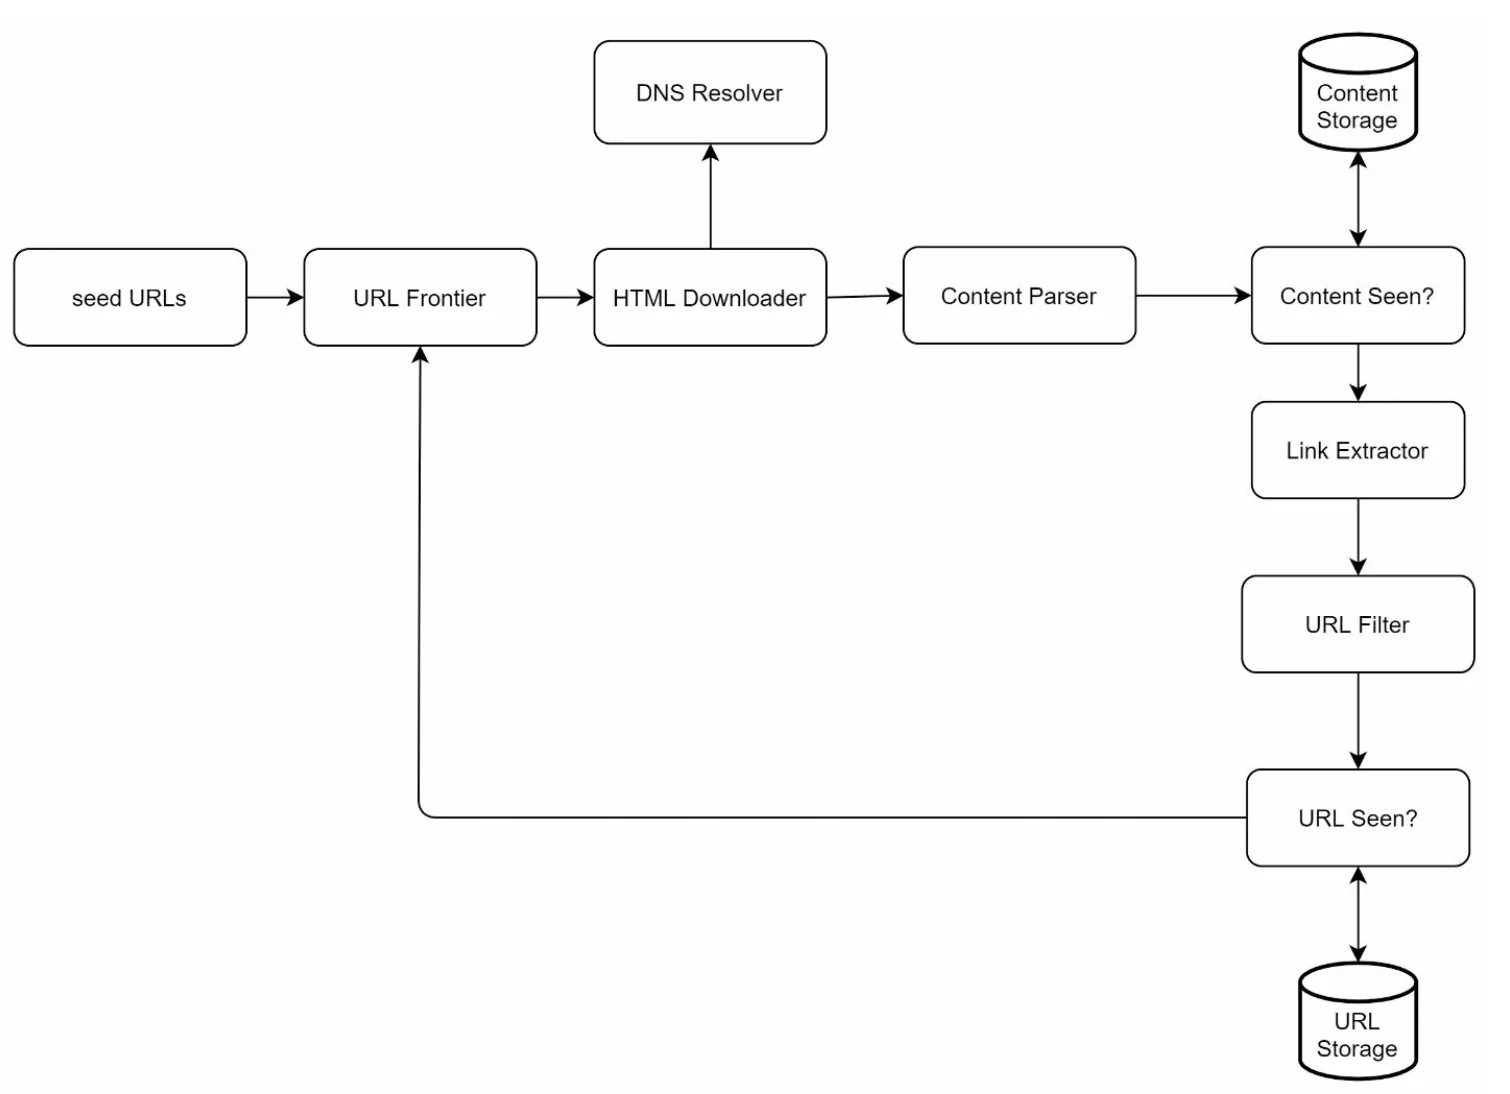
-
种子 URL(Seed URLs): 爬虫的起点。
- 需要精心挑选,作为良好的起点,使爬虫能够借此遍历尽可能多的链接。
- 可以按地域选取不同的热门网站,也可以按主题选取。
- 策略:按地域或主题分类(例如体育、医疗健康)。
-
URL 待抓取队列(URL Frontier): 存储待下载的 URL。
- 实现为一个先进先出(FIFO)队列。
-
HTML 下载器(HTML Downloader): 从 URL 待抓取队列提供的 URL 下载网页。
-
DNS 解析器(DNS Resolver): 将 URL 转换为 IP 地址。
-
内容解析器(Content Parser): 校验并解析网页。
- 丢弃格式错误的网页。
-
内容已见?(Content Seen?): 通过哈希比较检查重复内容(比较两个网页的哈希值)。
-
内容存储(Content Storage): 将 HTML 网页存储在磁盘上(热门内容放在内存中以降低延迟)。
-
URL 提取器(URL Extractor): 从解析后的网页中提取新链接。
-
URL 过滤器(URL Filter): 排除黑名单中的或错误的 URL。
-
URL 已见?(URL Seen?) 记录已访问的 URL,避免重复。
-
URL 存储(URL Storage): 存储已访问过的 URL。
工作流程
- 将种子 URL 加入 URL 待抓取队列。
- HTML 下载器获取 URL,并通过 DNS 解析器解析出其 IP。
- 内容解析器校验内容,并将其交给“内容已见?”组件。
- 如果内容是新的,则通过 URL 提取器提取链接。
- 过滤链接,并将不重复的链接加入 URL 待抓取队列。
第 3 步:深入关键组件
DFS/BFS
- 可以把整个网络看作一张有向图,网页是节点,超链接(URL)是边。
- 图遍历通常使用 BFS,因为深度可能非常深,所以 DFS 并不理想。
- 标准 BFS 不考虑 URL 的优先级,而并非每个网页都具有相同的质量和重要性。
URL 待抓取队列
-
礼貌性:
- 确保同一时间对每个主机只发送一个请求。在两次下载任务之间加入延迟。
- 使用从主机名到队列和工作(下载)线程的映射。
-
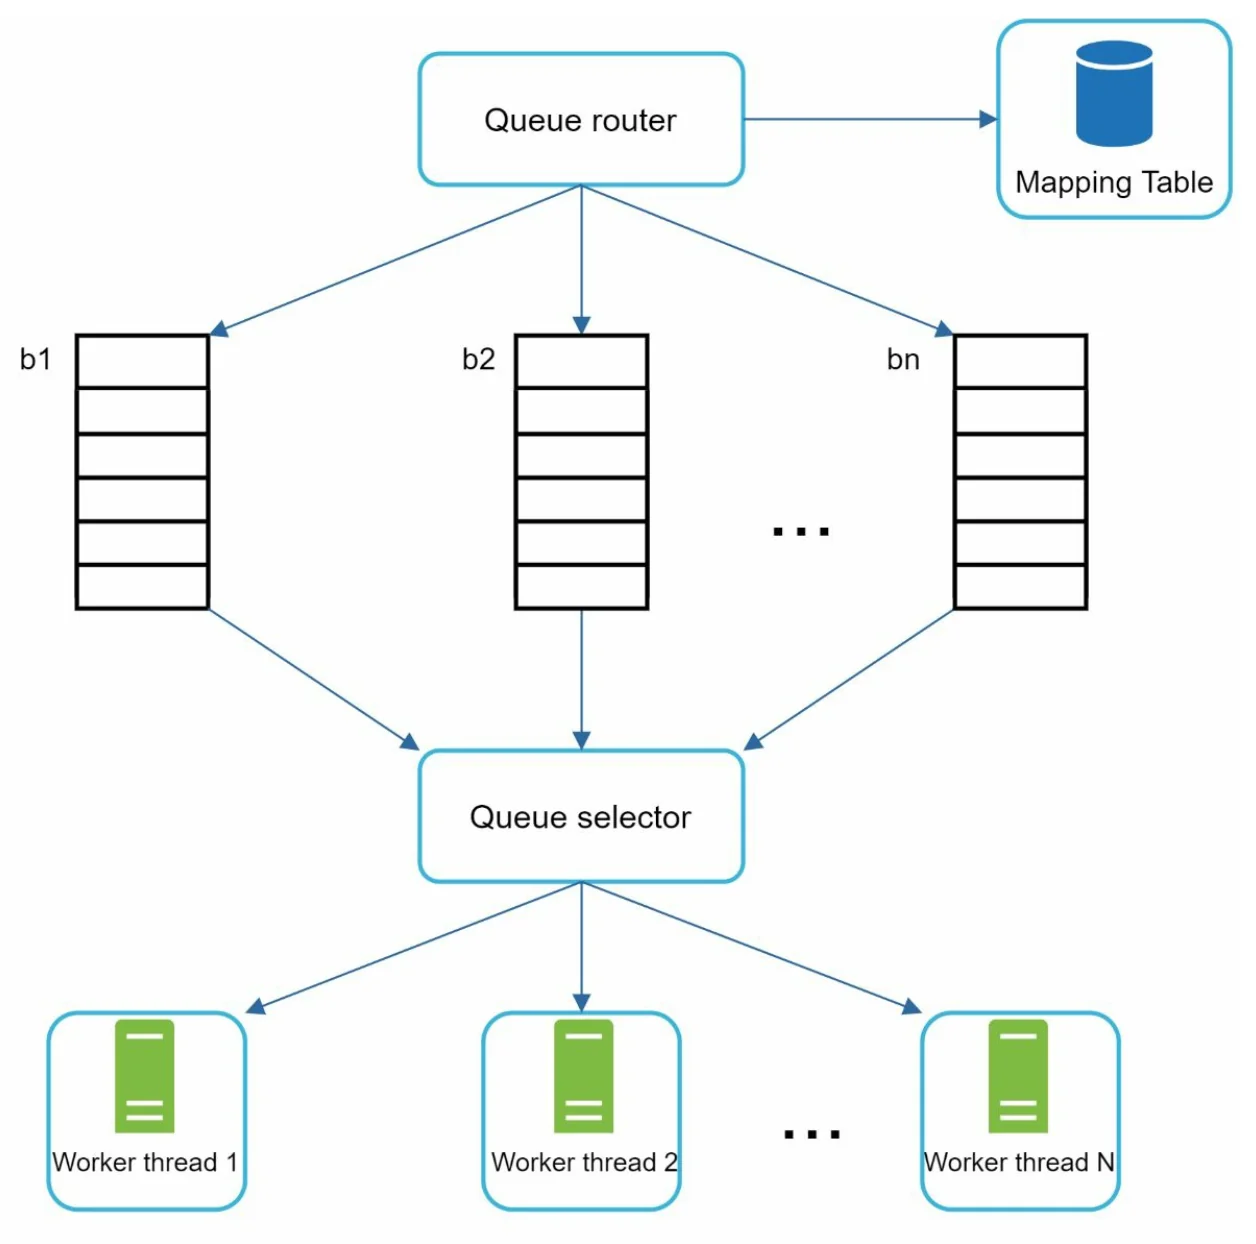
每个下载线程都有一个独立的 FIFO 队列,并且只从该队列下载 URL。
-
队列路由器(Queue router): 确保每个队列(b1、b2、… bn)只包含来自同一主机的 URL。
- 映射表(Mapping table): 将每个主机映射到一个队列。
- 队列选择器(Queue selector): 每个工作线程映射到一个 FIFO 队列,并且只从该队列下载 URL。队列选择逻辑由队列选择器完成。
- 工作线程 1 到 N。 一个工作线程按顺序下载来自同一主机的网页。两次下载任务之间可以加入延迟。
-
优先级(Priority):
-
为重要网页分配更高的优先级(例如依据 PageRank 或更新频率)。
-
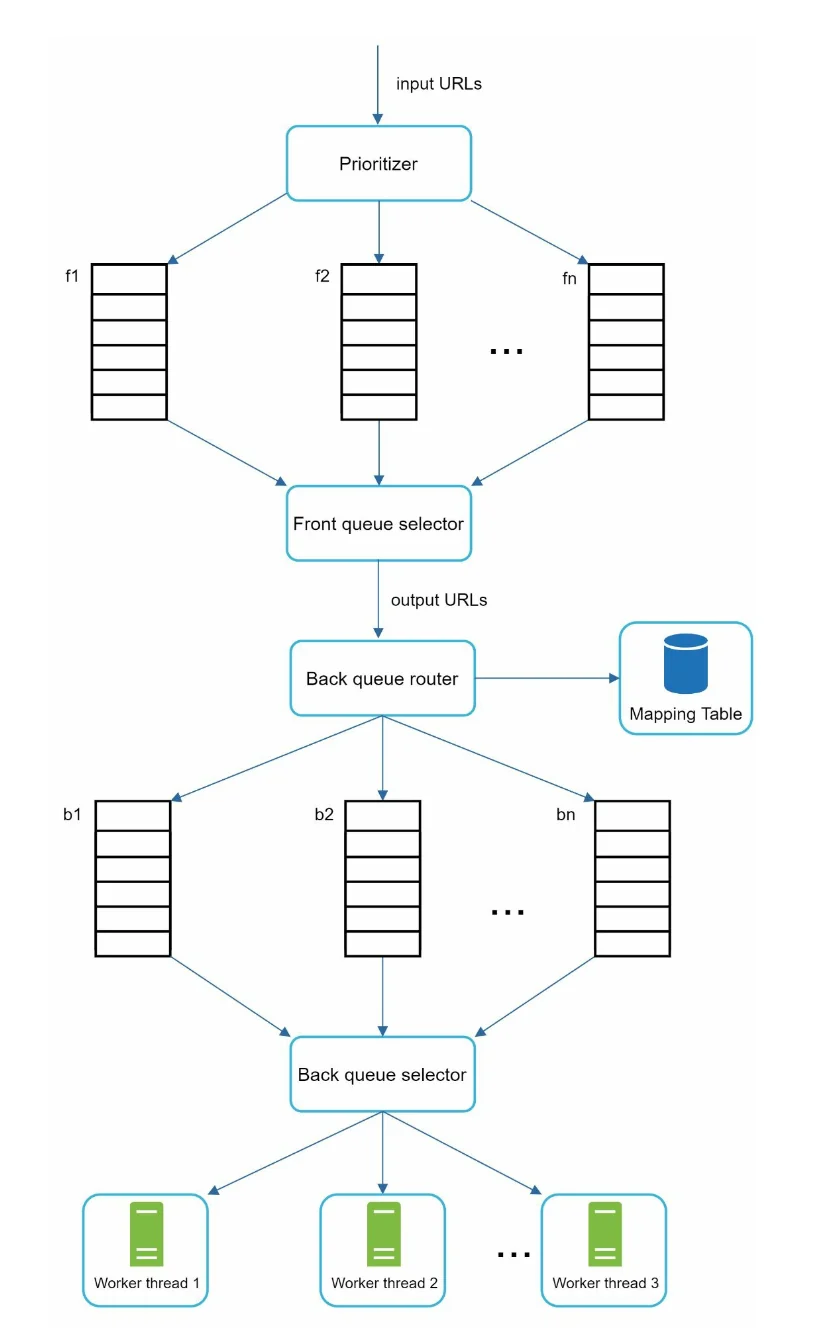
优先级计算器(Prioritizer): 以 URL 为输入,计算其优先级。
- 队列 f1 到 fn: 每个队列都被分配了一个优先级。高优先级的队列被选中的概率更高。
- 队列选择器: 随机选择一个队列,但偏向优先级更高的队列。
- 前端队列(Front queues): 管理优先级
- 后端队列(Back queues): 管理礼貌性
-
-
新鲜度(Freshness): 根据更新历史或重要性重新抓取。
HTML 下载器
- 遵守 Robots.txt: 遵守 robots.txt 文件中的规则。
- 性能优化:
- 使用多台服务器进行分布式抓取。
- 使用 DNS 缓存,避免重复查询。
- 在地理上分散部署抓取服务器,以加快下载速度。
- 使用较短的超时时间,避开缓慢或无响应的服务器。
健壮性
- 一致性哈希(Consistent Hashing): 在服务器之间有效地分配负载。
- 错误处理: 防止异常导致系统崩溃。
- 数据校验: 确保内容的完整性。
可扩展性
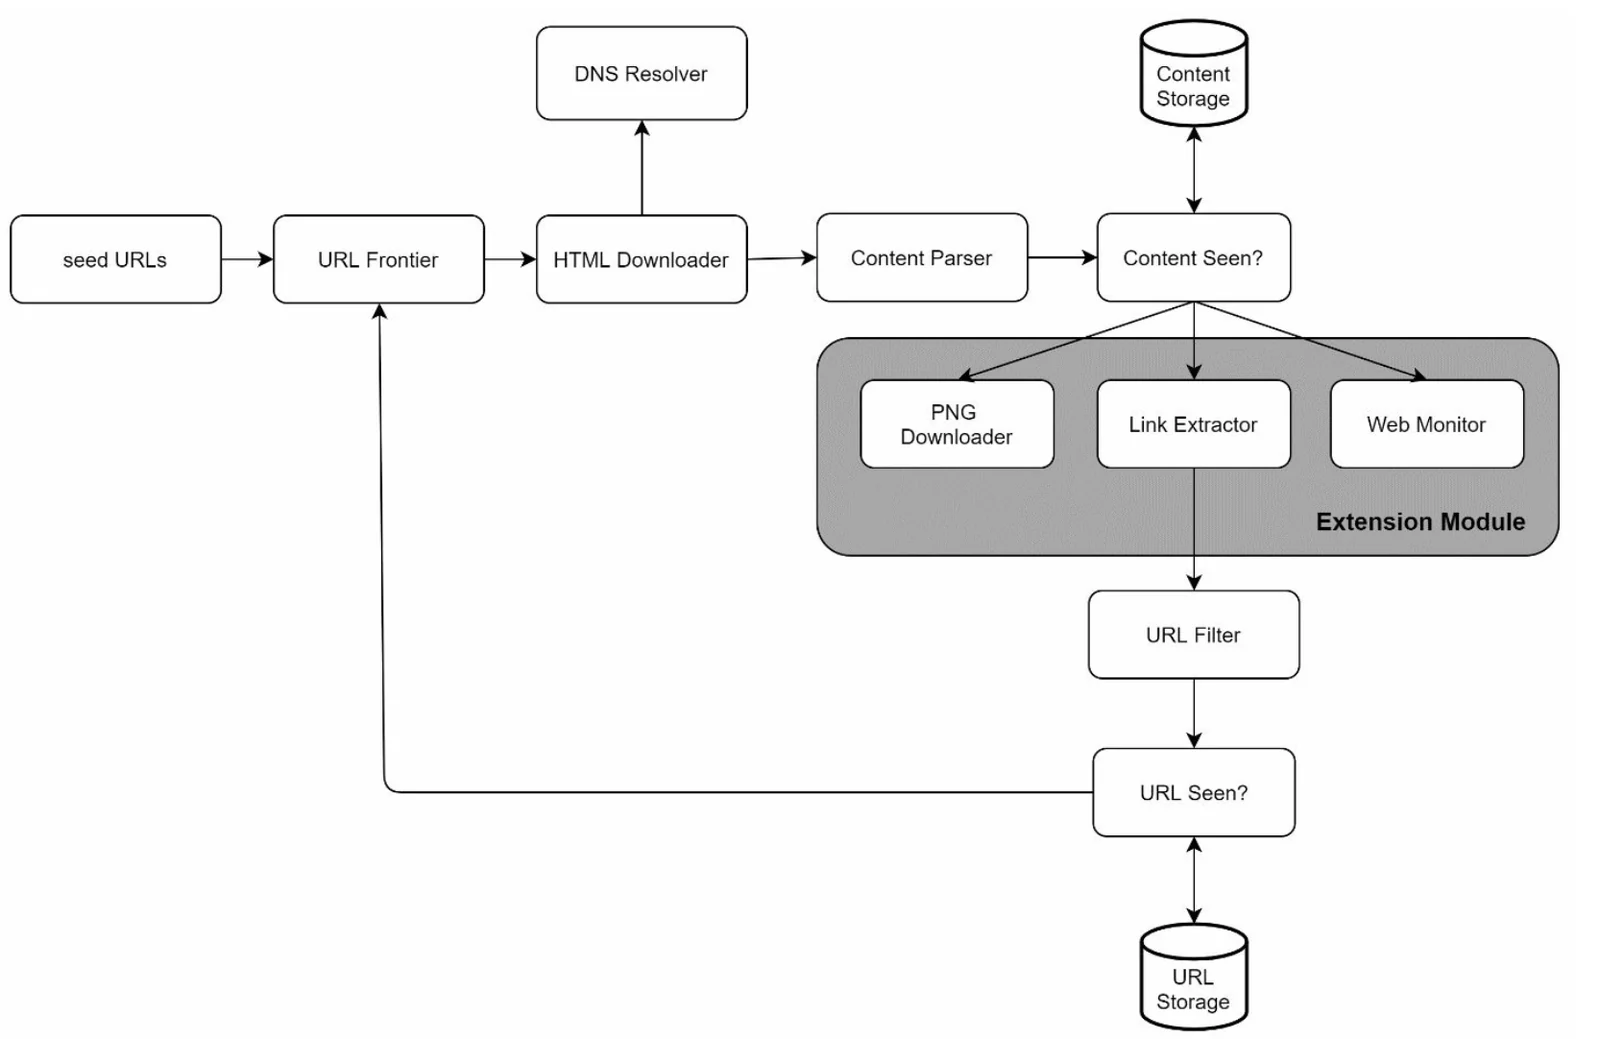
- 为新的内容类型添加模块(例如 PNG 下载器、网页监控器)。
-
示例:插入一个模块来监控网页内容是否存在侵犯版权的情况。
避开有问题的内容
- 重复内容: 通过哈希比较来检测。
- 爬虫陷阱(Spider Traps): 通过限制 URL 长度等技术避免无限循环。
- 数据噪声: 过滤广告或垃圾信息等无关内容。
第 4 步:总结
要点回顾
- 网络爬虫必须在可伸缩性、健壮性、礼貌性和可扩展性之间取得平衡。
- 礼貌性防止服务器过载,而优先级确保重要网页被优先抓取。
- 高效的存储和错误处理对于大规模抓取至关重要。
其他考虑因素
- 服务端渲染(Server-Side Rendering): 处理由 JavaScript 或 AJAX 生成的动态内容。
- 反垃圾措施: 排除低质量或无关的网页。
- 数据库分片: 通过复制和分片来扩展数据层。
- 水平扩展: 使用无状态服务器高效地扩展抓取任务。
- 分析: 收集并分析数据以获取洞察。