第 11 章 设计信息流系统
简介
信息流系统(News Feed System)展示一个持续更新的列表,内容是用户的好友或关注对象发布的帖子(状态更新、照片、视频和链接)。例如 Facebook 的动态消息(news feed)、Instagram 的信息流和 Twitter 的时间线。本章探讨如何设计一个可扩展的信息流系统。
第 1 步:理解问题
需求
- 平台: 系统同时支持 Web 和移动应用。
- 功能:
- 用户可以发布帖子。
- 用户可以在自己的信息流中查看好友的帖子。
- 排序: 为简单起见,信息流按时间倒序(reverse chronological order)排列。
- 规模:
- 每个用户最多可以有 5,000 个好友。
- 1000 万日活跃用户(DAU)。
- 信息流中可能包含文本、图片和视频。
第 2 步:高层设计
概述
该设计包含两个主要流程:
- 信息流发布(Feed Publishing): 用户发布一条帖子,帖子被写入数据库,并传播到其好友的信息流中。
- 信息流构建(News Feed Building): 用户获取自己的信息流,系统将好友的帖子按时间倒序聚合起来。
信息流 API
-
信息流发布 API:
- 端点:
POST /v1/me/feed - 参数:
content(帖子文本)和auth_token(身份认证)。
- 端点:
-
信息流获取 API:
- 端点:
GET /v1/me/feed - 参数:
auth_token(身份认证)。
- 端点:
信息流发布
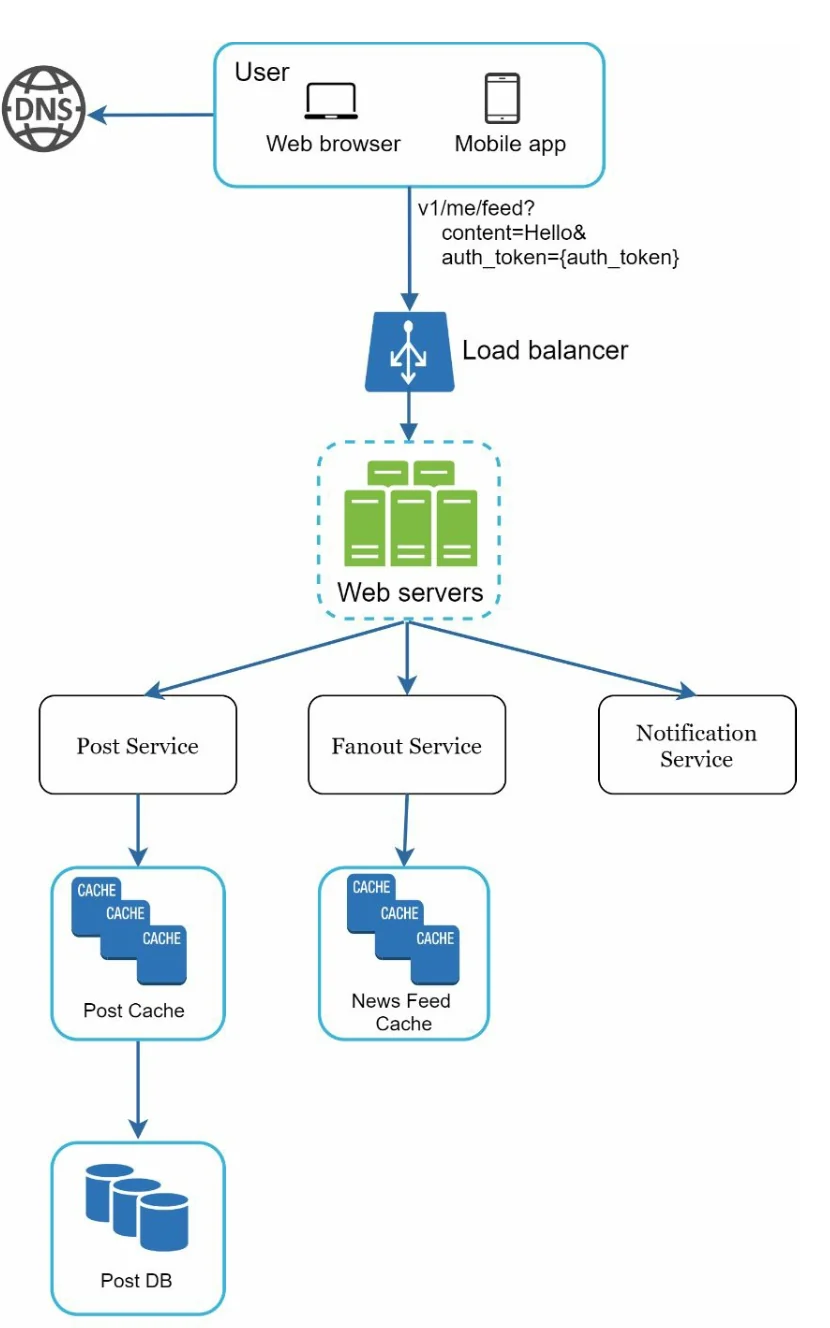
- 用户交互: 用户通过信息流发布 API 发布一条帖子。
- 负载均衡器(Load Balancer): 将流量分发到 Web 服务器。
- Web 服务器: 对请求进行身份认证,并将其转发到相应的服务。
- 帖子服务(Post Service): 将帖子存储到数据库和缓存中。
- 扇出服务(Fanout Service): 将帖子传播到缓存中好友的信息流里。
- 通知服务(Notification Service): 向好友发送通知。
信息流构建
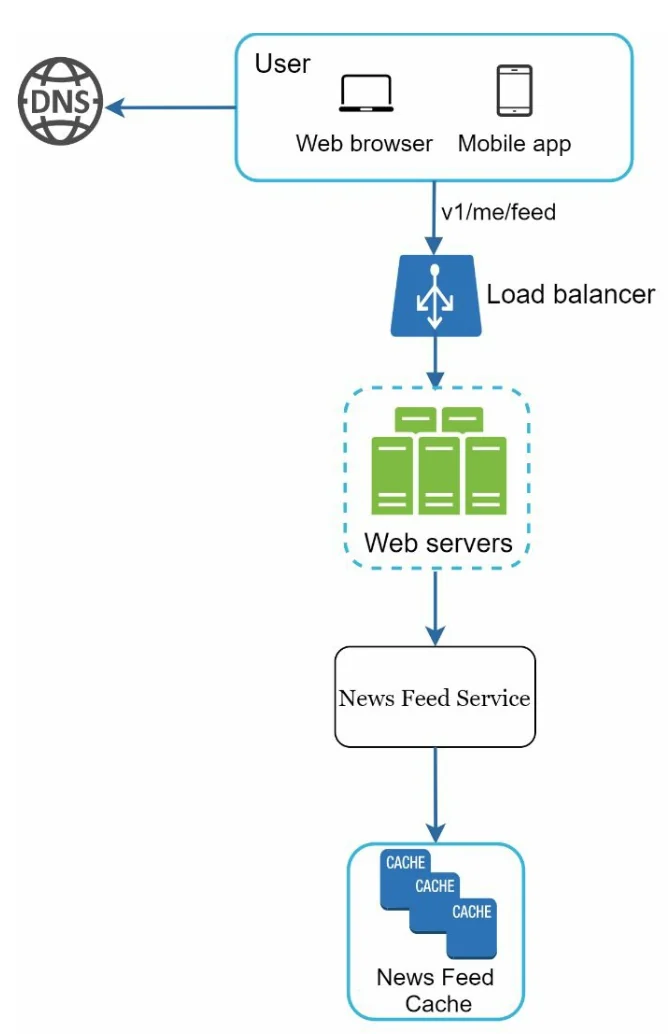
- 用户交互: 用户通过获取 API 请求自己的信息流。
- 负载均衡器: 将流量分发到 Web 服务器。
- Web 服务器: 将请求转发给信息流服务。
- 信息流服务(News Feed Service): 从信息流缓存中获取帖子 ID,再从数据库或缓存中获取帖子的完整详情。
第 3 步:深入设计
深入信息流发布
-
Web 服务器:
- 使用
auth_token对用户进行身份认证。 - 实施限流,防止垃圾信息。
- 使用
-
扇出服务:
- 写扩散(Fanout on Write): 在写入时将帖子推送到好友的信息流中。
- 优点: 实时更新,获取信息流速度快。
- 缺点: 对于好友众多的用户,非常消耗资源。
- 读扩散(Fanout on Read): 在读取时拉取帖子。
- 优点: 对不活跃用户而言更高效。
- 缺点: 获取信息流的速度较慢。
-
混合方案: 对大多数用户采用推模型,对拥有大量关注者的用户(例如名人)采用拉模型。
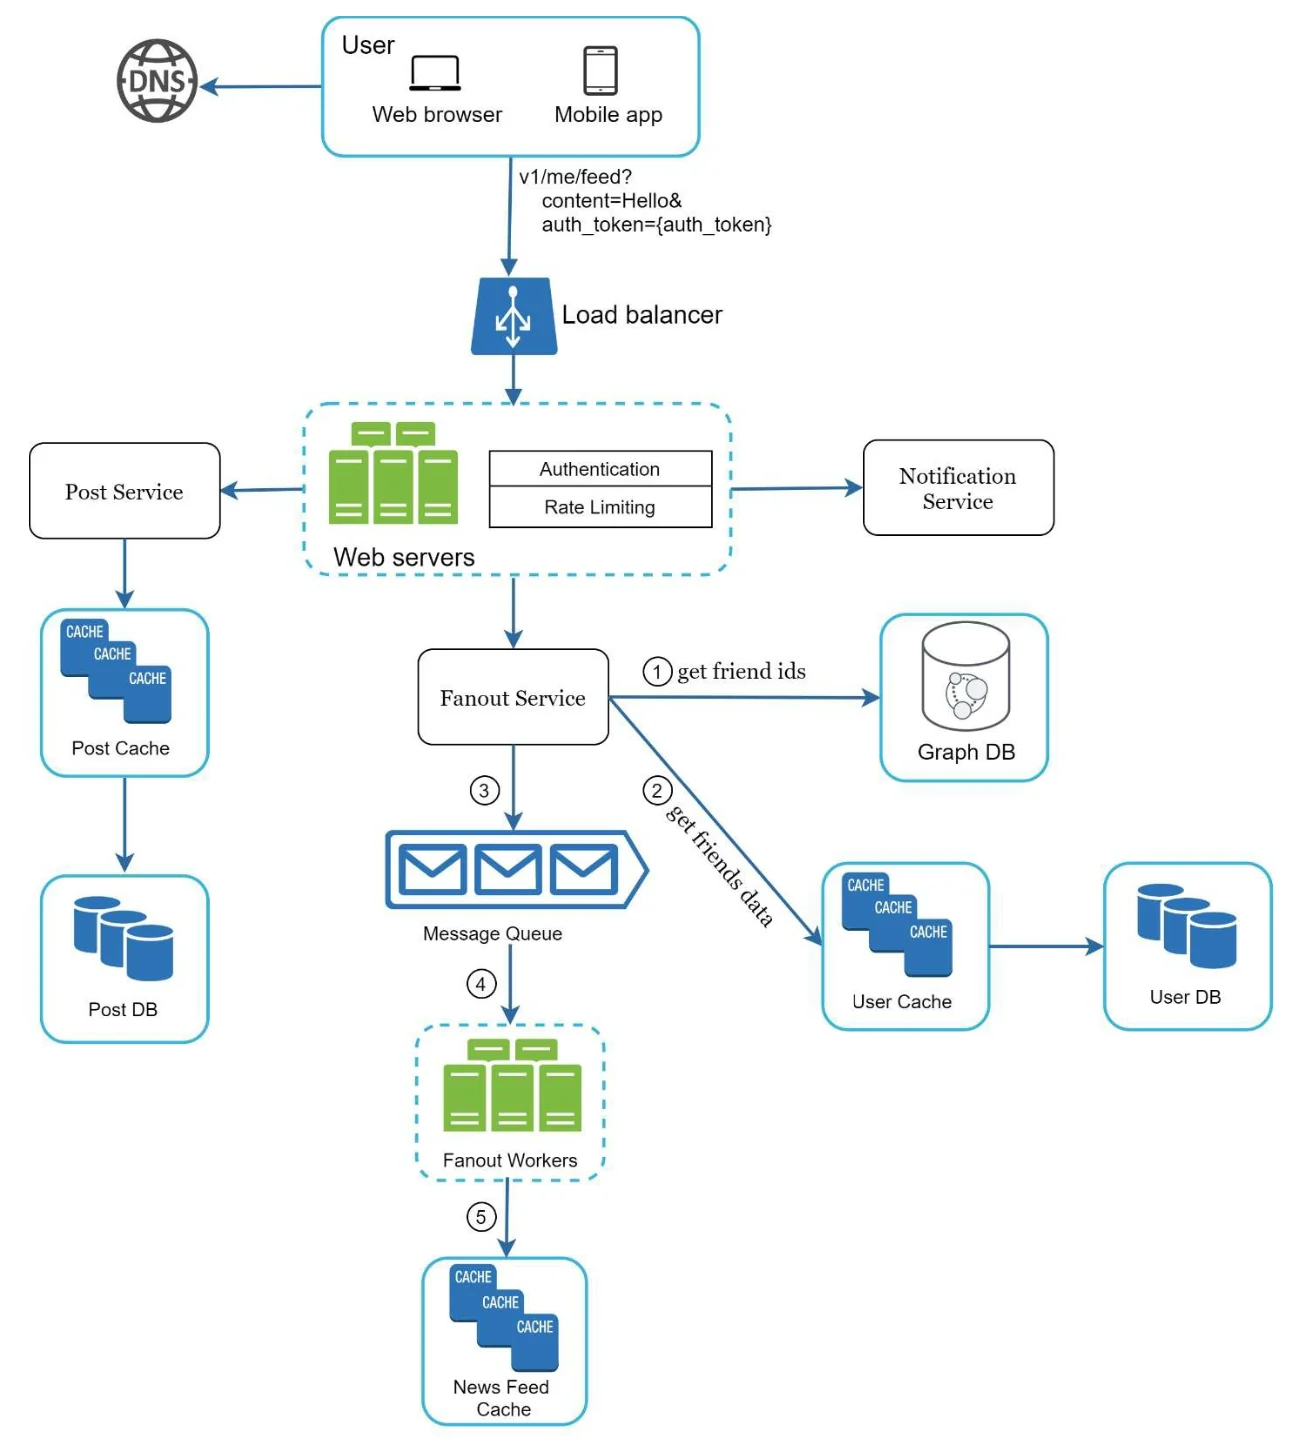
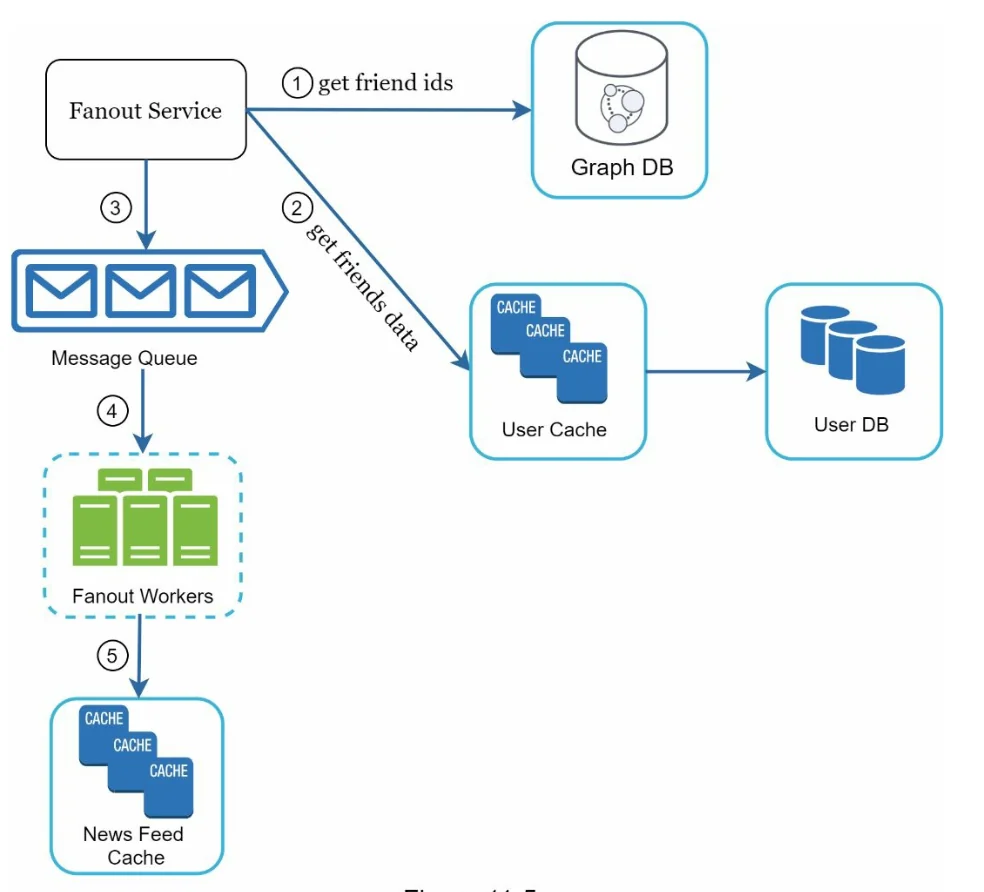
扇出服务的工作流程如下:
- 获取好友 ID: 从图数据库中获取好友列表。
- 基于缓存过滤好友: 访问缓存中的用户设置,排除某些好友(例如被屏蔽的好友,或用户设置了选择性分享)。
- 发送到消息队列: 将过滤后的好友列表连同新帖子的 ID 一起发送到消息队列中等待处理。
- 扇出工作节点(Fanout Workers): 工作节点从消息队列中获取数据并更新信息流缓存。为节省内存,缓存中存储的是
<post_id, user_id>映射,而不是完整的用户对象和帖子对象。 -
存入信息流缓存: 将新帖子的 ID 追加到好友的信息流缓存中。由于大多数用户只关注最新内容,可以设置一个可配置的上限,确保只存储最近的帖子,从而将缓存内存消耗控制在可接受的范围内。
- 写扩散(Fanout on Write): 在写入时将帖子推送到好友的信息流中。
深入信息流获取
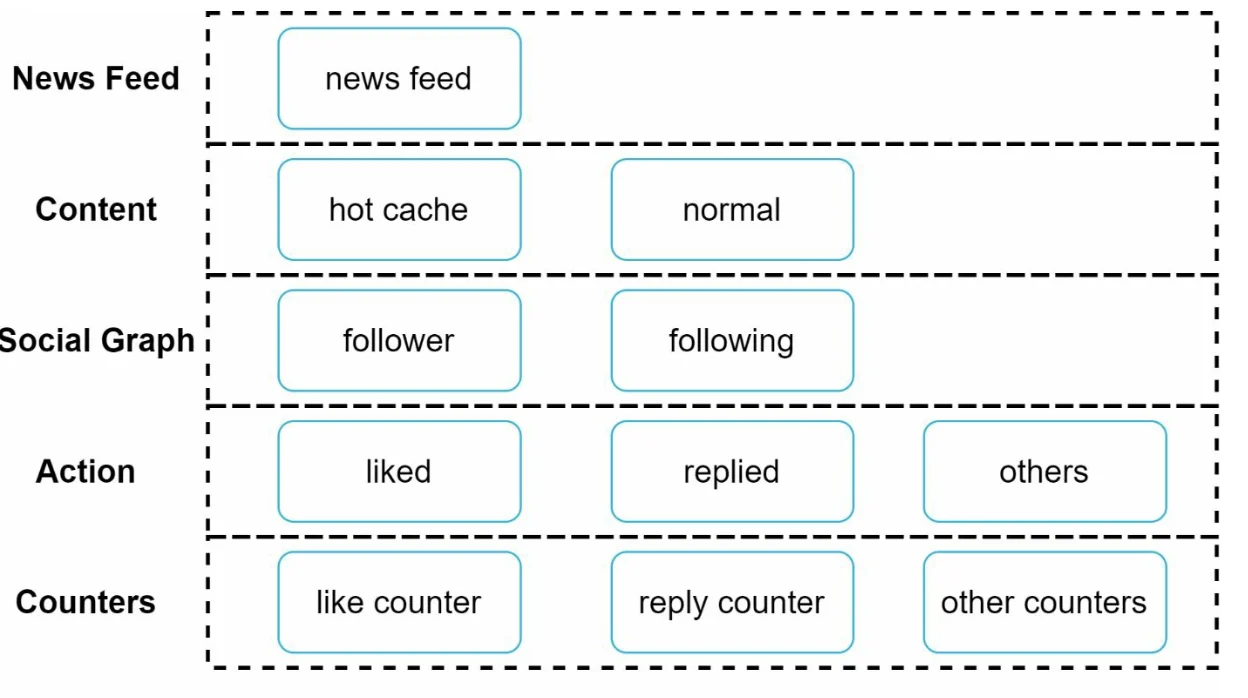
缓存架构
缓存分为五层:
- 信息流缓存(News Feed Cache): 存储帖子 ID,以便快速获取。
- 内容缓存(Content Cache): 存储帖子详情(热门帖子放在热缓存中)。
- 社交图谱缓存(Social Graph Cache): 存储用户关系数据。
- 行为缓存(Action Cache): 记录用户行为(点赞、回复、分享)。
-
计数器缓存(Counter Cache): 维护点赞数、回复数、关注者数等计数。
关键优化
扩展
- 数据库扩展:
- 水平扩展和分片(sharding)。
- 使用只读副本(read replica)来处理高流量查询。
- 无状态 Web 层: 保持 Web 服务器无状态,以便进行水平扩展。
缓存
- 将频繁访问的数据存储在内存中。
- 使用缓存层来降低延迟和数据库负载。
可靠性
- 一致性哈希(Consistent Hashing): 将请求均匀地分发到各服务器。
- 消息队列: 解耦系统组件并缓冲流量。
监控
- 追踪 QPS(每秒查询数)和延迟等关键指标。
- 监控缓存命中率,并据此调整配置。