第 15 章 设计 Google Drive
简介
Google Drive 是一项基于云的文件存储与同步服务,用户可以在各种设备上存储、访问和共享文件。本章讨论如何设计一个具备以下功能的可扩展系统:
- 文件上传与下载
- 跨设备文件同步
- 文件共享
- 文件修订历史
- 编辑、删除和共享时的通知
第 1 步:理解问题
关键需求
功能性需求:
- 上传和下载文件。
- 在多台设备之间同步文件。
- 保留文件的修订版本。
- 支持带权限控制的文件共享。
- 在文件被编辑、删除和共享时发送通知。
非功能性需求:
- 可靠性(Reliability): 数据丢失是不可接受的。
- 同步速度快: 避免同步延迟让用户失去耐心。
- 带宽效率: 尽量减少不必要的数据流量。
- 可扩展性: 支撑 1000 万日活跃用户(DAU)。
- 高可用性(High Availability): 在服务器故障或网络问题期间仍能无缝运行。
约束与假设
- 用户可获得 10 GB 免费空间。
- 最大文件大小:10 GB。
- 平均上传文件大小:500 KB。
- 上传频率:每个用户每天 2 个文件。
- 所需总存储量:500 PB。
第 2 步:高层设计
单服务器方案
一个基础方案包括:
- Web 服务器: 处理上传和下载。
- 元数据数据库(Metadata Database): 用于记录用户数据、登录信息、文件信息等元数据。
- 存储目录: 按命名空间(namespace)组织存放文件。
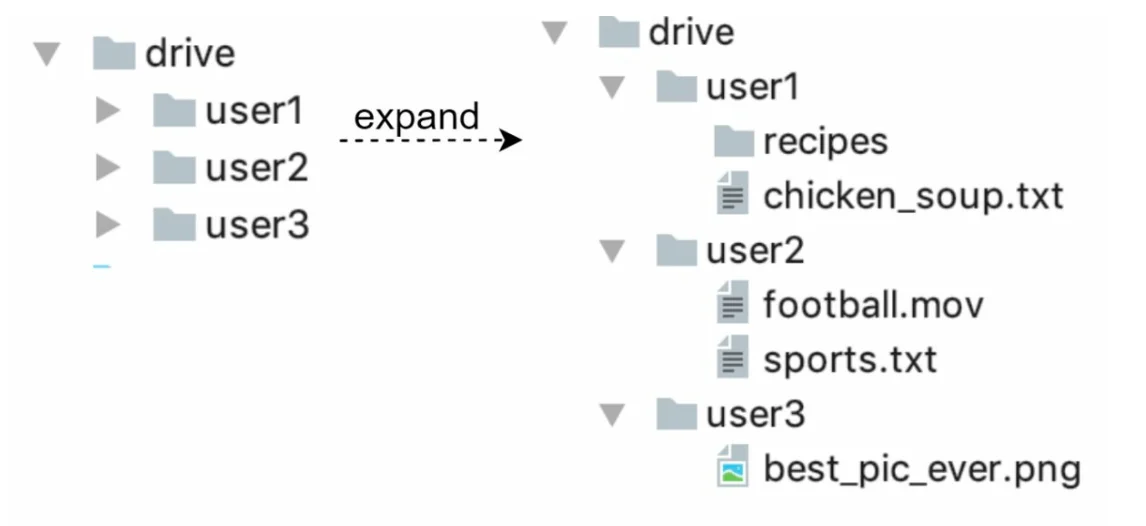
- 搭建一台 Web 服务器,并将一个名为 drive/ 的目录设为存放上传文件的根目录。
- 在 drive/ 目录下有一组目录,称为命名空间。
- 每个命名空间包含该用户上传的所有文件。
- 将命名空间与相对路径拼接起来,就可以唯一标识每个文件或文件夹。
这个设计可以作为起点,但不足以支撑扩展。
API
- 向 Google Drive 上传文件: 支持两种上传方式
- 简单上传(Simple upload):在文件较小时使用。
- 可续传上传(Resumable upload):
- 端点:https://api.example.com/files/upload?uploadType=resumable
- 发送初始请求以获取可续传 URL。
- 上传数据并监控上传状态
- 如果上传被中断,则恢复上传。
- 从 Google Drive 下载文件: 用于下载文件
- 端点:https://api.example.com/files/download
- 获取文件修订版本:
- 端点:https://api.example.com/files/list_revisions
迈向分布式系统
改进:
- 分片(Sharding): 根据
user_id将存储拆分到多台服务器上。 -
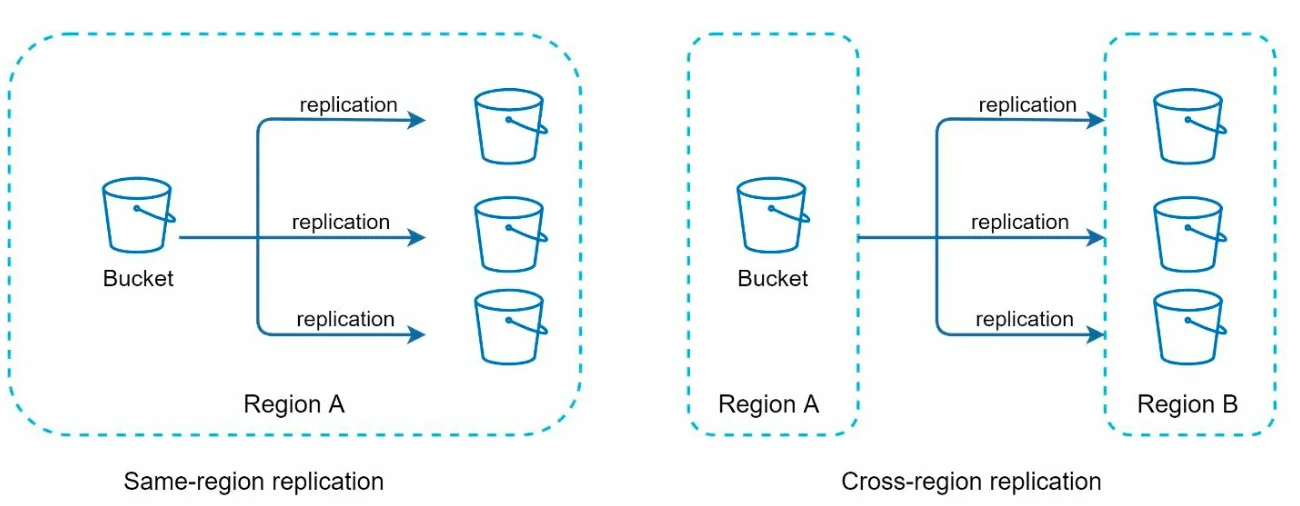
Amazon S3: 使用 S3 实现可扩展、带冗余的文件存储,并进行跨区域复制(cross-region replication)。
-
负载均衡器(Load Balancer): 将流量分发到多台 Web 服务器上。
- 元数据数据库复制: 通过数据库分片和复制来确保可用性。
同步冲突:
对于 Google Drive 这样的大型存储系统,同步冲突时有发生。 当两个用户同时修改同一个文件或文件夹时,就会发生冲突。
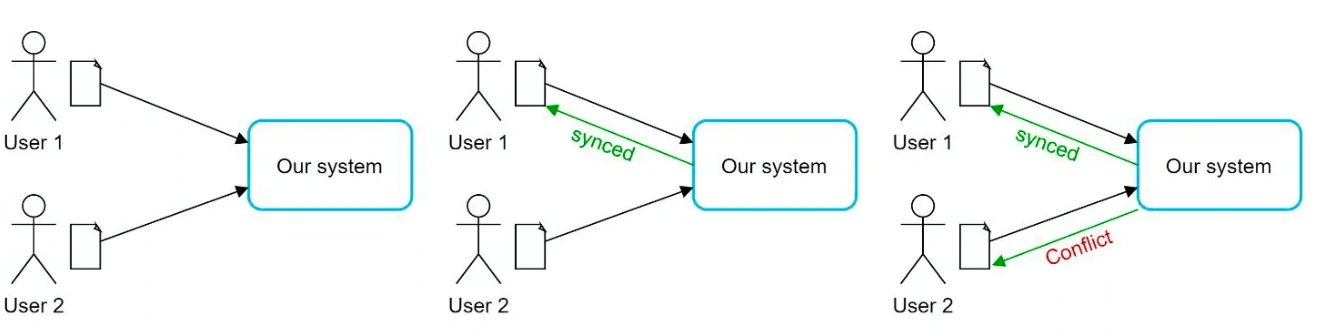
- 在这个例子中,用户 1 和用户 2 试图同时更新同一个文件,但用户 1 的文件先被我们的系统处理。
- 用户 1 的更新操作成功了,而用户 2 则遇到同步冲突。
- 系统会同时呈现同一文件的两个副本:用户 2 的本地副本和服务器上的最新版本。
- 用户 2 可以选择合并这两个文件,或者用其中一个版本覆盖另一个版本。
改进后的设计
-
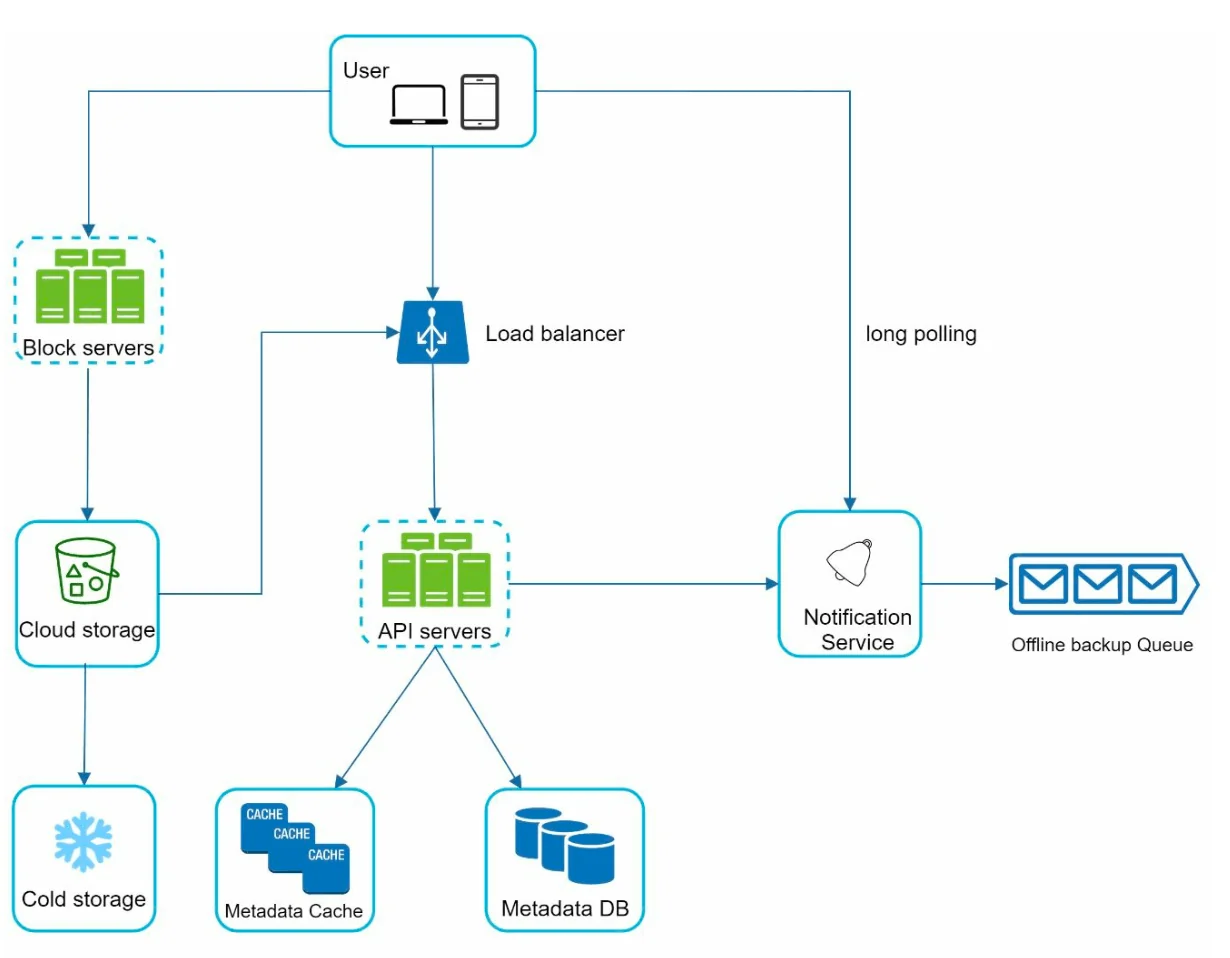
用户交互:用户通过浏览器或移动应用访问该应用。
-
块服务器(Block Servers):
- 文件被拆分为若干 4 MB 的块(最大大小),并为每个块分配唯一的哈希值。
- 各个块独立存储在云存储中(例如 Amazon S3)。
- 重建文件时,需要按特定顺序将各个块拼接起来。
-
云存储(Cloud Storage): 块存储在云存储中,以获得可扩展性和冗余。
-
冷存储(Cold Storage): 将不活跃的文件移到冷存储中以降低成本。
-
负载均衡器: 将请求均匀地分发给各 API 服务器,以确保高效运行。
-
API 服务器:
- 处理用户认证、个人资料管理和文件元数据更新。
- 管理除上传之外的所有工作流程。
-
元数据数据库和缓存:
- 存储用户、文件、块和版本的元数据。
- 频繁访问的元数据会被缓存,以加快检索速度。
-
通知服务(Notification Service):
- 一个发布/订阅系统(publisher/subscriber system),在文件发生变更(新增、编辑、删除)时通知客户端。
- 确保客户端能够拉取到最新的更新。
-
离线备份队列(Offline Backup Queue): 为离线客户端暂存文件变更信息,以便其重新上线后进行同步。
第 3 步:深入设计
元数据数据库
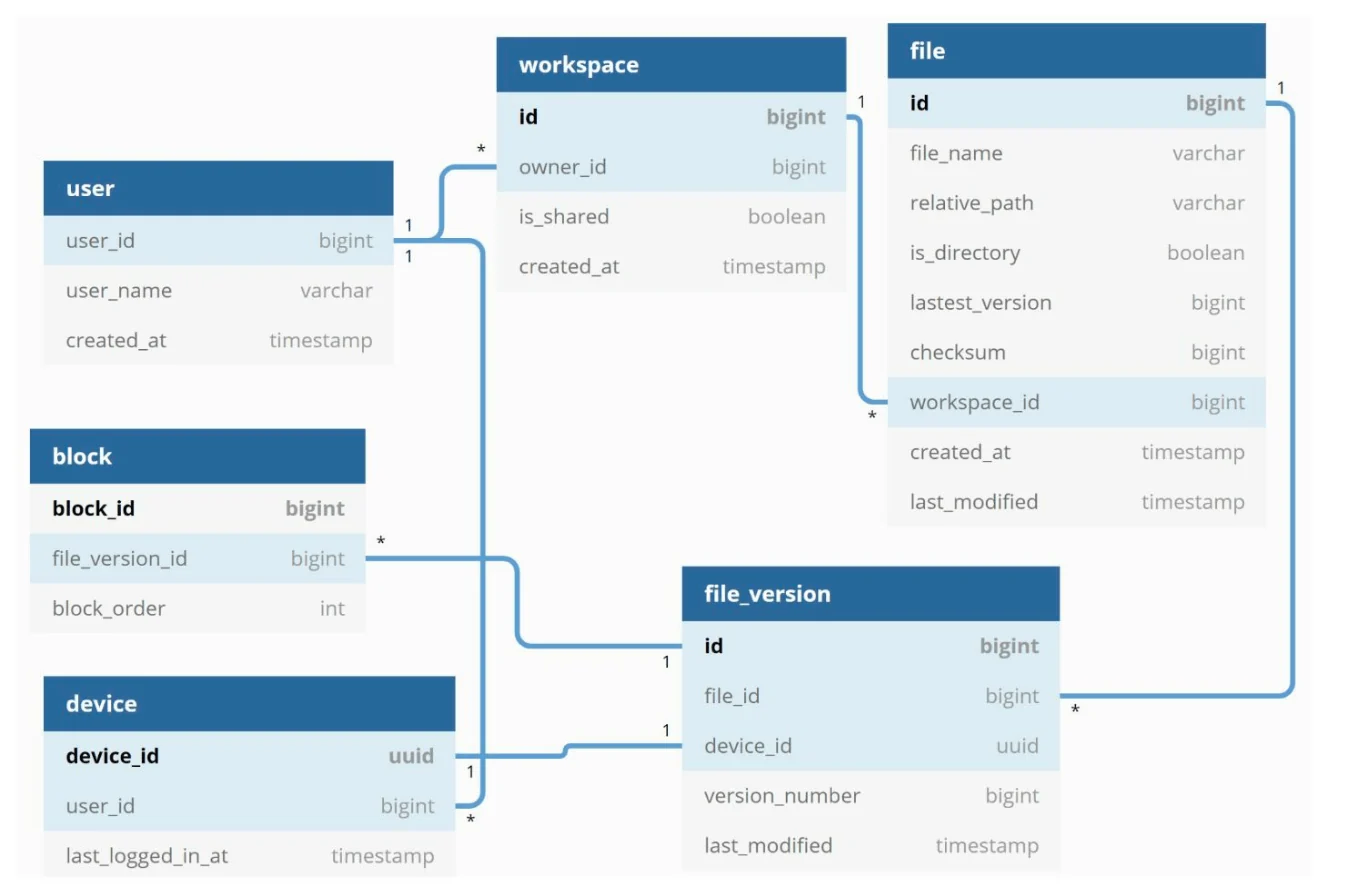
下面展示的是一个高度简化的版本,因为它只包含最重要的表和字段。
模式设计:
- 用户表(User Table): 存储用户资料和偏好设置。
- 文件表(File Table): 维护文件元数据(例如大小、名称、路径)。
- 块表(Block Table): 记录文件的块,用于重建文件。
- 文件版本表(File Version Table): 存储文件修订历史。
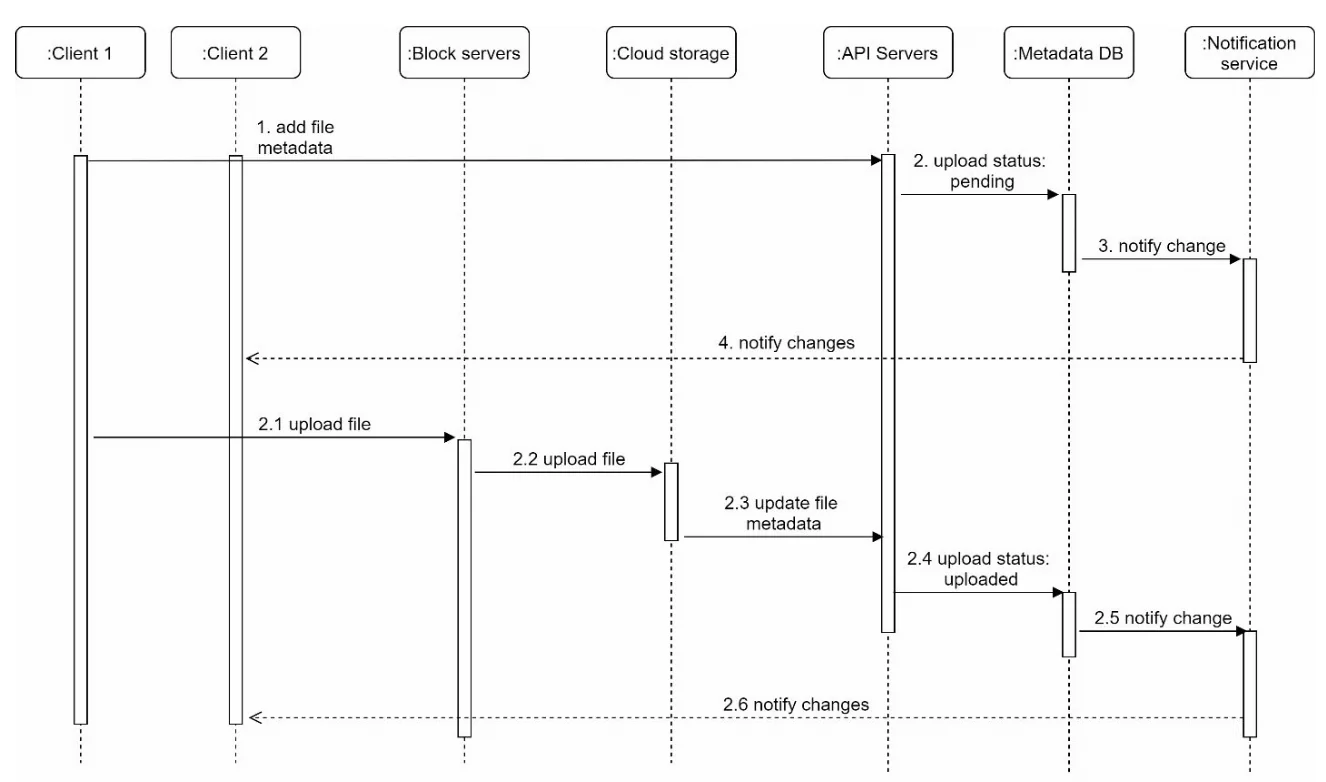
文件上传流程
- 文件上传:
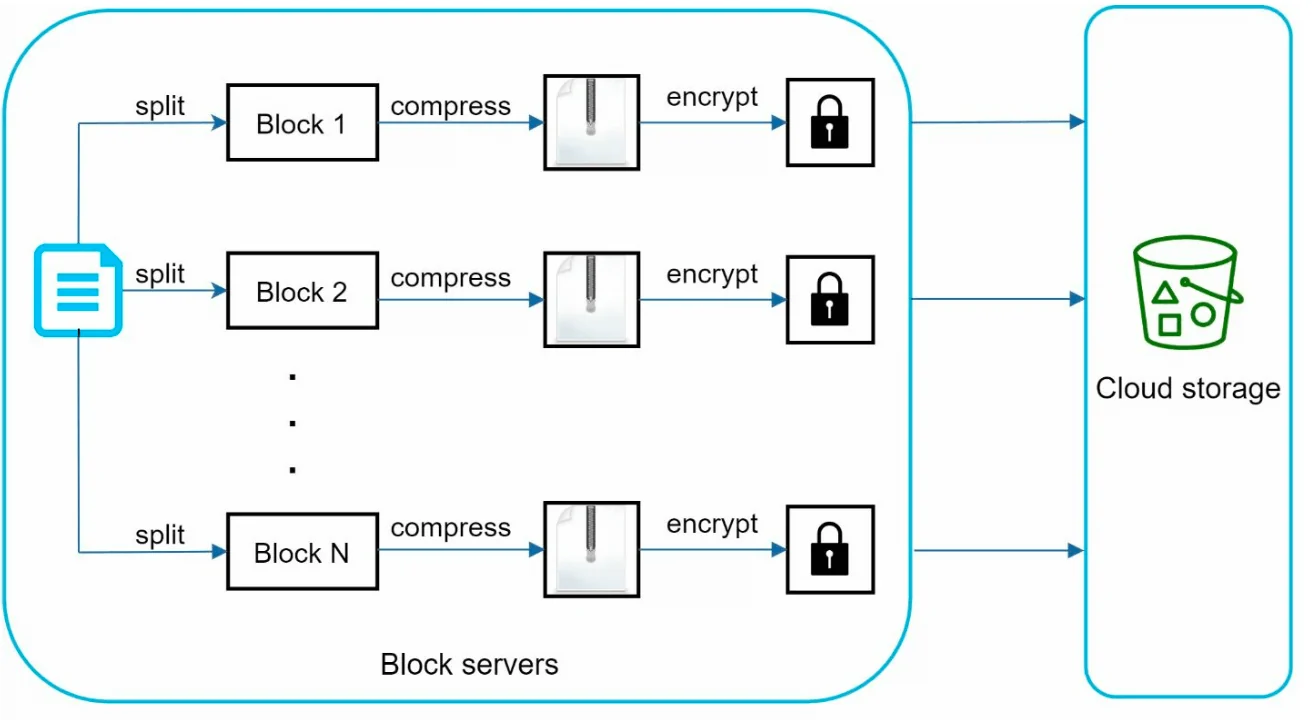
- 块服务器将文件拆分为块,并进行压缩和加密。
- 块被上传到块服务器,并存储在 S3 中。
- 元数据上传:
- 客户端将元数据发送给 API 服务器。
- 元数据以
pending状态存储到数据库中。
- 完成:
- S3 触发回调,将文件状态更新为
uploaded。 - 通知服务通知相关用户。
- S3 触发回调,将文件状态更新为
文件同步
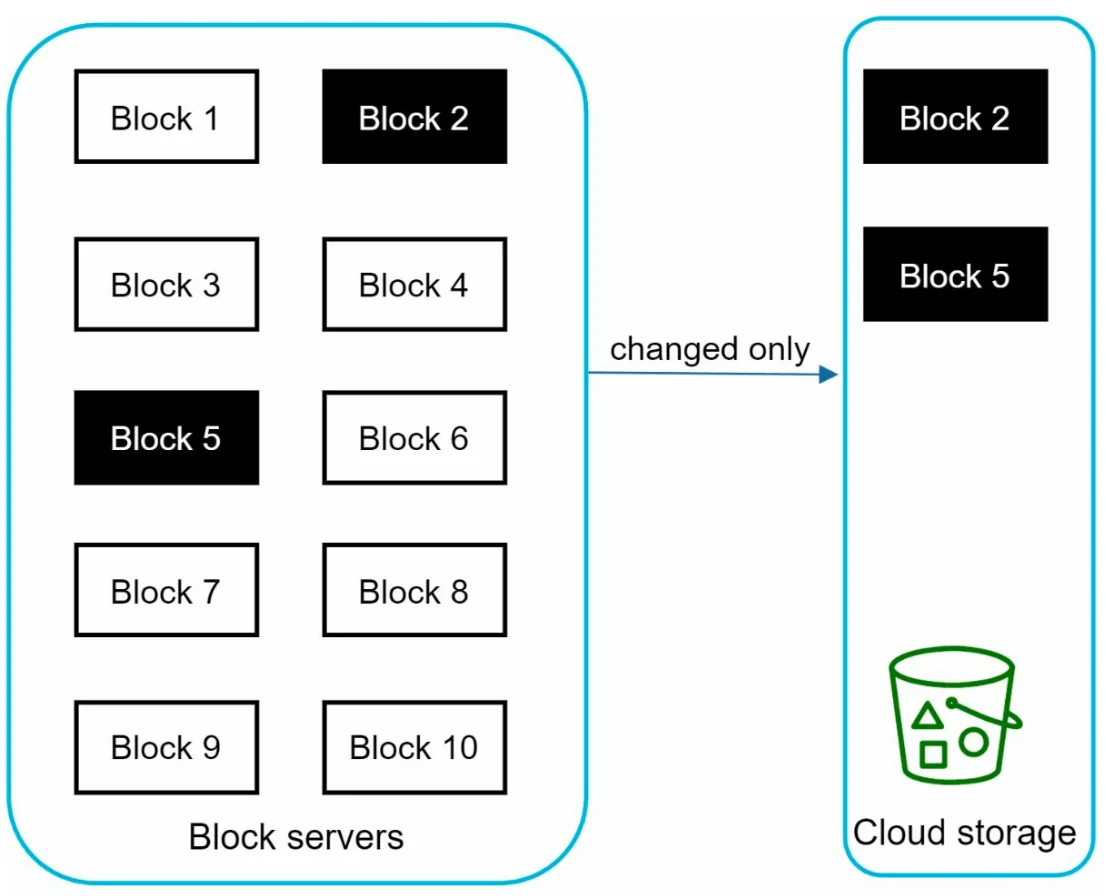
-
增量同步(Delta Sync): 只传输被修改的块,而不是整个文件。
-
压缩: 根据文件类型选用相应的压缩算法对块进行压缩。
- 冲突解决:
- 先被处理的版本胜出。
- 冲突的版本会被单独保存,交由用户解决。
文件下载流程
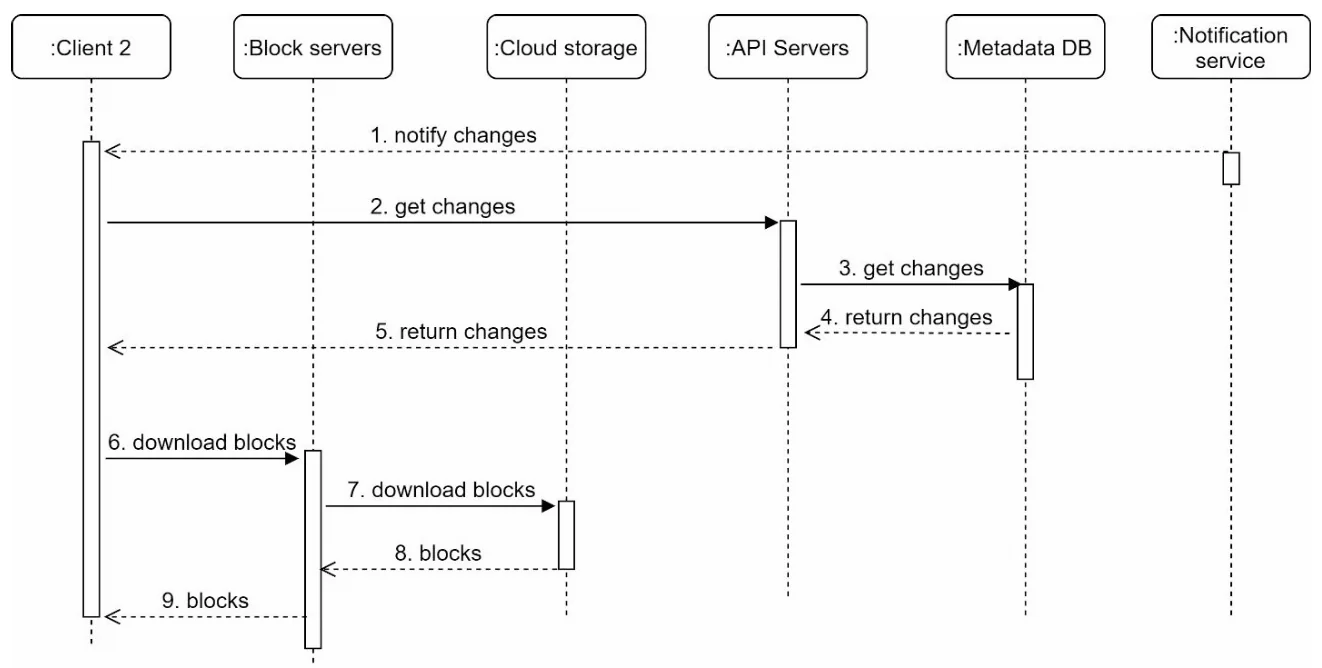
当文件在其他地方被新增或编辑时,就会触发下载流程。客户端有两种方式得知这一点:
- 如果另一个客户端修改文件时客户端 A 在线,通知服务会通知客户端 A。
- 如果另一个客户端修改文件时客户端 A 离线,数据会被保存到缓存中。当离线客户端重新上线时,它会拉取最新的变更。
客户端一旦得知某个文件发生了变更,会先通过 API 服务器请求元数据,然后 下载各个块来构建该文件。
- 触发: 通知服务告知客户端文件有更新。
- 获取元数据: 客户端通过 API 获取更新后的元数据。
- 下载块: 客户端从块服务器下载更新后的块,并重建文件。
通知服务
- 目的: 让客户端及时了解文件的变更。
- 机制: 采用长轮询(long polling)实现异步通知。
- 示例: 当文件被新增、编辑或删除时,通知会被推送给所有相关的客户端。
存储优化
- 去重(De-duplication): 在账户级别使用基于哈希的比较来移除重复的块。
- 版本控制策略:
- 限制保存的修订版本数量。
- 对于频繁编辑的文件,优先保留最近的版本。
- 冷存储: 将很少访问的文件移到更便宜的存储方案中(例如 Amazon S3 Glacier)。
故障处理
- 负载均衡器故障: 备用负载均衡器接管工作。
- 块服务器故障: 待处理的任务被重新分配给其他服务器。
- 元数据数据库故障:
- 将一个从节点提升为主节点。
- 将流量重定向到其余的副本上。
- 云存储故障: 利用跨区域复制获取不可用的文件。
- 通知服务故障: 客户端重新连接到其他服务器。