第 16 章 邻近服务
引言
邻近服务(Proximity Service) 用于查找附近的地点,例如餐馆、酒店、加油站及其他商家。Google Maps 和 Yelp 等应用都用到了这一功能,帮助用户发现指定半径范围内的地点。
第 1 步:理解问题并确定设计范围
功能性需求
- 根据用户位置(纬度、经度)和搜索半径搜索商家。
- 允许商家所有者添加、更新或删除商家(不要求实时生效)。
- 在请求时提供商家的详细信息。
非功能性需求
- 低延迟:用户应能快速得到响应。
- 数据隐私:遵守 GDPR 和 CCPA 法规。
- 高可用:能应对繁华地段高峰时段的流量激增。
粗略估算(Back-of-the-Envelope Estimation)
- 1 亿日活跃用户。
- 系统中有 2 亿个商家。
- 搜索 QPS 计算:
- 每个用户每天搜索 5 次。
- 搜索 QPS = (100M × 5) / 86,400 ≈ 5,000 QPS。
第 2 步:高层设计
API 设计
搜索附近商家
GET /v1/search/nearby
- 请求参数:
latitude:用户所在位置的纬度。longitude:用户所在位置的经度。radius:搜索半径(默认:5000m)。
商家 API
| API 端点 | 说明 |
|---|---|
GET /v1/businesses/{id} |
获取商家详细信息 |
POST /v1/businesses |
添加新商家 |
PUT /v1/businesses/{id} |
更新商家详情 |
DELETE /v1/businesses/{id} |
从系统中删除商家 |
数据模型
- 由于以下两项功能使用非常频繁,读取量很大,因此 MySQL 这类关系型数据库很合适。
- 搜索附近商家
- 查看商家的详细信息
数据表结构
- 关键的数据库表是商家表和地理空间索引表。
- 商家表包含商家的详细信息。
高层系统架构
系统由两部分组成:基于位置的服务(Location-Based Service,LBS)和商家相关服务。
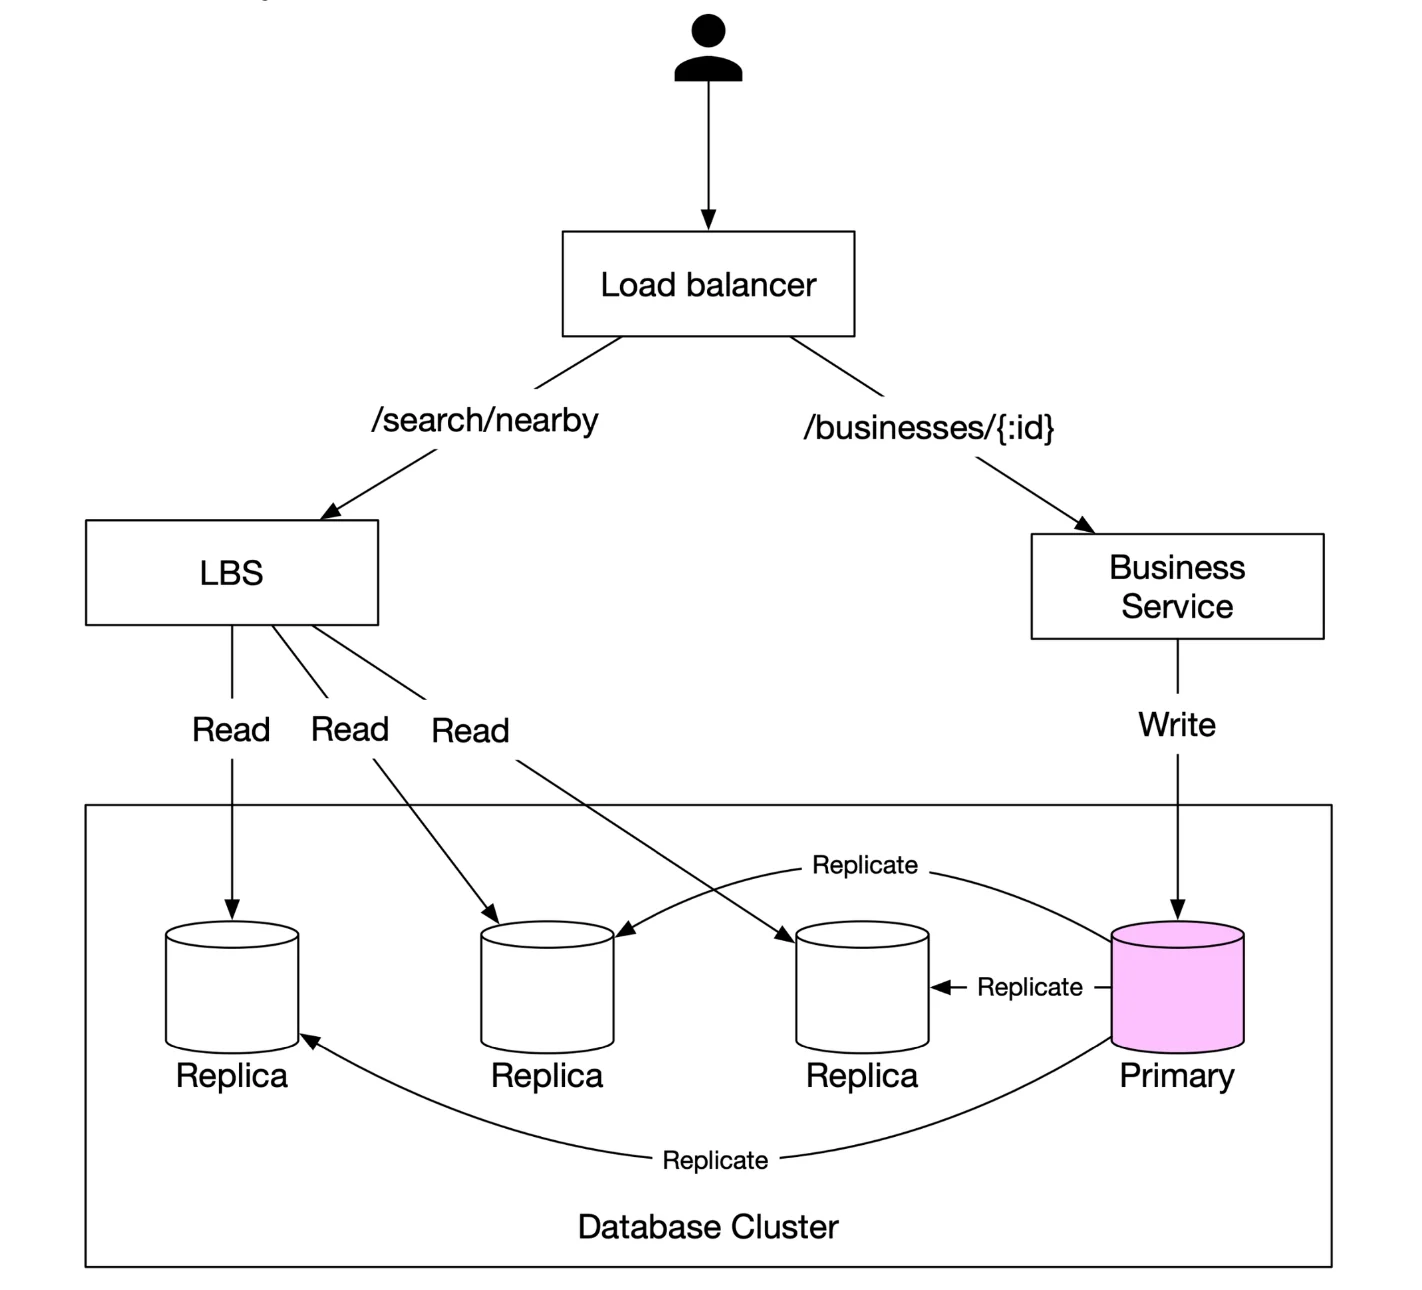
- 基于位置的服务(LBS):
- 处理基于位置的搜索查询。
- 读多写少的服务,没有写请求。
- QPS 很高,尤其是在人口密集区域的高峰时段;该服务是无状态的。
- 商家服务:处理两类请求。
- 商家所有者创建、更新或删除商家。
- 顾客查看商家的详细信息。
- 负载均衡器:将流量路由到 LBS 和商家服务。
- 数据库集群:
- 采用主从(primary-replica)架构来应对读多写少的负载。
- LBS 读到的数据与主数据库写入的数据之间可能存在一些差异。
- 这种不一致不是问题,因为商家信息本来就不需要实时更新。
第 3 步:获取附近商家的算法
方案 1:二维搜索(朴素方法)
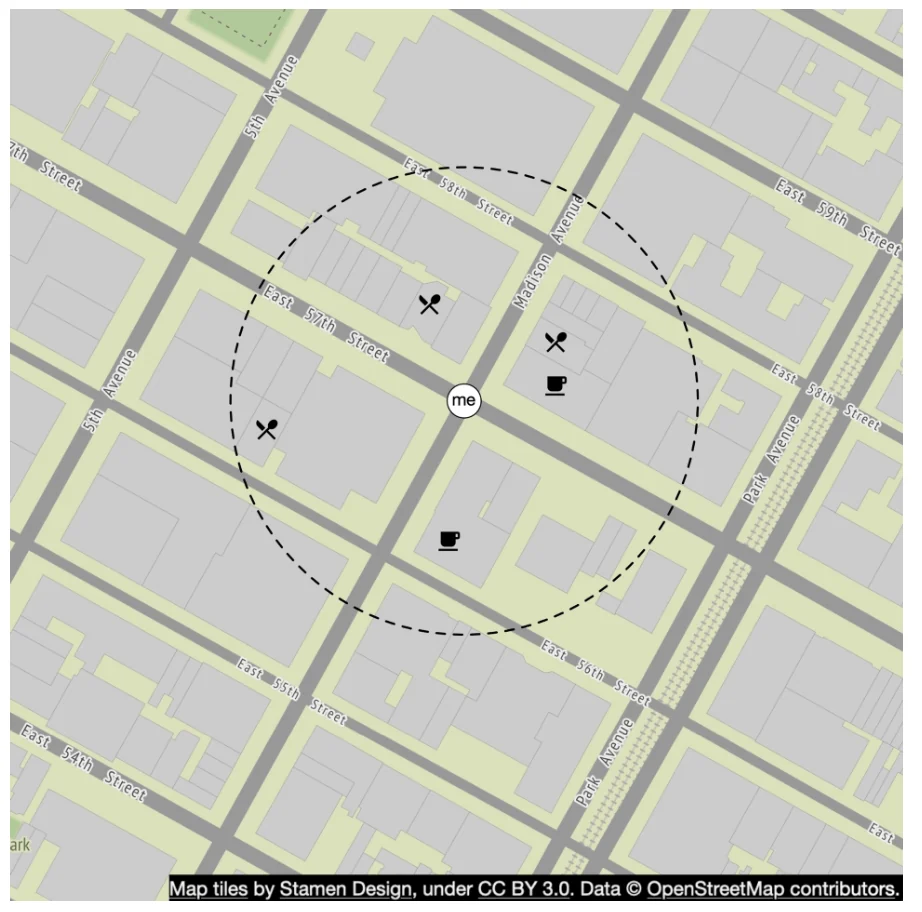
最直观的做法是以预先设定的半径画一个圆,找出圆内的所有商家。
SQL 查询:
SELECT business_id, latitude, longitude
FROM business
WHERE (latitude BETWEEN :lat - radius AND :lat + radius)
AND (longitude BETWEEN :long - radius AND :long + radius);
问题:
- 效率低:需要扫描整个数据库。
- 受限于一维索引(纬度/经度)。
一种可能的改进是在经度和纬度列上建立索引,这样虽然稍好一些,但仍然非常慢。
更好的方法
- 上一种方法的问题在于,数据库索引只能提升单一维度上的搜索速度。
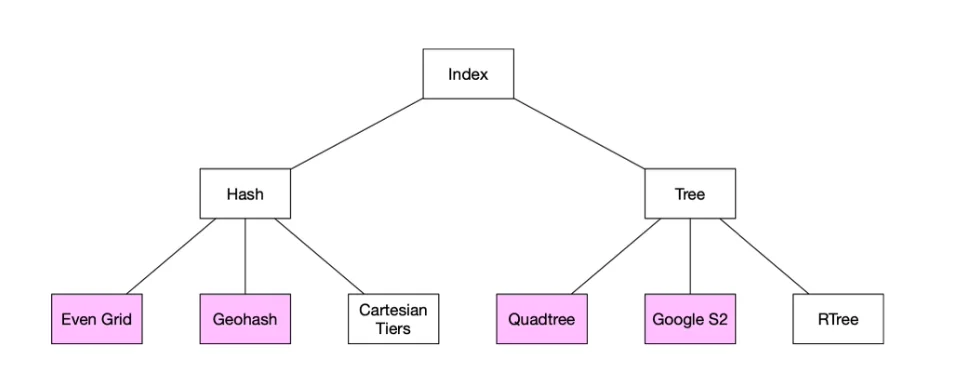
- 更优的做法是借助地理空间索引(Geospatial Indexing),把二维数据映射到一维上来表示。
- 哈希类:均匀网格、Geohash
-
树类:四叉树、Google S2、R 树(RTree)
方案 2:均匀划分的网格
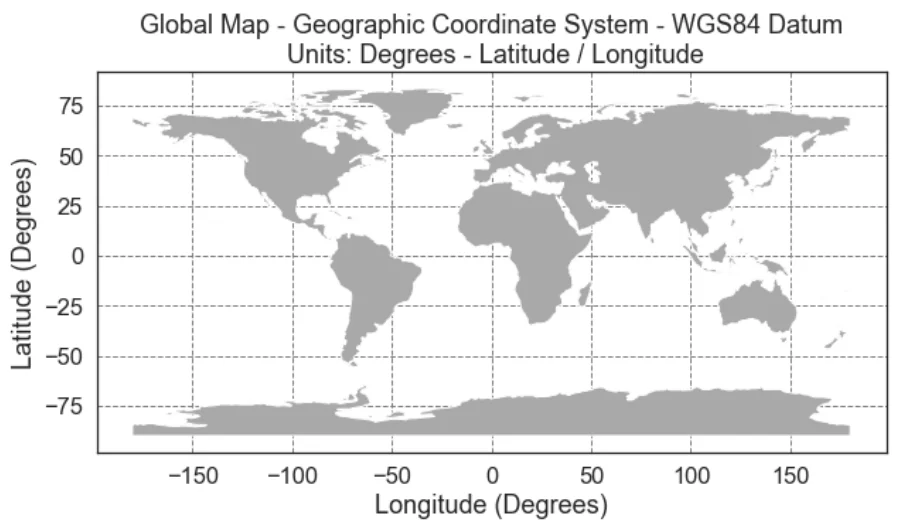
- 把世界划分为固定大小的网格。
- 问题:商家分布不均匀(城市里密度高,农村地区稀疏)。
方案 3:Geohash
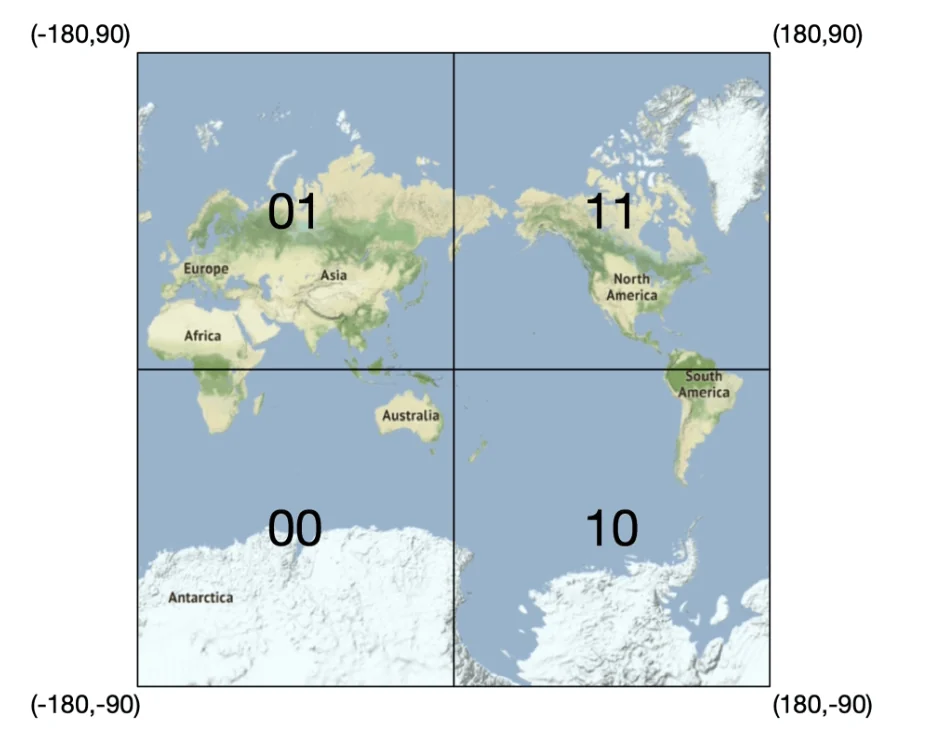
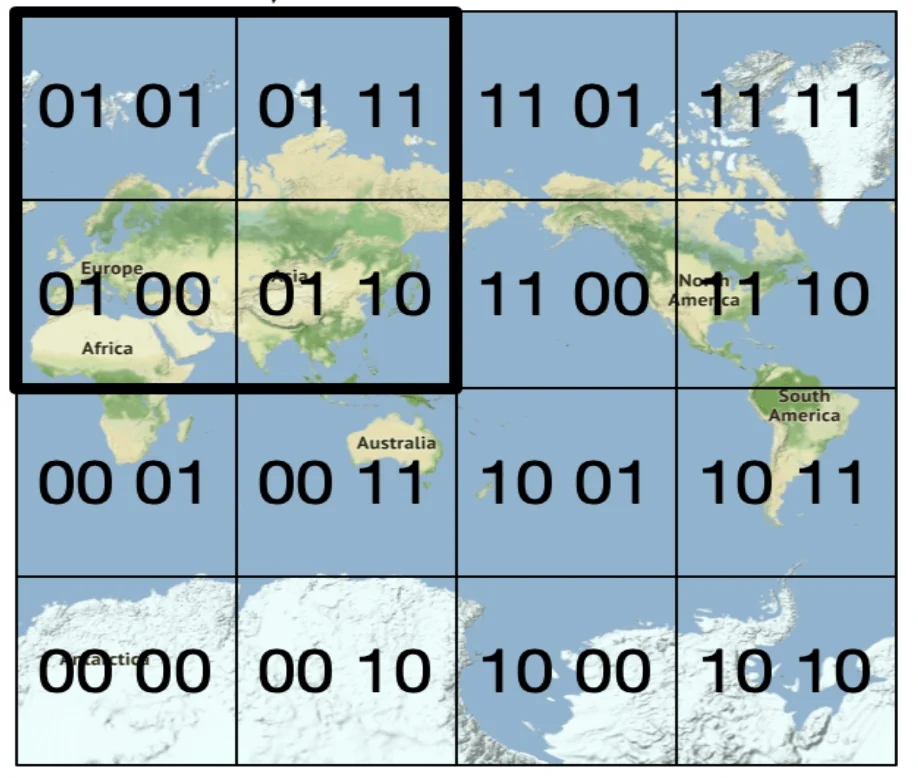
- 沿本初子午线和赤道把地球划分为四个象限,然后再把每个网格划分为四个更小的网格。
- 每个网格都可以用经度位和纬度位交替排列来表示。
-
重复这一细分过程。
-
把纬度和经度编码成单个字母数字字符串。共有 12 级精度(层级)。
- 层级化的网格结构使搜索更加高效。
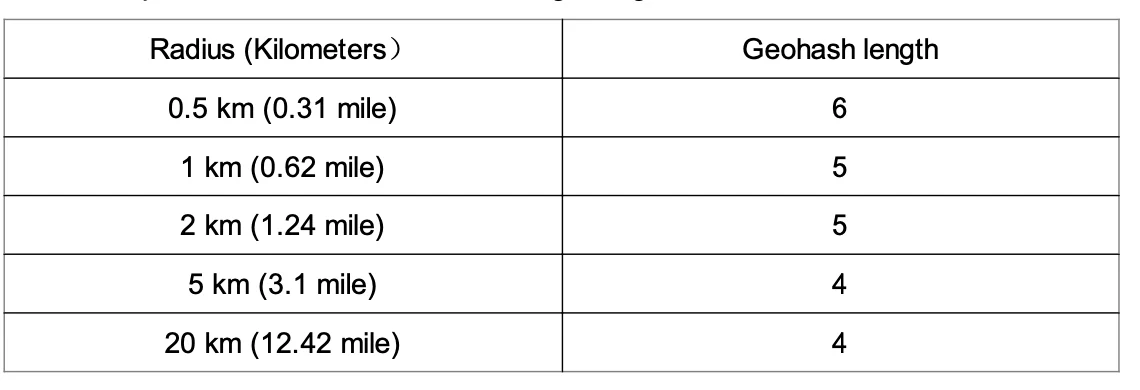
- 根据下表,选择满足条件的最短 geohash 长度作为合适的精度。
-
Geohash 保证:两个 geohash 的公共前缀越长,它们的位置就越近。
-
挑战:
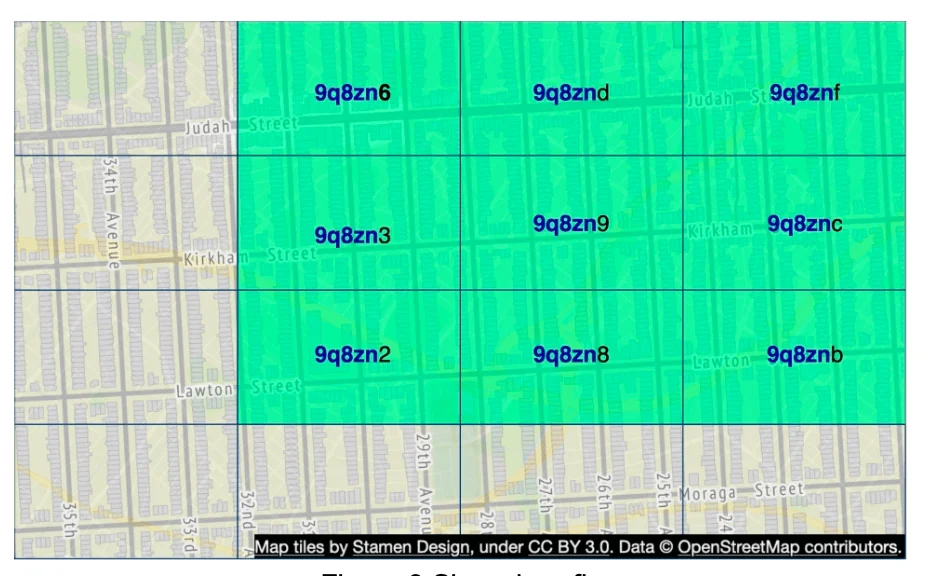
- 边界问题(靠近网格边缘的商家可能被漏掉)。
- 两个位置可能非常接近,却完全没有公共前缀(例如分处赤道两侧)。
- 两个位置可能有很长的公共前缀,却属于不同的 geohash。
- 解决办法:需要同时搜索相邻网格。
- 边界问题(靠近网格边缘的商家可能被漏掉)。
方案 4:四叉树
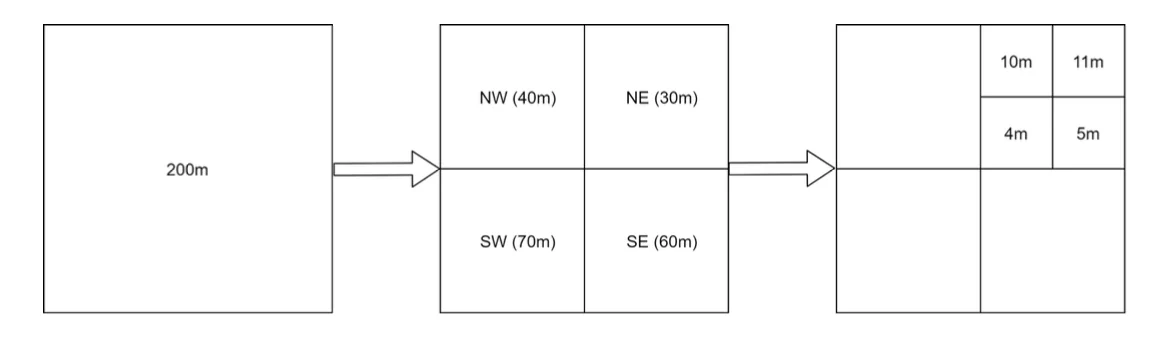
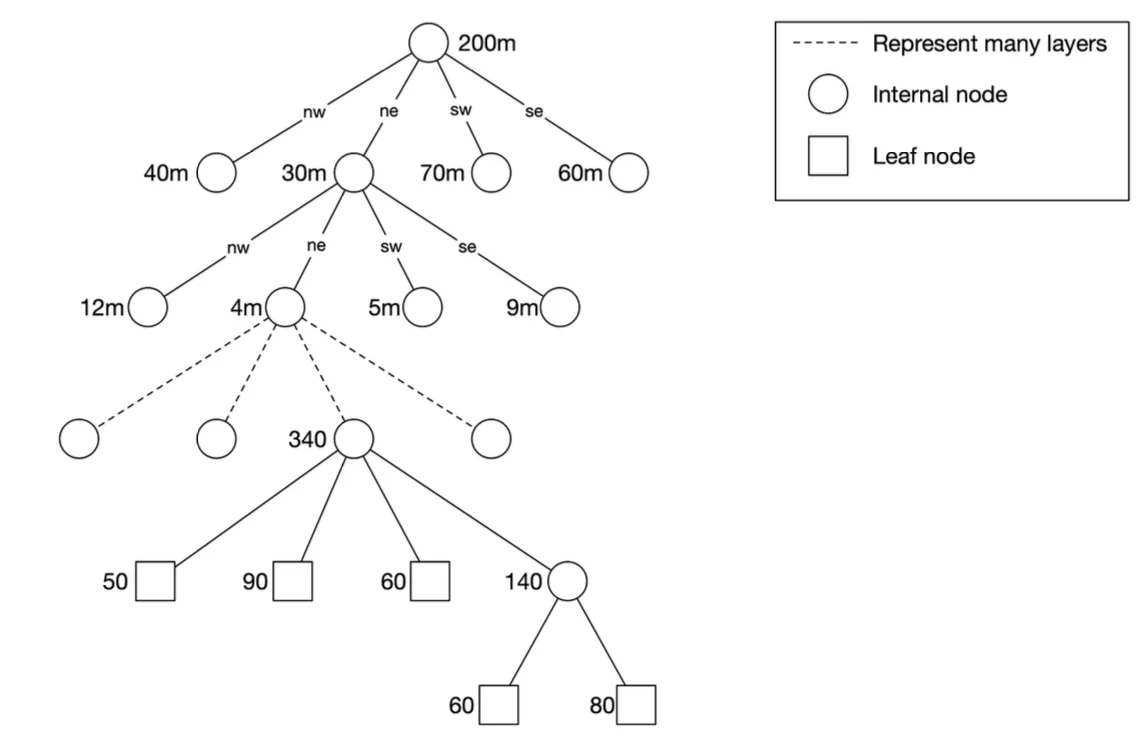
四叉树(Quadtree)是一种树形数据结构,它递归地把二维空间划分为四个象限,每个内部节点恰好有四个子节点,分别代表空间的四个子区域。
-
四叉树是一种内存数据结构,运行在每台 LBS 服务器上,在服务器启动时构建。
-
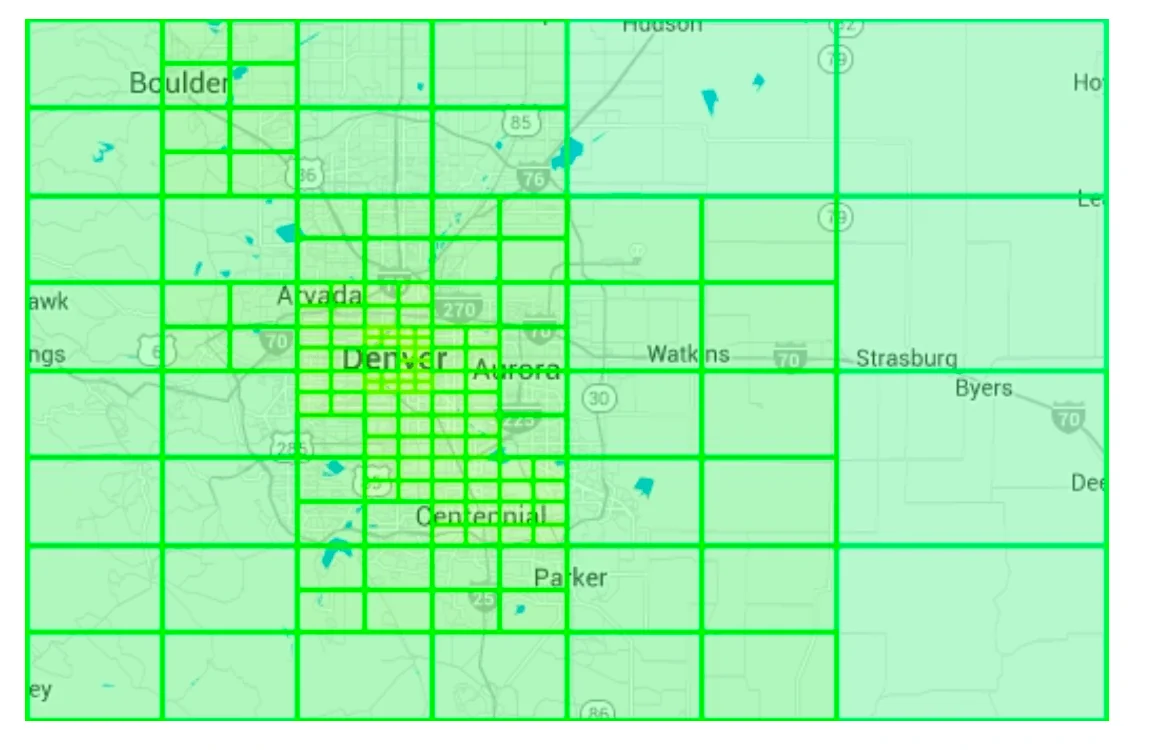
根节点被递归地划分为 4 个象限,直到没有任何节点包含超过 x 个商家(本例中为 100 个)。
-
四叉树索引占用的内存不大(通常为 GB 级),一台服务器就能轻松容纳。
- 由于构建树的时间复杂度是 nlogn,构建可能需要几分钟。
-
适合 k 近邻搜索查询(例如查找最近的加油站)。
运维方面的考虑
- 对于约 2 亿个商家,在服务器启动时构建四叉树可能需要几分钟。
- 构建四叉树期间服务器无法处理流量,因此新版本应当逐步发布到一部分服务器上。
- 更新或新增商家时,最简单的做法是增量地重建四叉树(会导致大量缓存失效)。
- 也可以实时更新四叉树,但实现起来更复杂(需要加锁机制)。
方案 5:Google S2
它基于希尔伯特曲线(Hilbert Curve)把球面映射为一维索引。在希尔伯特曲线上彼此接近的两个点,在一维空间中也是接近的。
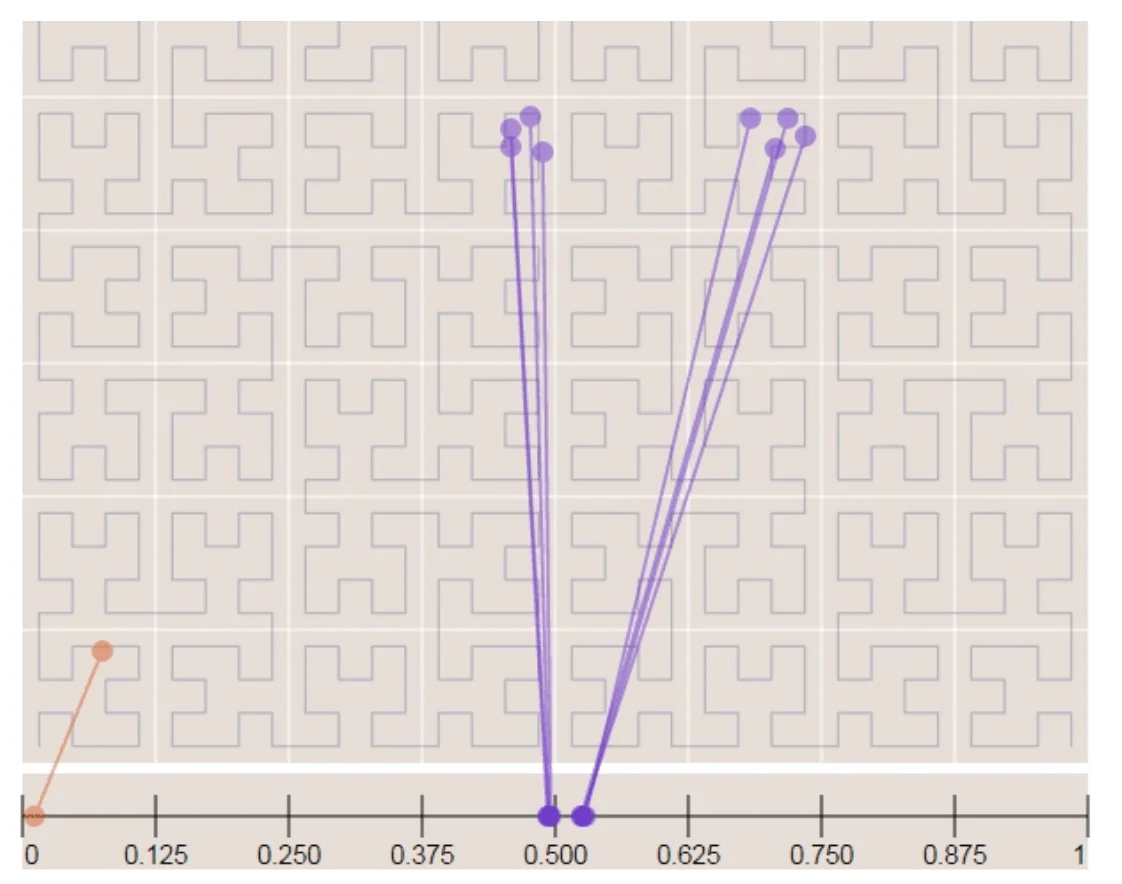
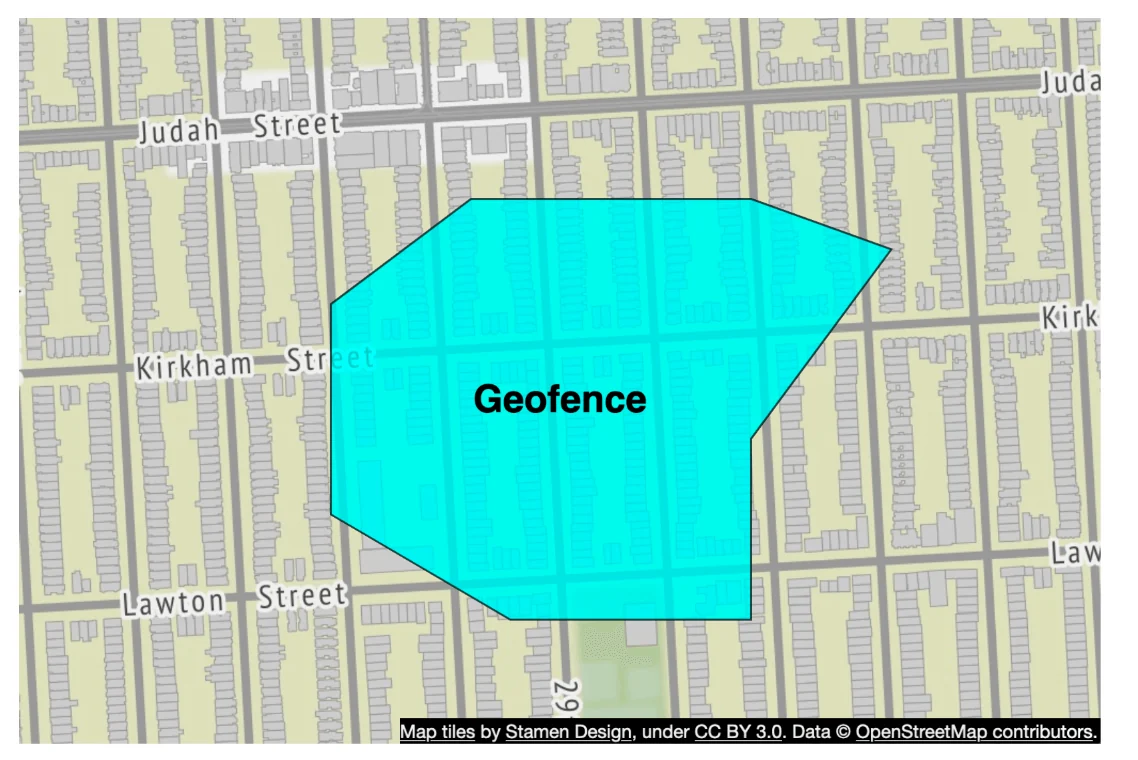
- 利用希尔伯特曲线把地球划分为许多小单元格(cell)。
- 非常适合地理围栏(Geofencing),因为它能以不同层级覆盖任意区域。
- 地理围栏还允许定义围绕目标区域的边界参数。
- 另一个优点是,S2 不必使用固定的精度级别,而是可以指定最小级别、最大级别和最大单元格数。
权衡对比
Geohash
- 易于使用和实现,无需构建或重建树
- 支持返回固定半径内的结果
- 更新索引很容易。
- 无法根据人口密度动态调整网格大小。
四叉树
- 实现起来稍难一些。
- 支持获取 k 个最近的商家。
- 可以根据人口密度动态调整网格大小。
- 更新索引更复杂,因为可能需要重建整棵树。
第 4 步:数据库扩展与缓存策略
扩展商家表
- 按商家 ID 分片可以保证数据分布均匀。
- 表中每个商家各占一行。
| Geohash | 商家 ID |
|---|---|
| 9q9hvu | 343 |
| 9q9hvu | 347 |
| 9q9hvu | 112 |
扩展地理空间索引
- 分片对 geohash 表来说未必合适。在本例中,所有数据都能放进一台服务器,因此没有分片的技术理由。
- 更好的做法是使用只读副本来分担读负载。
缓存策略
最直观的缓存键是位置坐标,但它存在几个问题:
- GPS 给出的位置坐标并不精确。
- 用户可能移动,导致位置坐标发生变化。
- 更好的键是 geohash。
| 缓存键 | 缓存值 |
|---|---|
geohash |
该网格内的商家 ID 列表 |
business_id |
商家详情(名称、地址、评价等) |
第 5 步:部署策略与最终架构
区域与可用区
- 将 LBS 和商家服务部署在多个区域。
处理实时更新
- 商家更新按天批量处理。
最终系统架构
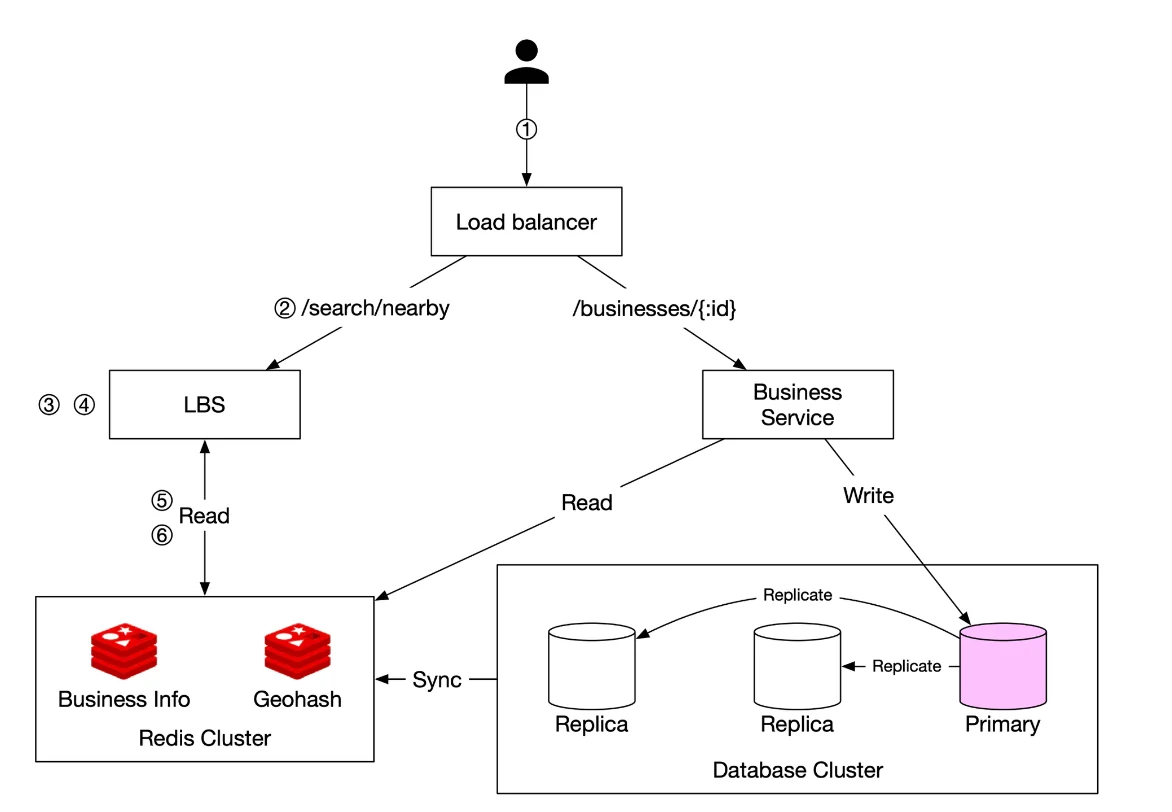
最终的算法流程如下:
获取附近商家的步骤
-
用户请求:
- 用户搜索 500 米范围内的餐馆。
- 客户端把纬度(37.776720)、经度(-122.416730)和半径(500m)发送给负载均衡器。
-
请求转发:
- 负载均衡器(LB)把请求转发给基于位置的服务(LBS)。
-
计算 Geohash:
- LBS 确定与半径相匹配的 geohash 长度。
- 通过查对照表可知,500m 对应的 geohash 长度为 6。
-
获取相邻 Geohash:
- LBS 计算相邻的 geohash,把附近区域也纳入进来。
- 结果是一个列表:
[my_geohash, neighbor1_geohash, neighbor2_geohash, ..., neighbor8_geohash]
-
从 Redis 获取商家 ID:
- 对列表中的每个 geohash,LBS 查询 Geohash Redis 服务器以获取商家 ID。
- 使用并行查询来尽量降低延迟。
-
获取商家并排序:
- LBS 从商家信息 Redis 服务器获取完整的商家详情。
- 按照与用户位置的距离对商家排序。
- 把排好序的结果返回给客户端。
关键优化
- 并行调用 Redis:缩短响应时间。
- Geohash 索引:保证空间查询高效。
- 缓存:加快商家数据的查找与获取。
这种方法确保能以低延迟、可扩展的方式获取用户附近的商家。
选择最佳索引方法
| 索引方法 | 优点 | 缺点 |
|---|---|---|
| Geohash | 易于实现,邻近搜索效率高 | 存在边界问题,网格大小固定 |
| 四叉树 | 能根据密度动态调整,支持 k 近邻查询 | 更复杂,需要对树进行再平衡 |
| Google S2 | 先进的地理围栏能力,Google Maps 在使用 | 较难实现 |