第 19 章 分布式消息队列
引言
本章我们将设计一个分布式消息队列(Distributed Message Queue)。
消息队列的好处:
- 解耦(Decoupling):消除组件之间的紧耦合,让它们可以各自独立更新。
- 提升可扩展性:生产者和消费者可以根据流量各自独立扩缩容。
- 提高可用性:即使系统的某个部分宕机,其他部分仍能继续与队列交互。
- 更好的性能:生产者无需等待消费者确认就可以生产消息。
一些流行的消息队列实现:Kafka、RabbitMQ、RocketMQ、Apache Pulsar、ActiveMQ、ZeroMQ。
严格来说,Kafka 和 Pulsar 并不是消息队列,而是事件流平台(Event Streaming Platform)。 不过两者的功能正在逐渐趋同,消息队列与事件流平台之间的界限也越来越模糊。
在本章中,我们要构建的消息队列会支持一些更高级的功能,例如长时间的数据保留、消息的重复消费等。
第 1 步:理解问题并确定设计范围
消息队列应当支持一些基本功能:生产者生产消息,消费者消费消息。 不过,在性能、消息投递、数据保留等方面还有各种不同的考量。
下面是候选人与面试官之间可能的一组问答:
- 候选人:消息的格式和平均大小是怎样的?只有文本吗?
- 面试官:消息只有文本,通常只有几 KB。
- 候选人:消息可以被重复消费吗?
- 面试官:可以,消息可以被不同的消费者重复消费。这是一个额外的需求,传统消息队列并不支持。
- 候选人:消息的消费顺序是否与生产顺序一致?
- 面试官:是的,需要保证顺序。这是一个额外的需求,传统消息队列并不支持。
- 候选人:数据保留有什么要求?
- 面试官:消息需要保留两周。这是一个额外的需求。
- 候选人:我们需要支持多少生产者和消费者?
- 面试官:越多越好。
- 候选人:我们需要支持哪种数据投递语义?最多一次、至少一次还是恰好一次?
- 面试官:我们肯定要支持至少一次。理想情况下,三种都支持并且可以配置。
- 候选人:端到端延迟的目标吞吐量是多少?
- 面试官:对于日志聚合这类场景,它应该支持高吞吐量;对于更传统的场景,则支持低吞吐量。
功能性需求
- 生产者向消息队列发送消息
- 消费者从队列中消费消息
- 消息可以被消费一次,也可以被重复消费
- 历史数据可以被截断
- 消息大小在 KB 级别
- 需要保证消息的顺序
- 数据投递语义可配置:最多一次 / 至少一次 / 恰好一次。
非功能性需求
- 高吞吐量或低延迟:可根据使用场景配置
- 可扩展:系统应当是分布式的,并能应对消息量的突然激增
- 持久化与持久性:数据应持久化到磁盘,并在节点之间复制
传统消息队列通常不支持数据保留,也不提供顺序保证。这大大简化了设计,我们后面会讨论这一点。
第 2 步:提出高层设计并获得认可
消息队列的关键组件:
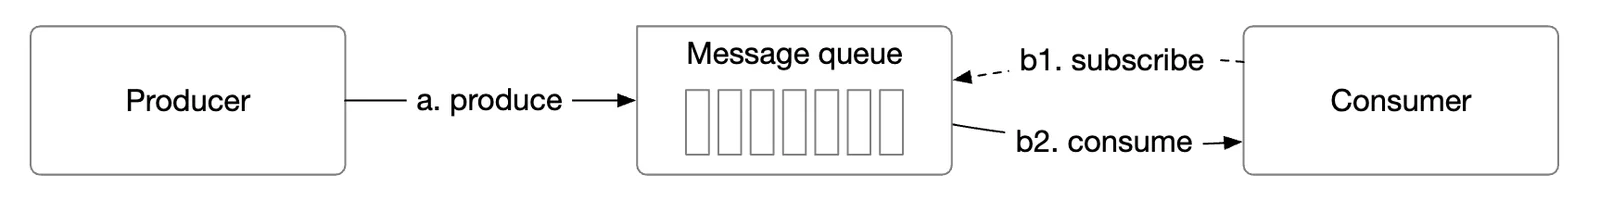
- 生产者(Producer)向队列发送消息
- 消费者(Consumer)订阅队列并消费所订阅的消息
- 消息队列是位于中间的服务,它将生产者与消费者解耦,使二者可以独立扩展。
- 生产者和消费者都是客户端,而消息队列是服务端。
消息模型
第一种消息模型是点对点(Point-to-Point)模型,常见于传统消息队列中:
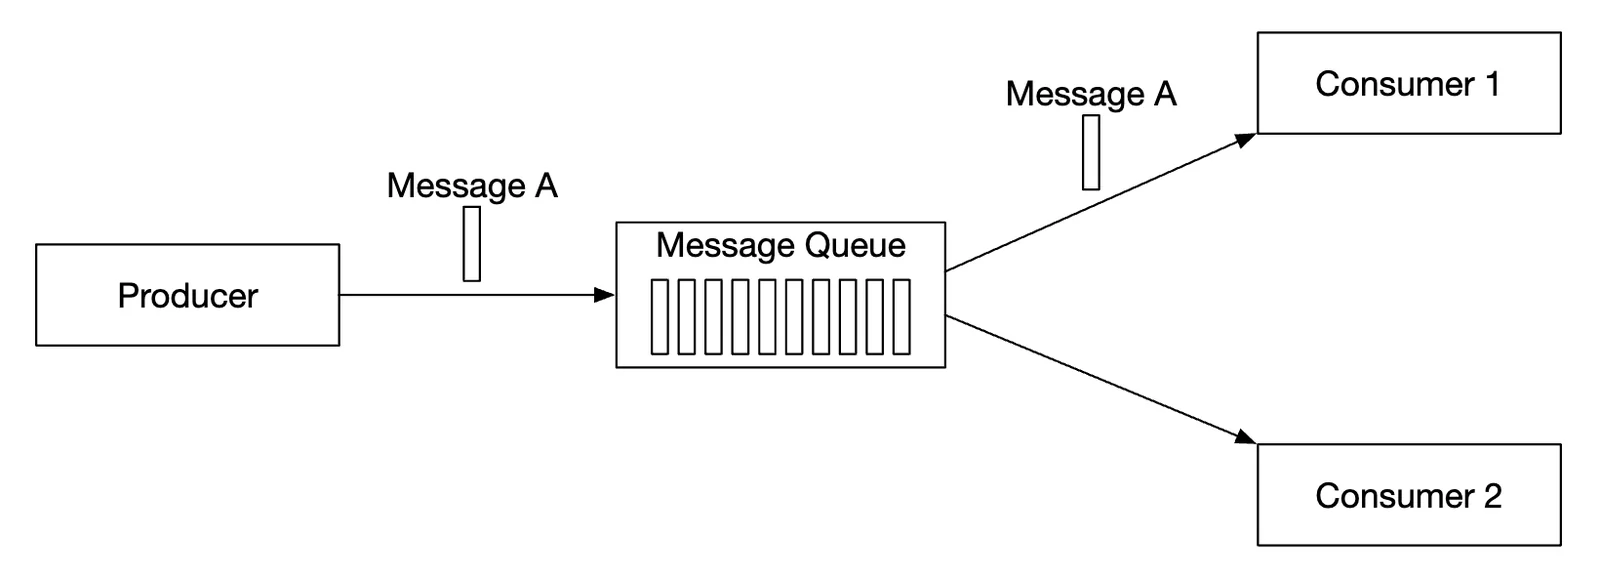
- 消息被发送到队列中,并且只会被一个消费者消费。
- 可以有多个消费者,但一条消息只会被消费一次。
- 消息一旦被确认已消费,就会从队列中移除。
- 点对点模型中没有数据保留,但我们的设计中有。
另一方面,发布-订阅(Publish-Subscribe)模型在事件流平台中更为常见:
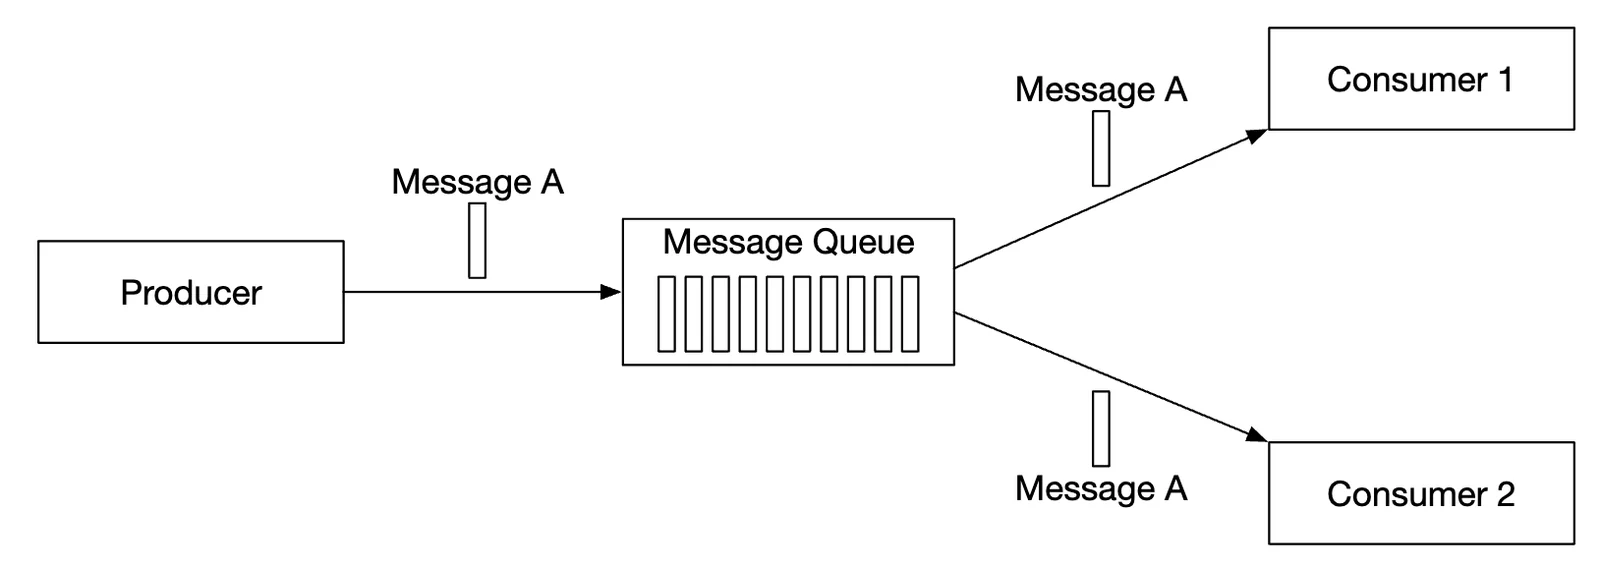
- 在这种模型中,消息与某个主题(Topic)相关联。
- 消费者订阅某个主题,并接收发送到该主题的所有消息。
主题、分区和 broker
如果某个主题的数据量太大怎么办?一种扩展方式是将主题拆分为多个分区(Partition),也就是分片(Sharding):
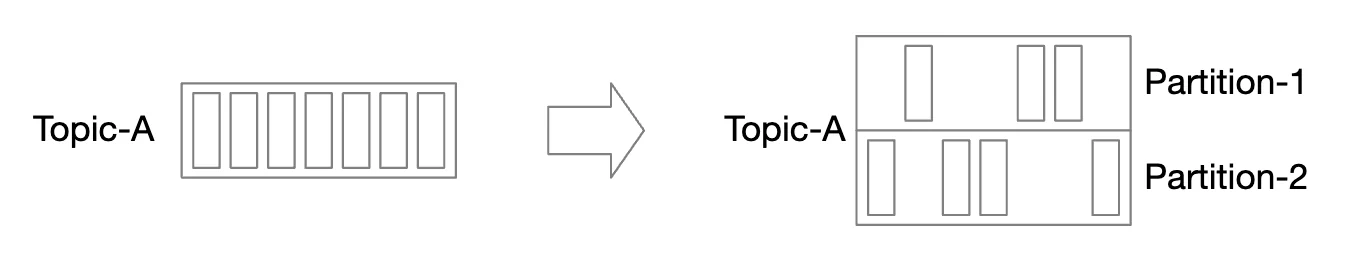
- 发送到某个主题的消息会均匀地分布到各个分区
- 承载分区的服务器称为 broker
- 每个主题都像一个队列一样,按 FIFO 方式处理消息。消息顺序在分区内得到保证。
- 消息在分区中的位置称为偏移量(Offset)。
- 生产的每条消息都会被发送到某个特定的分区。分区键(Partition Key)决定了消息应该落到哪个分区。
- 例如,可以用
user_id作为分区键,以保证同一用户的消息有序。
- 例如,可以用
- 每个消费者订阅一个或多个分区。当同一批消息有多个消费者时,它们就组成了一个消费者组(Consumer Group)。
消费者组
消费者组是一组协同工作、共同消费某个主题中消息的消费者:
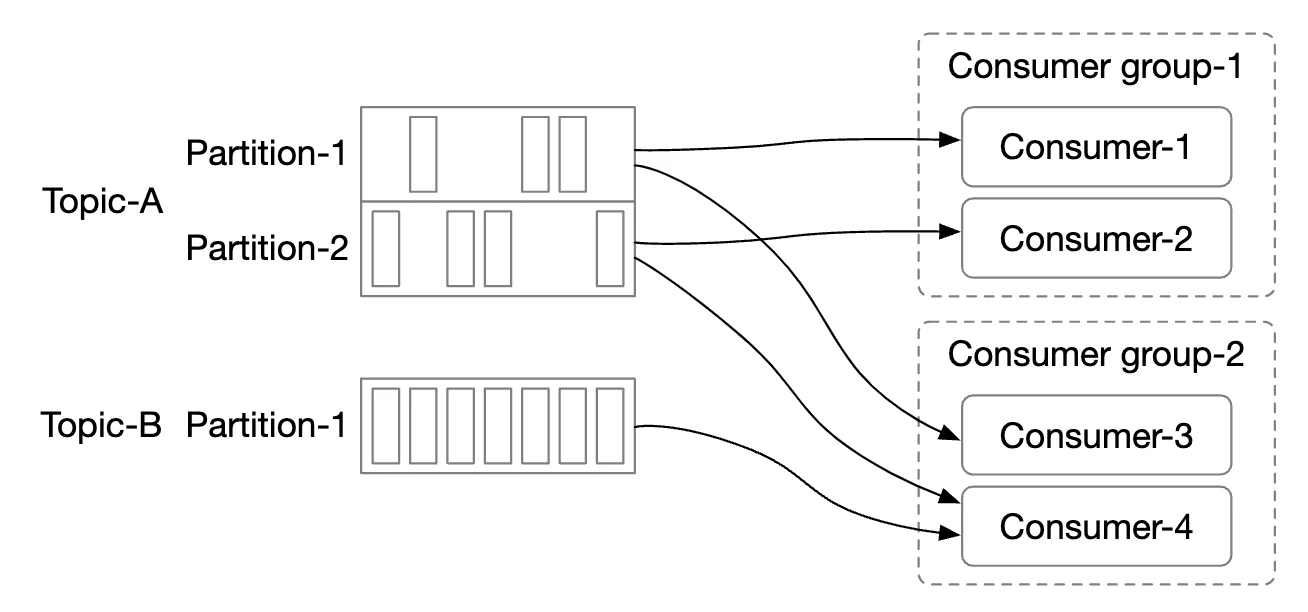
- 消息是按消费者组(而不是按消费者)进行复制的。
- 每个消费者组维护自己的偏移量。
- 消费者组并行读取消息可以提高吞吐量,但会破坏顺序保证。
- 这一点可以通过只允许组内的一个消费者订阅某个分区来缓解。
- 这意味着组内的消费者数量不能多于分区数量。
高层架构
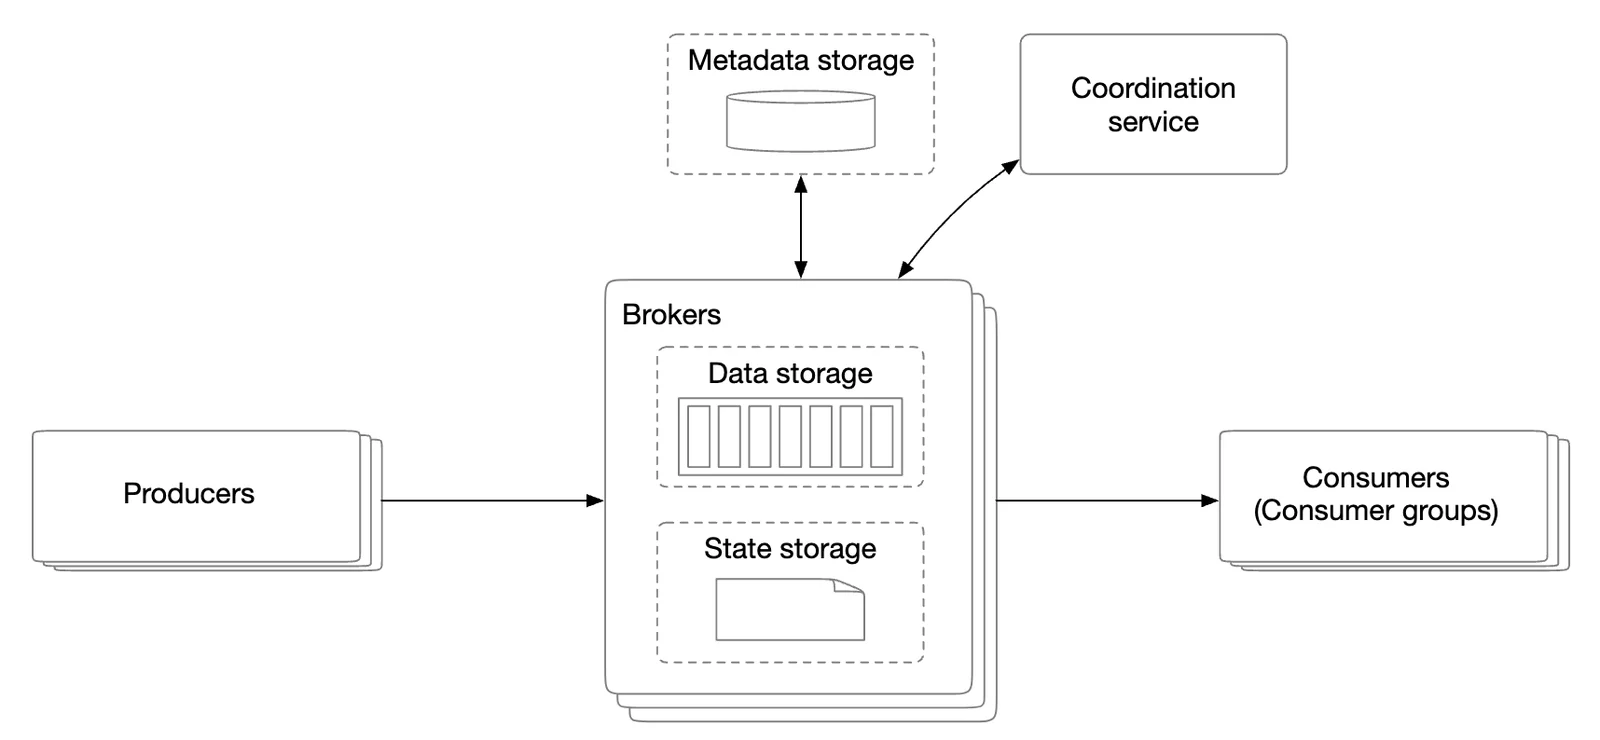
- 客户端:生产者和消费者。生产者将消息推送到指定的主题。消费者组订阅某个主题的消息。
- broker:承载多个分区。一个分区保存某个主题的一部分消息。
- 数据存储:在分区中存储消息。
- 状态存储:保存消费者的状态。
- 元数据存储:存储配置和主题属性
- 协调服务:负责服务发现(哪些 broker 是存活的)和领导者选举(哪个 broker 是 leader,负责分配分区)。
第 3 步:设计深入
为了实现高吞吐量并满足较长数据保留的要求,我们做出了几个重要的设计选择:
- 我们选择了一种磁盘上的数据结构,充分利用现代 HDD 的特性以及现代操作系统的磁盘缓存策略。
- 消息数据结构是不可变的,以避免额外的复制,而在高数据量、高流量的系统中,我们正希望避免这种复制。
- 我们围绕批处理来设计写入,因为小 I/O 是高吞吐量的大敌。
数据存储
为了给消息找到最合适的数据存储,我们必须先分析消息的特性:
- 写多,读也多
- 没有更新 / 删除操作。在传统消息队列中存在「删除」操作,因为消息不会被保留。
- 以顺序读写为主的访问模式。
我们有哪些选择:
- 数据库:并不理想,因为典型的数据库无法很好地同时支持写密集和读密集的系统。
- 预写日志(Write-Ahead Log,WAL):一个只支持追加写入的纯文本文件,对 HDD 非常友好。
- 我们将分区拆分为多个段(Segment),以避免维护一个非常大的文件。
- 旧的段是只读的。只有最新的段接受写入。
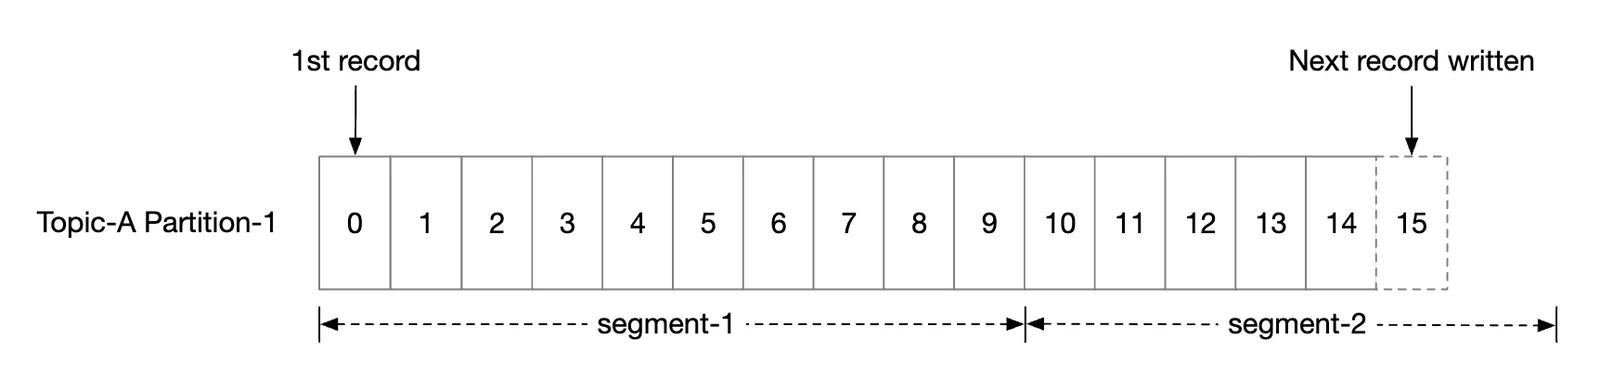
在传统 HDD 上使用 WAL 文件的效率极高。
有一种误解认为 HDD 的访问速度很慢,但这在很大程度上取决于访问模式。 当访问模式是顺序访问时(正如我们的场景),HDD 可以达到每秒数 MB 的读写速度,足以满足我们的需求。 我们还借助了操作系统会积极地将磁盘数据缓存在内存中这一特点。
消息数据结构
消息的模式(Schema)在生产者、队列和消费者之间保持一致非常重要,这样可以避免额外的复制,让处理效率高得多。
消息结构示例:
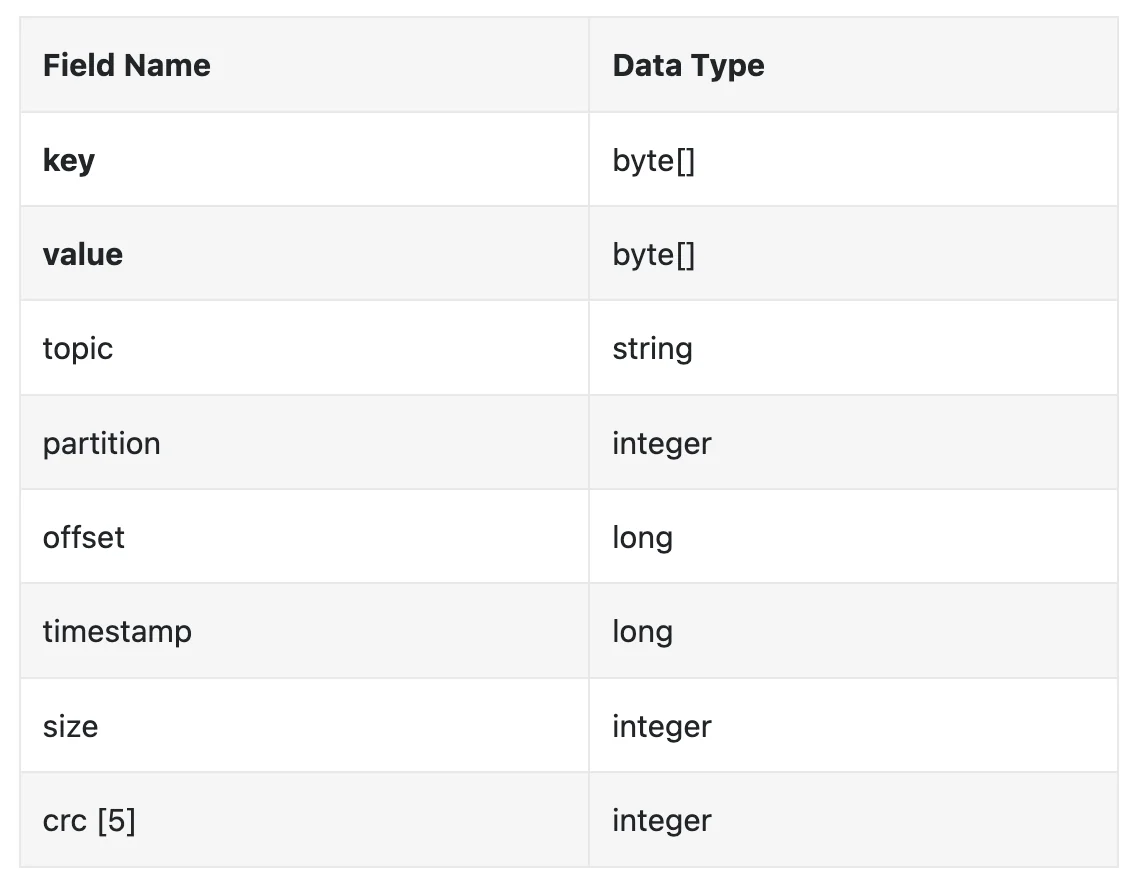
消息的键(key)决定了消息属于哪个分区。一种映射方式的示例是 hash(key) % numPartitions。
为了获得更大的灵活性,生产者可以覆盖默认的键,从而控制消息被分发到哪些分区。
消息的值(value)是消息的负载(Payload),可以是纯文本,也可以是压缩过的二进制块。
注意:与传统的 KV 存储不同,消息的键不需要唯一。键可以重复,甚至可以缺失。
消息的其他字段:
- Topic:消息所属的主题
- Partition:消息所属分区的 ID
- Offset:消息在分区中的位置。可以通过
topic、partition、offset定位一条消息。 - Timestamp:消息被存储的时间
- Size:消息的大小
- CRC:用于确保消息完整性的校验和
还可以通过添加额外的字段来支持过滤等其他功能。
批处理
批处理(Batching)对我们系统的性能至关重要。我们在生产者、消费者和消息队列中都会应用它。
它之所以至关重要,是因为:
- 它允许操作系统将消息分组,从而分摊昂贵的网络往返开销
- 消息被成组地顺序写入 WAL,这会带来大量的顺序写入和磁盘缓存。
延迟和吞吐量之间存在权衡(Trade-off):
- 批量大,吞吐量高,但延迟也更高。
- 批量小,吞吐量低,但延迟也更低。
如果系统被部署为传统消息队列、需要支持更低的延迟,可以将系统调优为使用较小的批量。
如果针对吞吐量进行调优,我们可能需要为每个主题设置更多的分区,以弥补较慢的顺序磁盘写入吞吐量。
生产者流程
如果生产者想向某个分区发送消息,它应该连接哪个 broker?
一种选择是引入一个路由层,由它将消息路由到正确的 broker。如果启用了复制,正确的 broker 就是 leader 副本(Replica):
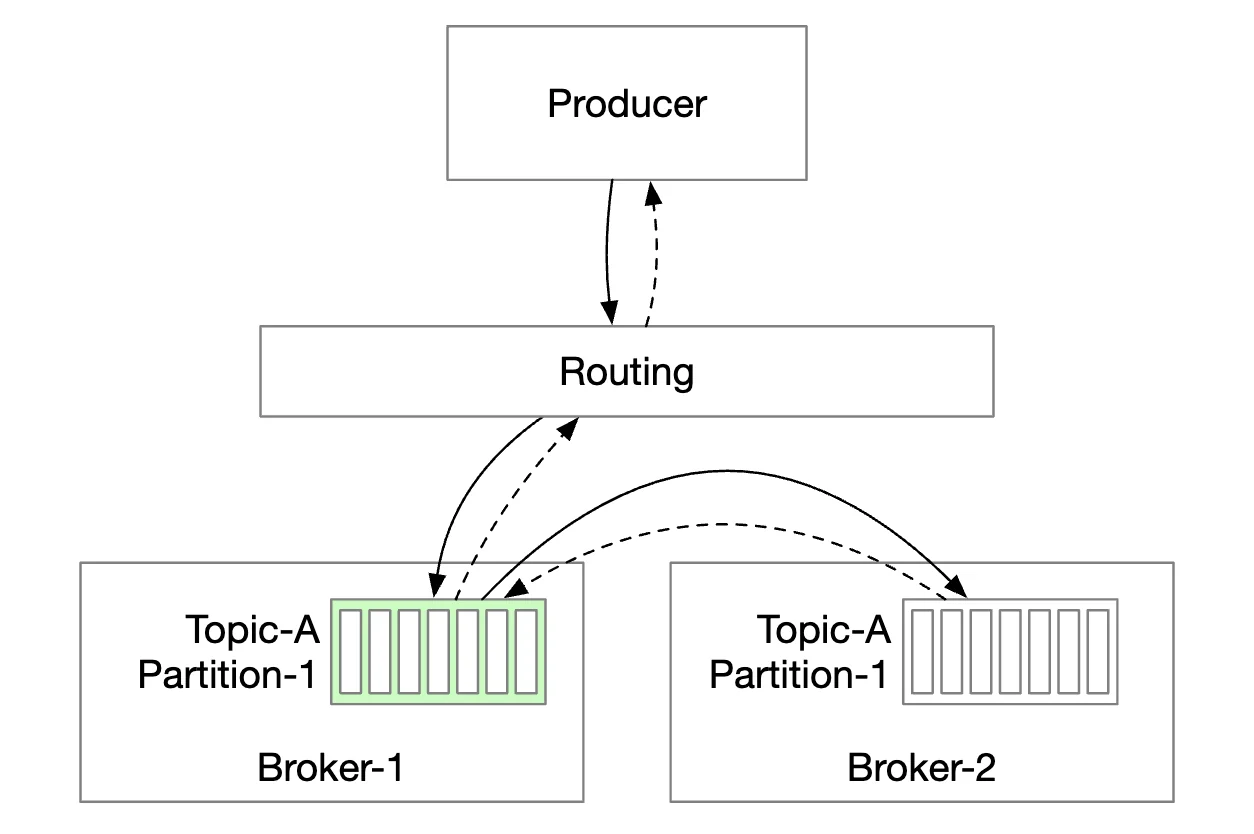
- 路由层从元数据存储中读取复制方案,并将其缓存在本地。
- 生产者将消息发送到路由层。
- 消息被转发给 broker 1,它是该分区的 leader
- follower 副本从 leader 拉取新消息。一旦收到足够多的确认,leader 就提交数据并响应生产者。
设置副本的原因是为了实现容错。
这种方式可行,但有一些缺点:
- 额外的组件带来了额外的网络跳数
- 这种设计无法对消息进行批处理
为了缓解这些问题,我们可以把路由层嵌入到生产者中:
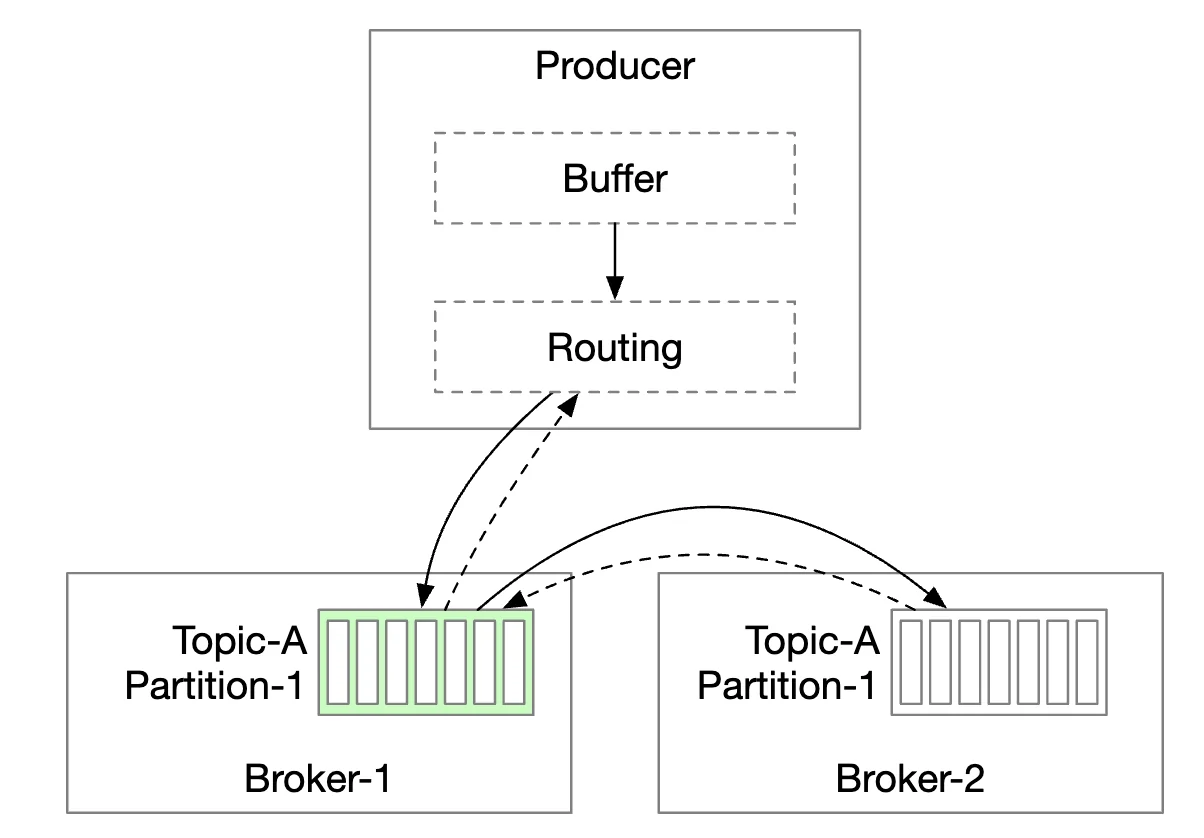
- 更少的网络跳数带来更低的延迟
- 生产者可以控制消息被路由到哪个分区
- 缓冲区让我们可以在内存中对消息进行批处理,并在单个请求中发送更大的批次,从而提高吞吐量。
批量大小的选择是吞吐量与延迟之间的经典权衡。
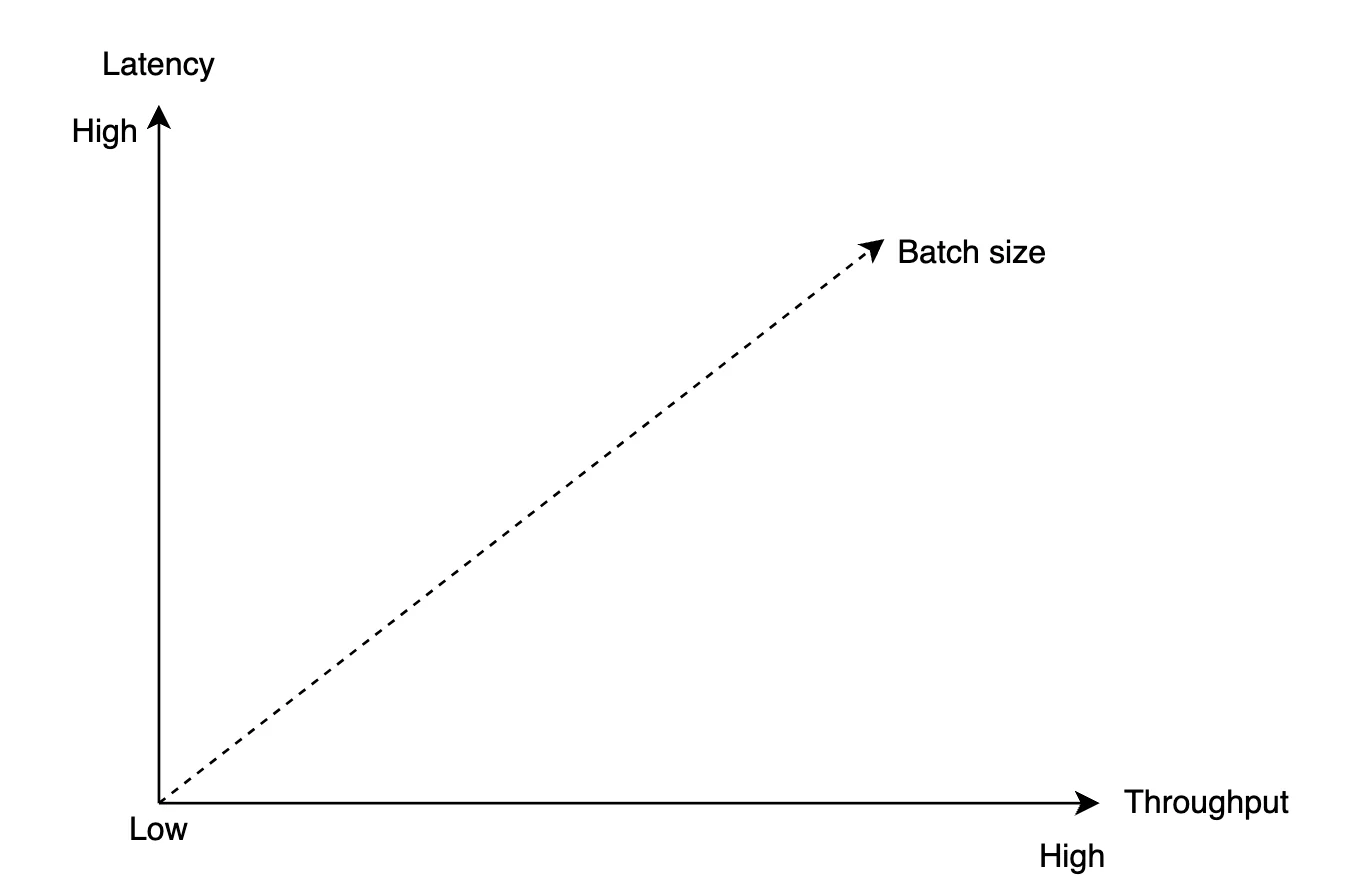
- 批量越大,批次提交前的等待时间越长。
- 批量越小,请求发出得越早、延迟越低,但吞吐量也越低。
消费者流程
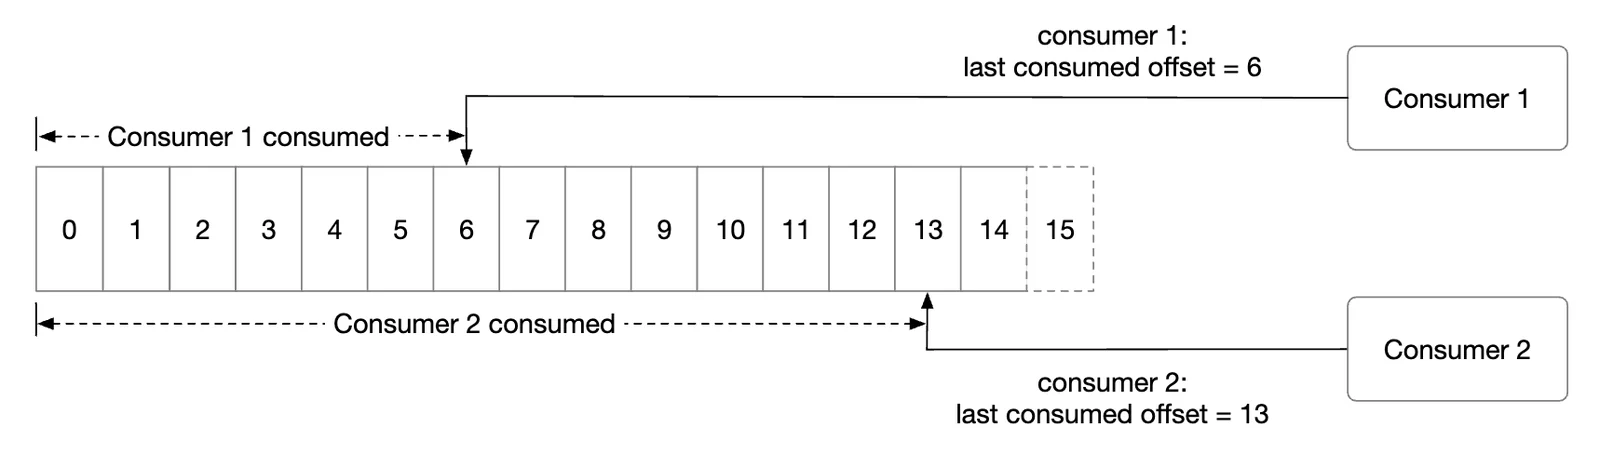
消费者指定它在某个分区中的偏移量,然后从该偏移量开始接收一批消息:
设计消费者时一个重要的考虑是:采用推模型还是拉模型:
- 推模型(Push):延迟更低,因为 broker 一收到消息就会将其推送给消费者。
- 但是,如果消费速率跟不上生产速率,消费者可能会被压垮。
- 由于是 broker 控制消费速率,因此很难应对处理能力各不相同的消费者。
- 拉模型(Pull):由消费者控制消费速率。
- 如果消费速率较慢,消费者不会被压垮,我们可以对其扩容以追上进度。
- 拉模型更适合批处理,因为在推模型下,broker 无法知道一个消费者能处理多少消息。
- 而在拉模型下,消费者可以积极地拉取大批量消息。
- 缺点是延迟更高,并且在没有新消息时会产生额外的网络调用。后一个问题可以用长轮询(Long Polling)来缓解。
因此,大多数消息队列(包括我们)都选择拉模型。
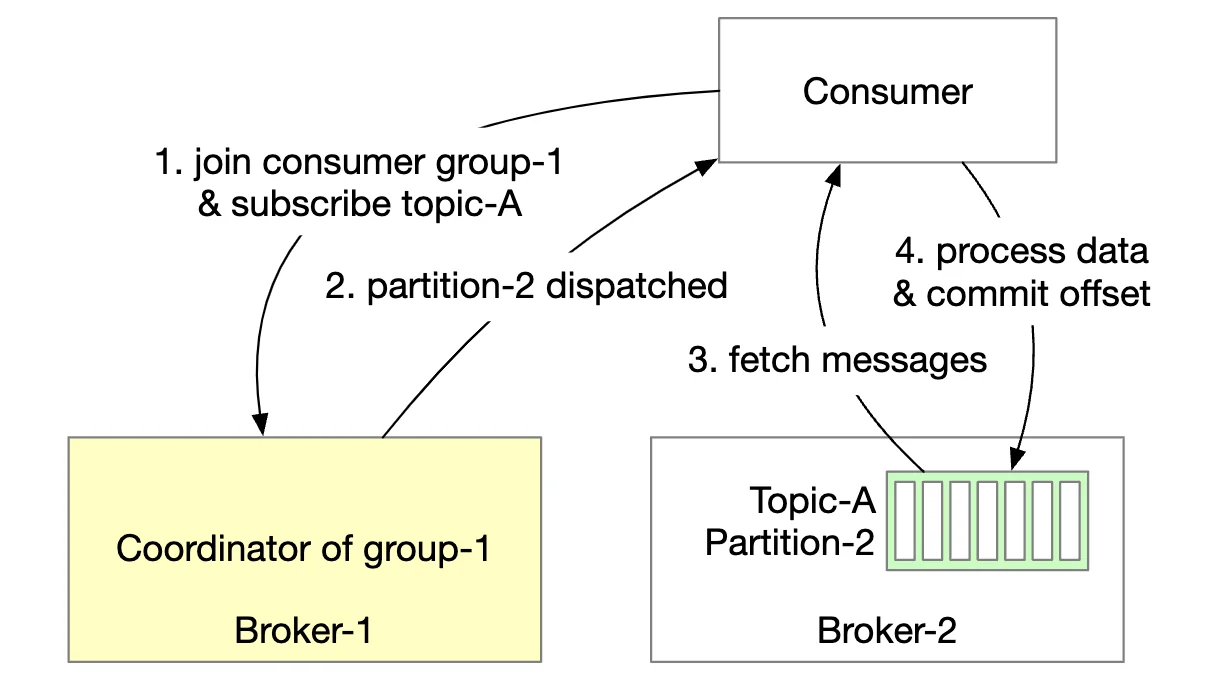
- 一个新的消费者订阅主题 A 并加入组 1。
- 通过对组名进行哈希来找到对应的 broker 节点。这样,同一组内的所有消费者都会连接到同一个 broker。
- 注意,这个消费者组协调者与协调服务(ZooKeeper)是不同的。
- 协调者确认该消费者已加入组,并将分区 2 分配给它。
- 分区分配有多种策略:轮询(round-robin)、范围(range)等。
- 消费者从上次的偏移量开始拉取最新消息。状态存储保存着消费者的偏移量。
- 消费者处理消息,并向 broker 提交偏移量。这两个操作的先后顺序会影响消息投递语义。
消费者再均衡
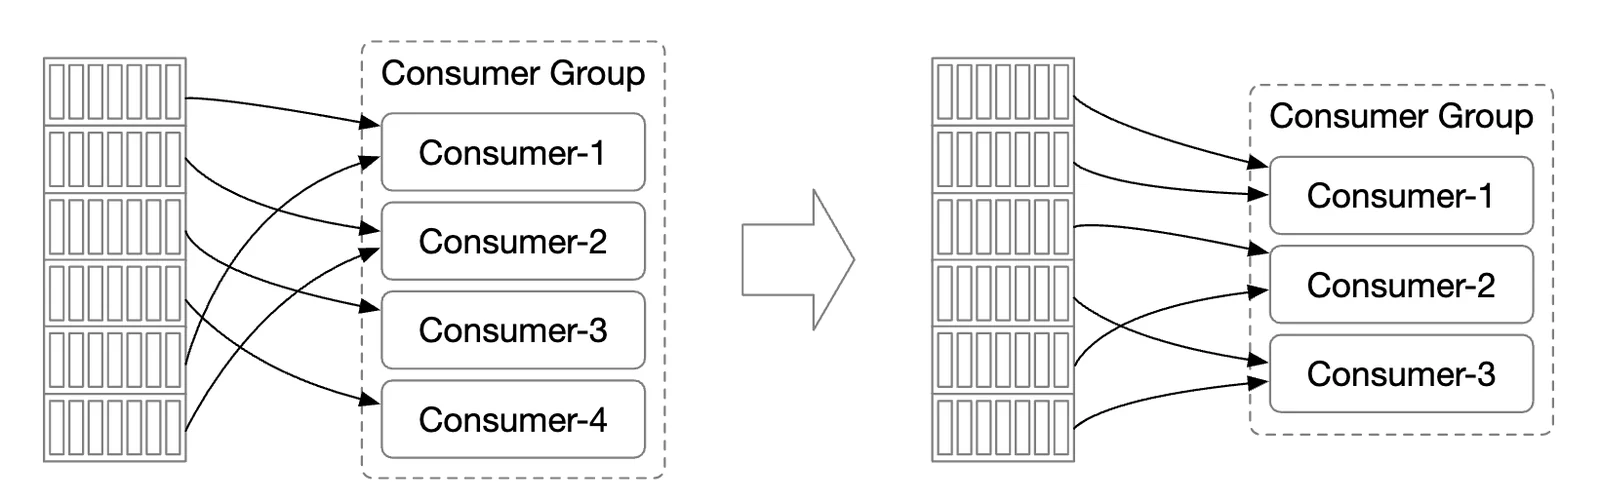
消费者再均衡(Consumer Rebalancing)负责决定由哪个消费者负责哪个分区。
当有消费者加入 / 离开,或者有分区被添加 / 移除时,就会发生这一过程。
作为协调者的 broker 在编排再均衡流程中起着重要作用。
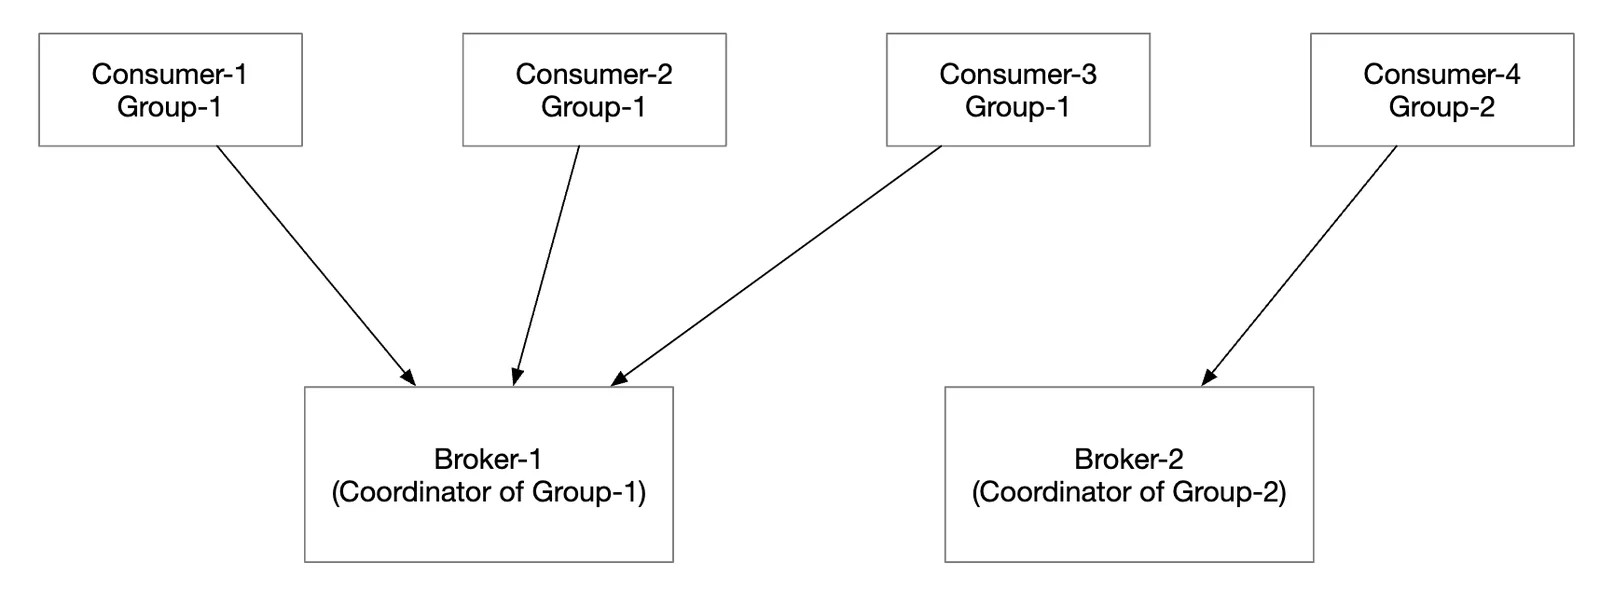
- 同一组内的所有消费者都连接到同一个协调者。协调者通过对组名进行哈希来确定。
- 当消费者列表发生变化时,协调者会为该组选出一个新的 leader。
- 组 leader 计算新的分区分派方案,并将其报告给协调者,再由协调者广播给其他消费者。
当协调者不再收到组内消费者的心跳时,就会触发再均衡:
我们来看看当一个消费者加入组时会发生什么:
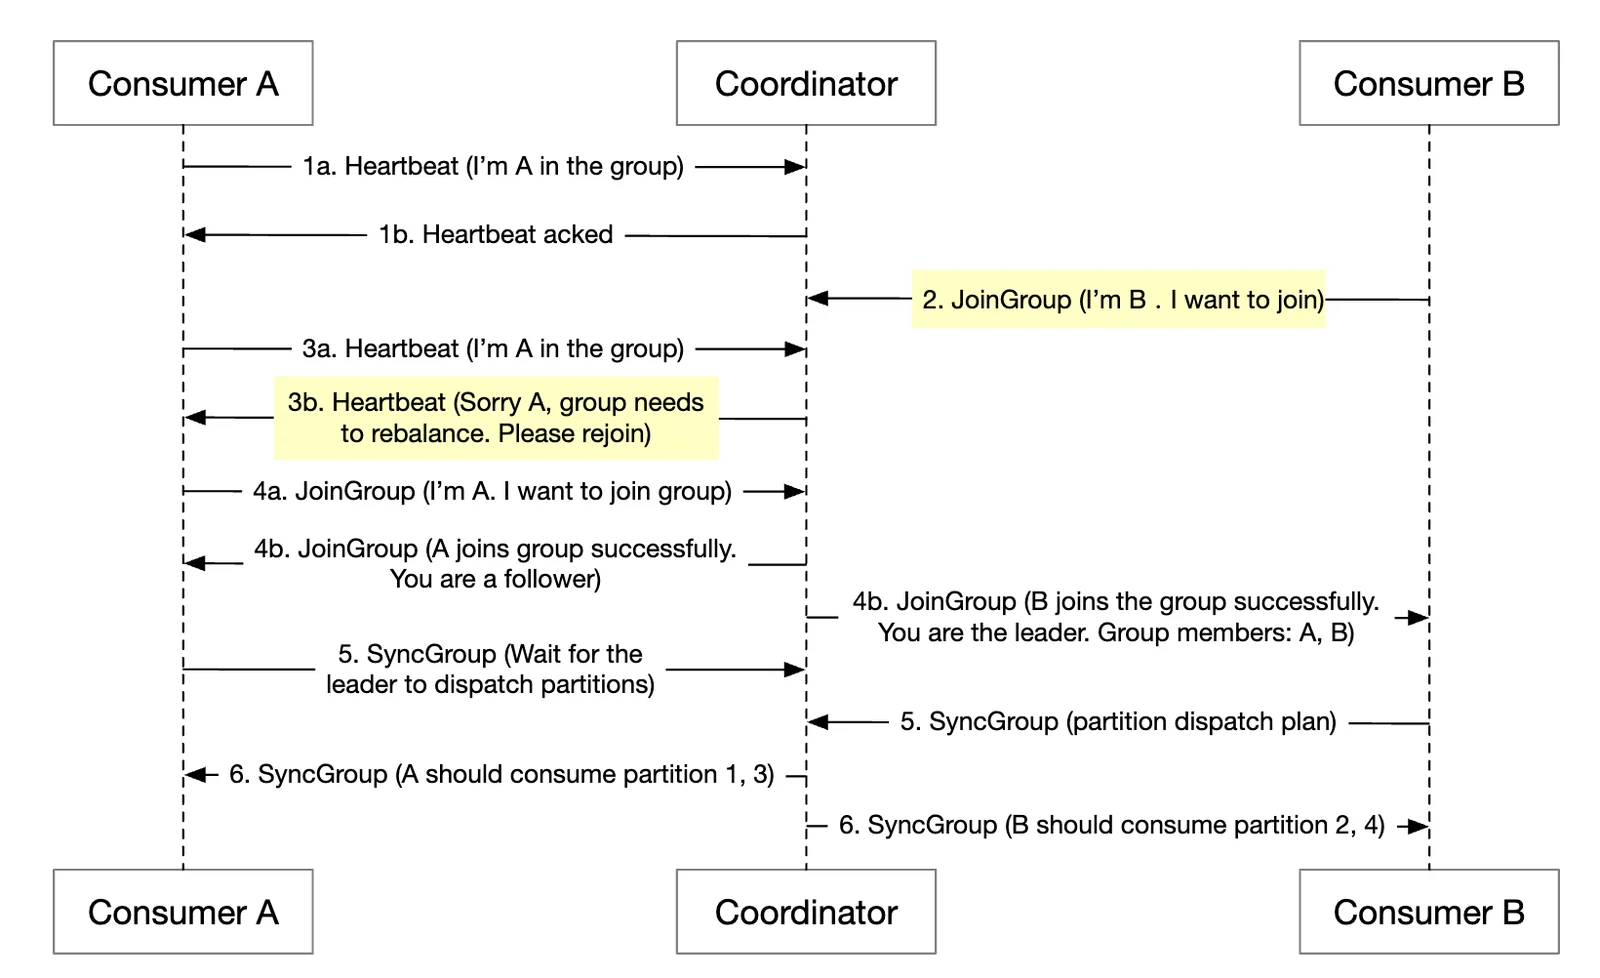
- 最初,组内只有消费者 A,它消费所有分区。
- 消费者 B 发送加入该组的请求。
- 协调者以被动方式(作为心跳的响应)通知所有组成员是时候进行再均衡了。
- 所有消费者重新加入组后,协调者选出一个 leader,并将选举结果通知其余成员。
- leader 生成分区分派方案并发送给协调者,其他成员等待分派方案。
- 消费者开始从新分配的分区消费。
下面是一个消费者离开组时发生的情况:
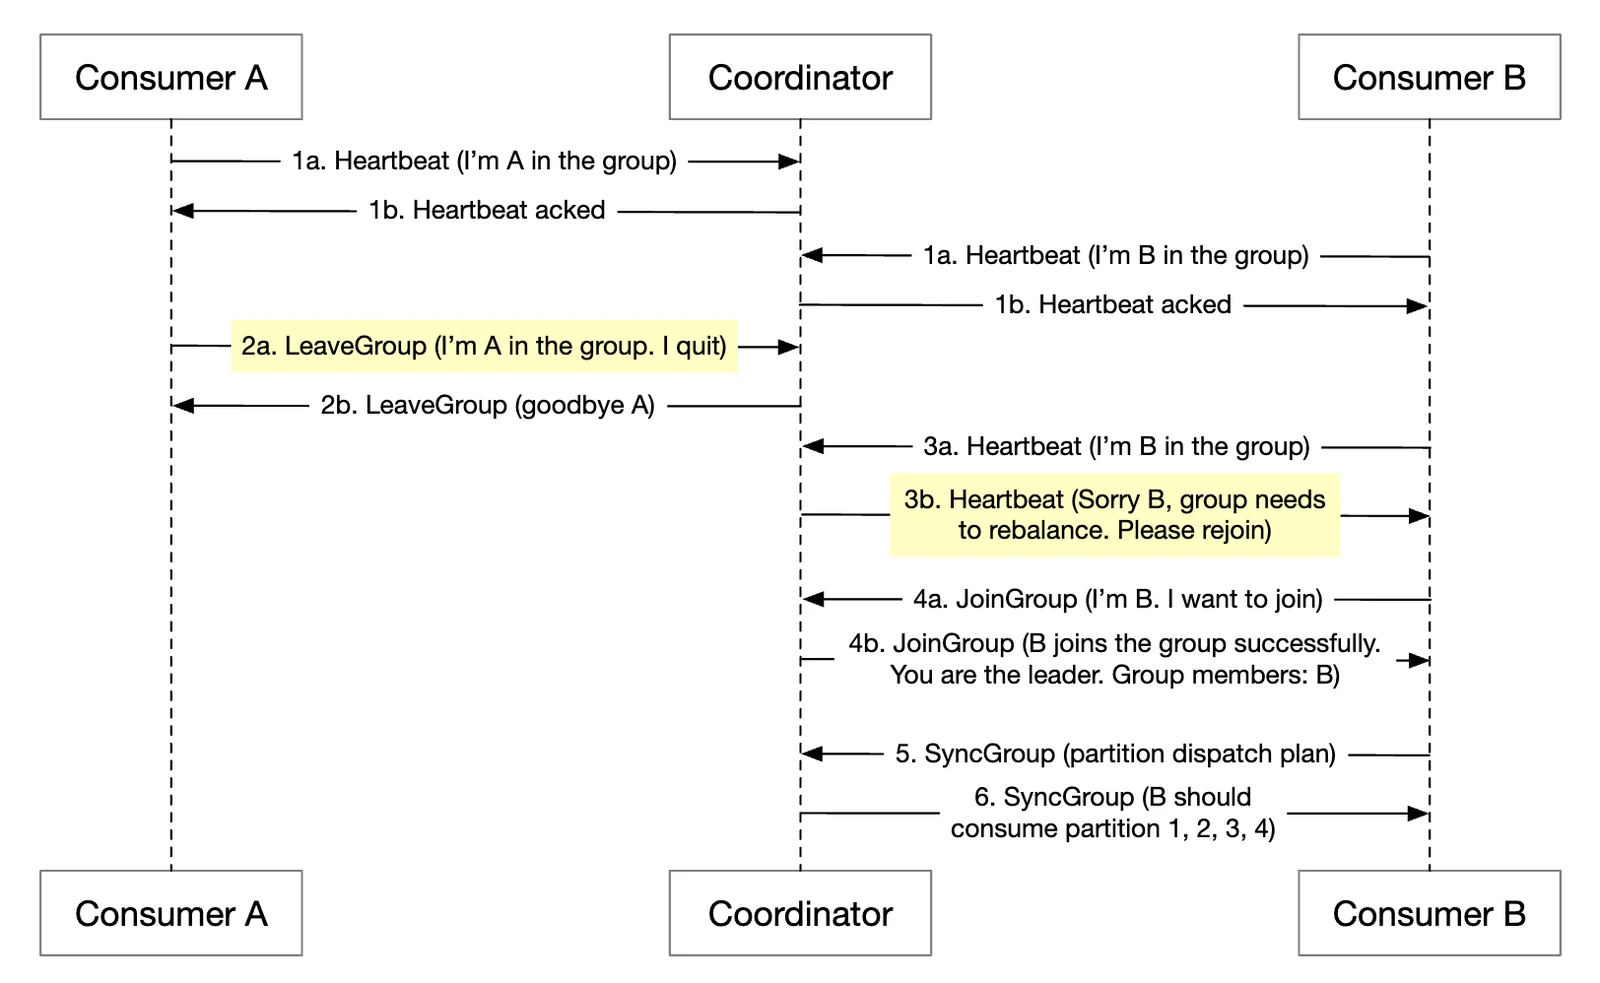
- 消费者 A 和 B 在同一个组中
- 消费者 B 请求离开该组
- 当协调者收到 A 的心跳时,会告知它是时候进行再均衡了。
- 其余步骤与前面相同。
当某个消费者长时间没有发送心跳时,过程也类似:
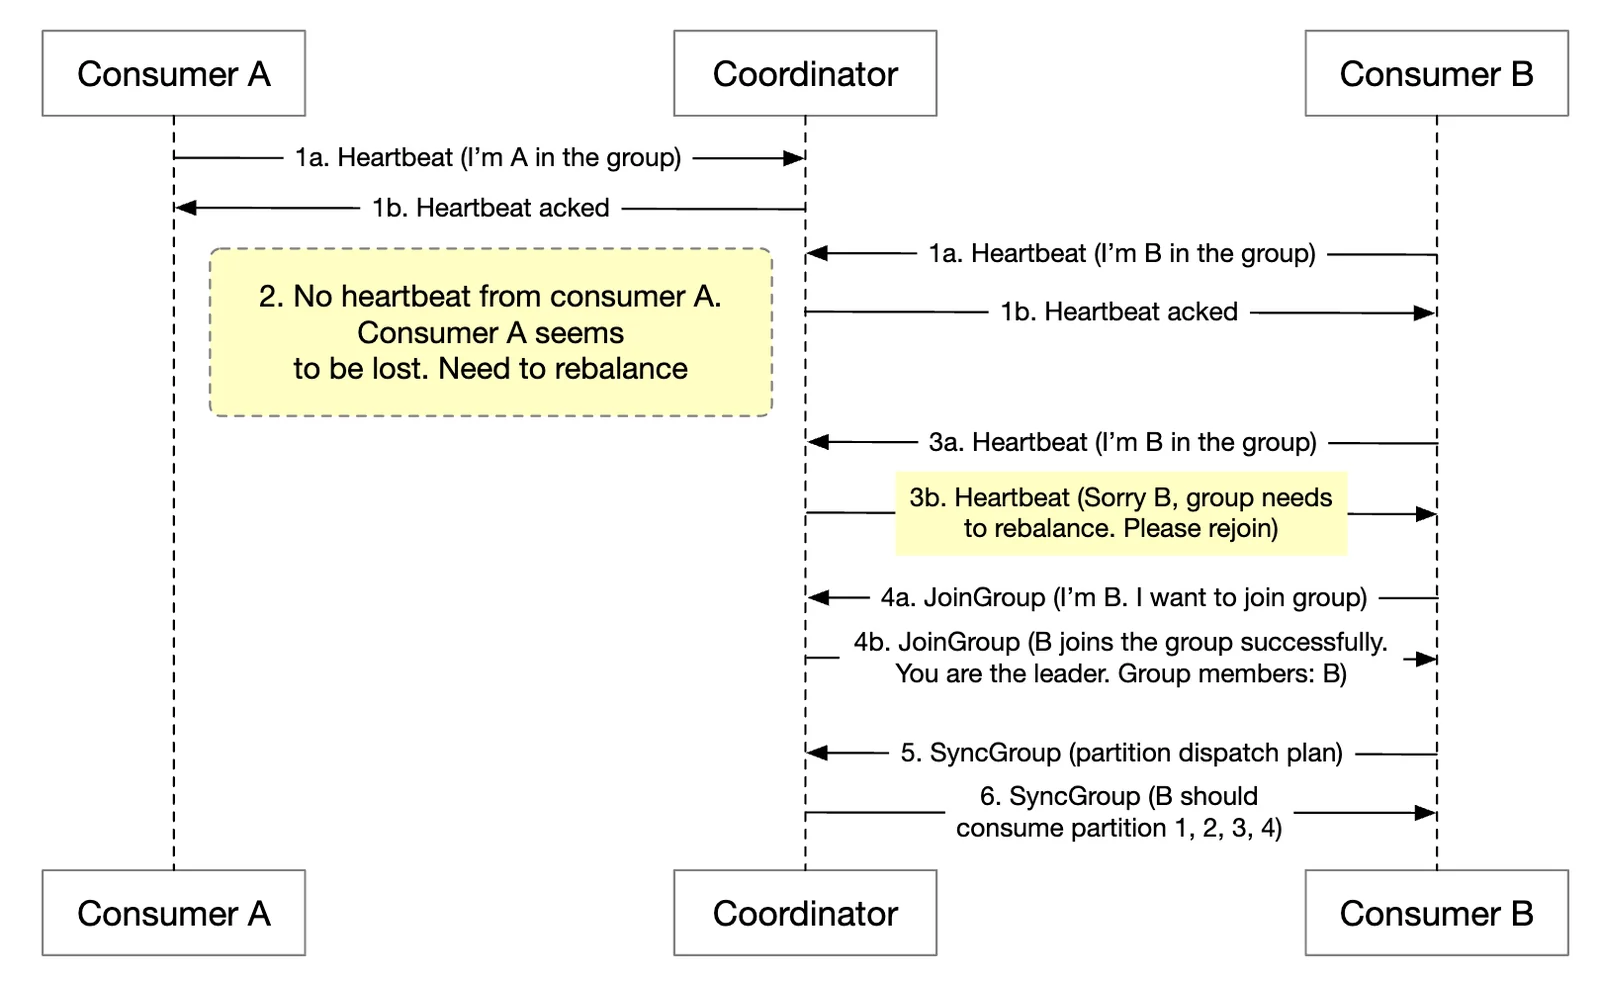
状态存储
状态存储保存分区与消费者之间的映射关系,以及每个分区最后被消费的偏移量。
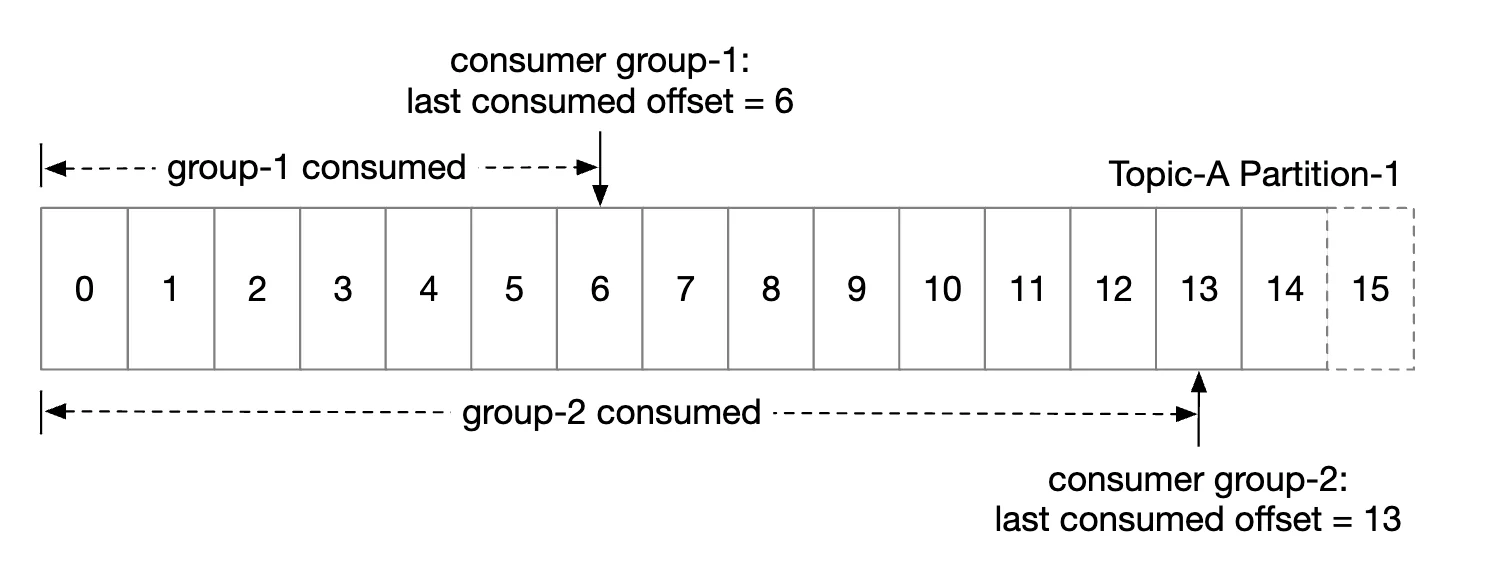
组 1 的偏移量为 6,意味着之前的所有消息都已被消费。如果某个消费者崩溃,新的消费者将从该消息开始继续消费。
消费者状态的数据访问模式:
- 读写操作频繁,但数据量小
- 数据更新频繁,但很少删除
- 随机读写
- 数据一致性很重要
基于这些需求,像 Zookeeper 这样的快速 KV 存储是理想的选择。
元数据存储
元数据存储保存配置和主题属性:分区数量、保留期限、副本分布。
元数据不常变化且数据量小,但对一致性有很高的要求。 Zookeeper 是这一存储的不错选择。
ZooKeeper
Zookeeper 对构建分布式消息队列至关重要。
它是一个层次化的键值存储,通常用于分布式配置、同步服务和命名注册(即服务发现)。
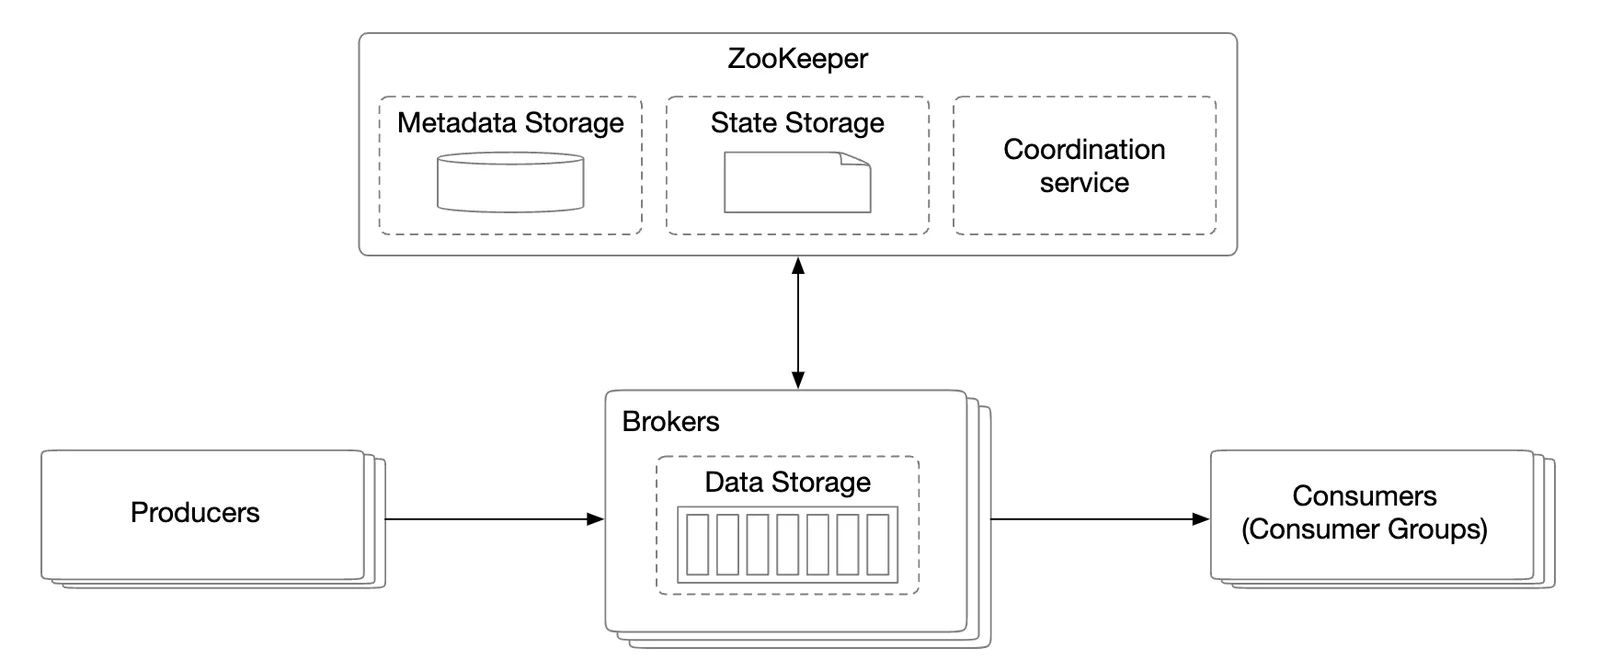
有了这一改变,broker 只需维护消息数据。元数据和状态存储都放在 Zookeeper 中。
Zookeeper 还能帮助完成 broker 副本的领导者选举。
复制
在分布式系统中,硬件问题不可避免。我们可以通过复制(Replication)来应对,以实现高可用。
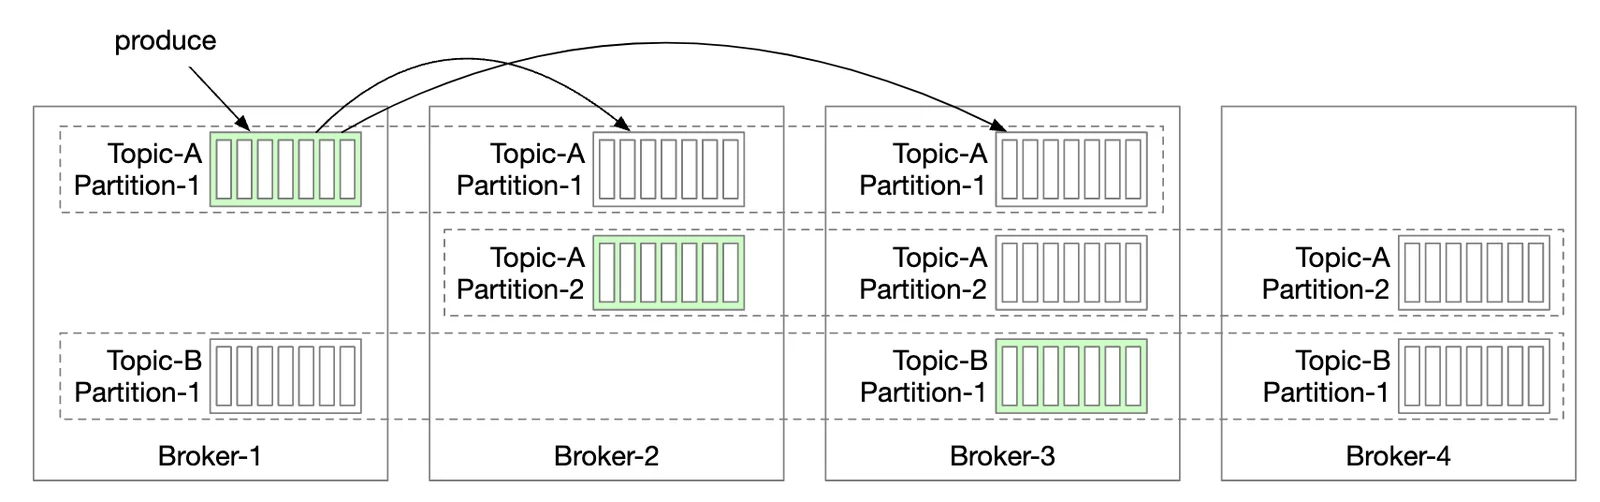
- 每个分区都会被复制到多个 broker 上,但只有一个 leader 副本。
- 生产者将消息发送给 leader 副本
- follower 从 leader 拉取要复制的消息
- 一旦有足够多的副本完成同步,leader 就向生产者返回确认
- 每个分区的副本分布称为副本分布方案。
- 给定分区的 leader 创建副本分布方案,并将其保存在 Zookeeper 中
同步副本
我们需要解决的一个问题是:对于给定分区,如何保持 leader 与 follower 之间的消息同步。
同步副本(In-Sync Replicas,ISR)是指某个分区中与 leader 保持同步的副本。
replica.lag.max.messages 定义了一个副本最多可以落后 leader 多少条消息,仍被视为处于同步状态。
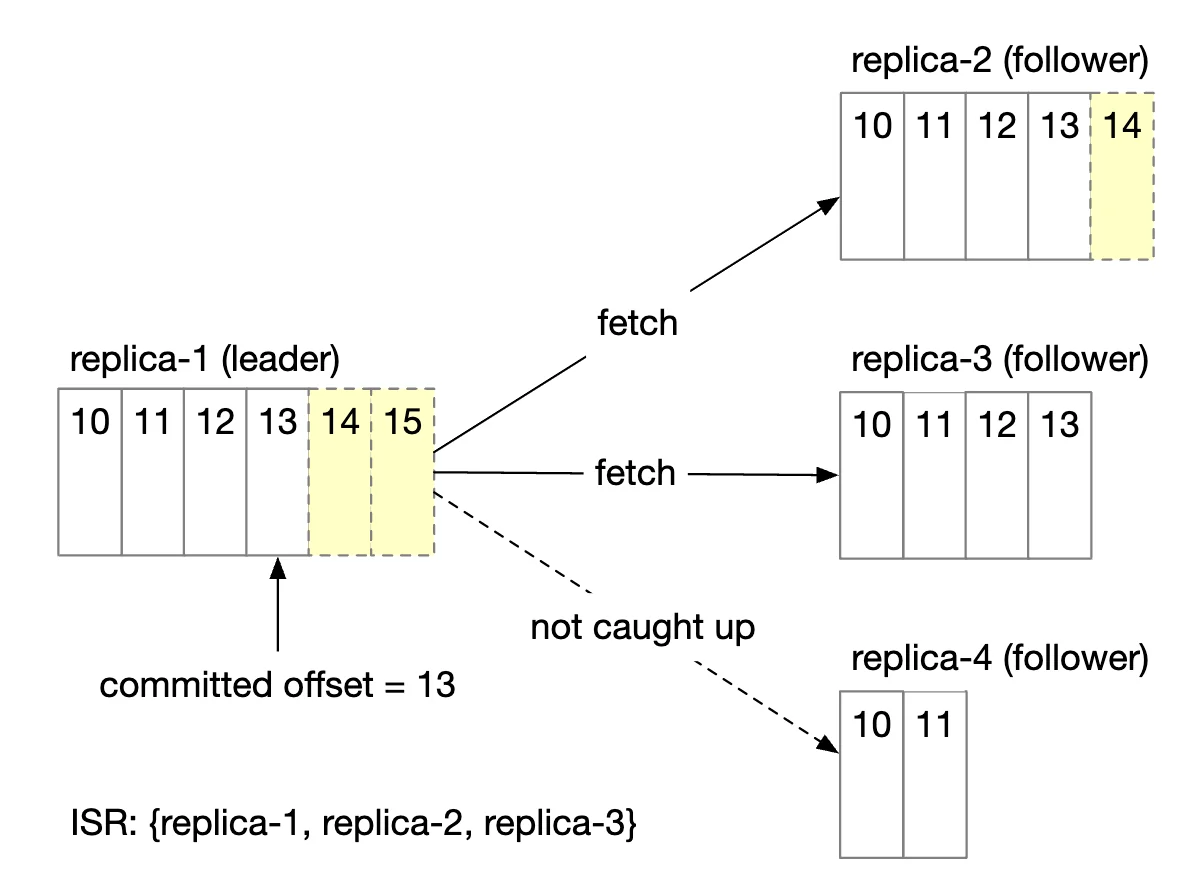
- 已提交的偏移量是 13
- 有两条新消息写入了 leader,但尚未提交。
- 一旦 ISR 中的所有副本都同步了某条消息,该消息就被提交
- 副本 2 和 3 已完全追上 leader,因此它们在 ISR 中
- 副本 4 落后了,因此暂时被移出 ISR
ISR 体现了性能与持久性之间的权衡。
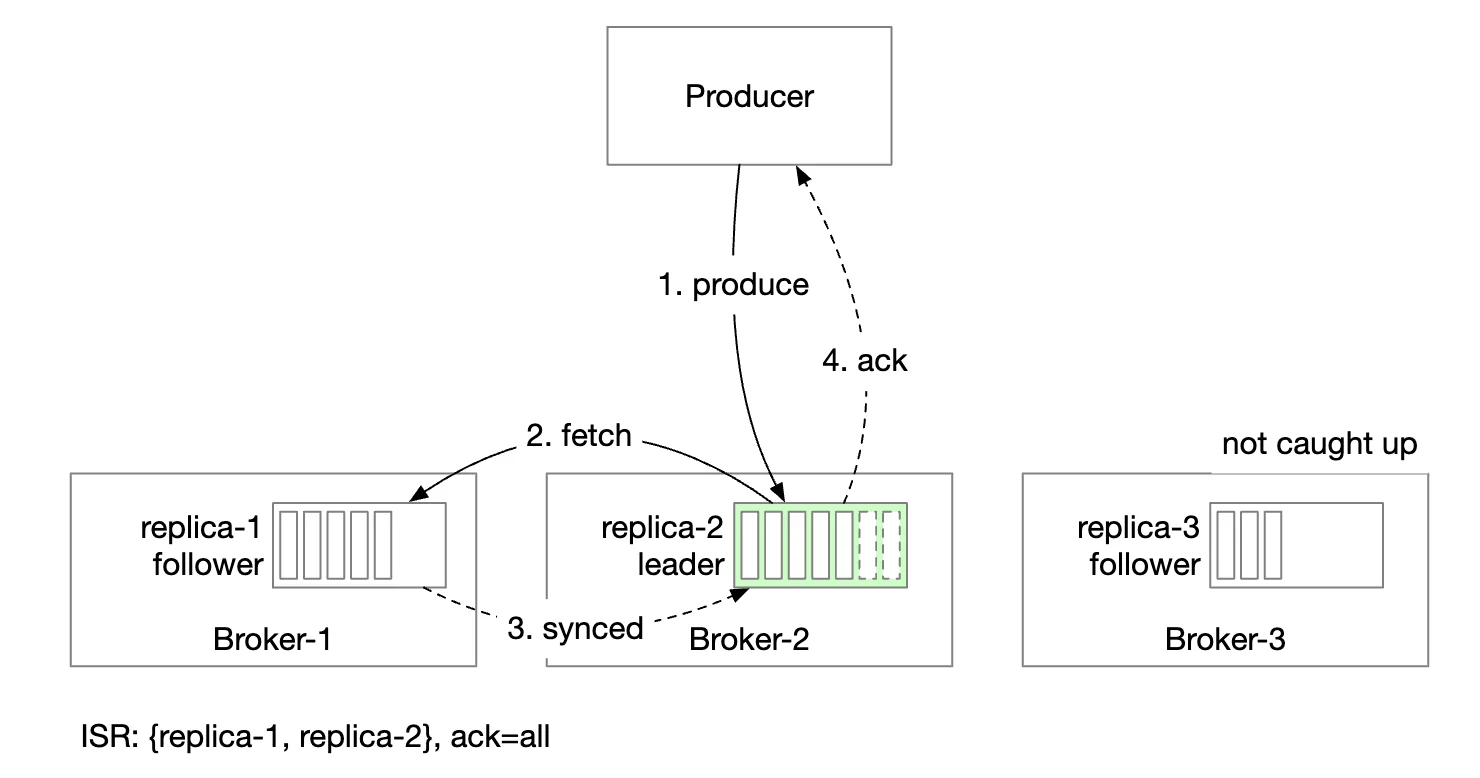
- 为了让生产者不丢失消息,所有副本都应在发送确认之前完成同步
- 但一个慢副本会导致整个分区变得不可用
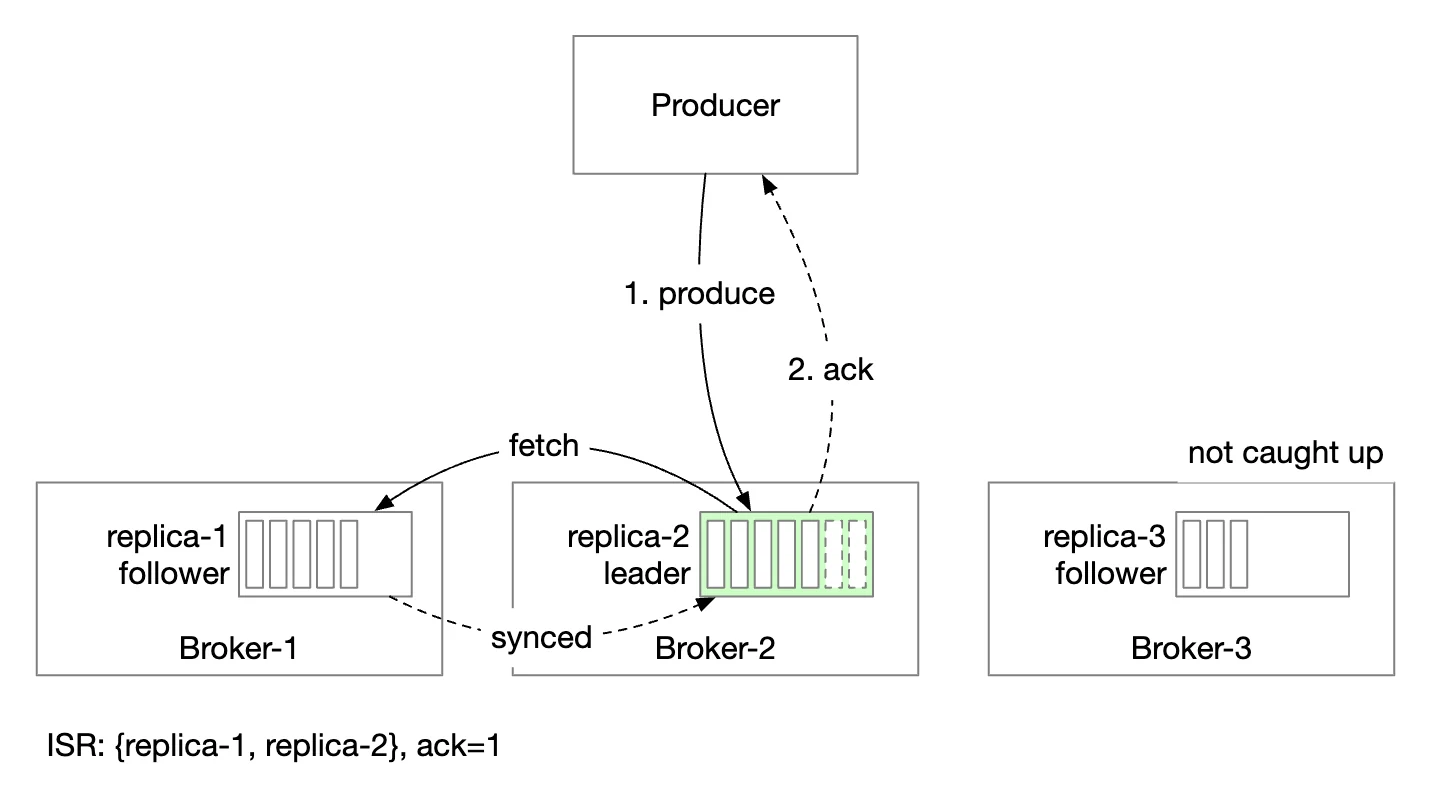
确认(Acknowledgment)的处理方式是可配置的。
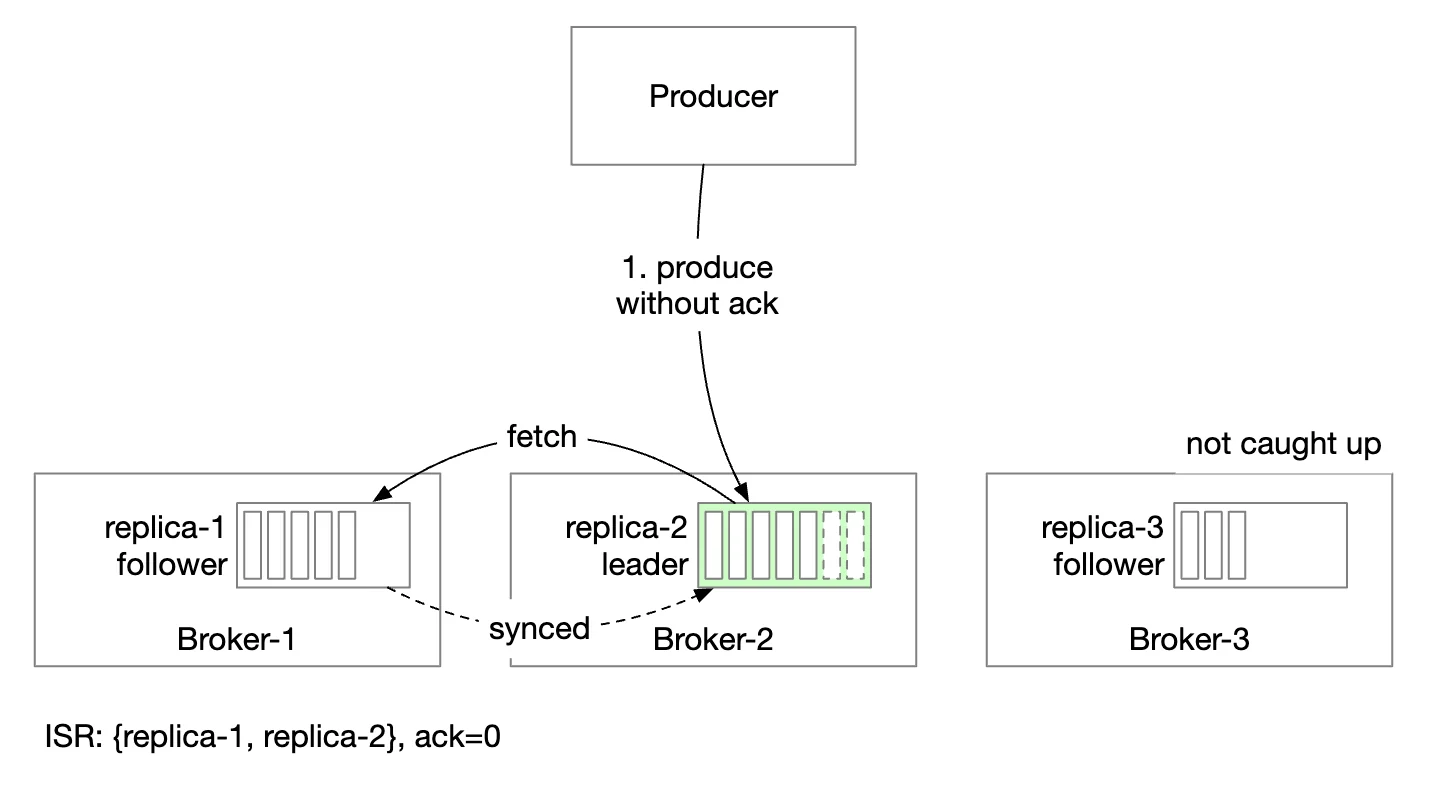
ACK=all 表示 ISR 中的所有副本都必须同步该消息。消息发送较慢,但消息的持久性最高。
ACK=1 表示一旦 leader 收到消息,生产者就会收到确认。消息发送较快,但消息的持久性较低。
ACK=0 表示生产者发送消息时不等待 leader 的任何确认。消息发送最快,消息的持久性最低。
在消费者一侧,我们可以让所有消费者都连接到分区的 leader,并从 leader 读取消息:
- 这是最简单的设计,运维也最容易
- 一个分区中的消息只会发送给组内的一个消费者,这限制了连接到 leader 副本的连接数
- 只要主题不是特别热门,连接到 leader 副本的连接数通常不会很高
- 对于热门主题,我们可以通过增加分区数和消费者数来扩展
- 在某些场景下,让消费者从 ISR 读取消息可能是合理的,例如消费者位于另一个数据中心时
ISR 列表由 leader 维护,它会跟踪自身与每个副本之间的延迟。
可扩展性
我们来评估一下如何扩展系统的各个部分。
生产者
生产者比消费者简单得多。只需增加 / 移除生产者实例,就能轻松实现其可扩展性。
消费者
消费者组之间彼此隔离,可以随意添加 / 移除消费者组。
再均衡有助于优雅地处理组内消费者被添加 / 移除的情况。
消费者组和再均衡帮助我们实现了可扩展性和容错性。
Broker
broker 如何处理故障?
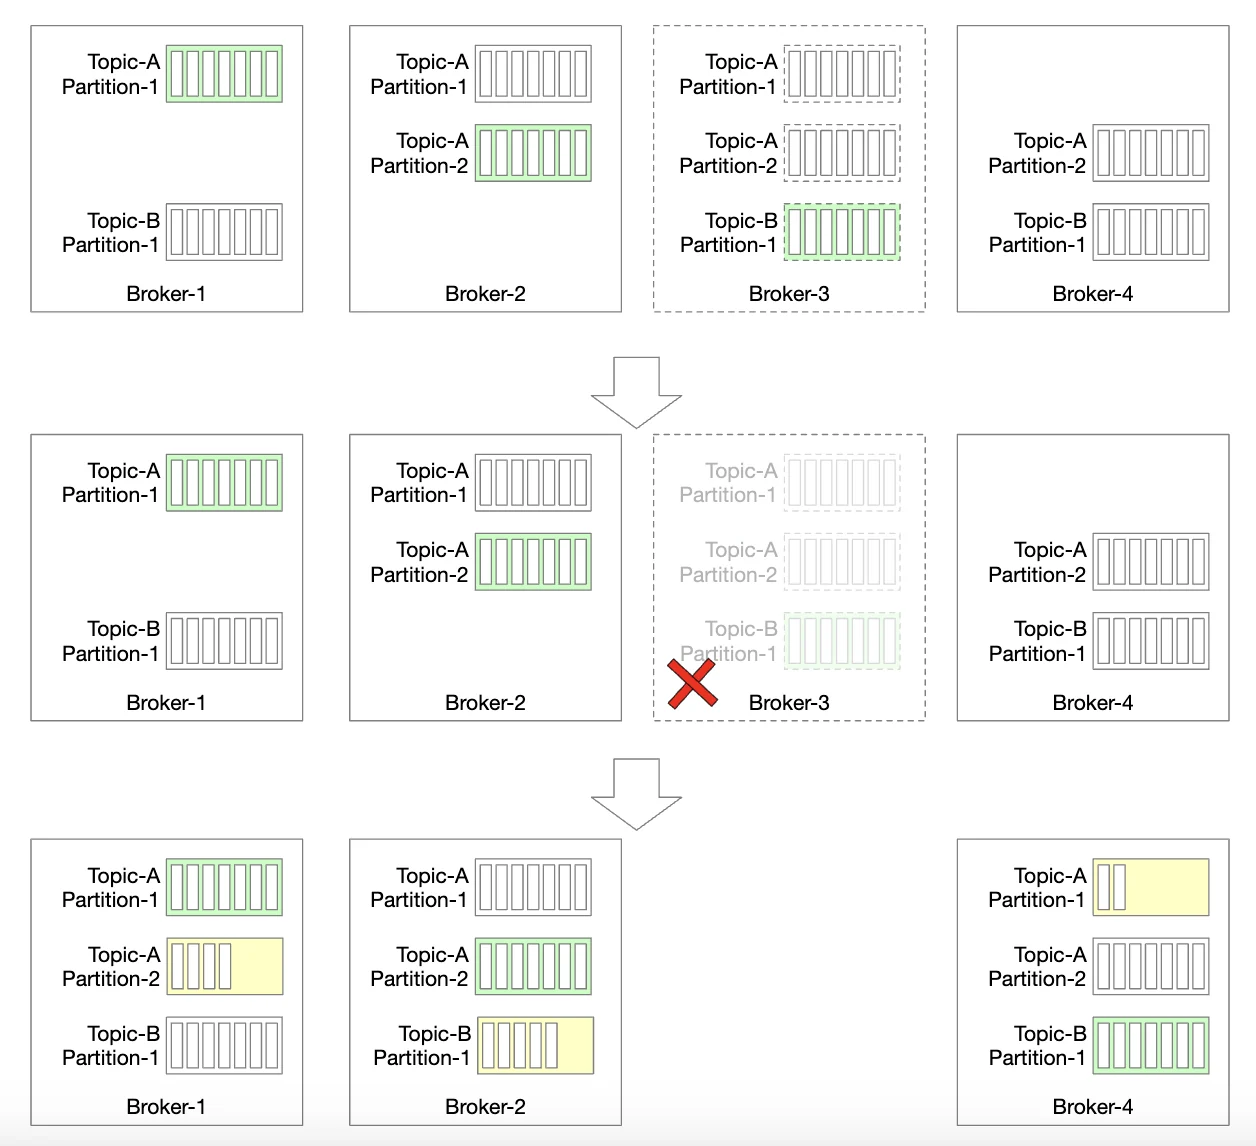
- 一旦某个 broker 发生故障,仍有足够的副本来避免分区数据丢失
- 选出新的 leader,broker 协调者将原来位于故障 broker 上的分区重新分配给现有副本
- 现有副本接手新的分区,并作为 follower 工作,直到追上 leader 并成为 ISR
让 broker 具备容错能力的其他考虑:
- ISR 的最小数量需要在延迟与安全性之间取得平衡。你可以根据需要对其进行微调。
- 如果一个分区的所有副本都在同一个节点上,那就是资源浪费。副本应当分布在不同的 broker 上。
- 如果一个分区的所有副本都崩溃了,数据就永久丢失了。将副本分散到多个数据中心会有所帮助,但会显著增加延迟。一种变通方案是使用数据镜像(Data Mirroring)。
当添加新的 broker 时,我们如何处理副本的重新分配?
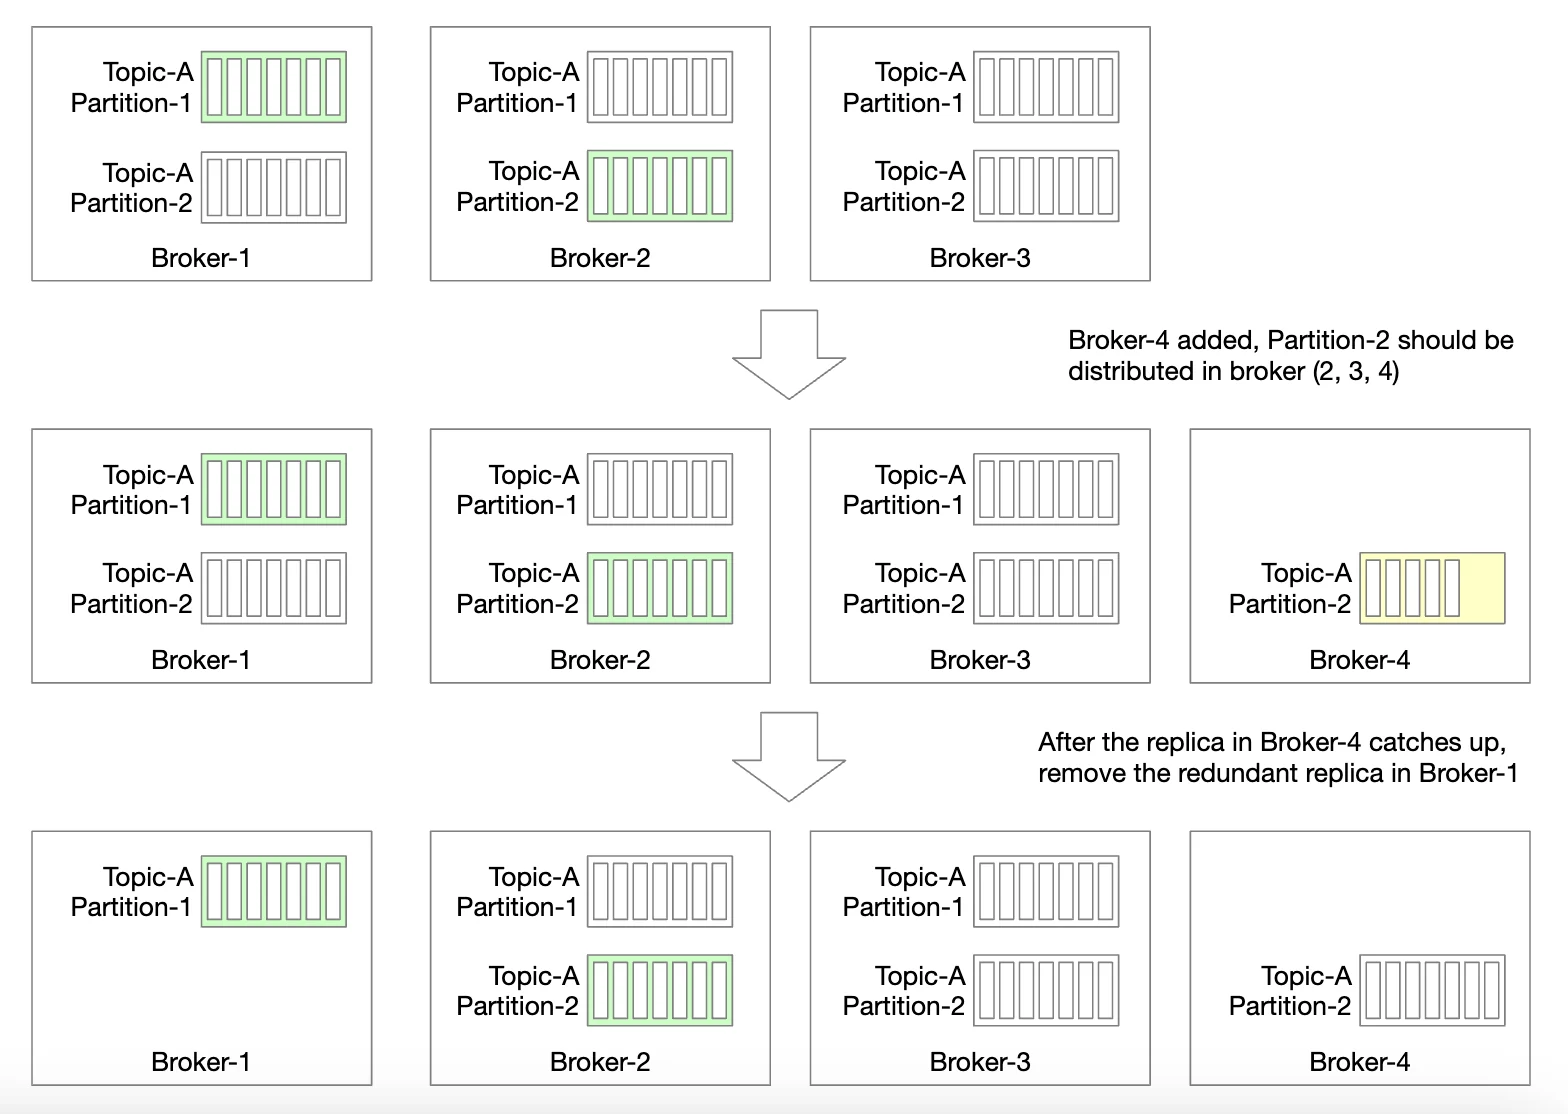
- 我们可以暂时允许副本数量多于配置值,直到新 broker 追上进度
- 一旦追上,就可以移除不再需要的分区副本
分区
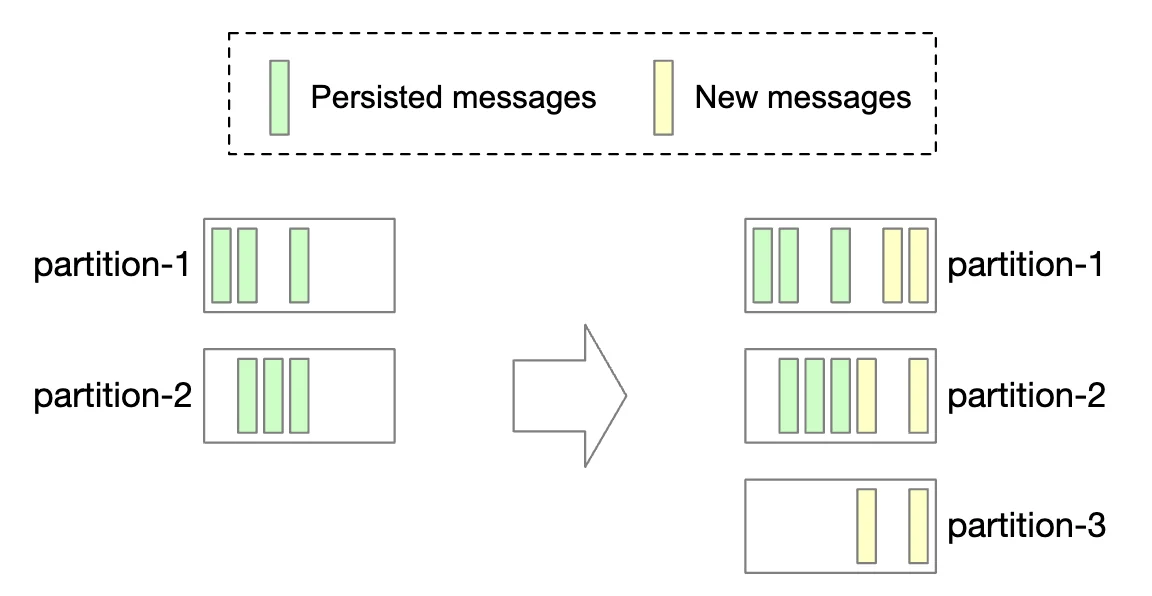
每当添加一个新分区时,生产者都会收到通知,并触发消费者再均衡。
在数据存储方面,我们可以只把新消息存储到新分区中,而不是尝试复制所有旧消息:
减少分区数量则要复杂一些:
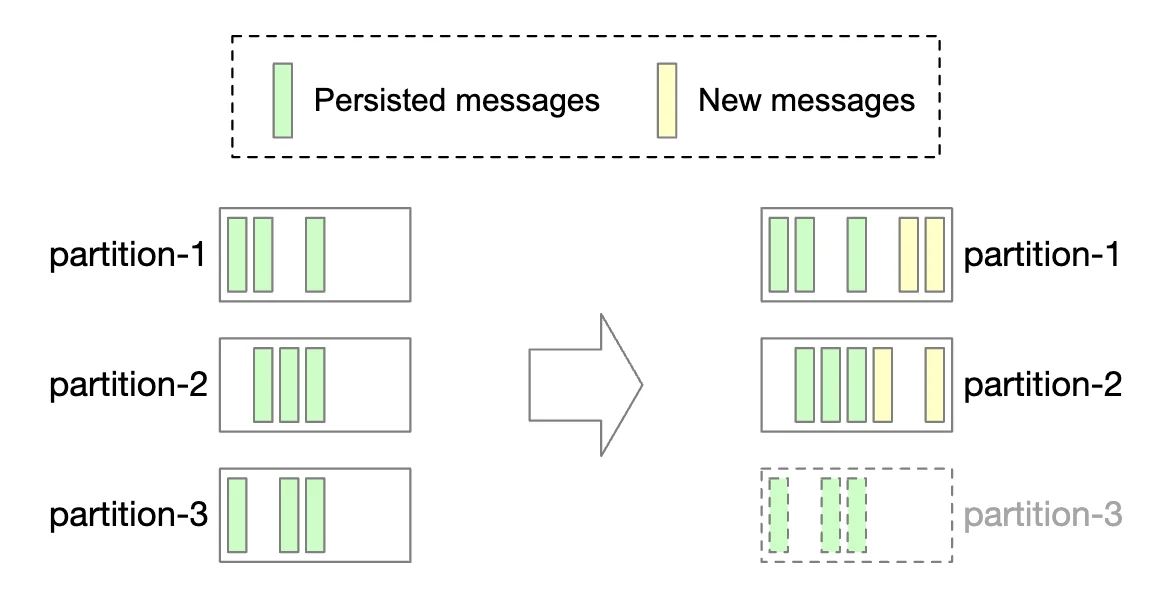
- 一旦某个分区被下线,新消息就只会由剩余的分区接收
- 被下线的分区不会立即被删除,因为仍然可以从中消费消息
- 只有在预先配置的保留期限过去之后,我们才会截断数据并释放存储空间
- 在过渡期内,生产者只向活跃分区发送消息,但消费者会从所有分区读取
- 保留期限到期后,再对消费者进行再均衡
数据投递语义
我们来讨论不同的投递语义。
最多一次
在这种保证下,消息最多投递一次,也可能根本不会被投递。
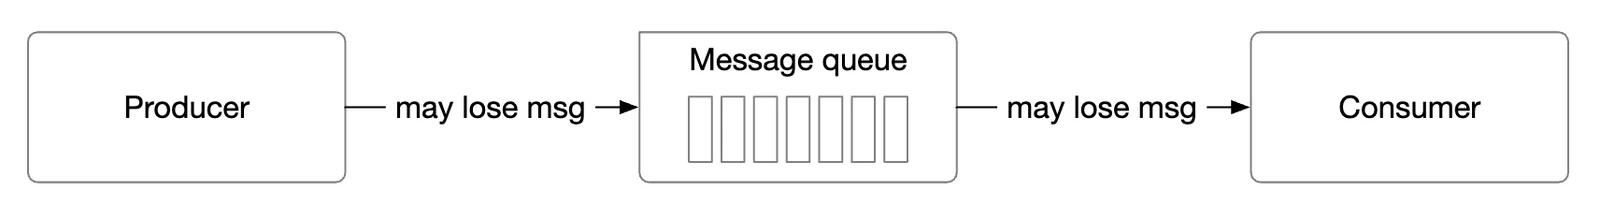
- 生产者异步地向主题发送消息。如果消息投递失败,不会重试。
- 消费者拉取消息后立即提交偏移量。如果消费者在处理消息之前崩溃,该消息将不会被处理。
至少一次
一条消息可以被发送多次,但不应有任何消息未被处理。
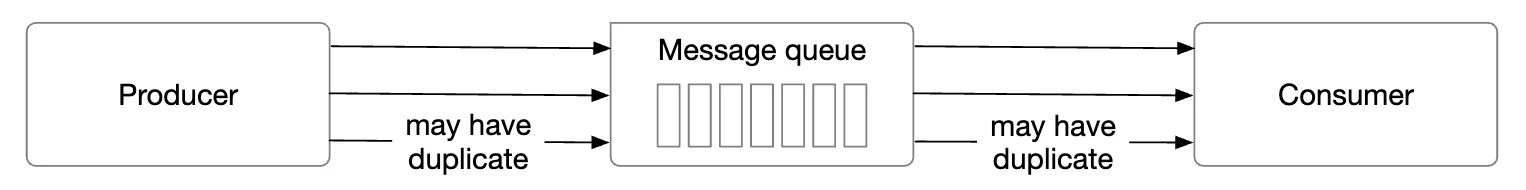
- 生产者以
ack=1或ack=all发送消息。如果出现任何问题,它会不断重试。 - 消费者拉取消息,并且只在处理完成后才提交偏移量。
- 一条消息有可能被投递多次,例如消费者在处理完消息之后、提交偏移量之前崩溃。
- 因此,这种语义适合可以接受数据重复或能够去重的场景。
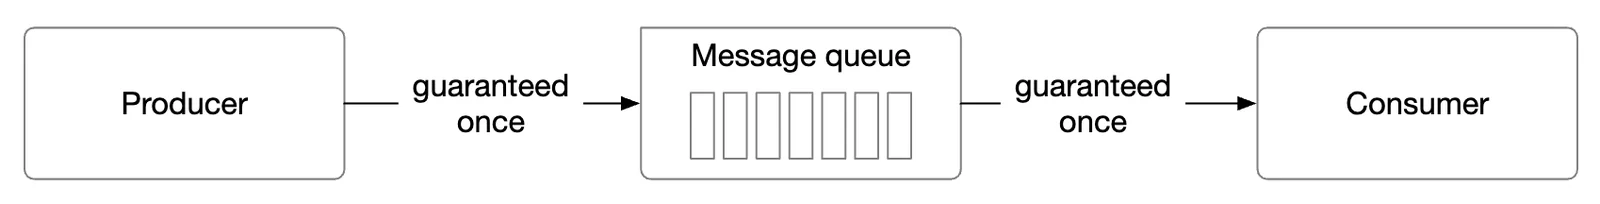
恰好一次
对系统来说,实现这种语义的代价极高,尽管它是对用户最友好的保证:
高级功能
我们来讨论一些在面试中可能会谈到的高级功能。
消息过滤
有些消费者可能只想消费分区内某种特定类型的消息。
这可以通过为每个消息子集建立单独的主题来实现,但如果系统有太多不同的使用场景,代价会很高。
- 在不同的主题上存储同一条消息是一种资源浪费
- 生产者与消费者紧密耦合,因为每当有新的消费者需求时,生产者都要随之改变
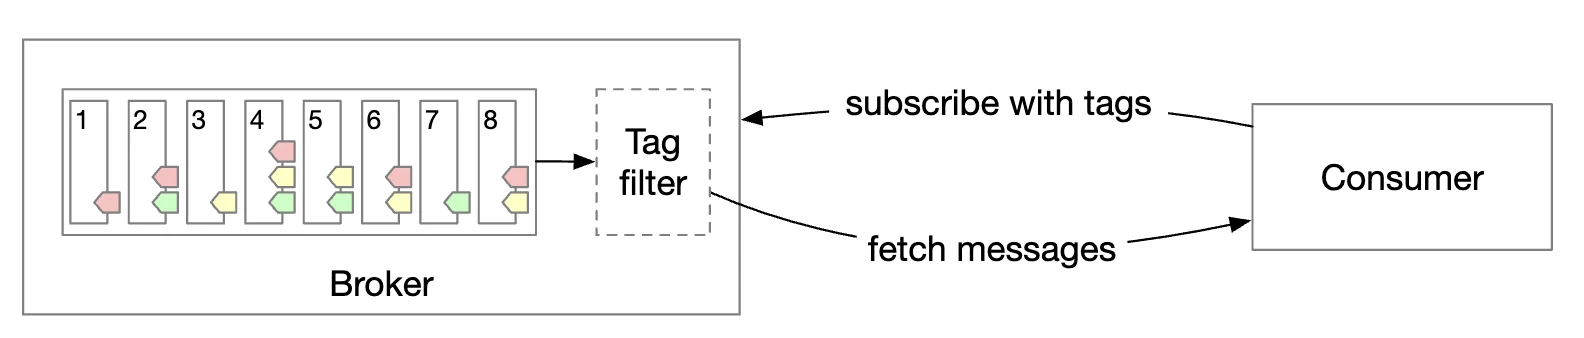
我们可以用消息过滤来解决这个问题。
- 一种朴素的做法是在消费者一侧进行过滤,但这会带来不必要的消费者流量
- 另一种做法是给消息附加标签(Tag),由消费者指定自己订阅哪些标签
- 也可以根据消息负载进行过滤,但对于加密 / 序列化过的消息,这既有难度也不安全
- 对于更复杂的数学公式,broker 可以实现一个语法解析器或脚本执行器,但这对消息队列来说可能太重了
延迟消息与定时消息
在某些场景下,我们可能希望延迟或定时投递消息。 例如,我们可以提交一个在 30 分钟后执行的支付核验检查,届时触发消费者去查看支付是否成功。
这可以通过将消息先发送到 broker 中的临时存储,在合适的时间再把消息移到分区中来实现:
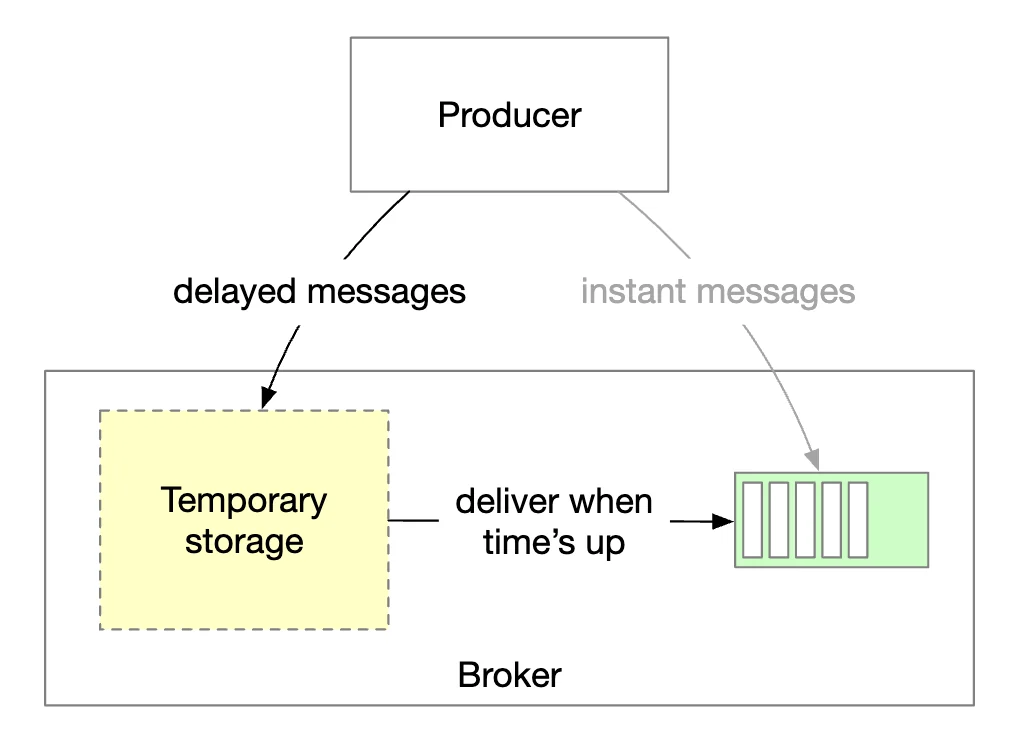
- 临时存储可以是一个或多个特殊的消息主题
- 定时功能可以通过专用的延迟队列或分层时间轮(Hierarchical Time Wheel)来实现
第 4 步:总结
其他可以讨论的要点:
- 通信协议:重要的考虑包括支持所有使用场景和大数据量,以及校验消息完整性。流行的协议有 AMQP 和 Kafka 协议。
- 重试消费:如果我们无法立即处理某条消息,可以把它发送到专门的重试主题,稍后再尝试。
- 历史数据归档:旧消息可以备份到 HDFS 或对象存储(例如 S3)这类大容量存储中。