第 20 章 指标监控和告警系统
引言
本章重点设计一个高度可扩展的指标监控和告警系统(Metrics Monitoring and Alerting System),它对于保障高可用性和可靠性至关重要。
第 1 步:理解问题并确定设计范围
指标监控系统可以指很多不同的东西,例如面试官只关心基础设施指标时,你可不想去设计一个日志聚合系统。
我们先来理解问题:
- 候选人:我们为谁构建这个系统?是大型科技公司的内部监控系统,还是像 DataDog 这样的 SaaS?
- 面试官:我们只供内部使用。
- 候选人:我们要收集哪些指标?
- 面试官:运行层面的系统指标,比如 CPU 负载、内存、数据磁盘空间。也包括每秒请求数这类高层指标。业务指标不在范围内。
- 候选人:我们要监控的基础设施规模有多大?
- 面试官:1 亿日活跃用户,1000 个服务器池,每个池 100 台机器。
- 候选人:数据要保留多久?
- 面试官:假设保留 1 年。
- 候选人:长期存储时可以降低指标数据的分辨率吗?
- 面试官:新收到的指标保留 7 天。之后 30 天内汇总(roll up)为 1 分钟分辨率。30 天之后进一步汇总为 1 小时分辨率。
- 候选人:支持哪些告警渠道?
- 面试官:电子邮件、电话、PagerDuty 或 webhook。
- 候选人:我们需要收集错误日志或访问日志之类的日志吗?
- 面试官:不需要。
- 候选人:我们需要支持分布式系统追踪吗?
- 面试官:不需要。
高层需求和假设
被监控的基础设施规模很大:
- 1 亿 DAU
- 1000 个服务器池 * 100 台机器 * 每台机器约 100 个指标 -> 约 1000 万个指标
- 数据保留 1 年
- 数据保留策略:原始数据保留 7 天,1 分钟分辨率保留 30 天,1 小时分辨率保留 1 年
可以监控的指标多种多样:
- CPU 负载
- 请求数
- 内存使用量
- 消息队列中的消息数
非功能需求
- 可扩展性:系统应当可扩展,以容纳更多的指标和告警
- 低延迟:系统需要为仪表盘和告警提供较低的查询延迟
- 可靠性:系统应当高度可靠,以避免漏掉关键告警
- 灵活性:系统应当能在未来方便地集成新技术
哪些需求不在范围内?
- 日志监控:ELK 技术栈在这个场景中非常流行
- 分布式系统追踪(Distributed System Tracing):指在请求流经系统内多个服务时,收集该请求生命周期相关的数据
第 2 步:提出高层设计并获得认可
基础知识
指标监控和告警系统涉及五个核心组件:
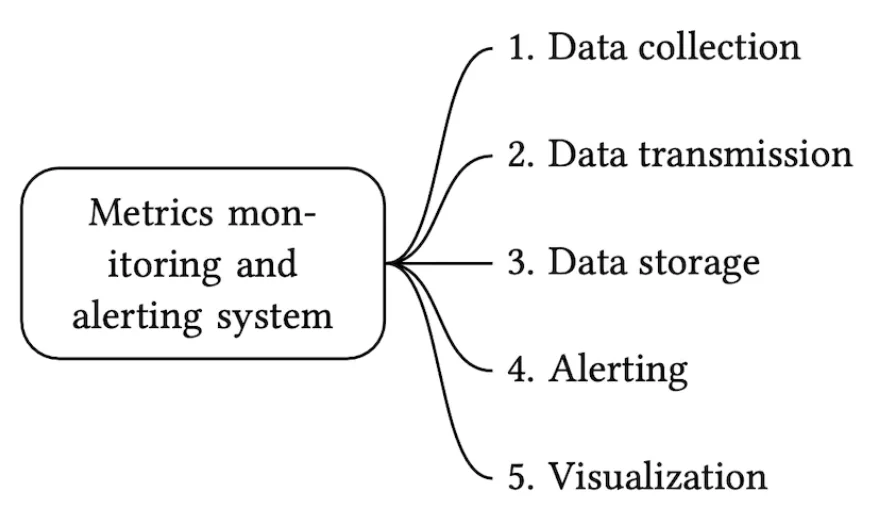
- 数据收集:从不同来源收集指标数据
- 数据传输:把数据从来源传送到指标监控系统
- 数据存储:组织并存储传入的数据
- 告警:分析传入的数据,检测异常并生成告警
- 可视化:以图形、图表等形式展示数据
数据模型
指标数据通常以时间序列(time-series)的形式记录,即一组带时间戳的值。 序列可以通过名称和一组可选的标签(tag)来标识。
示例 1:生产服务器实例 i631 在 20:00 时的 CPU 负载是多少?
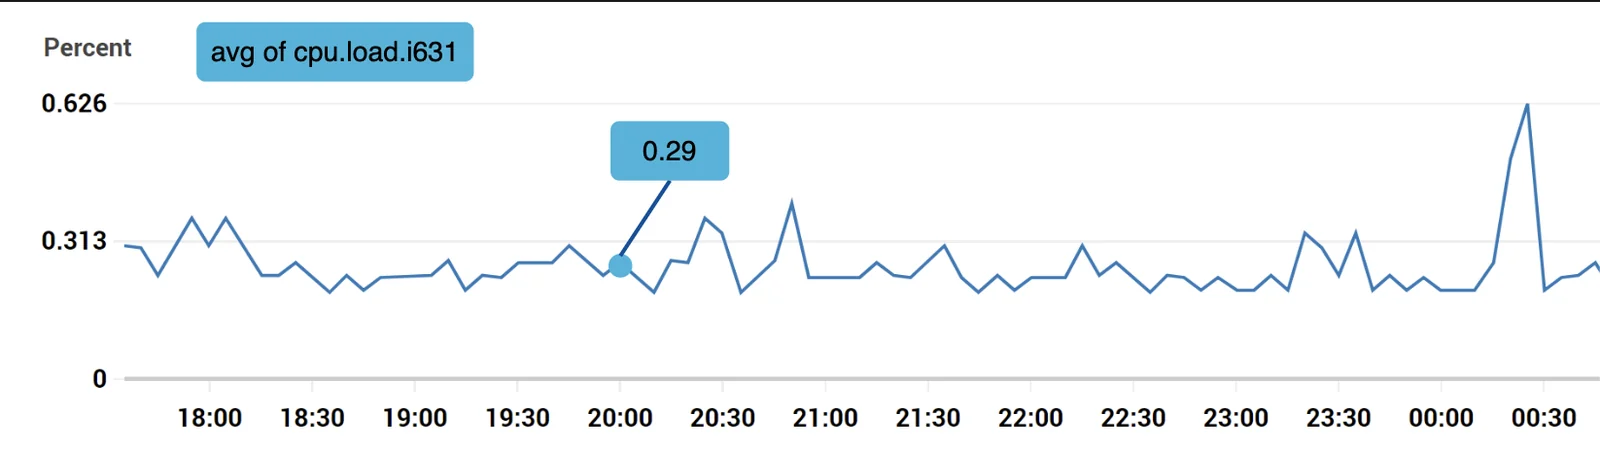
这条数据可以用下表来标识:
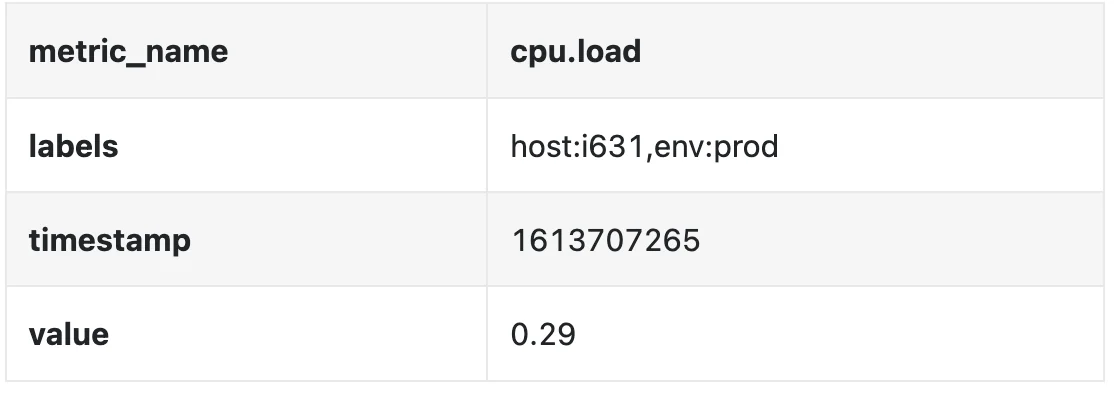
时间序列由指标名称、标签以及特定时间上的单个数据点来标识。
示例 2:过去 10 分钟内,us-west 区域所有 Web 服务器的平均 CPU 负载是多少?
CPU.load host=webserver01,region=us-west 1613707265 50

CPU.load host=webserver01,region=us-west 1613707265 62

CPU.load host=webserver02,region=us-west 1613707265 43

CPU.load host=webserver02,region=us-west 1613707265 53

...

CPU.load host=webserver01,region=us-west 1613707265 76

CPU.load host=webserver01,region=us-west 1613707265 83
这是为回答这个问题,我们可能从存储中取出的示例数据。 把这些行最后一列的值取平均,就能算出平均 CPU 负载。
上面展示的格式称为行协议(line protocol),市面上许多流行的监控软件都在使用它,例如 Prometheus、OpenTSDB。
每个时间序列由以下部分组成:
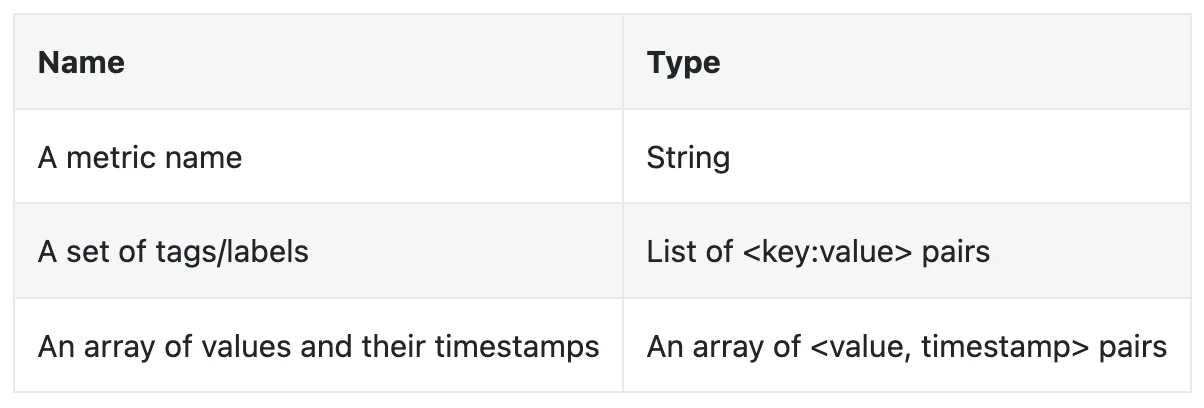
下图很好地直观展示了数据的样子:
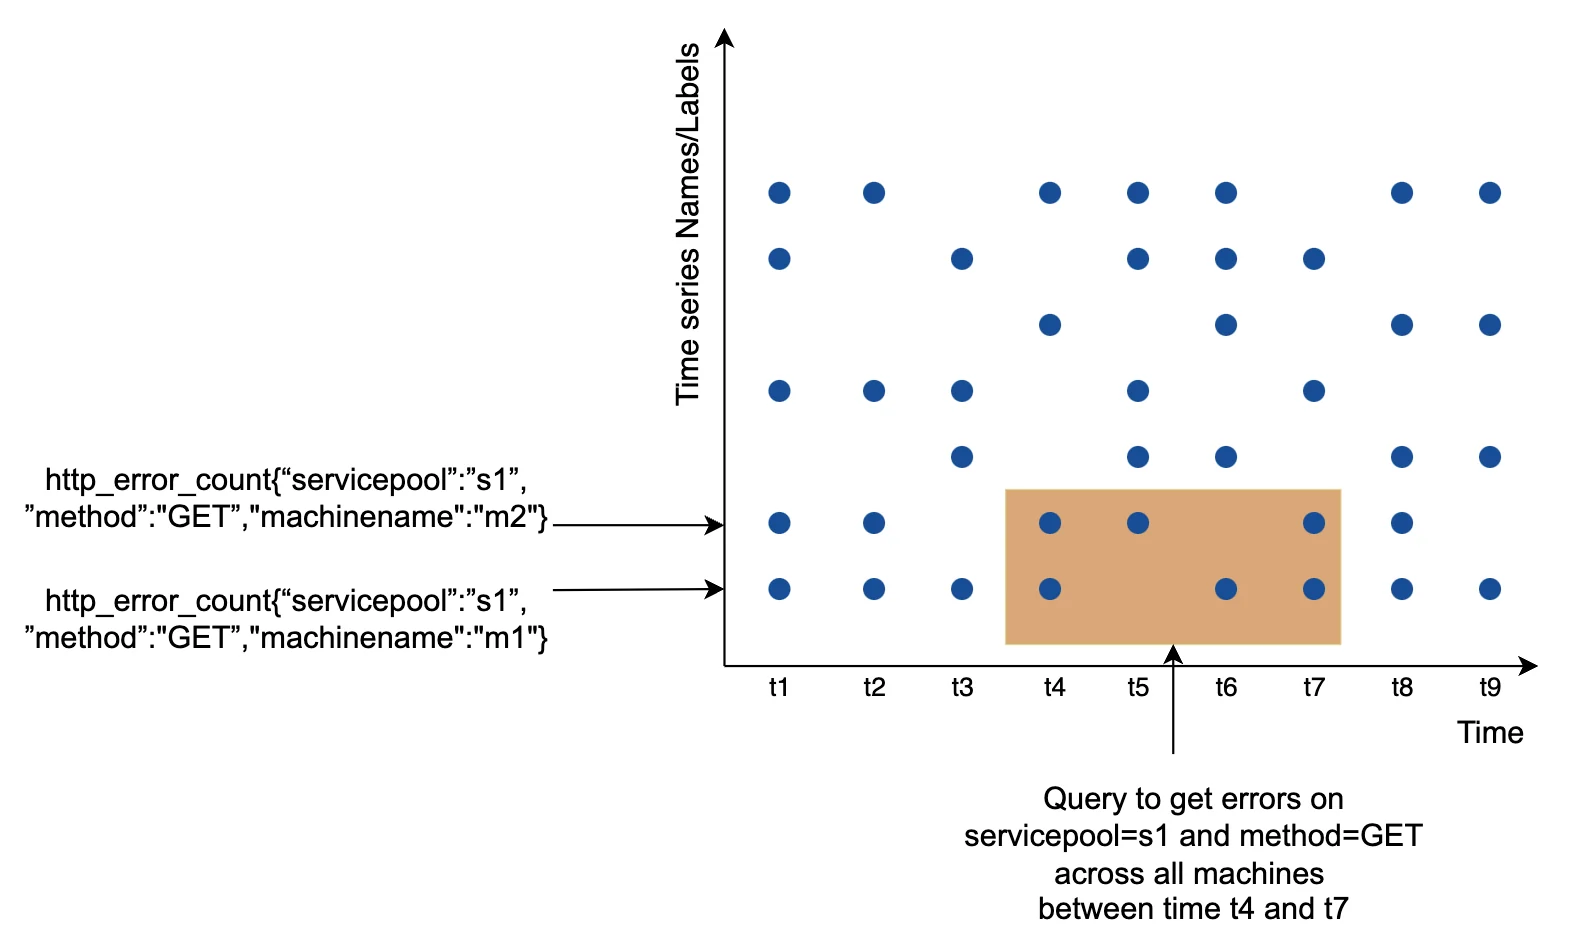
- x 轴是时间
- y 轴是你要查询的维度,例如指标名称、标签等。
这种数据访问模式是写密集、读突发的:我们会收集大量指标,但它们很少被访问,不过一旦访问往往是集中爆发的,例如有正在进行的故障事件时。
数据存储系统是这个设计的核心。
- 不建议用通用数据库来解决这个问题,尽管经过专家级调优也能达到不错的规模。
- 理论上使用 NoSQL 数据库可行,但很难设计出一个可扩展的模式(schema)来高效存储和查询时间序列数据。
有许多专门为存储时间序列数据量身打造的数据库。其中很多都支持自定义查询接口,可以高效地查询时间序列数据。
- OpenTSDB 是一个分布式时间序列数据库,但它基于 Hadoop 和 HBase。如果你没有部署这套基础设施,就很难使用这项技术。
- Twitter 使用 MetricsDB,而 Amazon 提供 Timestream。
- 最流行的两个时间序列数据库是 InfluxDB 和 Prometheus。
- 它们都是为存储海量时间序列数据而设计的,并且都基于内存缓存 + 磁盘存储。
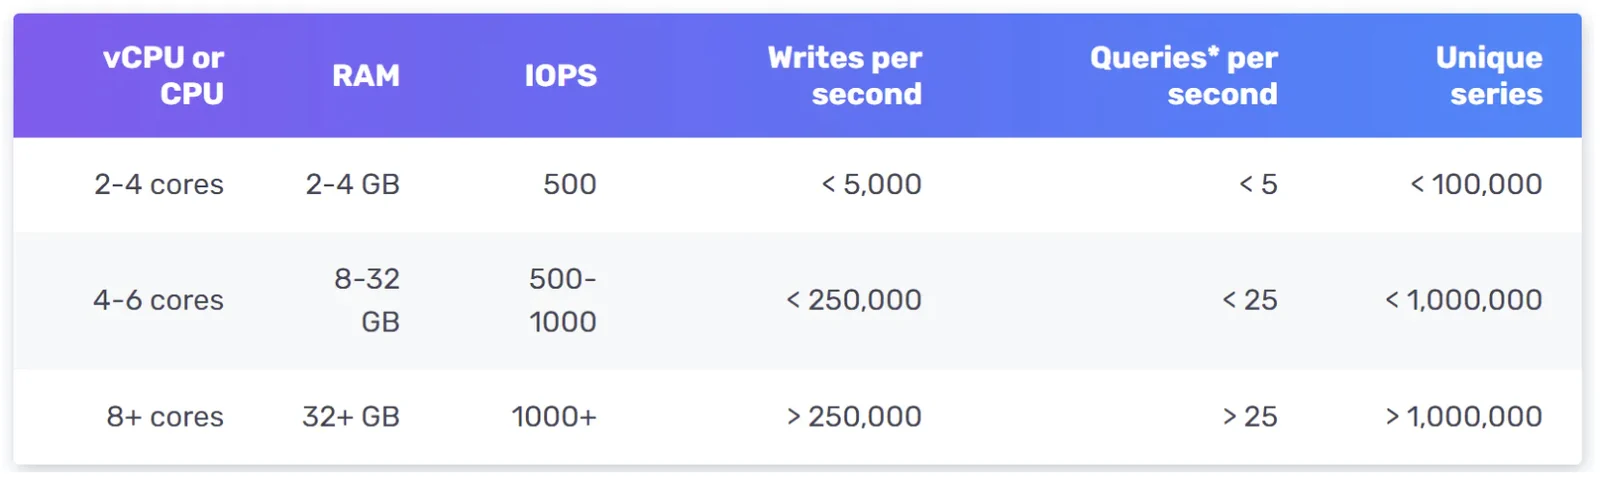
InfluxDB 的规模示例:在配置 8 核 CPU 和 32GB 内存时,每秒可处理超过 25 万次写入:
你不需要了解指标数据库的内部原理,因为这属于小众知识。只有当你在简历中提到过它时,面试官才可能问到。
就面试而言,只需要理解指标是时间序列数据,并了解 InfluxDB 这类流行的时间序列数据库即可。
时间序列数据库的一个优点是能够按标签高效地聚合和分析大量时间序列数据。 例如,InfluxDB 会为每个标签建立索引。
但关键是要保持标签的基数(cardinality)较低,即不要使用过多的唯一标签值。
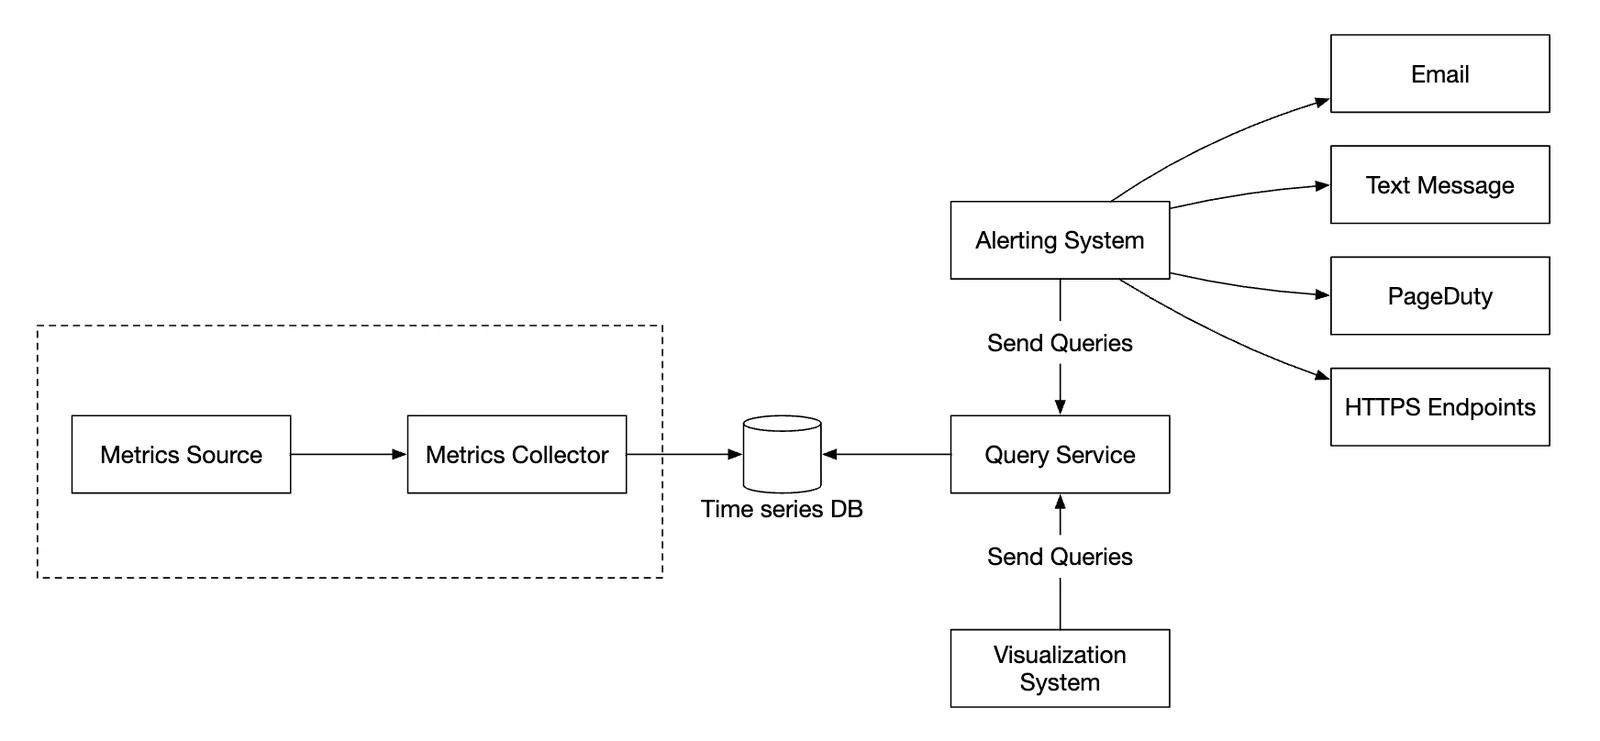
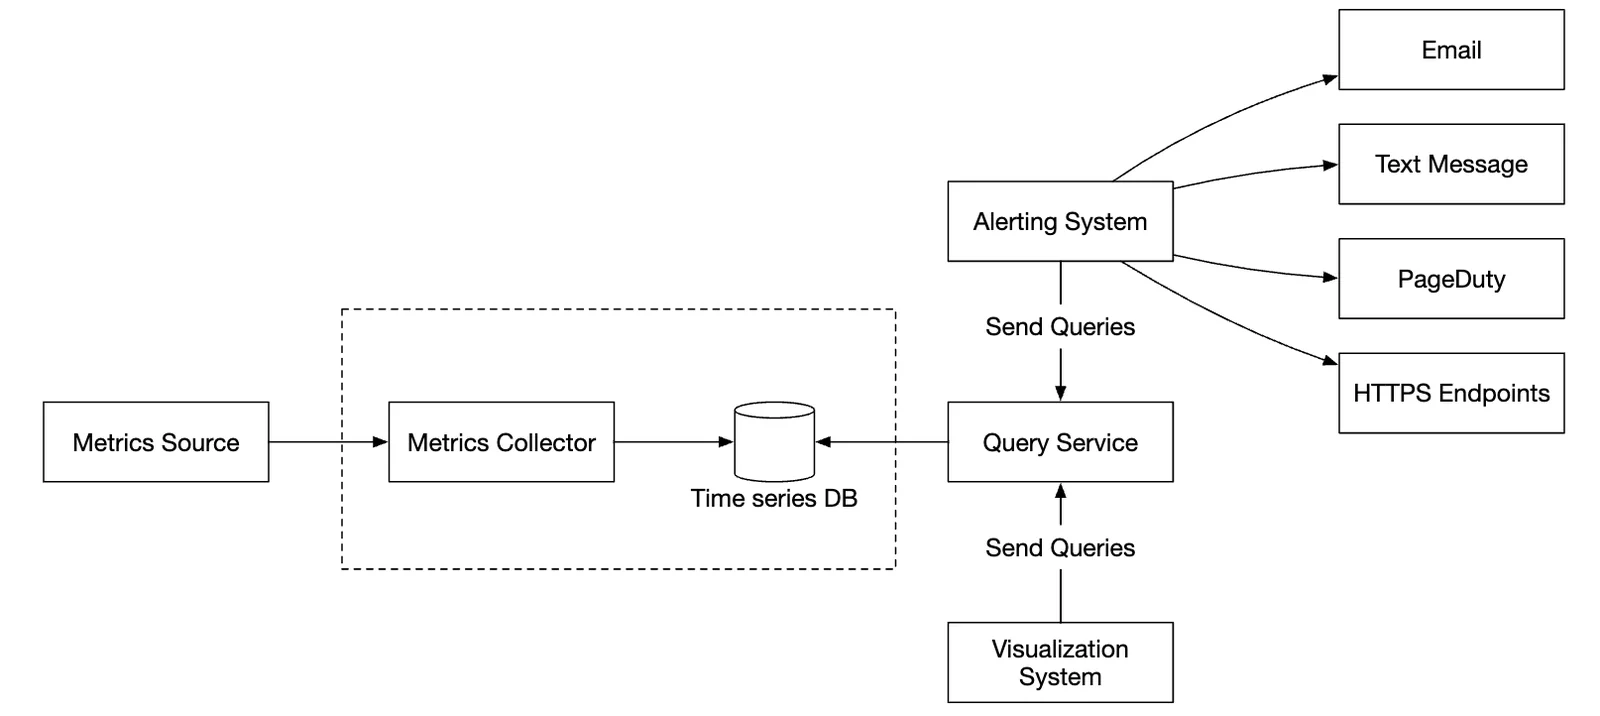
高层设计
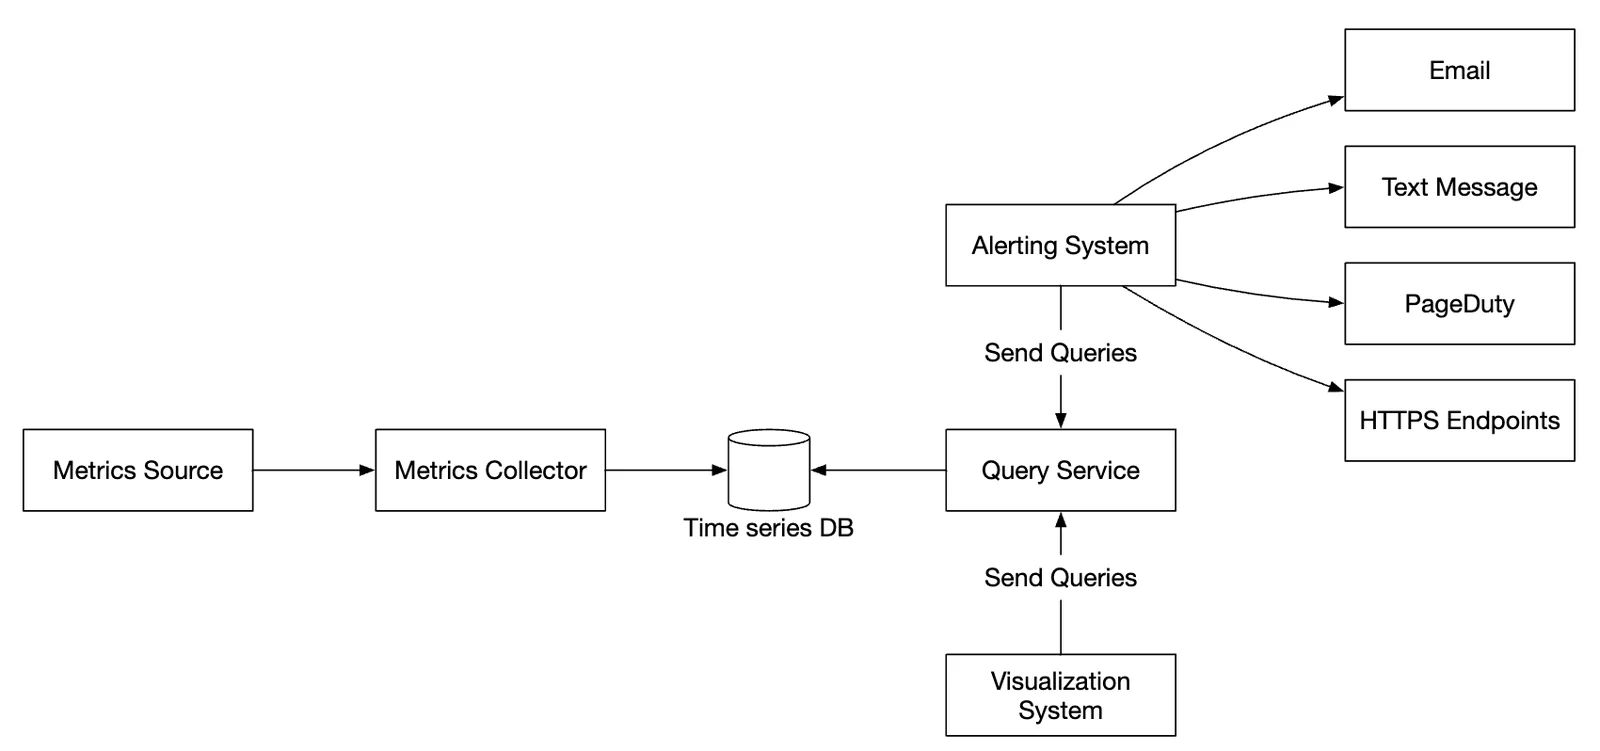
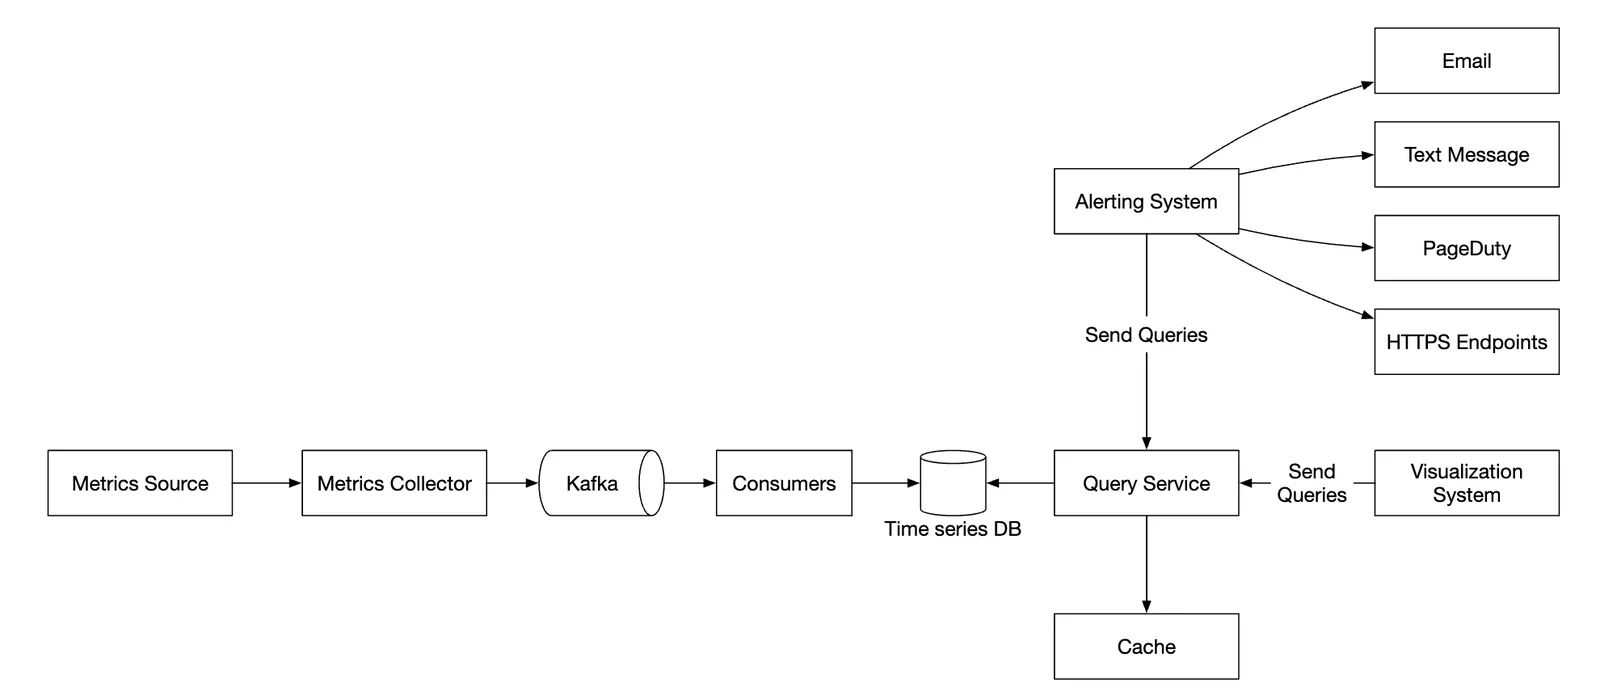
- 指标来源:可以是应用服务器、SQL 数据库、消息队列等。
- 指标收集器:收集指标数据并写入时间序列数据库
- 时间序列数据库:以时间序列的形式存储指标。提供自定义查询接口,用于分析大量指标。
- 查询服务:让从时间序列数据库查询和获取数据变得容易。如果数据库自身的接口足够强大,也可以完全用它来替代。
- 告警系统:把告警通知发送到各个告警目的地。
- 可视化系统:以图形/图表的形式展示指标。
第 3 步:设计深入探讨
我们来深入探讨系统中几个更有意思的部分。
指标收集
对于指标收集来说,偶尔丢失数据并不致命。客户端采用「发出即不管(fire and forget)」的方式是可以接受的。
实现指标收集有两种方式:拉(pull)或推(push)。
拉模型大致如下:
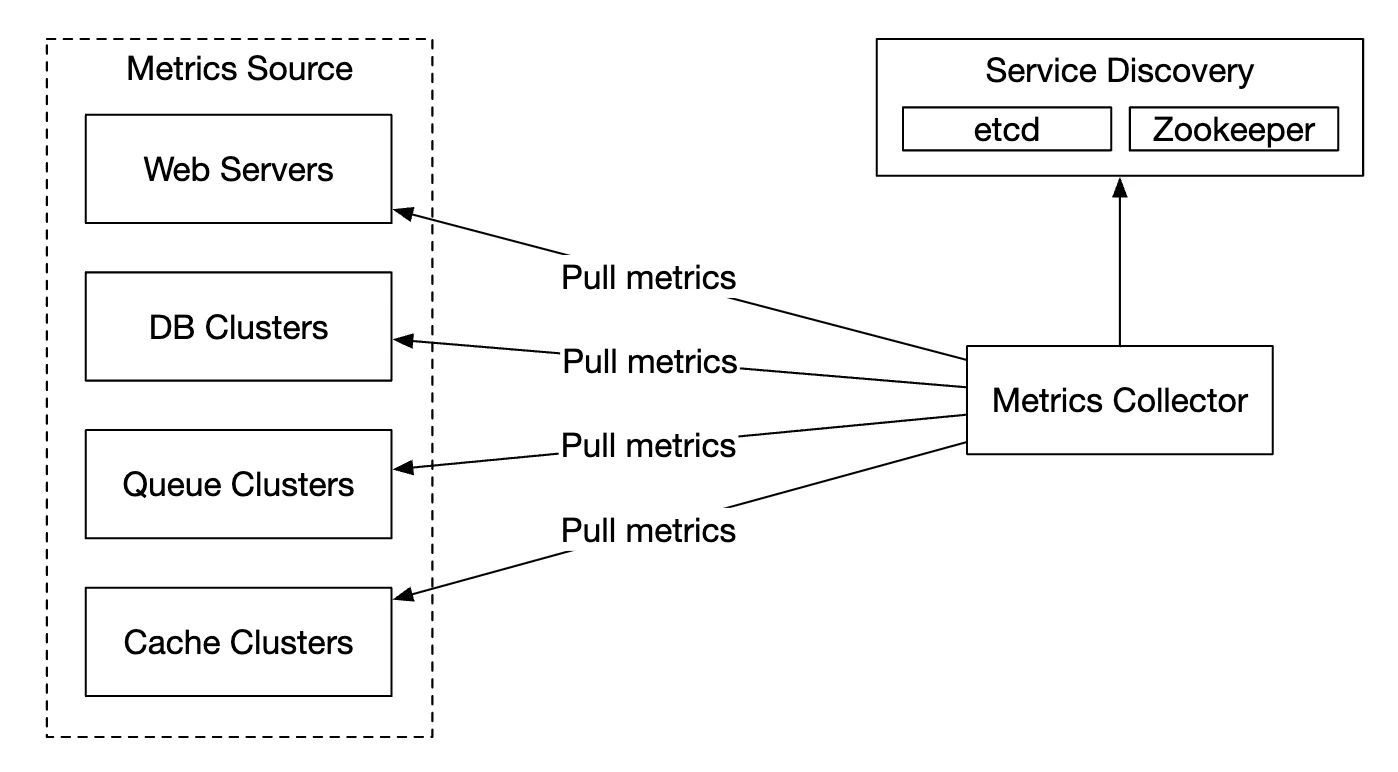
在这个方案中,指标收集器需要维护一份最新的服务及指标端点列表。 我们可以用 Zookeeper 或 etcd 来实现这一点,即服务发现(Service Discovery)。
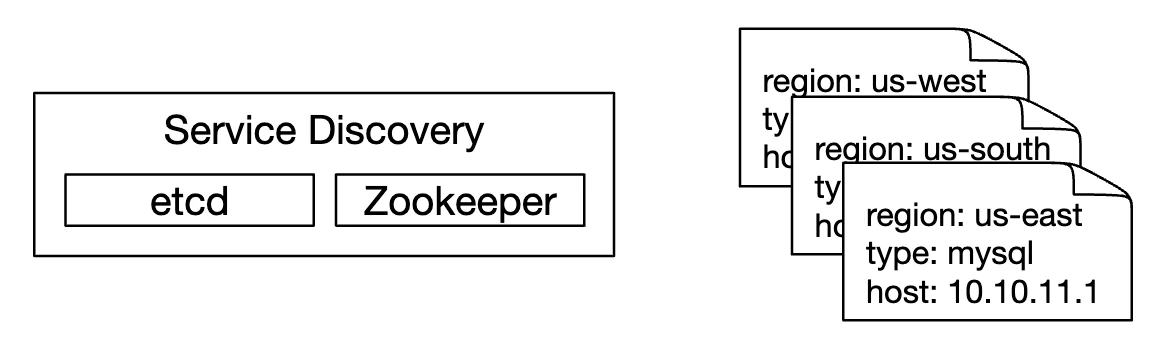
服务发现包含关于何时、从何处收集指标的配置规则:
下面详细说明指标收集流程:
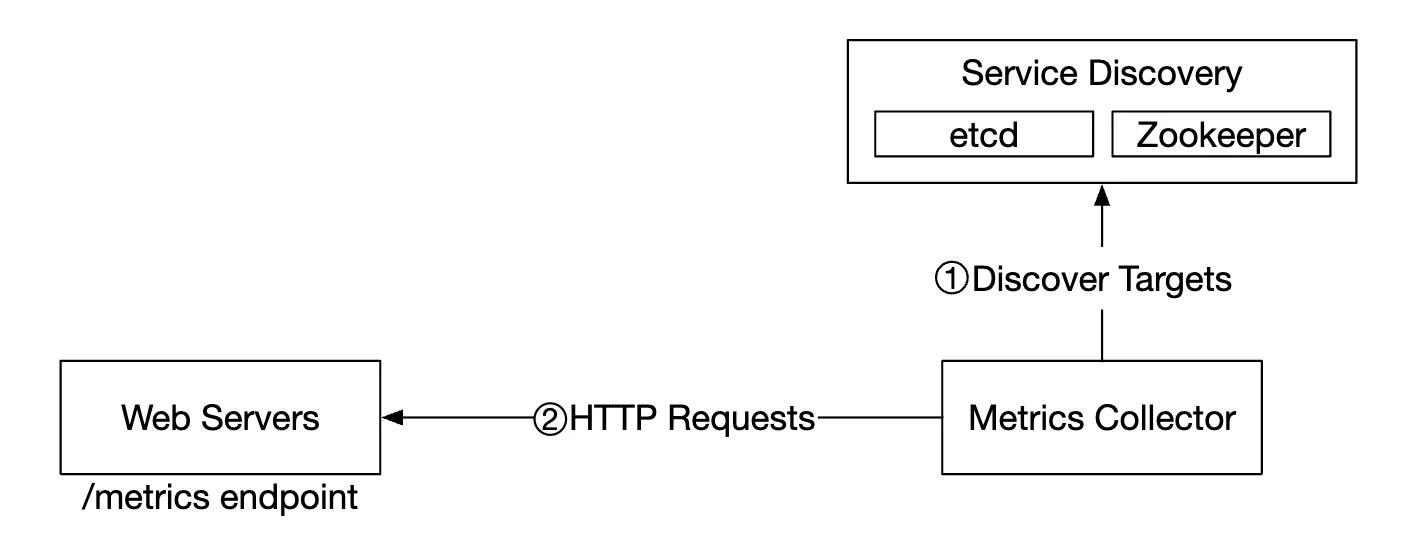
- 指标收集器从服务发现获取配置元数据,包括拉取间隔、IP 地址、超时和重试参数。
- 指标收集器通过预先定义的 HTTP 端点(例如
/metrics)拉取指标数据。这通常由客户端库完成。 - 另外,指标收集器也可以向服务发现注册变更事件通知,以便在服务端点变化时收到通知。
- 还有一种做法是指标收集器定期轮询指标端点配置的变化。
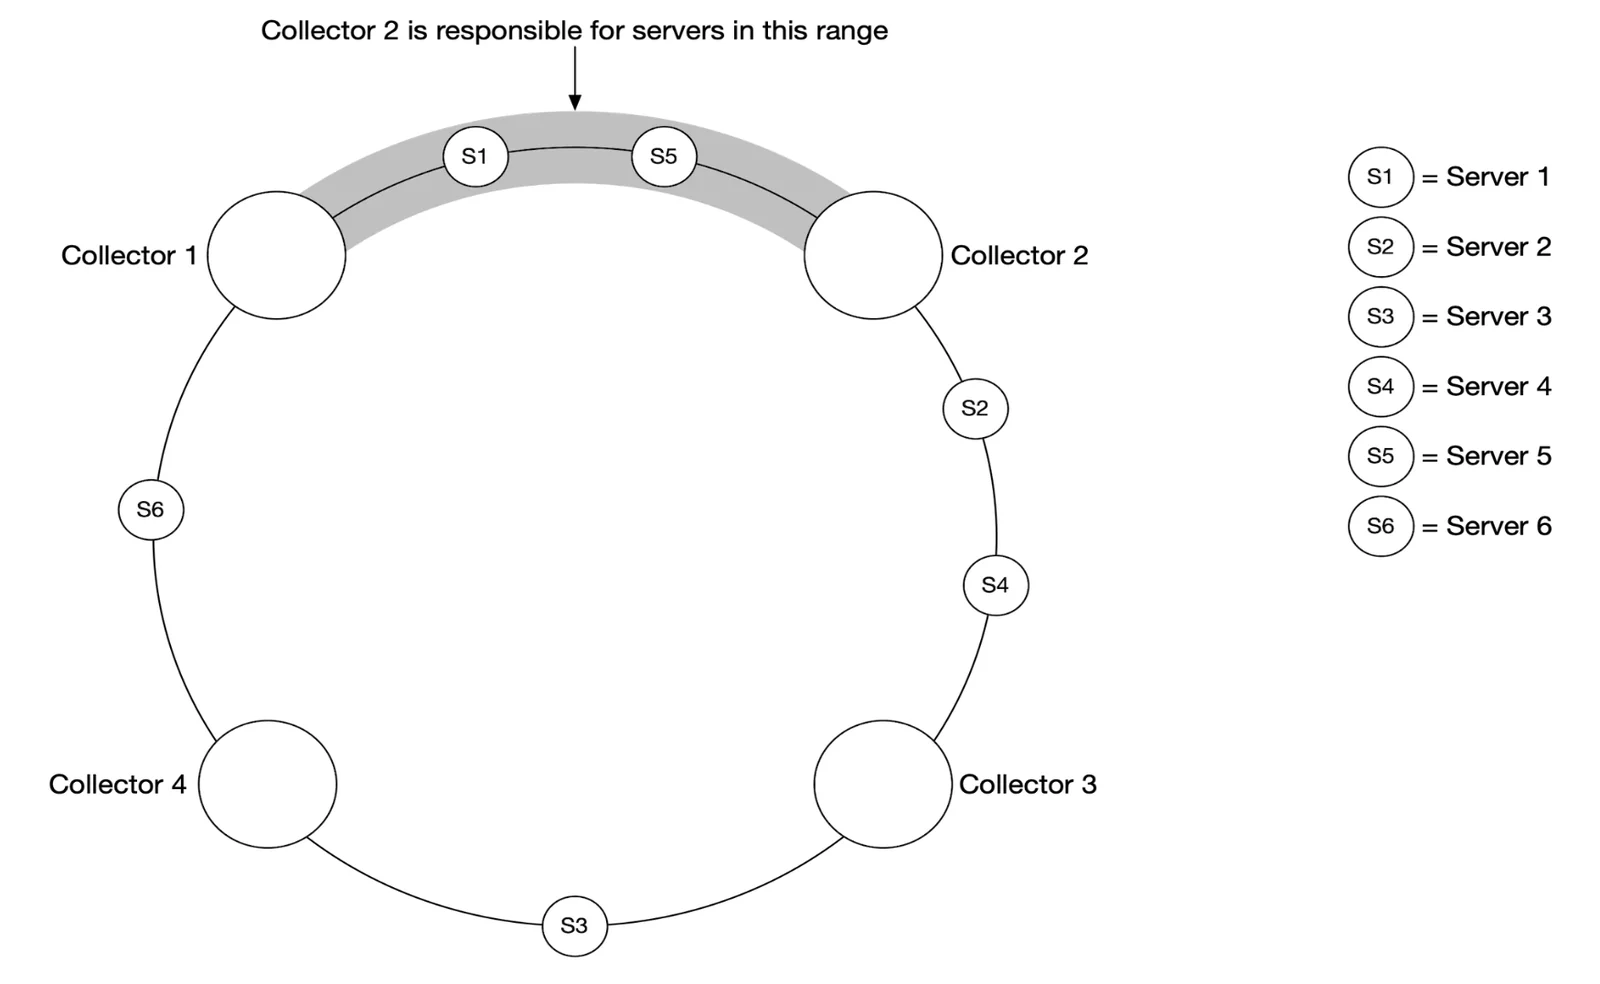
在我们的规模下,单个指标收集器是不够的,必须部署多个实例。 但它们之间也必须有某种同步机制,这样两个收集器才不会把同一批指标重复收集两次。
一种解决方案是把收集器和服务器放在一致性哈希环(Consistent Hash Ring)上,让一组服务器只与一个收集器关联:
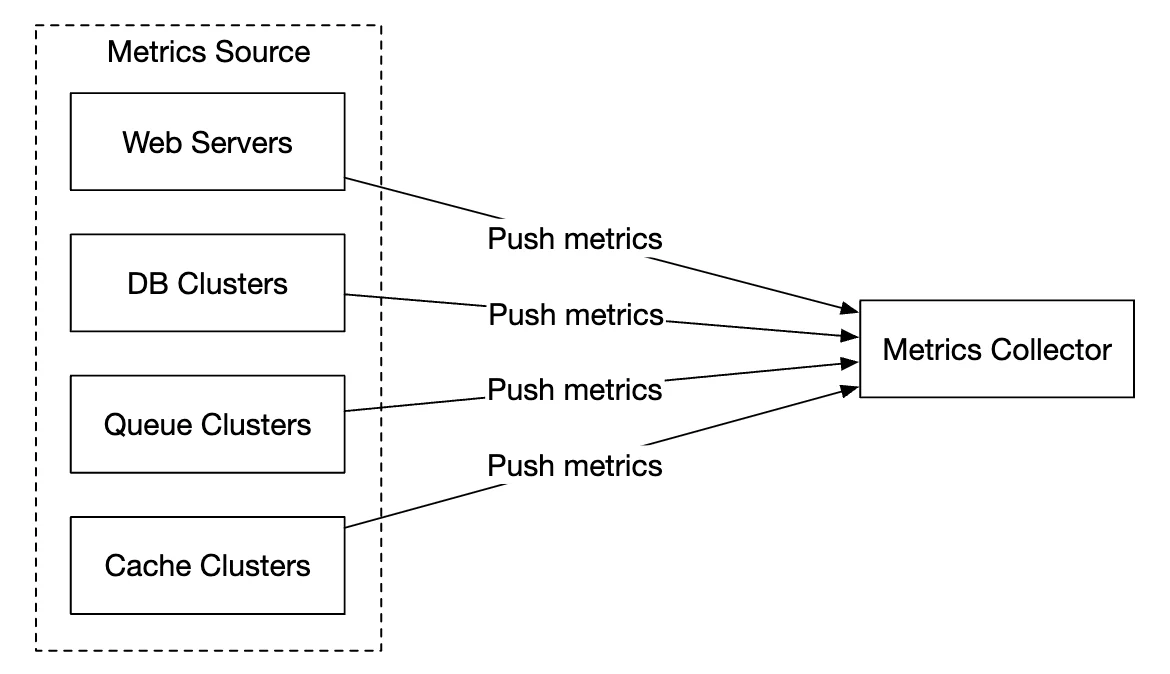
而在推模型中,服务会主动把自己的指标推送给指标收集器:
这种做法通常会在服务实例旁边安装一个收集代理(collection agent)。 代理从服务器收集指标,再推送给指标收集器。
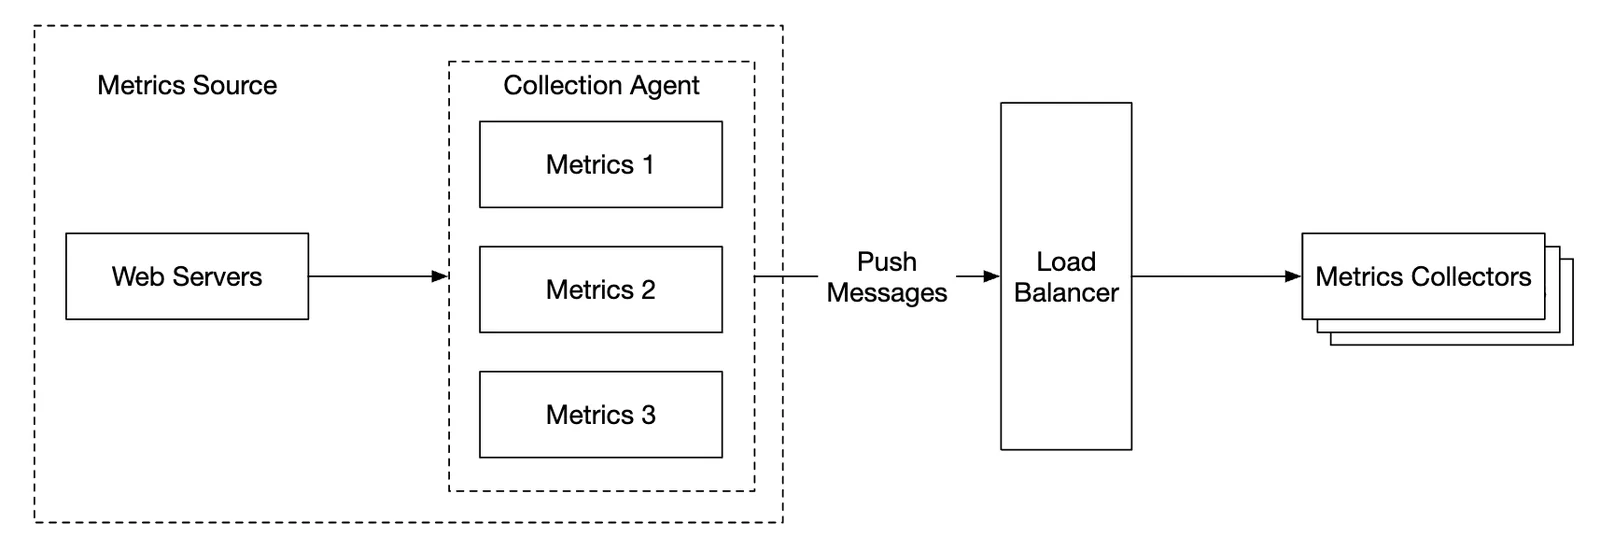
在这种模型下,我们可以在发送给收集器之前先对指标做聚合,从而减少收集器需要处理的数据量。
另一方面,指标收集器可能因为扛不住负载而拒绝推送请求。 因此,重要的是把收集器放进负载均衡器后面的自动伸缩组(auto-scaling group)中。
那么哪种更好?两种方式各有权衡,不同的系统采用了不同的方式:
- Prometheus 使用拉架构
- Amazon Cloud Watch 和 Graphite 使用推架构
下面是推和拉之间的一些主要区别: | | 拉 | 推 | |----------------------------------------|---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|-----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------| | 易于调试 | 应用服务器上用于拉取指标的 /metrics 端点可以随时用来查看指标,你甚至可以在自己的笔记本电脑上这样做。拉胜出。 | 如果指标收集器没有收到指标,问题可能是网络问题导致的。 | | 健康检查 | 如果应用服务器没有响应拉取请求,你可以很快判断出该应用服务器是否已宕机。拉胜出。 | 如果指标收集器没有收到指标,问题可能是网络问题导致的。 | | 短生命周期任务 | | 有些批处理任务的生命周期可能很短,持续时间不足以被拉取到。推胜出。这一点可以通过为拉模型引入推送网关(push gateway)来解决 [22]。 | | 防火墙或复杂的网络环境 | 由服务器来拉取指标,要求所有指标端点都可访问。这在多数据中心的环境中可能会有问题,可能需要更复杂的网络基础设施。 | 如果指标收集器配置了负载均衡器和自动伸缩组,就可以接收来自任何地方的数据。推胜出。 | | 性能 | 拉方式通常使用 TCP。 | 推方式通常使用 UDP。这意味着推方式能以更低的延迟传输指标。反方观点是,与发送指标负载相比,建立 TCP 连接的开销很小。 | | 数据真实性 | 要从中收集指标的应用服务器事先在配置文件中定义好,从这些服务器收集的指标可以保证是真实的。 | 任何客户端都可以向指标收集器推送指标。这可以通过设置白名单只接受特定服务器的指标,或者要求身份认证来解决。 |
没有明显的赢家。大型组织可能两种都需要支持。有时可能根本就没办法安装推送代理。
扩展指标传输管道
无论使用推模型还是拉模型,指标收集器都部署在自动伸缩组中。
不过,如果时间序列数据库宕机,就有丢失数据的可能。为了缓解这一问题,我们会部署一个排队机制:
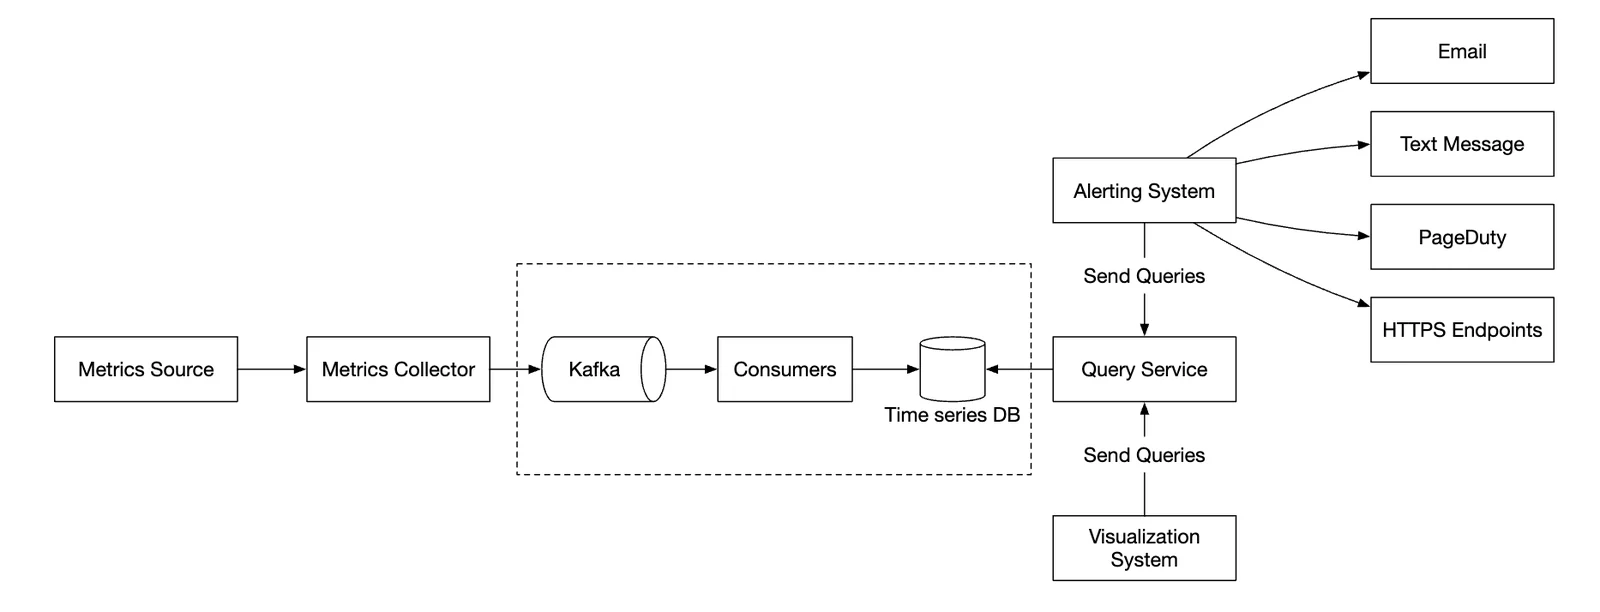
- 指标收集器把指标数据推送到 Kafka
- 消费者或流处理服务(例如 Apache Storm、Flink 或 Spark)处理这些数据,并将其推送到时间序列数据库
这种方式有几个优点:
- Kafka 被用作高度可靠、可扩展的分布式消息平台
- 它把数据收集和数据处理相互解耦
- 它可以把数据保留在 Kafka 中,从而防止数据丢失
可以把 Kafka 配置为每个指标名称一个分区,这样消费者就能按指标名称聚合数据。 为了扩展,我们还可以进一步按标签/标记分区,并对指标进行分类/设定优先级,让重要的指标先被收集。
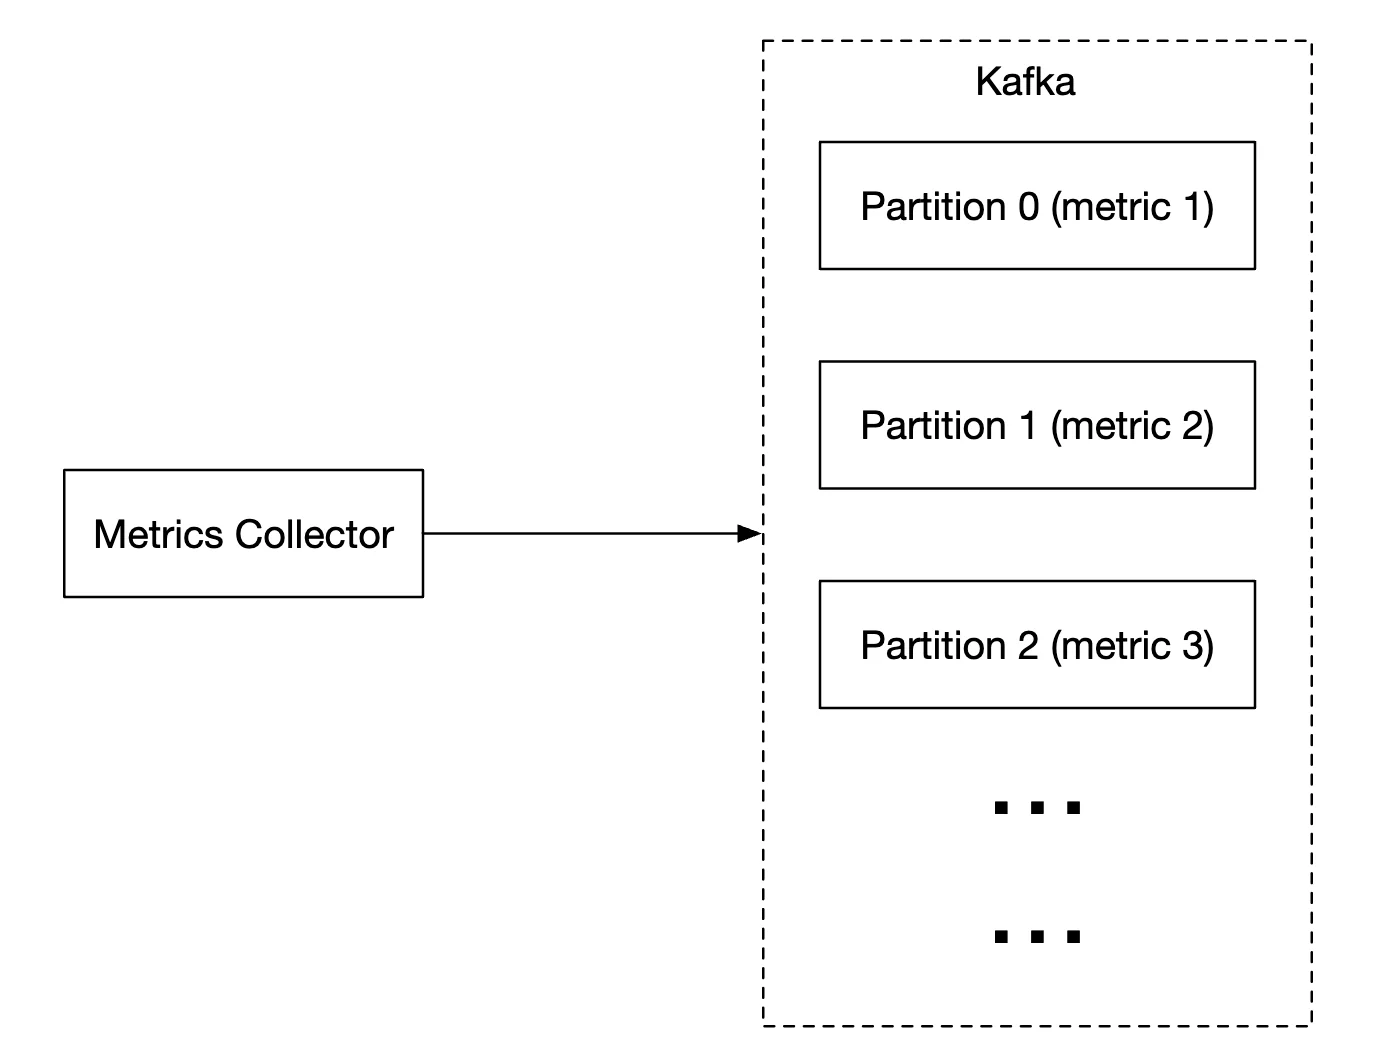
在这个问题中使用 Kafka 的主要缺点是维护/运维开销。 另一种选择是使用像 Gorilla 这样的大规模数据摄取系统。 可以认为,使用它与用 Kafka 做排队具有同样的可扩展性。
聚合可以在哪里进行
指标可以在多个地方进行聚合,不同的选择之间存在权衡:
- 收集代理:客户端收集代理只支持简单的聚合逻辑。例如对一个计数器收集 1 分钟后再发送给指标收集器。
- 摄取管道:要在写入数据库之前聚合数据,我们需要 Flink 这样的流处理引擎。这样可以减少写入量,但由于不存储原始数据,会损失数据精度。
- 查询端:可以在通过可视化系统执行查询时聚合数据。这样不会丢失数据,但由于需要处理大量数据,查询可能会很慢。
查询服务
让查询服务独立于时间序列数据库,可以把可视化系统和告警系统与数据库解耦,从而使数据库与客户端解耦,并能随意更换数据库。
我们可以在这里加一个缓存层,以减轻时间序列数据库的负载:
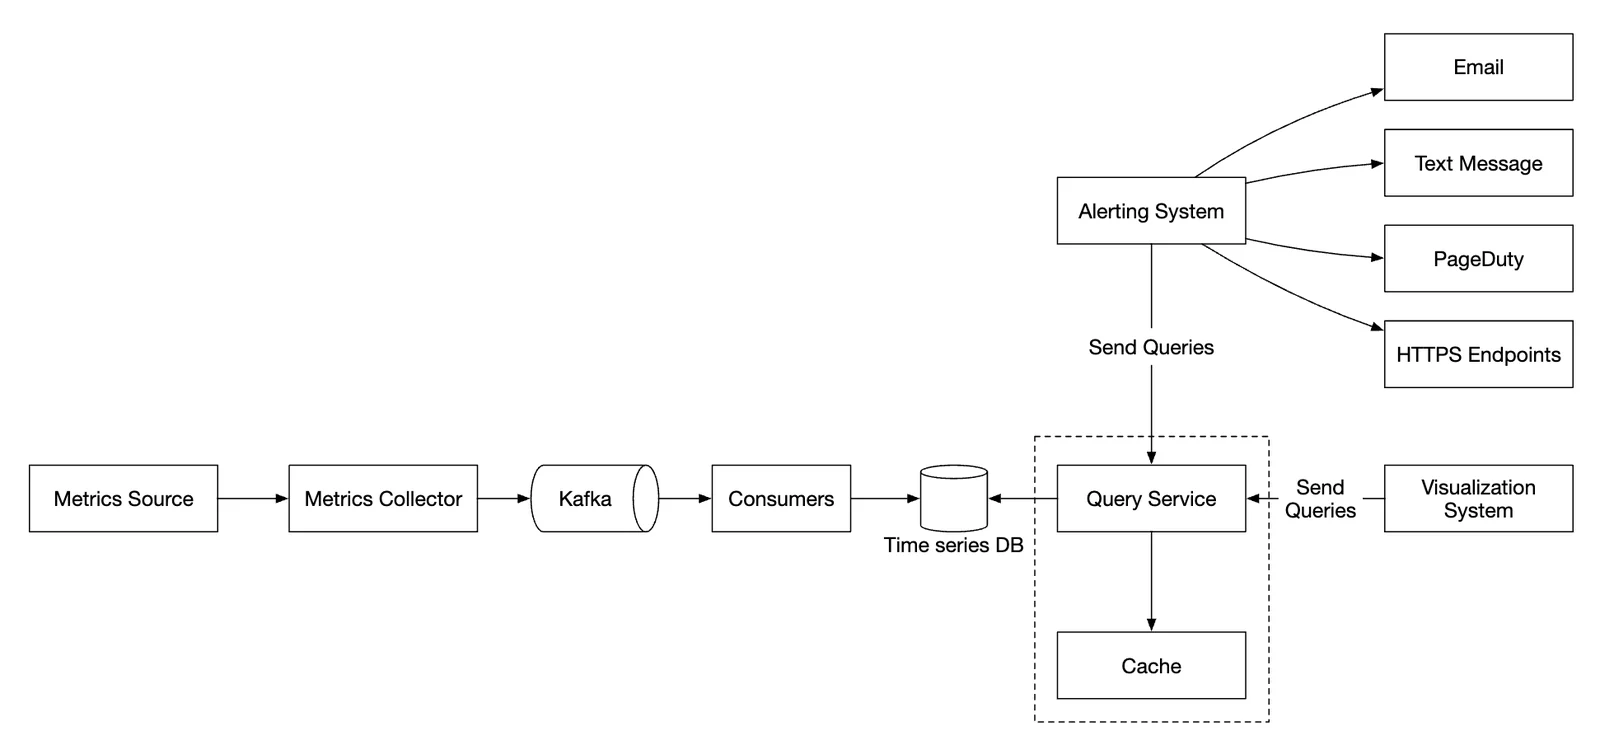
我们也可以完全不加查询服务,因为大多数可视化和告警系统都有强大的插件,可以与大多数时间序列数据库集成。 如果时间序列数据库选得好,我们可能也不需要引入自己的缓存层。
大多数时间序列数据库不支持 SQL,原因很简单:SQL 查询时间序列数据的效率不高。下面是一个计算指数移动平均(exponential moving average)的 SQL 查询示例:
select id,
       temp,
       avg(temp) over (partition by group_nr order by time_read) as rolling_avg
from (
  select id,
         temp,
         time_read,
         interval_group,
         id - row_number() over (partition by interval_group order by time_read) as group_nr
  from (
    select id,
    time_read,
    "epoch"::timestamp + "900 seconds"::interval * (extract(epoch from time_read)::int4 / 900) as interval_group,
    temp
    from readings
  ) t1
) t2
order by time_read;
下面是用 Flux(InfluxDB 使用的查询语言)写的同一个查询:
from(db:"telegraf")
  |> range(start:-1h)
  |> filter(fn: (r) => r._measurement == "foo")
  |> exponentialMovingAverage(size:-10s)
存储层
慎重选择时间序列数据库非常重要。
根据 Facebook 发表的研究,对运行数据存储的查询中,约 85% 针对的是过去 26 小时内的数据。
如果我们选择一个能利用这一特性的数据库,就可能对系统性能产生显著影响。InfluxDB 就是这样一个选择。
无论选择哪种数据库,我们都可以采用一些优化手段。
数据编码和压缩可以显著减小数据体积。好的时间序列数据库通常都内置了这些功能。
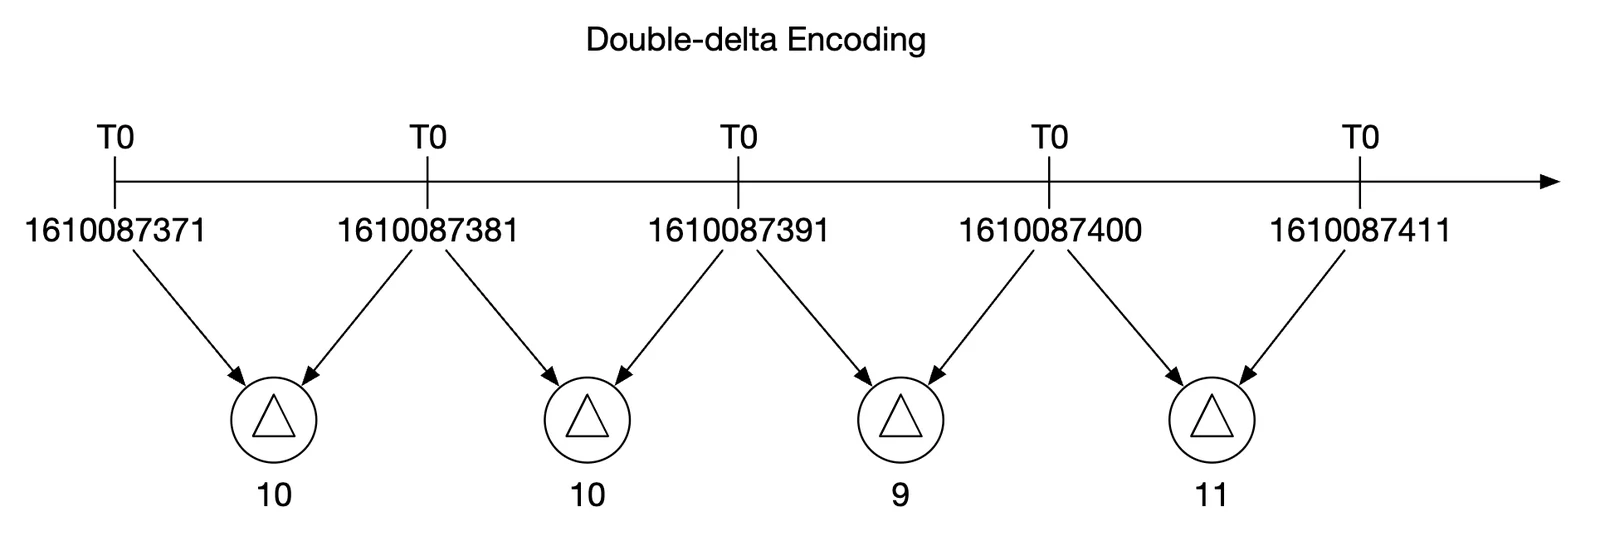
在上面的例子中,我们可以不存储完整的时间戳,而是存储时间戳的差值(delta)。
我们还可以采用另一种技术:降采样(down-sampling),即把高分辨率数据转换为低分辨率数据,以减少磁盘占用。
我们可以对旧数据使用降采样,并让数据科学家可以配置规则,例如:
- 7 天:不降采样
- 30 天:降采样到 1 分钟
- 1 年:降采样到 1 小时
例如,下面是一个 10 秒分辨率的指标表: | metric | timestamp | hostname | Metric_value | |--------|----------------------|----------|--------------| | cpu | 2021-10-24T19:00:00Z | host-a | 10 | | cpu | 2021-10-24T19:00:10Z | host-a | 16 | | cpu | 2021-10-24T19:00:20Z | host-a | 20 | | cpu | 2021-10-24T19:00:30Z | host-a | 30 | | cpu | 2021-10-24T19:00:40Z | host-a | 20 | | cpu | 2021-10-24T19:00:50Z | host-a | 30 |
降采样到 30 秒分辨率后: | metric | timestamp | hostname | Metric_value (avg) | |--------|----------------------|----------|--------------------| | cpu | 2021-10-24T19:00:00Z | host-a | 19 | | cpu | 2021-10-24T19:00:30Z | host-a | 25 |
最后,我们还可以用冷存储(cold storage)来存放不再使用的旧数据。冷存储的财务成本要低得多。
告警系统
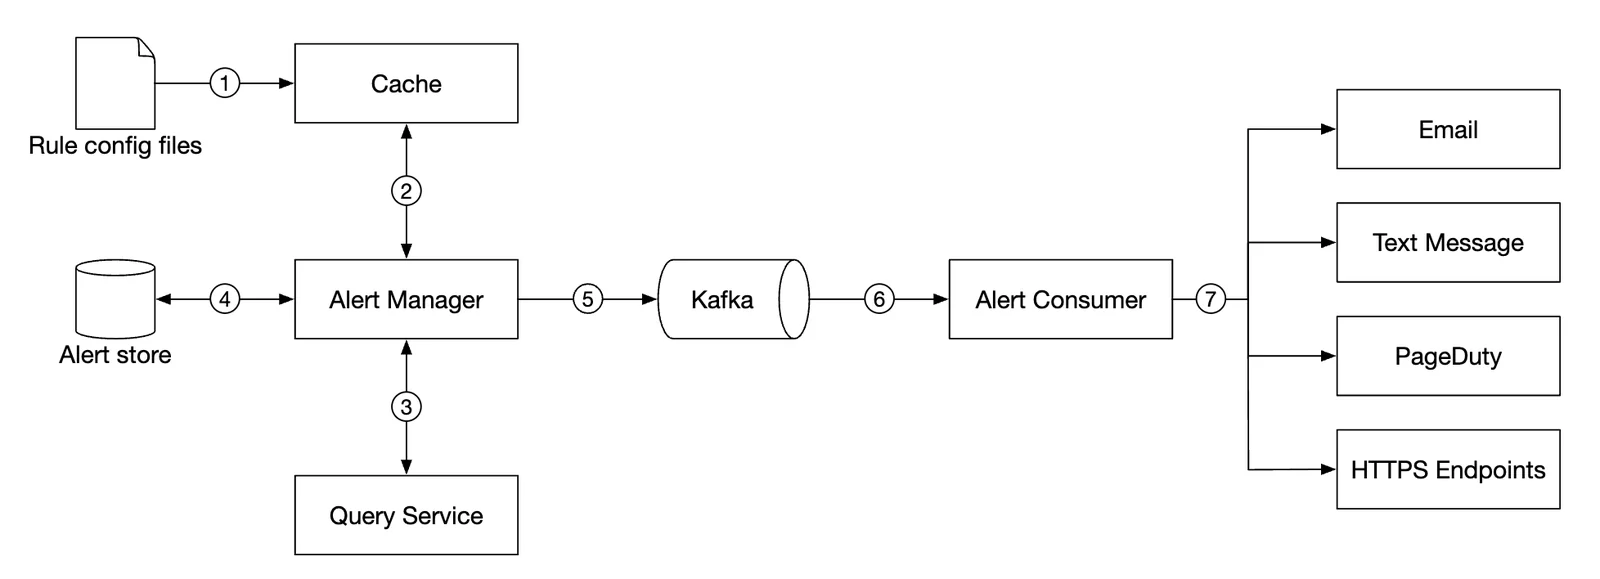
配置被加载到缓存服务器中。规则通常以 YAML 格式定义,示例如下:
- name: instance_down
  rules:

  # 对任何超过 5 分钟无法访问的实例发出告警。
  - alert: instance_down
    expr: up == 0
    for: 5m
    labels:
      severity: page
告警管理器(alert manager)从缓存中获取告警配置,并根据配置规则,按预定义的时间间隔调用查询服务。 如果某条规则被满足,就会创建一个告警事件。
告警管理器的其他职责包括:
- 过滤、合并告警并去重。例如,如果单个实例的某个告警被触发了多次,只生成一个告警事件。
- 访问控制:把告警管理操作限制在特定人员手中非常重要
- 重试:管理器确保告警至少被传播一次。
告警存储是一个键值数据库,比如 Cassandra,它保存所有告警的状态,确保通知至少被发送一次。 告警一旦被触发,就会发布到 Kafka。
最后,告警消费者从 Kafka 拉取告警数据,并通过不同渠道发送通知:电子邮件、短信、PagerDuty、webhook。
在现实世界中,告警系统有很多现成的解决方案,很难证明自研一套系统是合理的。
可视化系统
可视化系统展示一段时间内的指标和告警。下面是一个用 Grafana 构建的仪表盘:
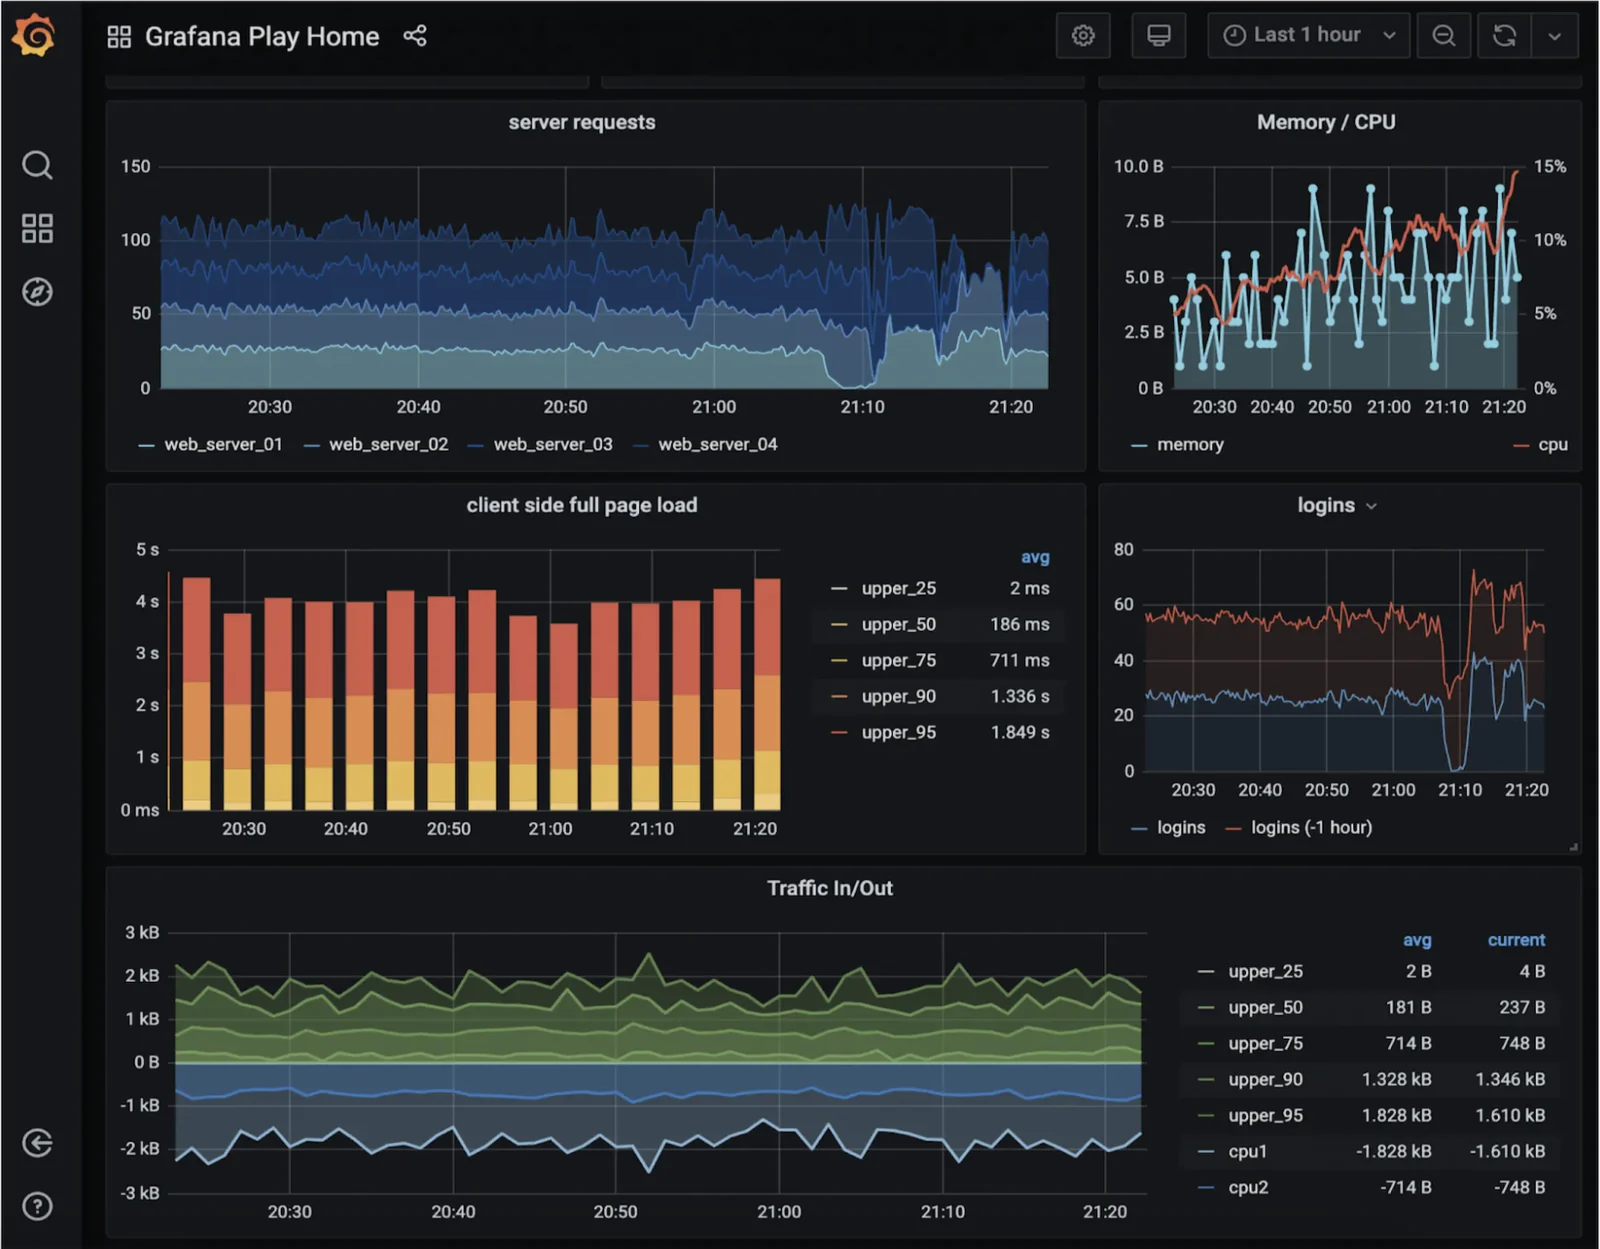
高质量的可视化系统很难构建,很难找到理由不用 Grafana 这样的现成方案。
第 4 步:总结
下面是我们的最终设计: