第 24 章 类 S3 对象存储
引言
本章我们将设计一个对象存储(Object Storage)服务,类似 Amazon S3。
存储系统大致分为三类:
- 块存储(Block Storage)
- 文件存储(File Storage)
- 对象存储(Object Storage)
块存储是 20 世纪 60 年代出现的设备,HDD 和 SSD 就是例子。 这些设备通常物理连接在服务器上,不过也可以通过高速网络协议以网络方式挂载。 服务器可以把原始块格式化后作为文件系统使用,也可以把块的控制权直接交给服务器。
文件存储构建在块存储之上。它提供了更高层次的抽象,让文件夹和文件的管理更加容易。
对象存储牺牲了性能,换取高持久性、超大规模和低成本。 它面向「冷」数据,主要用于归档和备份。 它没有层级目录结构,所有数据都以对象的形式存储在扁平结构中。 与其他存储类型相比,它的速度相对较慢。大多数云服务商都提供对象存储产品,例如 Amazon S3、Google GCS 等。
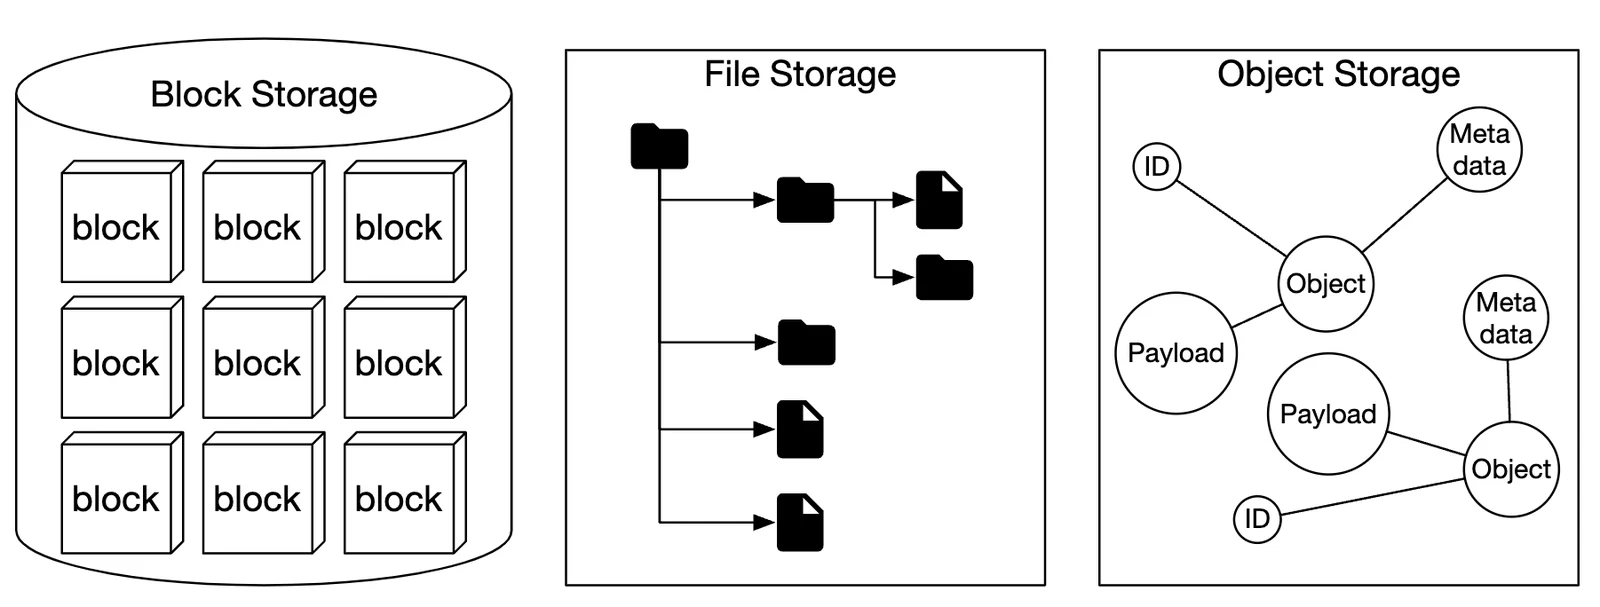
| 块存储 | 文件存储 | 对象存储 | |
|---|---|---|---|
| 内容可变 | 是 | 是 | 否(支持对象版本控制) |
| 成本 | 高 | 中到高 | 低 |
| 性能 | 中到高,非常高 | 中到高 | 低到中 |
| 一致性 | 强一致性 | 强一致性 | 强一致性 [5] |
| 数据访问 | SAS/iSCSI/FC | 标准文件访问、CIFS/SMB 和 NFS | RESTful API |
| 可扩展性 | 中等可扩展性 | 高可扩展性 | 超大规模可扩展性 |
| 适用场景 | 虚拟机(VM)、数据库 | 通用文件系统访问 | 二进制数据、非结构化数据 |
与对象存储相关的一些术语:
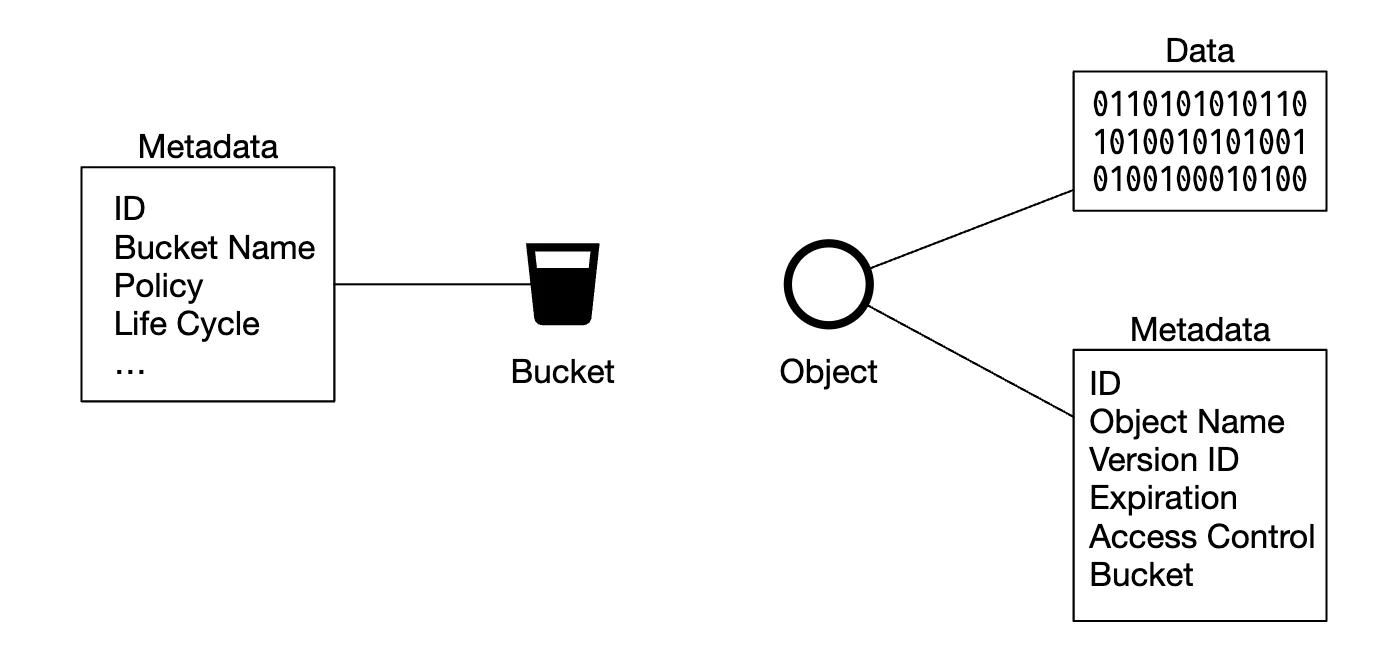
- 存储桶(Bucket):对象的逻辑容器。名称全局唯一。
- 对象(Object):存储在存储桶中的单个数据单元。包含对象数据和元数据。
- 版本控制(Versioning):在同一个存储桶中保留一个对象多个版本的功能。
- 统一资源标识符(Uniform Resource Identifier,URI):每个资源都由一个 URI 唯一标识。
- 服务等级协议(Service-level Agreement,SLA):服务提供商与客户之间的合约。
Amazon S3 标准-不频繁访问(Standard-Infrequent Access)存储类别的 SLA:
- 跨多个可用区(Availability Zone)实现 99.999999999% 的持久性
- 即使整个可用区被摧毁,数据仍然可以保全
- 设计可用性为 99.9%
第 1 步:理解问题并确定设计范围
- 候选人:应该包含哪些功能?
- 面试官:创建存储桶、上传/下载对象、版本控制、列出存储桶中的对象
- 候选人:典型的数据大小是多少?
- 面试官:我们需要高效地存储超大对象和小对象
- 候选人:一年要存储多少数据?
- 面试官:100 PB
- 候选人:可以假设数据持久性为 6 个 9(99.9999%),服务可用性为 4 个 9(99.99%)吗?
- 面试官:可以,听起来很合理
非功能性需求
- 100 PB 数据
- 6 个 9 的数据持久性
- 4 个 9 的服务可用性
- 存储效率。在保持高可靠性和高性能的同时降低存储成本
粗略估算
对象存储的瓶颈很可能出现在磁盘容量或每秒 IO 次数(IOPS)上。
假设:
- 20% 为小对象(小于 1 MB),60% 为中等对象(1 到 64 MB),20% 为大对象(大于 64 MB),
- 一块硬盘(SATA,7200 转)每秒可以完成 100 到 150 次随机寻道(100 到 150 IOPS)
基于这些假设,我们可以估算系统能够持久化的对象总数。
- 为简化计算,各类对象取中位大小:小对象 0.5 MB,中等对象 32 MB,大对象 200 MB。
- 给定 100 PB 存储(10^11 MB)、40% 的存储使用率,可得约 6.8 亿个对象
- 如果假设每个对象的元数据为 1 KB,那么需要 0.68 TB 的空间来存储元数据
第 2 步:提出高层设计并获得认可
在深入设计之前,我们先来看看对象存储的一些有意思的特性:
- 对象不可变性:对象存储中的对象是不可变的(其他存储系统并非如此)。我们可以删除或替换对象,但不能更新。
- 键值存储:对象的 URI 就是它的键,我们可以通过一次 HTTP 调用获取其内容
- 一次写入,多次读取:数据访问模式是写一次、读多次。根据 LinkedIn 的一些研究,95% 的操作是读操作
- 同时支持小对象和大对象
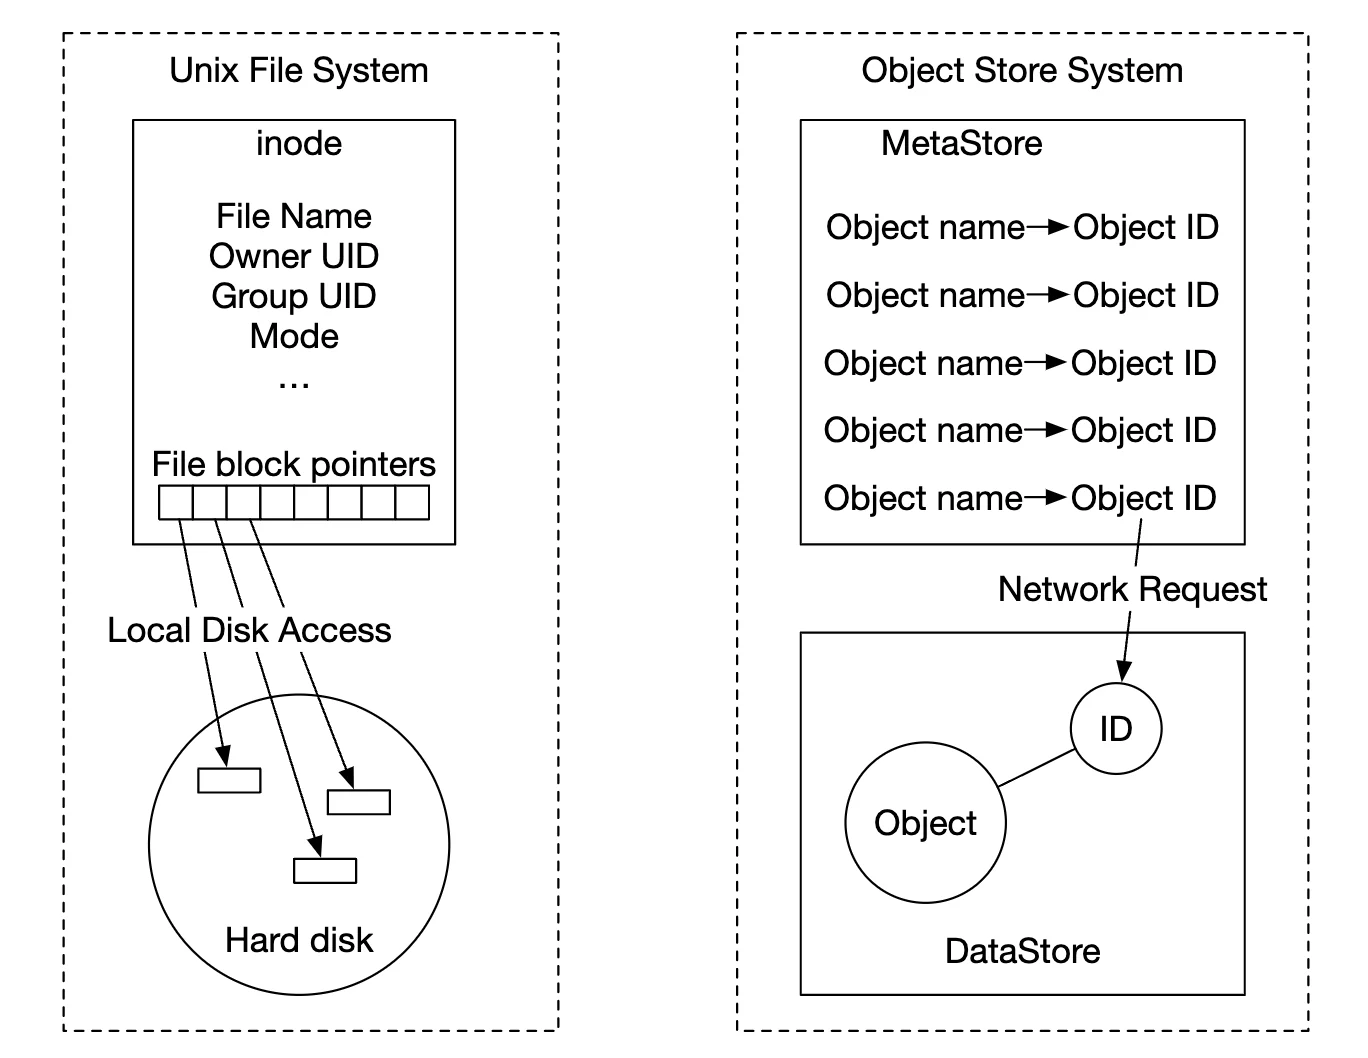
对象存储的设计理念与 UNIX 类似:保存文件时,文件名被创建在一个叫作 inode 的数据结构中,而文件数据存储在磁盘的不同位置。 inode 包含一个文件块指针列表,这些指针指向磁盘上的不同位置。
访问文件时,我们先从 inode 中获取元数据,然后再获取文件内容。
对象存储的工作方式类似:元数据存储用于保存文件信息,而内容存储在磁盘上:
通过将元数据与文件内容分离,我们可以独立扩展不同的存储:
高层设计
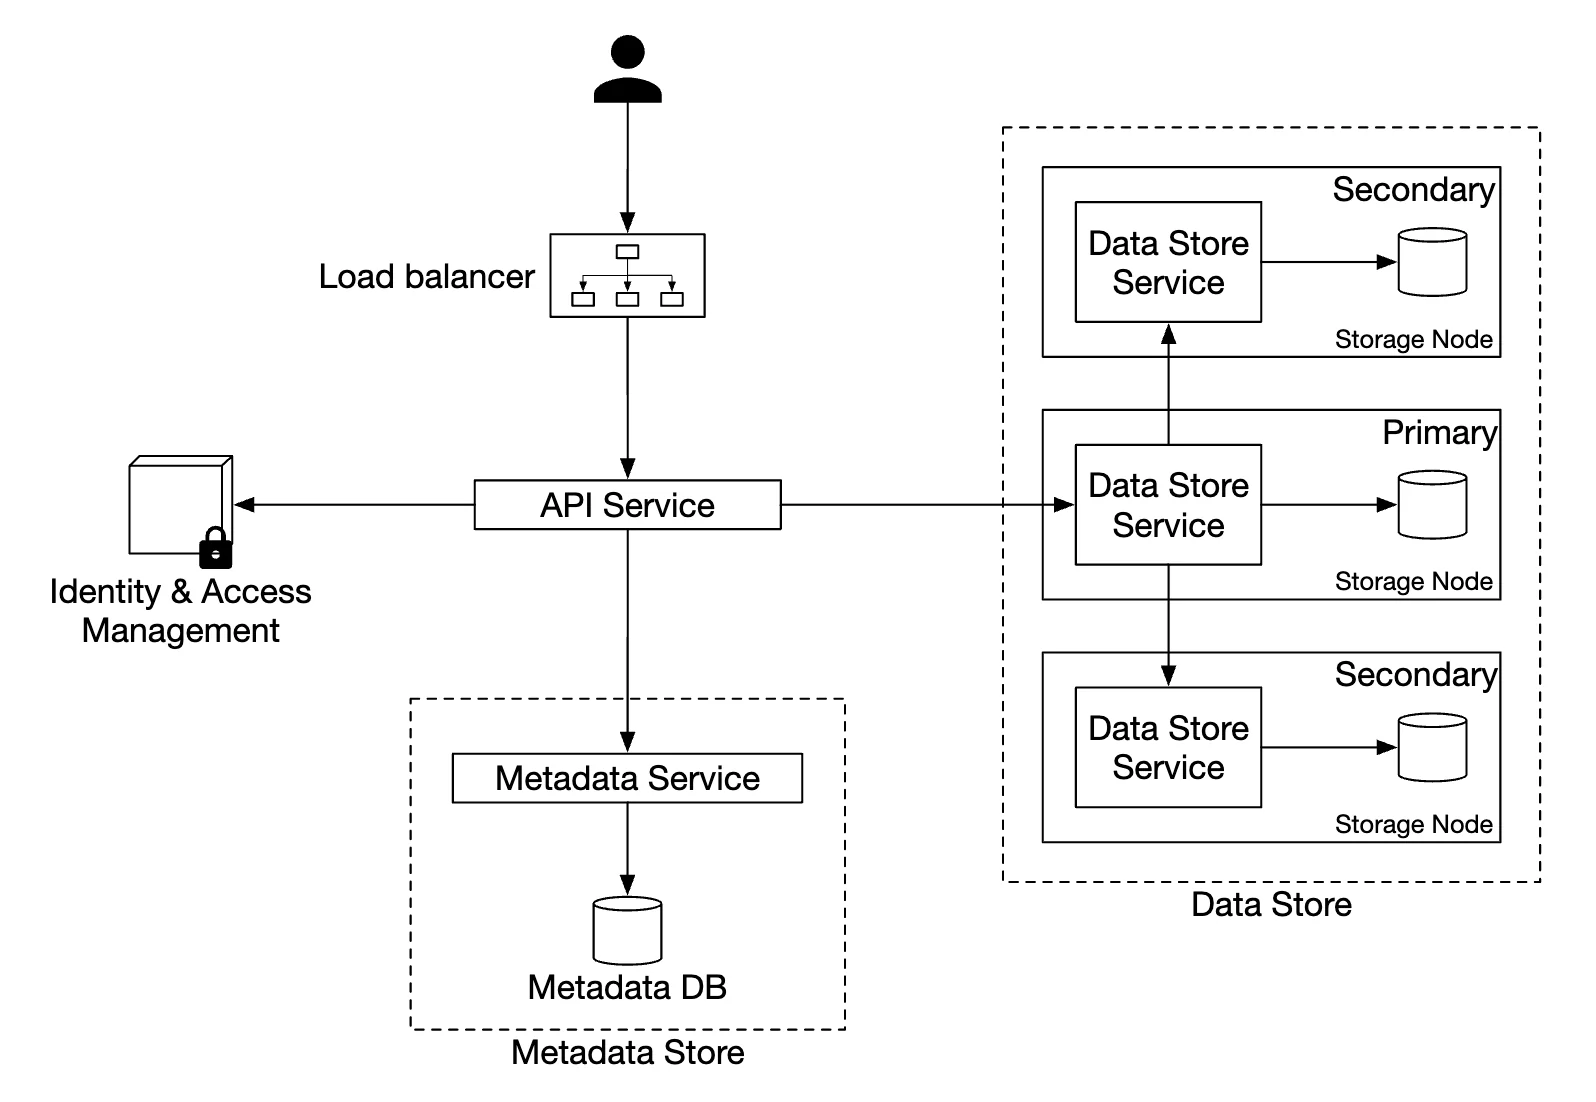
- 负载均衡器(Load Balancer):将 API 请求分发到各个服务副本
- API 服务:无状态服务器,负责编排对元数据存储、对象存储以及 IAM 服务的调用。
- 身份与访问管理(Identity and Access Management,IAM):集中处理认证、授权和访问控制的地方。
- 数据存储:存储和检索实际数据。操作基于对象 ID(UUID)。
- 元数据存储:存储对象的元数据
上传对象
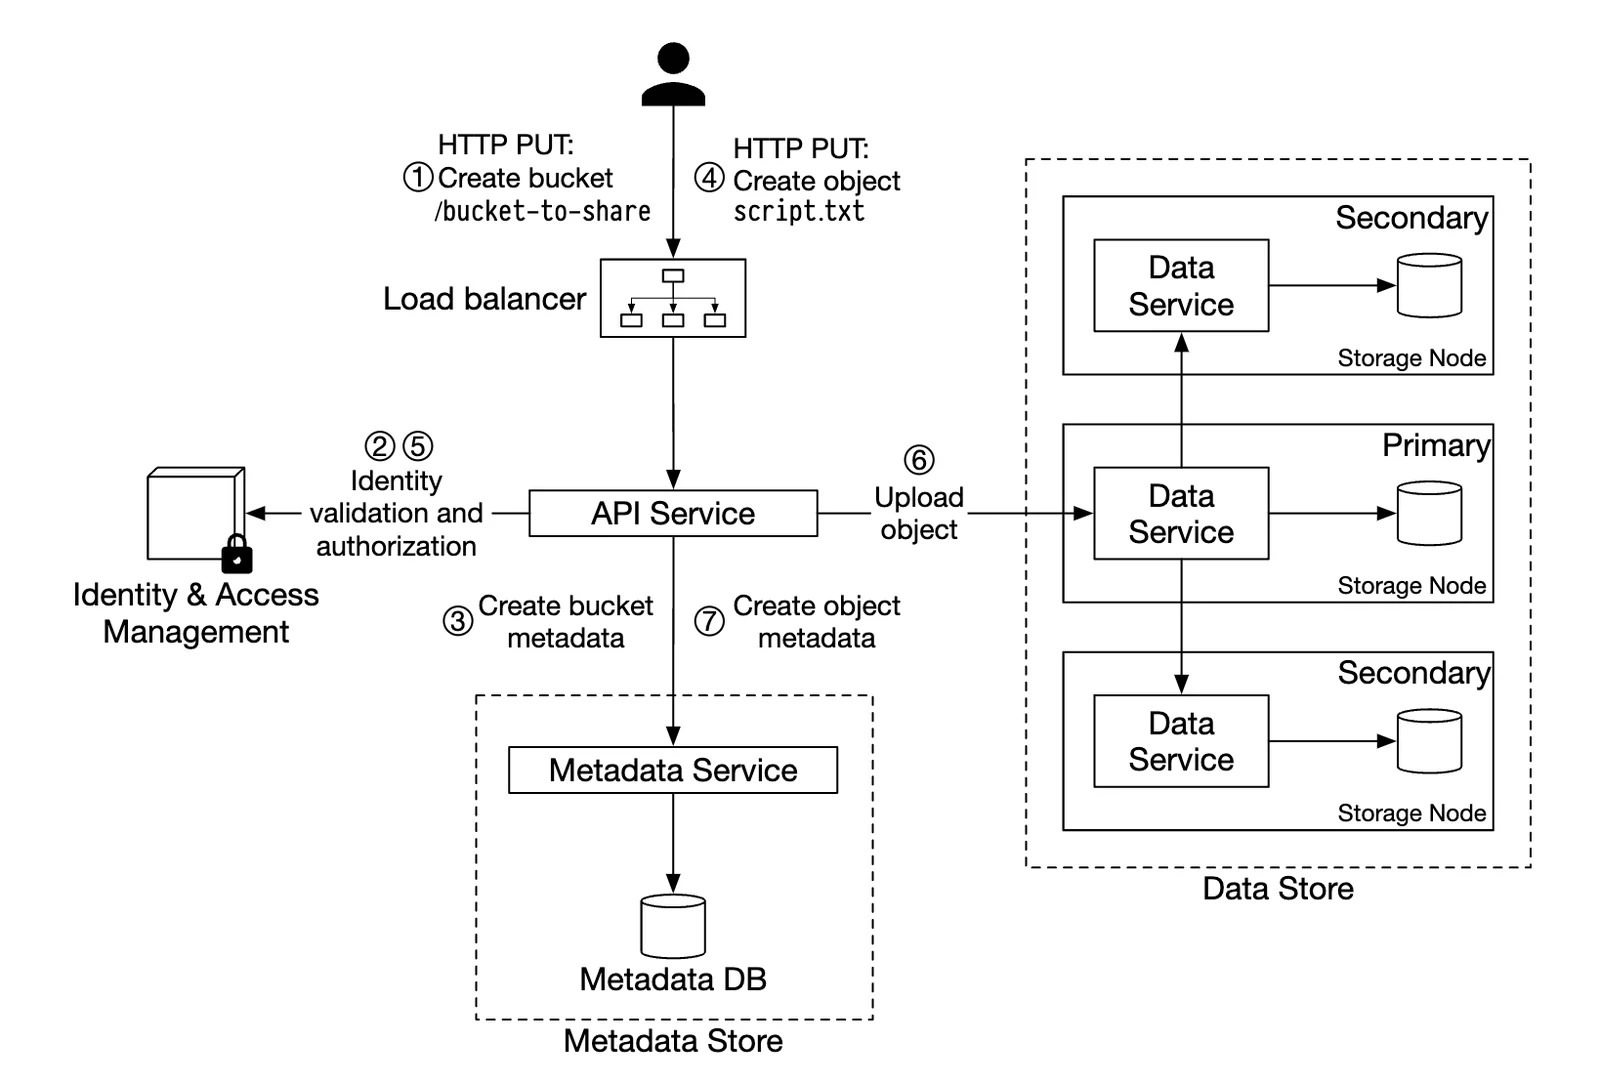
- 通过 HTTP PUT 请求创建一个名为「bucket-to-share」的存储桶
- API 服务调用 IAM,确认用户已获授权并拥有写权限
- API 服务调用元数据存储创建一条存储桶记录。创建完成后,返回成功响应。
- 存储桶创建后,发送 HTTP PUT 请求创建一个名为「script.txt」的对象
- API 服务验证用户身份,并确认用户拥有写权限
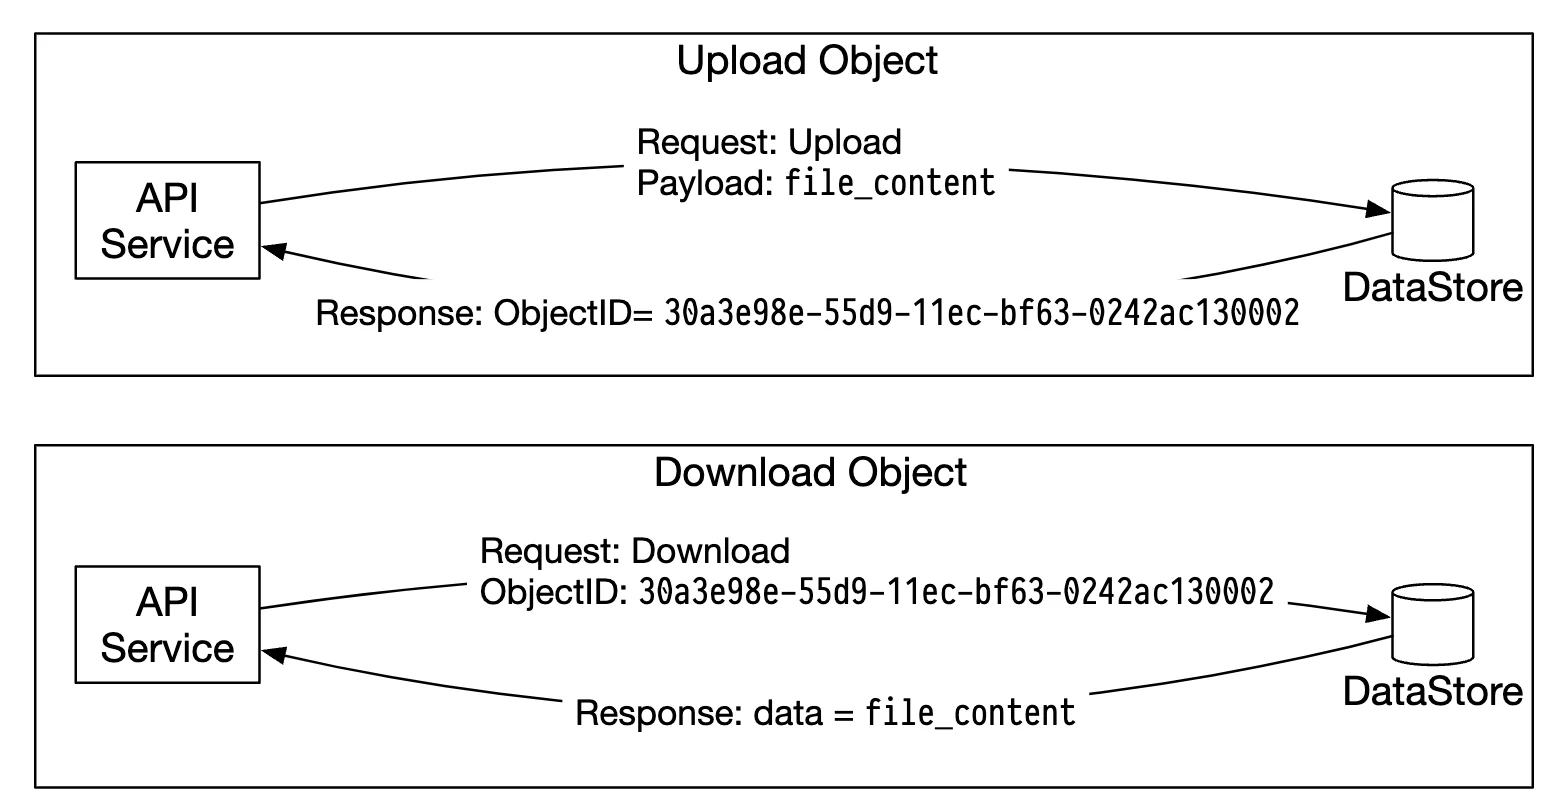
- 验证通过后,对象数据通过 HTTP PUT 发送到数据存储。数据存储将其持久化并返回一个 UUID。
- API 服务调用元数据存储创建一条新记录,其中包含 object_id、bucket_id、bucket_name 以及其他元数据。
上传对象的请求示例:
PUT /bucket-to-share/script.txt HTTP/1.1
Host: foo.s3example.org
Date: Sun, 12 Sept 2021 17:51:00 GMT
Authorization: authorization string
Content-Type: text/plain
Content-Length: 4567
x-amz-meta-author: Alex

[4567 bytes of object data]
下载对象
存储桶没有目录层级,但我们可以通过拼接存储桶名和对象名来创建逻辑层级,模拟文件夹结构。
获取对象的 GET 请求示例:
GET /bucket-to-share/script.txt HTTP/1.1
Host: foo.s3example.org
Date: Sun, 12 Sept 2021 18:30:01 GMT
Authorization: authorization string
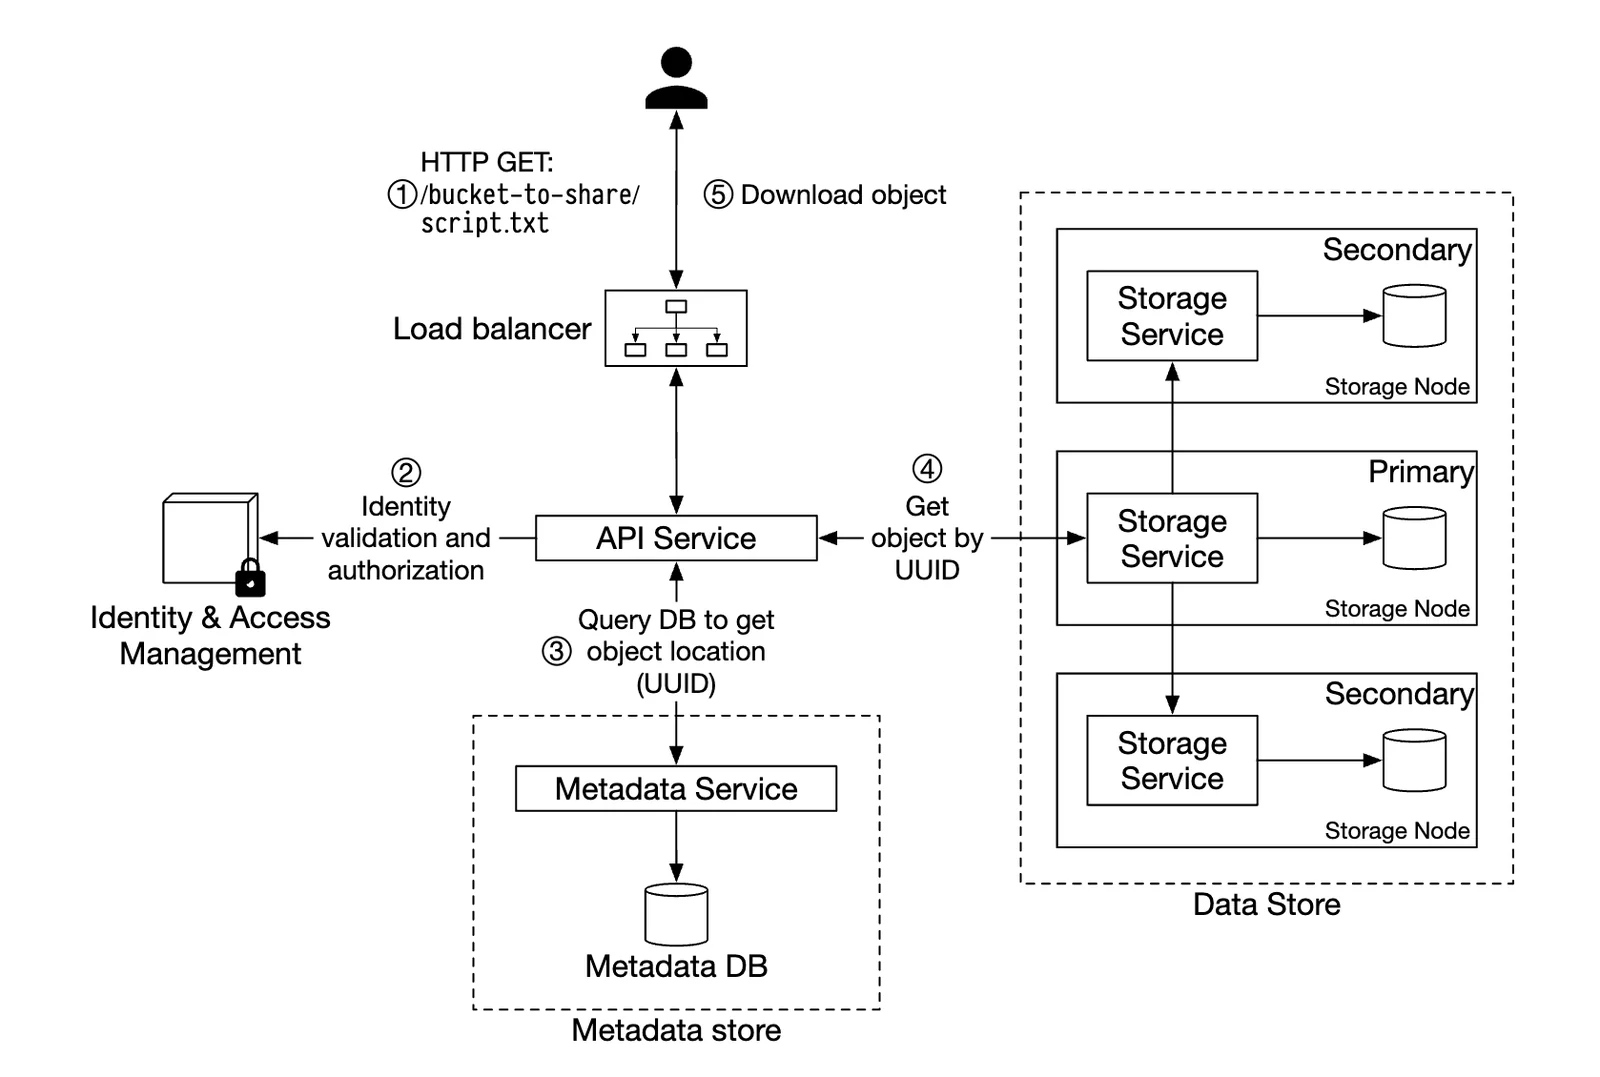
- 客户端向负载均衡器发送 HTTP GET 请求,即
GET /bucket-to-share/script.txt - API 服务查询 IAM,验证用户拥有读取该存储桶的正确权限
- 验证通过后,从元数据存储中取出对象的 UUID
- 根据 UUID 从数据存储中取出对象数据,并返回给客户端
// sprint 1
第 3 步:设计深入探讨
数据存储
API 服务与数据存储的交互方式如下:
数据存储的主要组件:
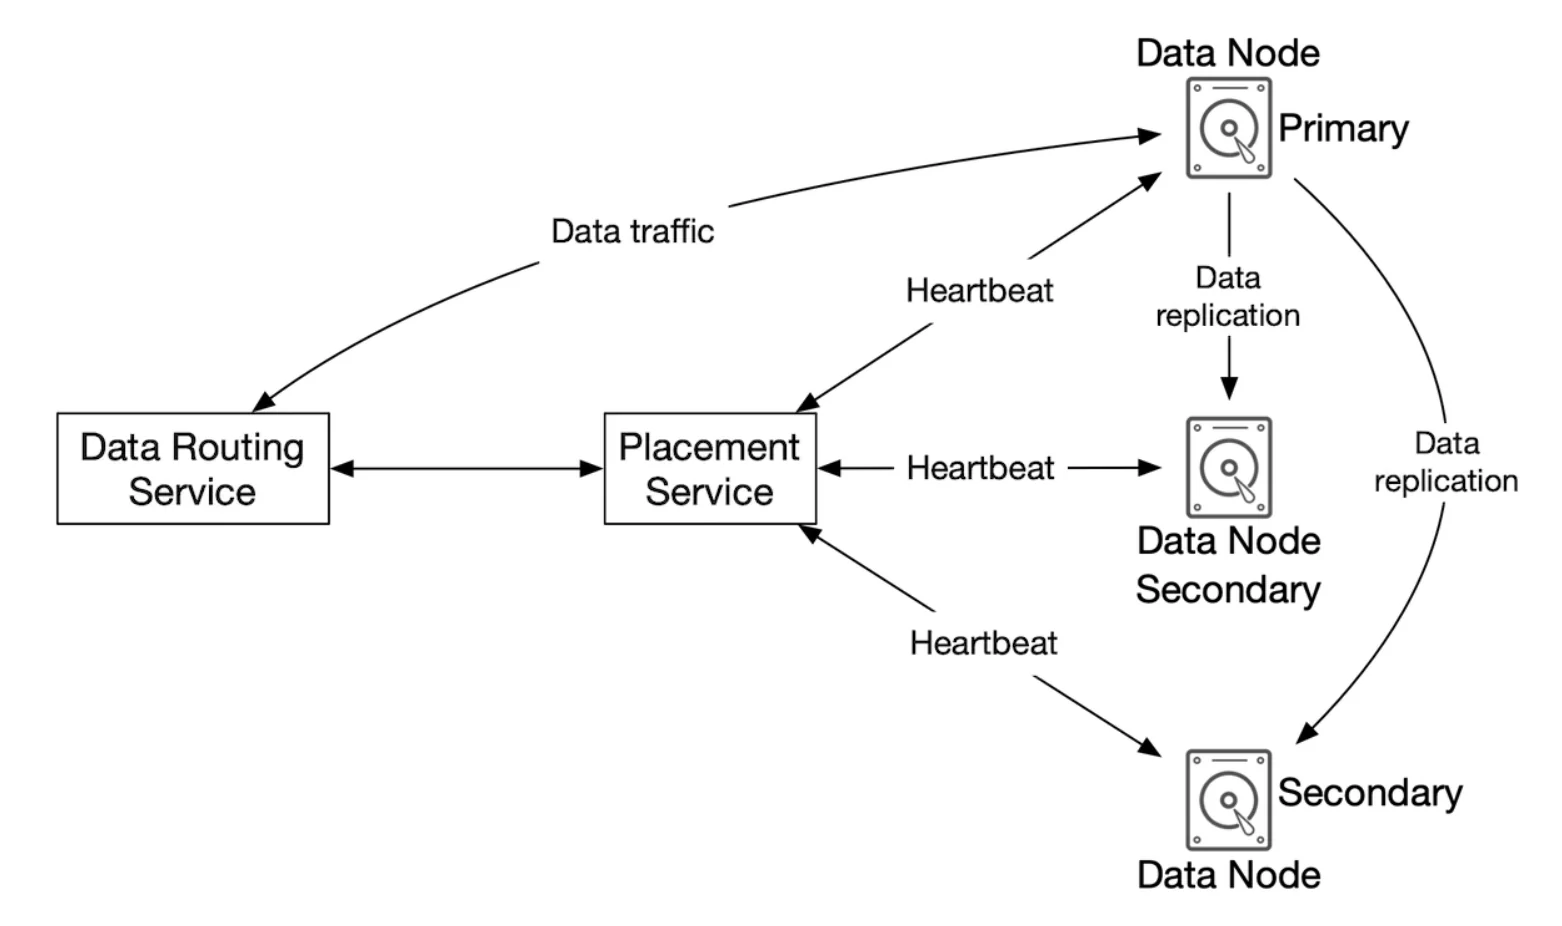
数据路由服务提供 RESTful 或 gRPC API,用于访问数据节点集群。 它是一个无状态服务,通过增加服务器来扩展。
它的主要职责是:
- 查询放置服务(Placement Service),获取存储数据的最佳数据节点
- 从数据节点读取数据并返回给 API 服务
- 向数据节点写入数据
放置服务决定一个对象应该由哪些数据节点来存储。 它维护着一张虚拟集群图(Virtual Cluster Map),用来确定集群的物理拓扑。
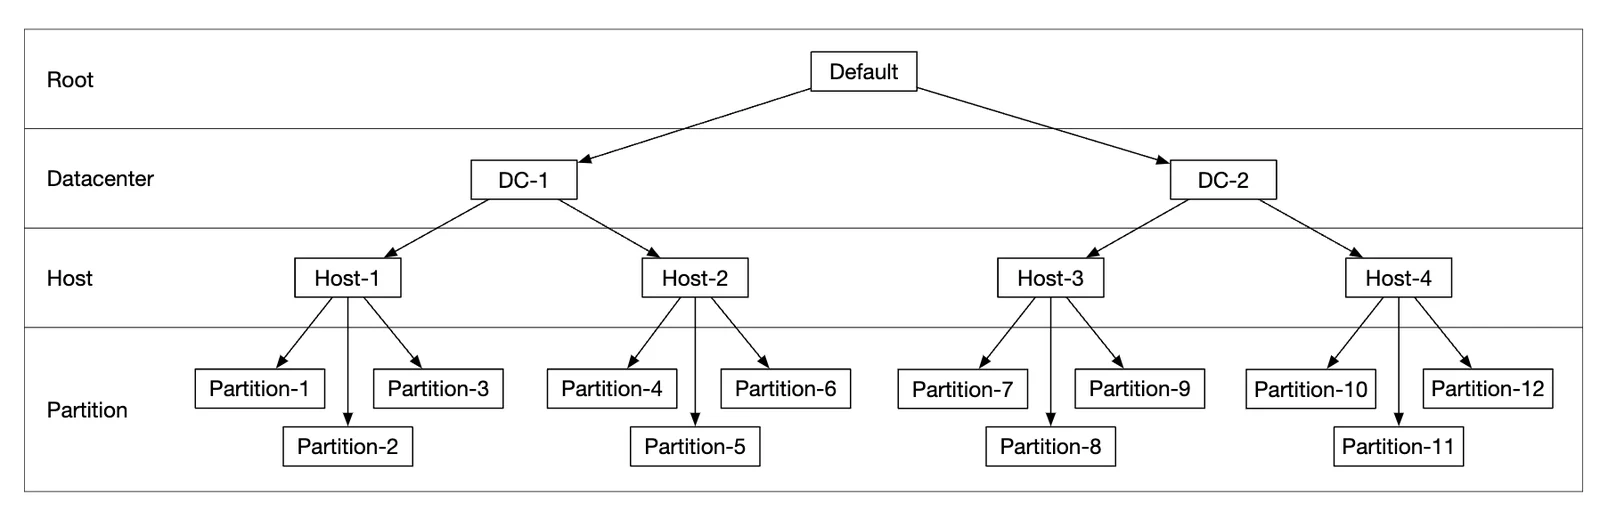
该服务还会向所有数据节点发送心跳,以确定是否应将它们从虚拟集群中移除。
由于这是一个关键服务,建议维护一个由 5 个或 7 个副本组成的集群,通过 Paxos 或 Raft 共识算法进行同步。 例如,一个 7 节点的集群可以容忍 3 个节点故障。
数据节点存储实际的对象数据。 通过将数据复制到多个数据节点来保证可靠性和持久性。
每个数据节点上都运行着一个守护进程,负责向放置服务发送心跳。
心跳包含:
- 该数据节点管理多少块磁盘驱动器(HDD 或 SSD)?
- 每块驱动器上存储了多少数据?
数据持久化流程
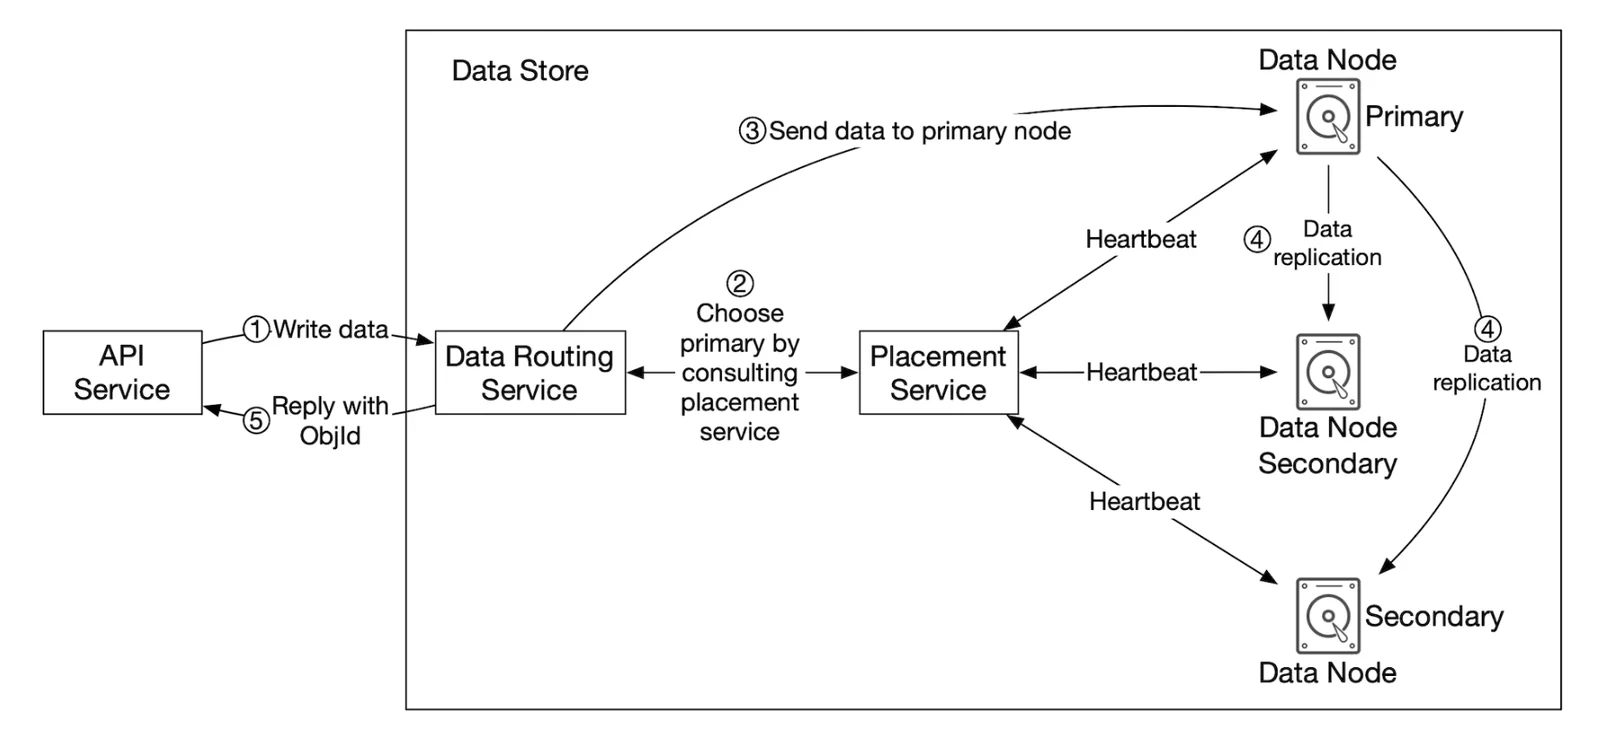
- API 服务将对象数据转发给数据存储
- 数据路由服务将数据发送到主数据节点
- 主数据节点在本地保存数据,并将其复制到两个从数据节点。复制成功后才发送响应。
- 对象的 UUID 被返回给 API 服务。
注意事项:
- 给定一个对象 UUID,它的复制组是通过一致性哈希(Consistent Hashing)确定性地选出的
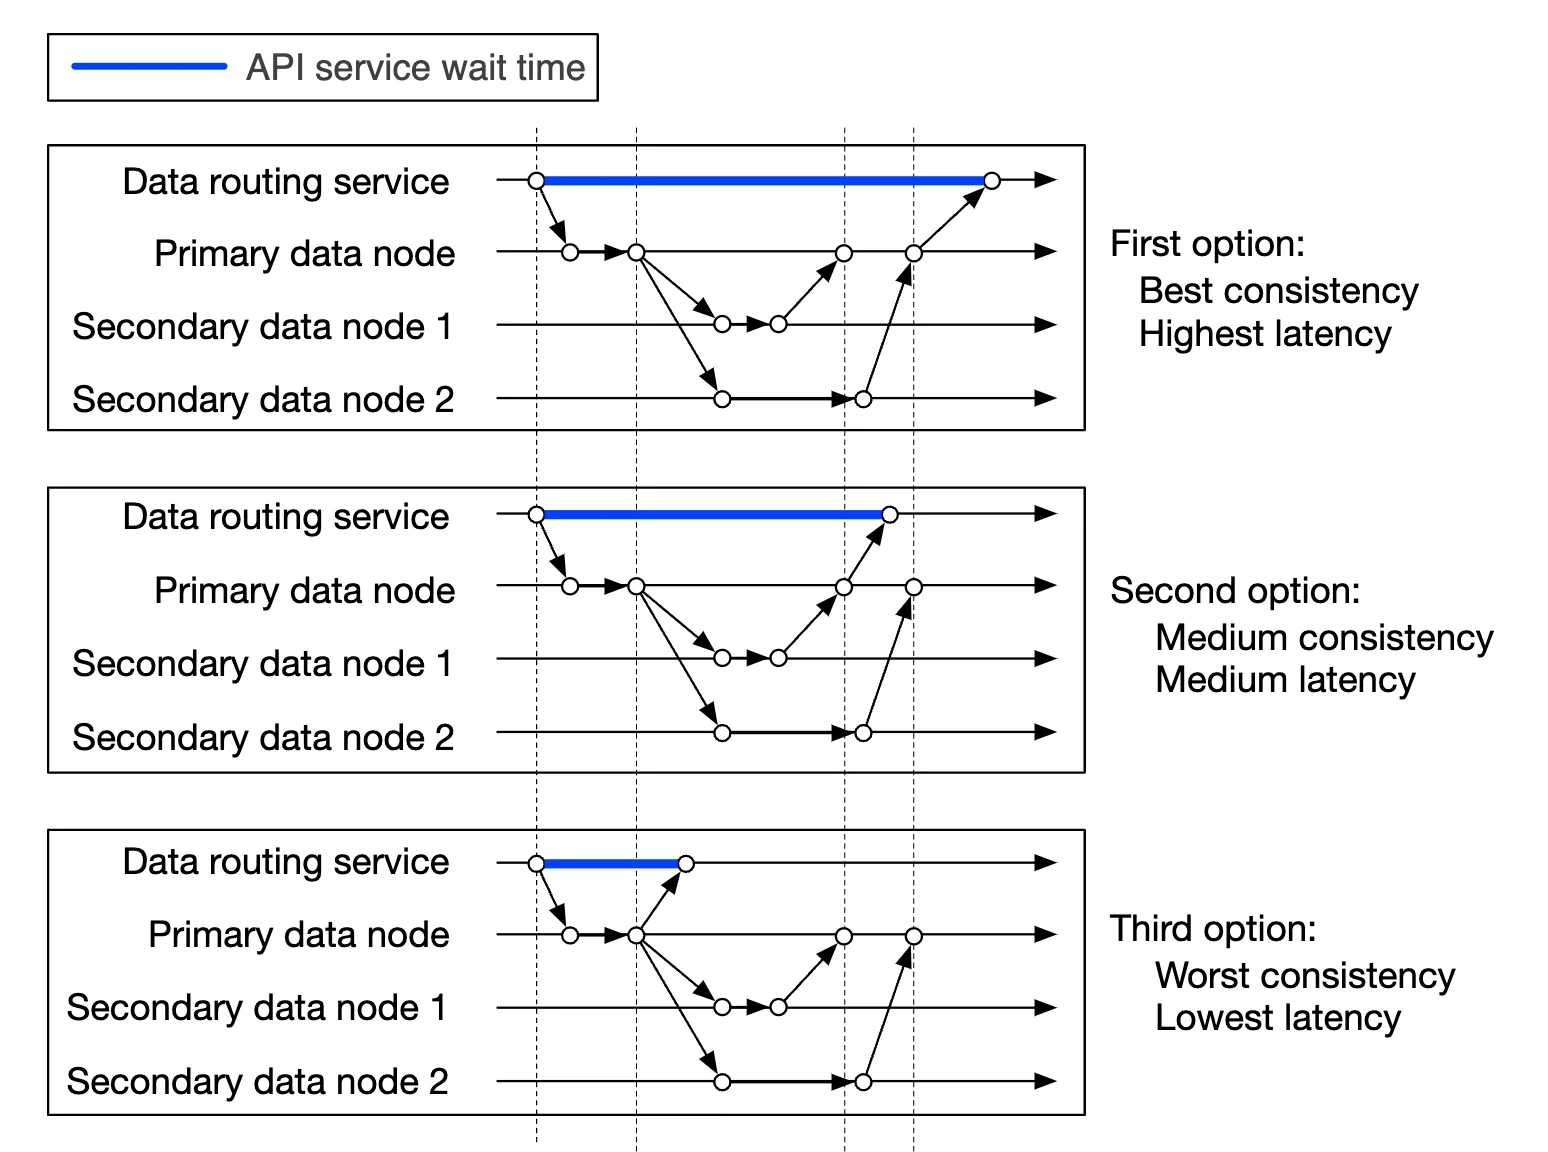
- 在第 4 步中,主数据节点先复制对象数据再返回响应。这是以更高的延迟换取强一致性。
数据如何组织
管理数据的一个简单方法是把每个对象存储在一个单独的文件中。
这样可行,但当文件系统中有大量小文件时,性能不佳:
- HDD 上的数据块会被浪费,因为每个文件都会占用整个块。典型的块大小为 4 KB。
- 文件多意味着 inode 多。操作系统不擅长处理过多的 inode,而且 inode 数量也有上限。
这些问题可以通过预写日志(Write-ahead Log,WAL)把许多小文件合并成大文件来解决。当文件达到容量上限(通常为几 GB)时,就创建一个新文件:
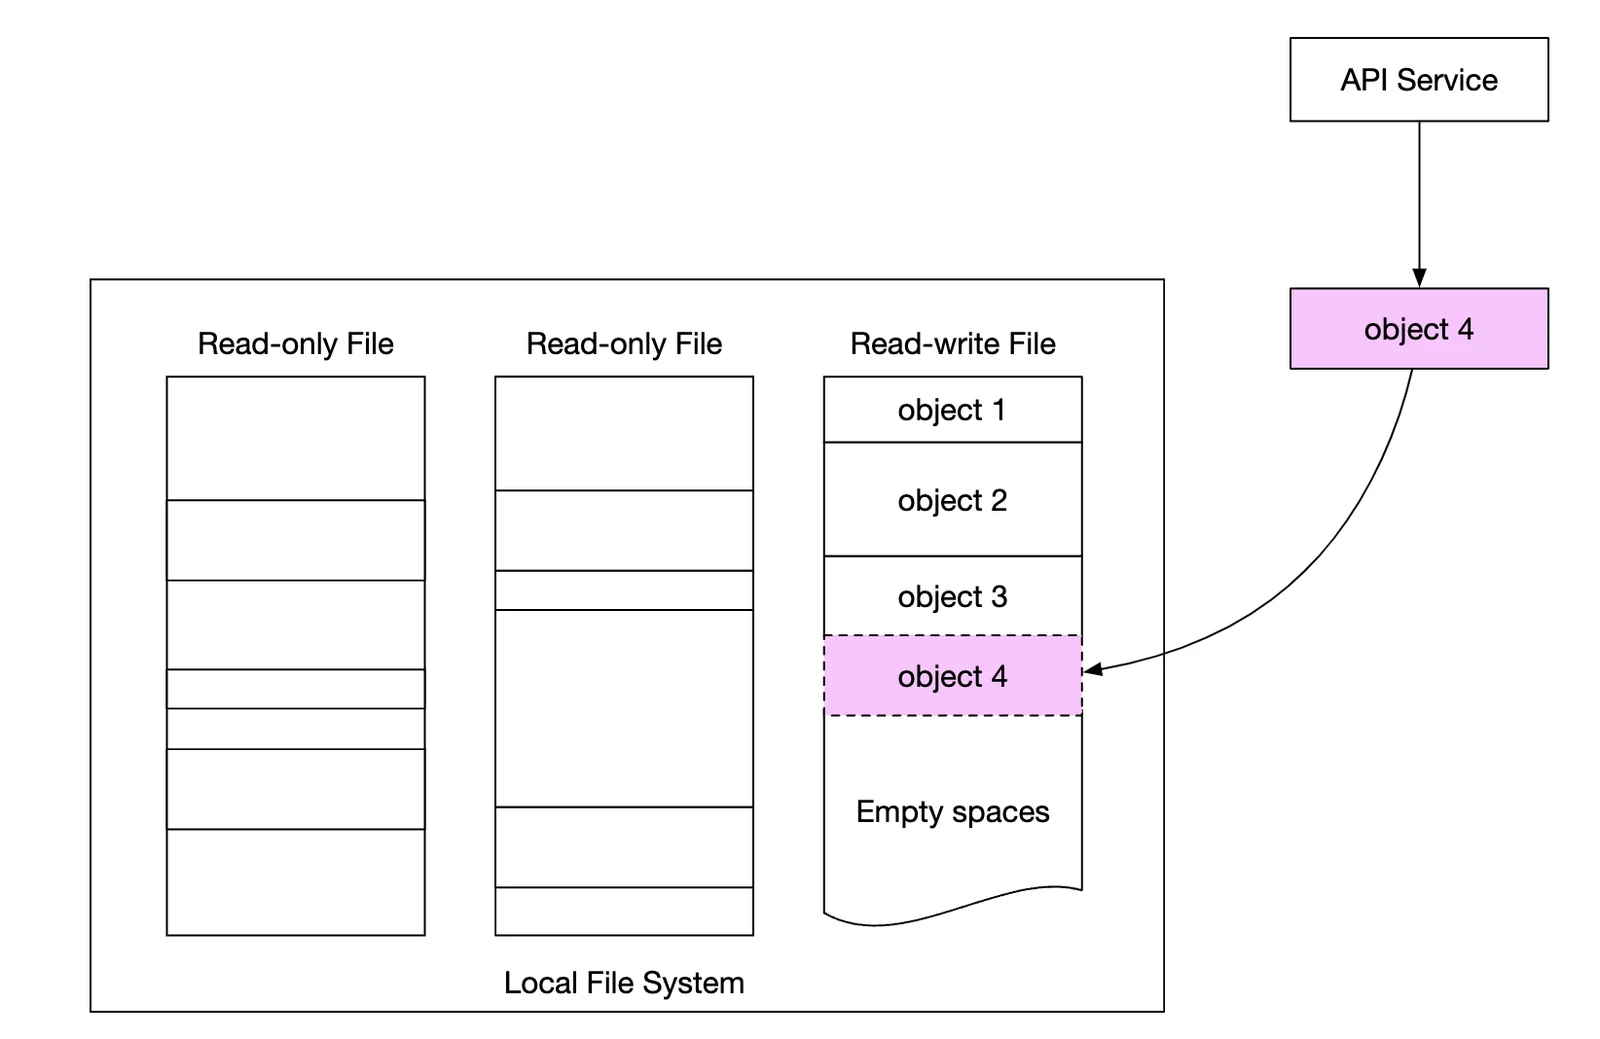
这种方法的缺点是,对文件的写访问必须串行化。访问同一个文件的多个核心必须相互等待。 为了解决这个问题,我们可以将文件绑定到特定的核心,以避免锁争用。
对象查找
为了支持在同一个文件中存储多个对象,我们需要维护一张表,告诉数据节点:
object_id- 对象所在的文件名
filename - 对象在文件中的起始偏移量
file_offset - 对象大小
object_size
这张表可以部署在 RocksDB 这类基于文件的数据库中,也可以部署在传统的关系型数据库中。 由于访问模式是写少读多,关系型数据库效果更好。
应该如何部署它? 我们可以把数据库单独部署成一个集群并独立扩展,由所有数据节点访问。
缺点:
- 我们需要大力扩展该集群才能处理所有请求
- 数据节点与数据库集群之间存在额外的网络延迟
另一种方案是利用这样一个事实:数据节点只关心与自己相关的数据, 因此我们可以把关系型数据库部署在数据节点内部。
SQLite 是个不错的选择,它是一个轻量级的基于文件的关系型数据库。
更新后的数据持久化流程
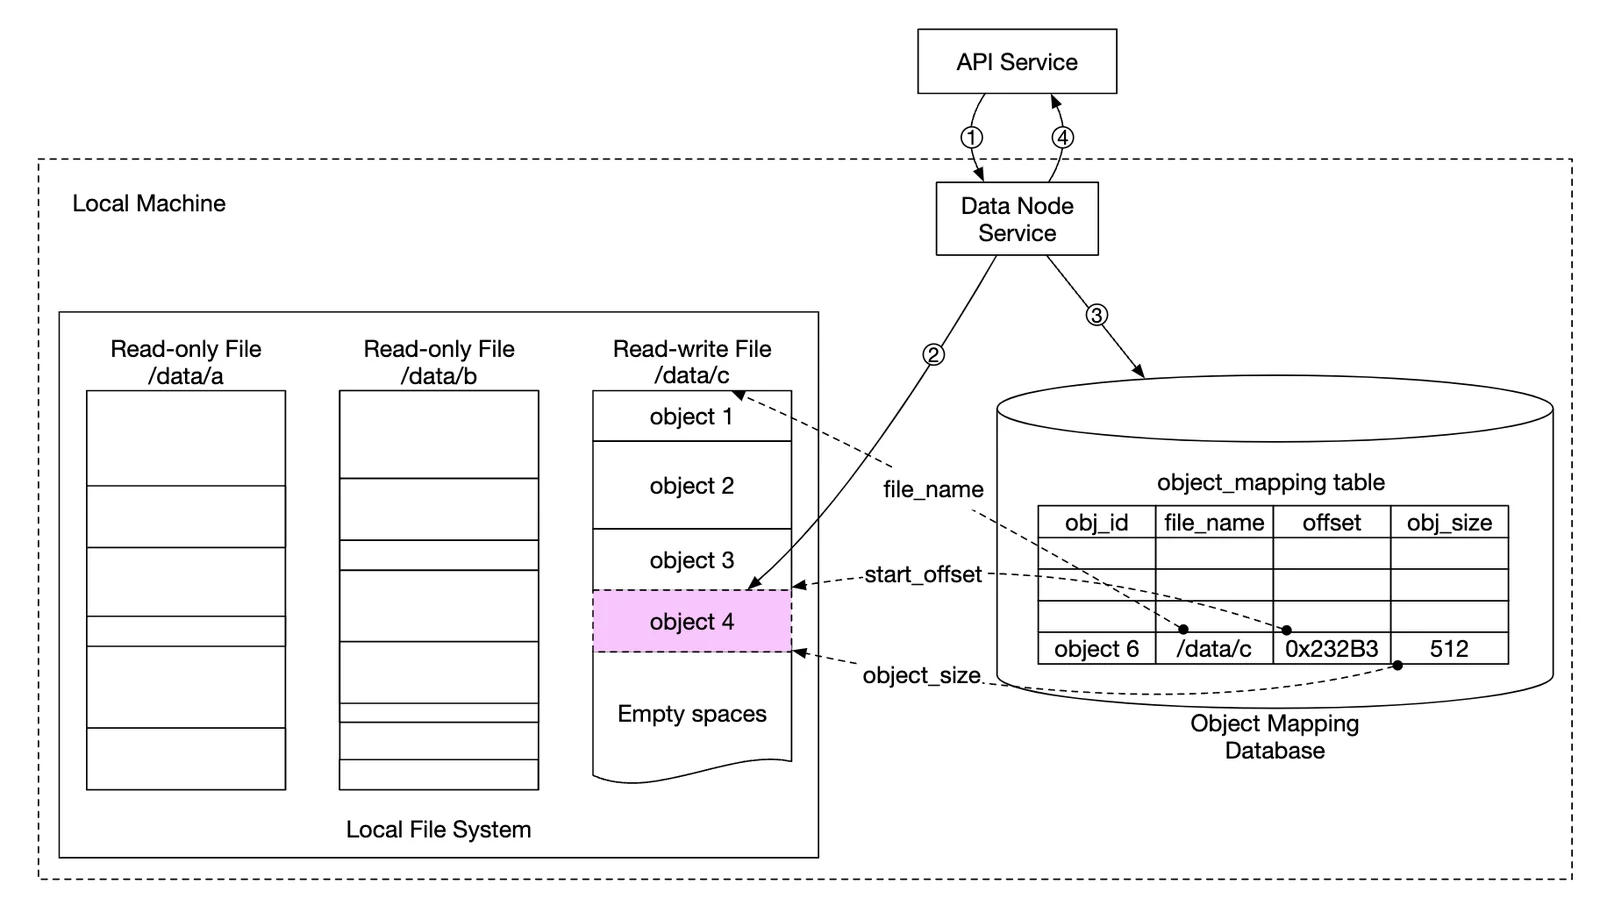
- API 服务发送保存新对象的请求
- 数据节点服务将新对象追加到名为「/data/c」的文件末尾
- 在对象映射表中插入该对象的一条新记录
持久性
数据持久性(Durability)是我们设计中的一项重要需求。为了达到 6 个 9 的持久性,每一种故障情况都需要仔细考察。
首先要解决的问题是硬件故障。我们可以通过复制数据节点来降低故障概率。 但除此之外,我们还应该跨不同的故障域(Failure Domain)进行复制(跨机架、跨数据中心、隔离的网络等)。 一个重大事件可能导致同一故障域内的多个硬件同时故障:
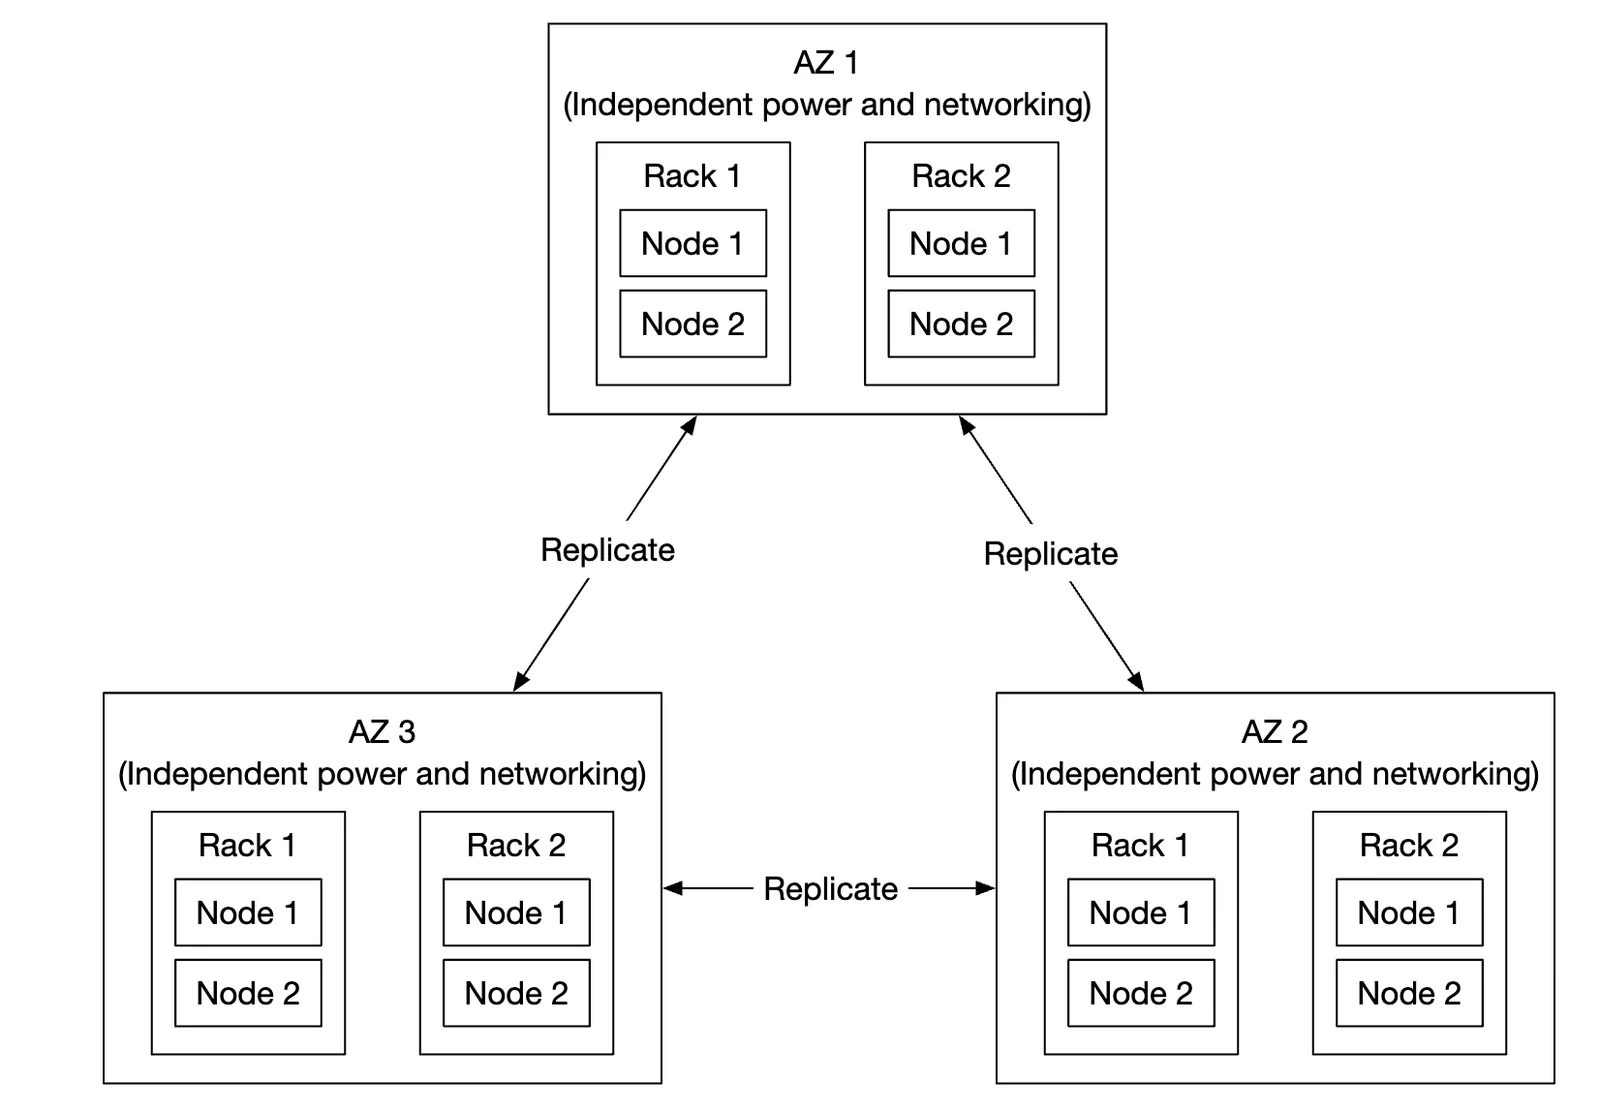
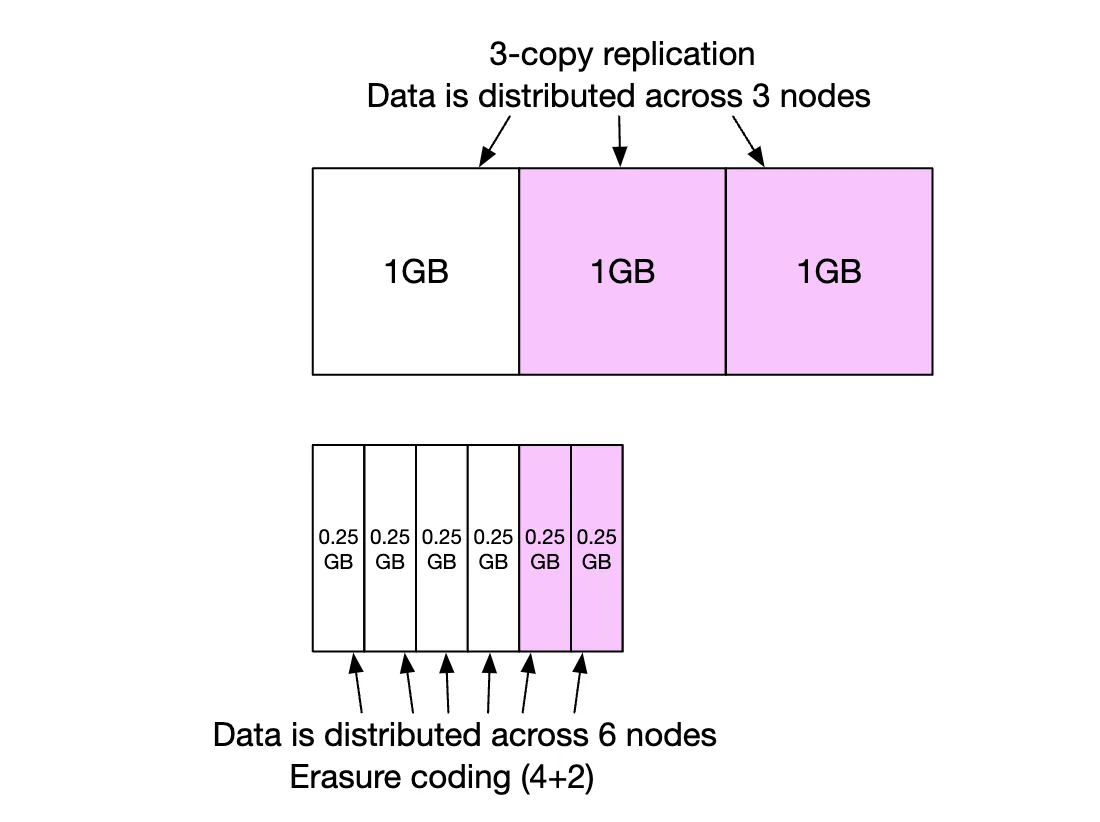
假设典型 HDD 的年故障率为 0.81%,保存三份副本就能达到 6 个 9 的持久性。
像这样复制数据节点可以提供我们想要的持久性,但我们也可以利用纠删码(Erasure Coding)来降低存储成本。
纠删码让我们可以使用校验位(Parity Bits),在发生故障时重建丢失的位:
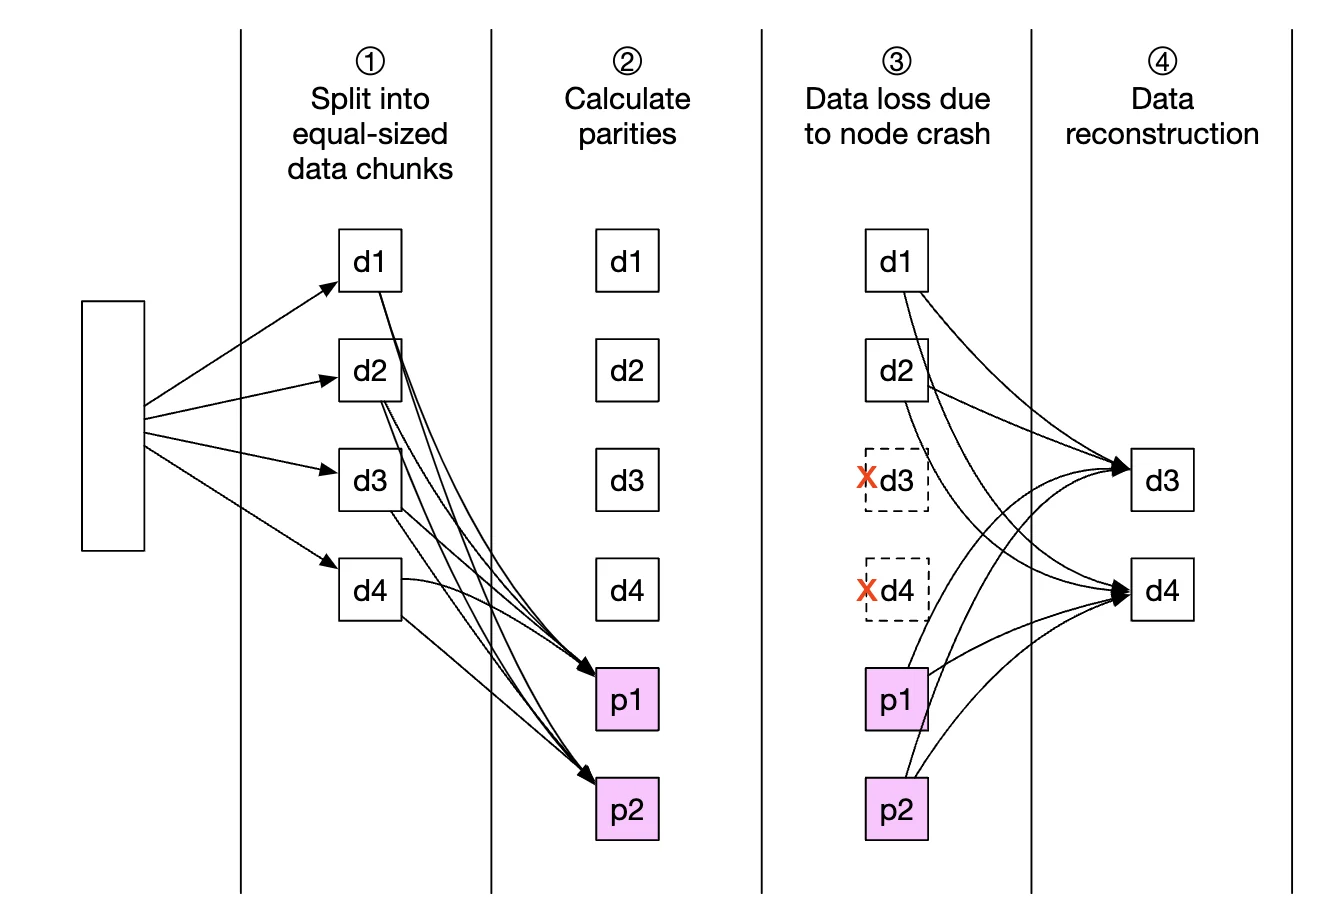
把这些位想象成数据节点。如果其中两个宕机,可以用其余四个恢复它们。
纠删码有不同的方案。在我们的场景中,可以使用 8+4 纠删码,并分散到不同的故障域中以最大化可靠性:
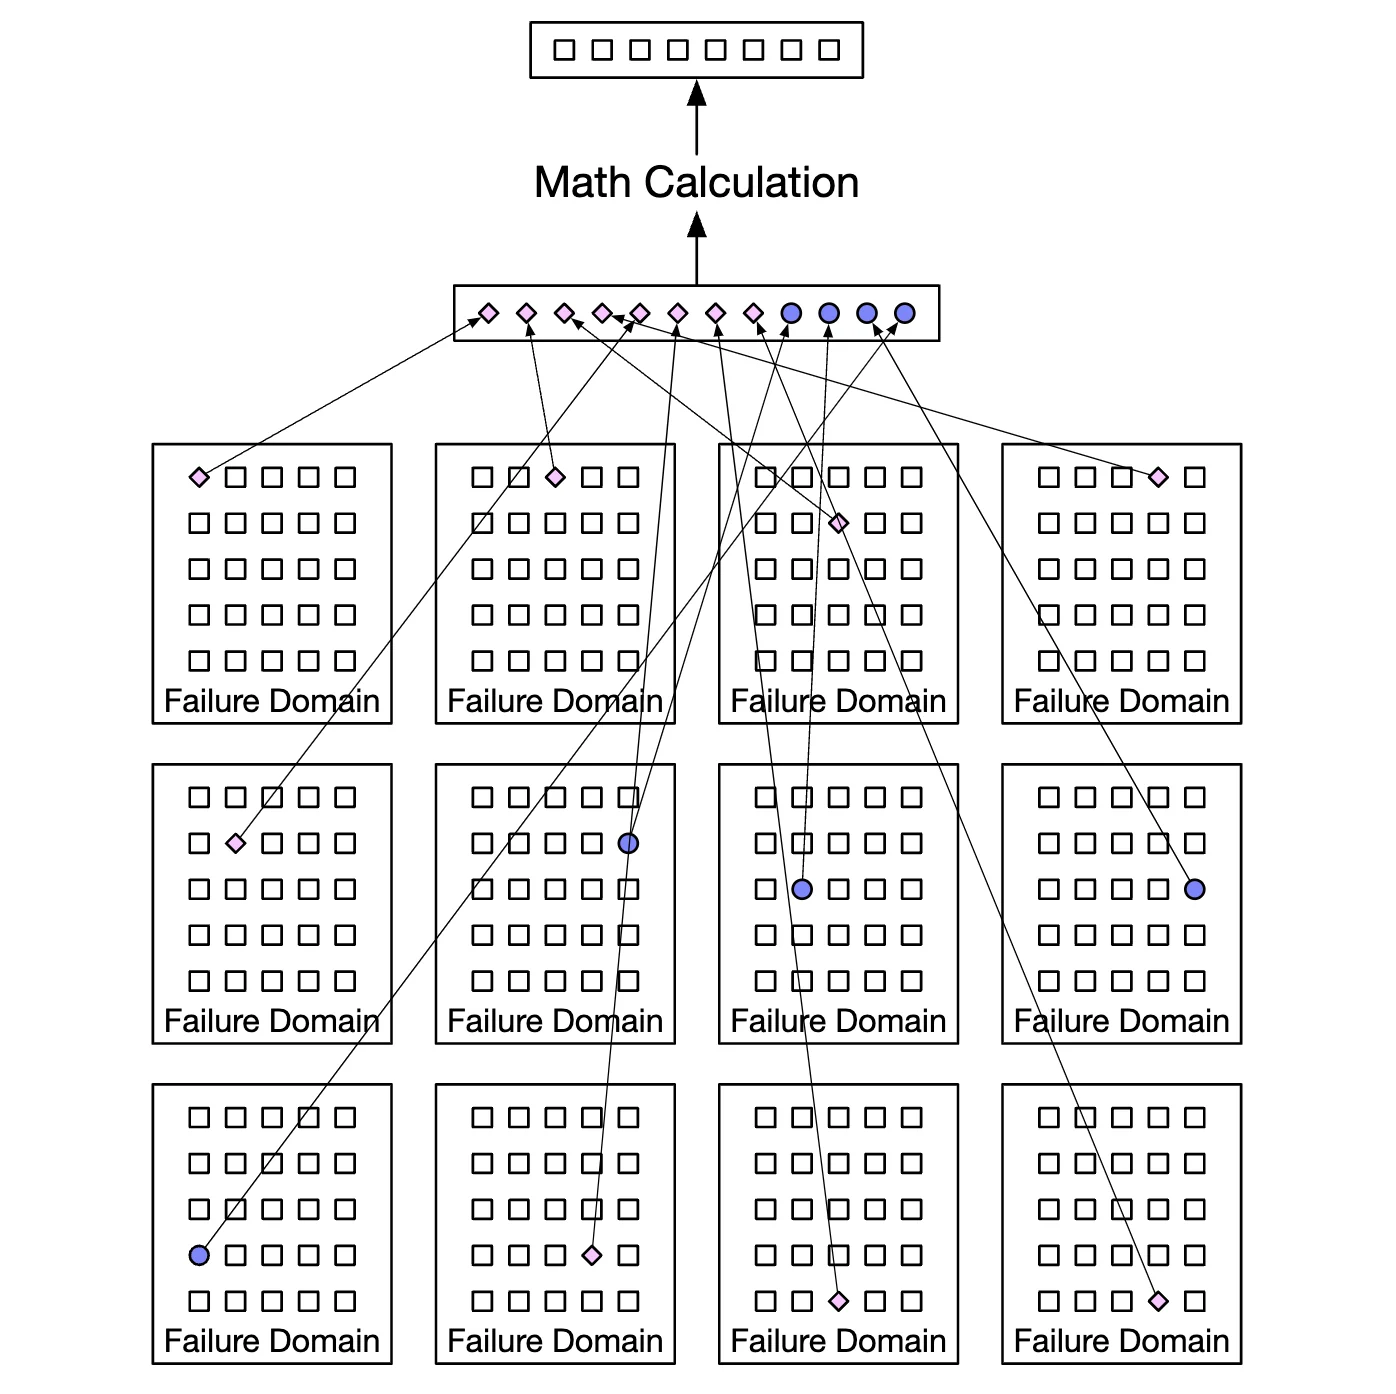
纠删码能让我们以低得多的成本存储数据(提升 50%),代价是访问速度变慢,因为数据路由服务必须从多个位置收集数据:
其他注意事项:
- 复制需要 200% 的存储开销(3 副本的情况下),而纠删码只需 50%
- 纠删码能提供 11 个 9 的持久性,而复制只有 6 个 9
- 纠删码需要更多的计算来计算和存储校验数据
总之,复制更适合对延迟敏感的应用,而纠删码在存储成本效率和持久性方面更有吸引力。 纠删码的实现难度也要大得多。
正确性校验
如果整块磁盘发生故障,故障很容易被检测到。但如果只是磁盘的一部分数据损坏,就没那么容易发现了。
为了检测这种情况,我们可以使用校验和(Checksum):它是文件内容的哈希值,可用来验证文件的完整性。
在我们的设计中,会为每个文件和每个对象都存储校验和:
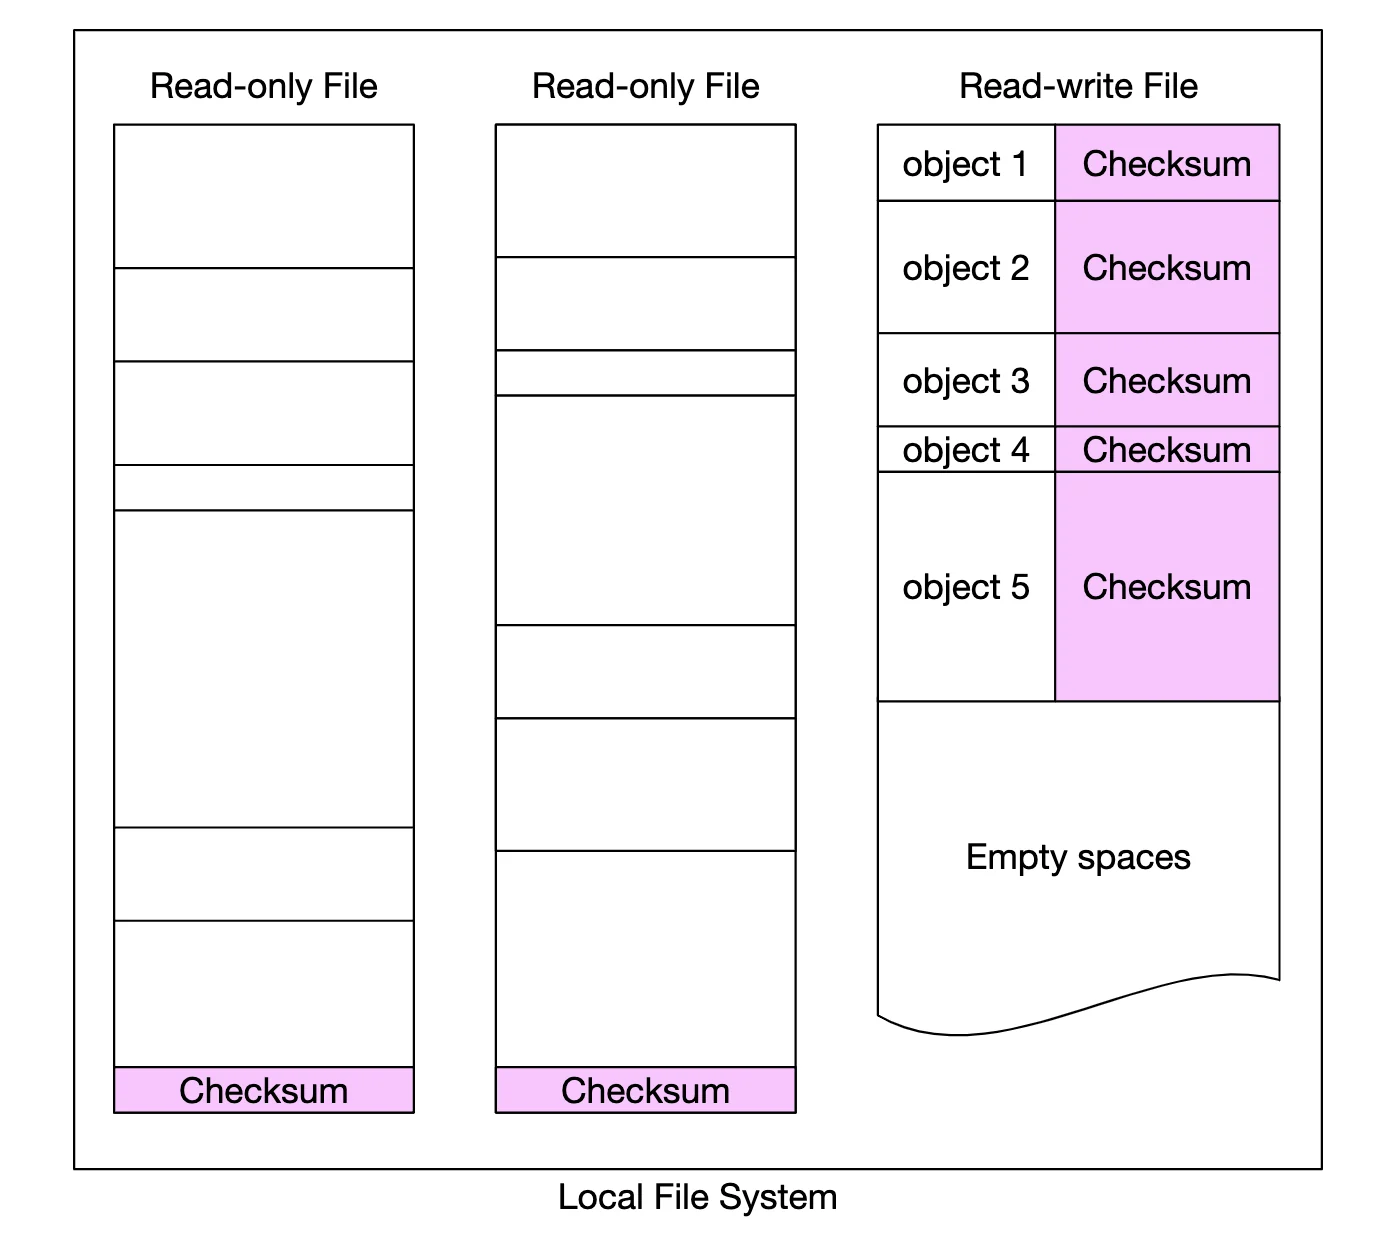
在纠删码(8+4)的情况下,我们需要分别获取 8 份数据中的每一份,并逐一验证它们的校验和。
// sprint 2
元数据的数据模型
表结构:
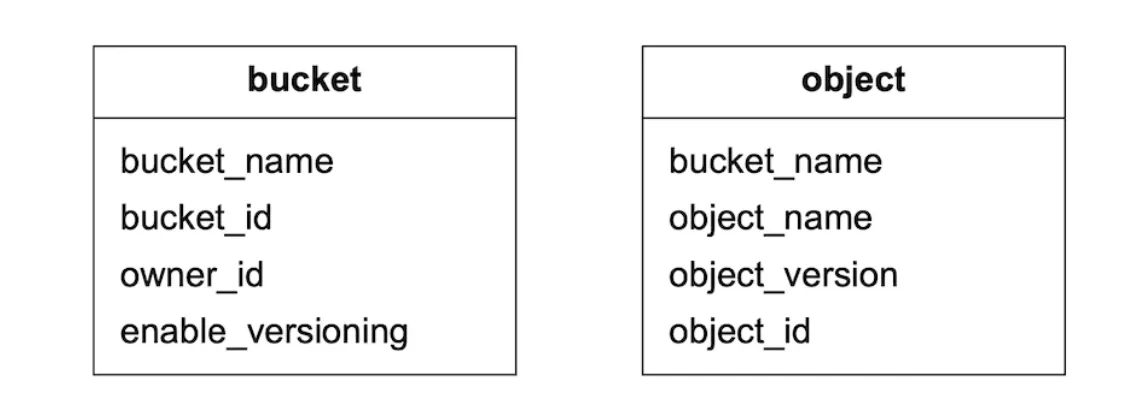
我们需要支持的查询:
- 根据名称查找对象 ID
- 根据名称插入/删除对象
- 列出存储桶中具有相同前缀的对象
用户能创建的存储桶数量通常有上限,因此存储桶表很小,可以放进单台数据库服务器。 但我们仍然需要扩展服务器以提升读吞吐量。
不过,对象表可能放不进单台数据库服务器。因此,我们可以通过分片来扩展该表:
- 按 bucket_id 分片会导致热点问题,因为一个存储桶可能包含数十亿个对象
- 按 bucket_id 分片能让负载分布更均匀,但我们的查询会很慢
- 我们选择按
hash(bucket_name, object_name)分片,因为大多数查询都是基于对象名/存储桶名进行的。
但即使采用这种分片方案,列出存储桶中的对象仍会很慢。
列出存储桶中的对象
在单个数据库中,基于前缀(看起来像目录)列出对象的方式如下:
SELECT * FROM object WHERE bucket_id = "123" AND object_name LIKE `abc/%`
当数据库分片后,这就很难实现了。为此,我们可以在每个分片上执行该查询,再在内存中聚合结果。 但这会让分页变得困难,因为不同分片返回的结果数量不同,我们需要为每个分片分别维护 limit/offset。
我们可以利用这样一个事实:对象存储通常并不针对列出对象做优化,因此可以牺牲列表性能。 我们也可以创建一张专门用于列出对象的反规范化(Denormalized)表,按存储桶 ID 分片。 这样列表查询就足够快了,因为它只涉及单个数据库实例。
对象版本控制
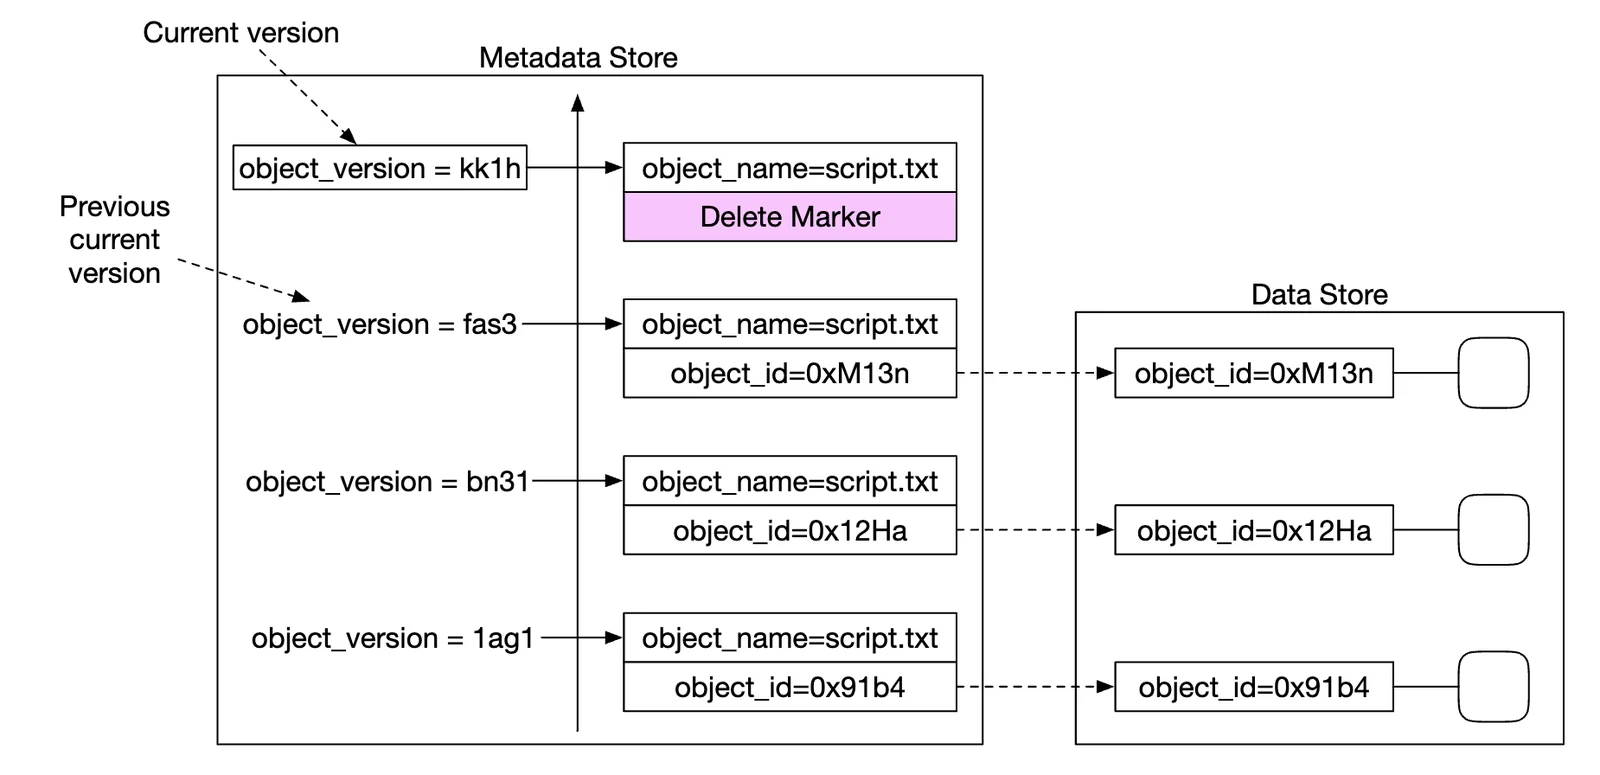
版本控制的实现方式是增加一个类型为 TIMEUUID 的 object_version 列,使我们可以据此对记录排序。
每个新版本都会产生一个新的 object_id:
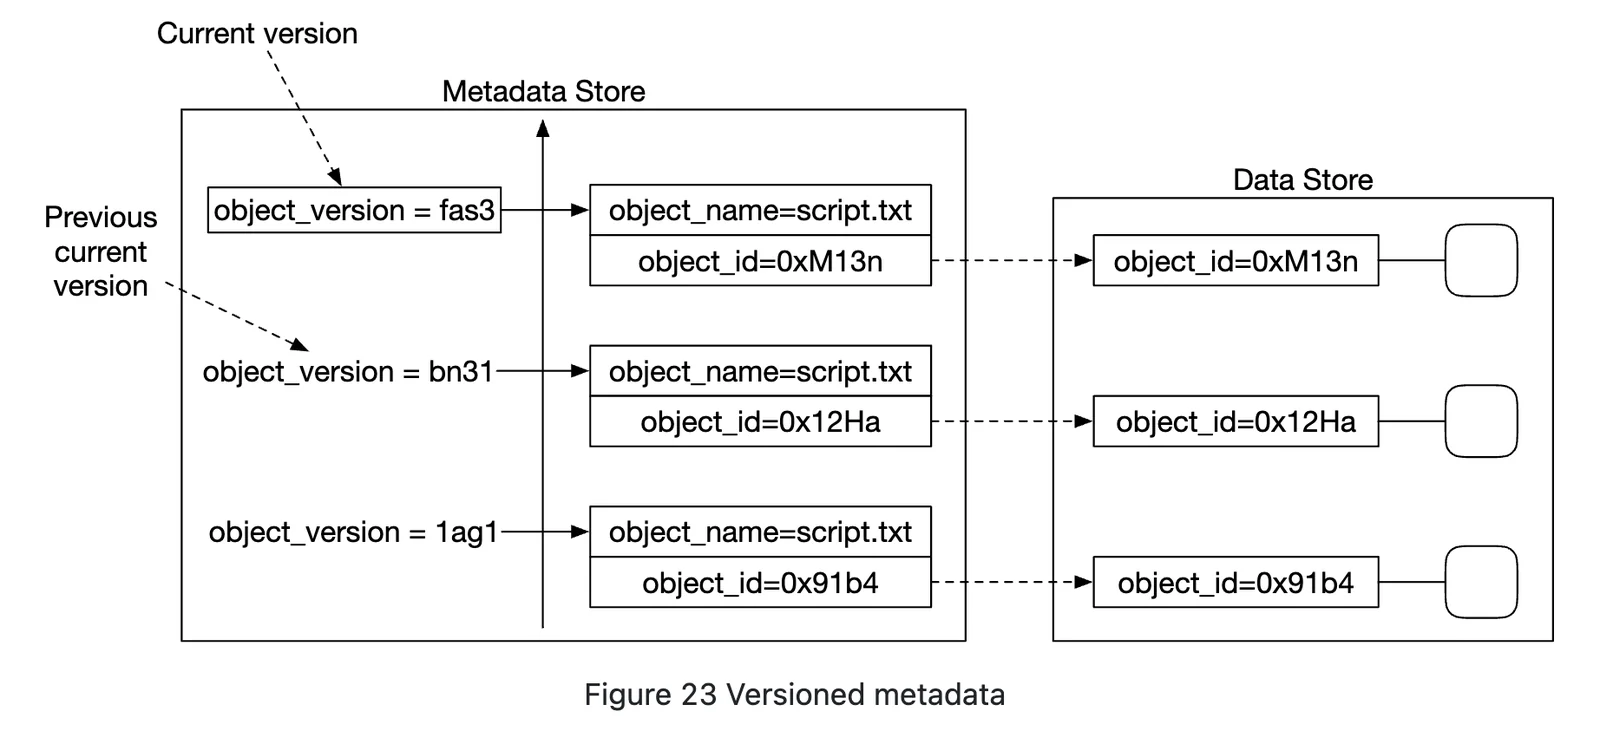
删除对象会创建一个新版本,其 object_id 是一个特殊值,表示该对象已被删除。查询该对象将返回 404:
优化大文件上传
大文件上传可以通过分段上传(Multipart Upload)来优化:把一个大文件拆分成若干块,分别独立上传:
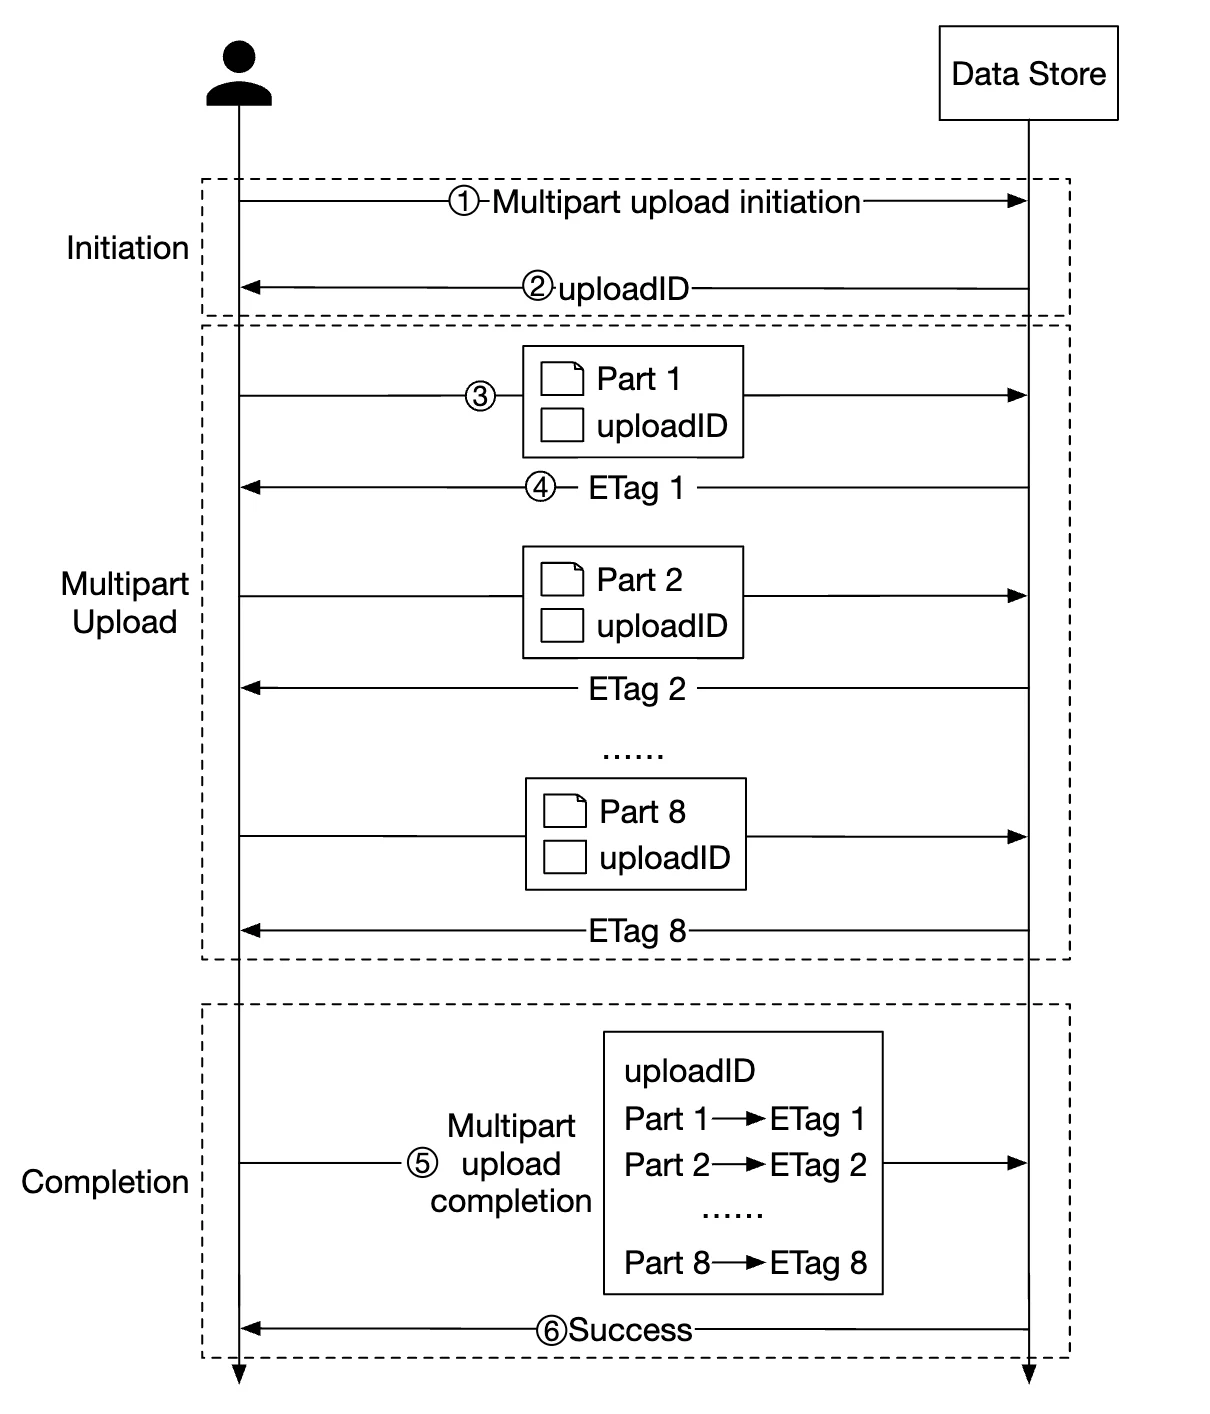
- 客户端调用服务,发起一次分段上传
- 数据存储返回一个上传 ID,用于唯一标识这次上传
- 客户端把大文件拆分成若干块,使用该上传 ID 分别独立上传
- 每上传完一块,数据存储会返回一个 etag,它是一个 MD5 校验和,用于标识该上传块
- 所有分段上传完成后,客户端发送一个完成分段上传的请求,其中包含 upload_id、分段编号以及所有 etag
- 数据存储将各分段重新组装成对象。这个过程可能需要几分钟。完成后,向客户端返回成功响应。
此时,不再有用的旧分段可以被删除。我们可以引入一个垃圾回收器来处理这件事。
垃圾回收
垃圾回收(Garbage Collection)是回收不再使用的存储空间的过程。数据变成垃圾有以下几种情况:
- 延迟删除对象:对象被标记为已删除,但实际上并没有被删除
- 孤立数据:例如上传中途失败,需要删除旧的分段
- 损坏数据:未通过校验和验证的数据
垃圾回收器还负责回收副本中未使用的空间。 采用复制时,数据会从主节点和副本上一并删除。采用纠删码(8+4)时,数据会从全部 12 个节点上删除。
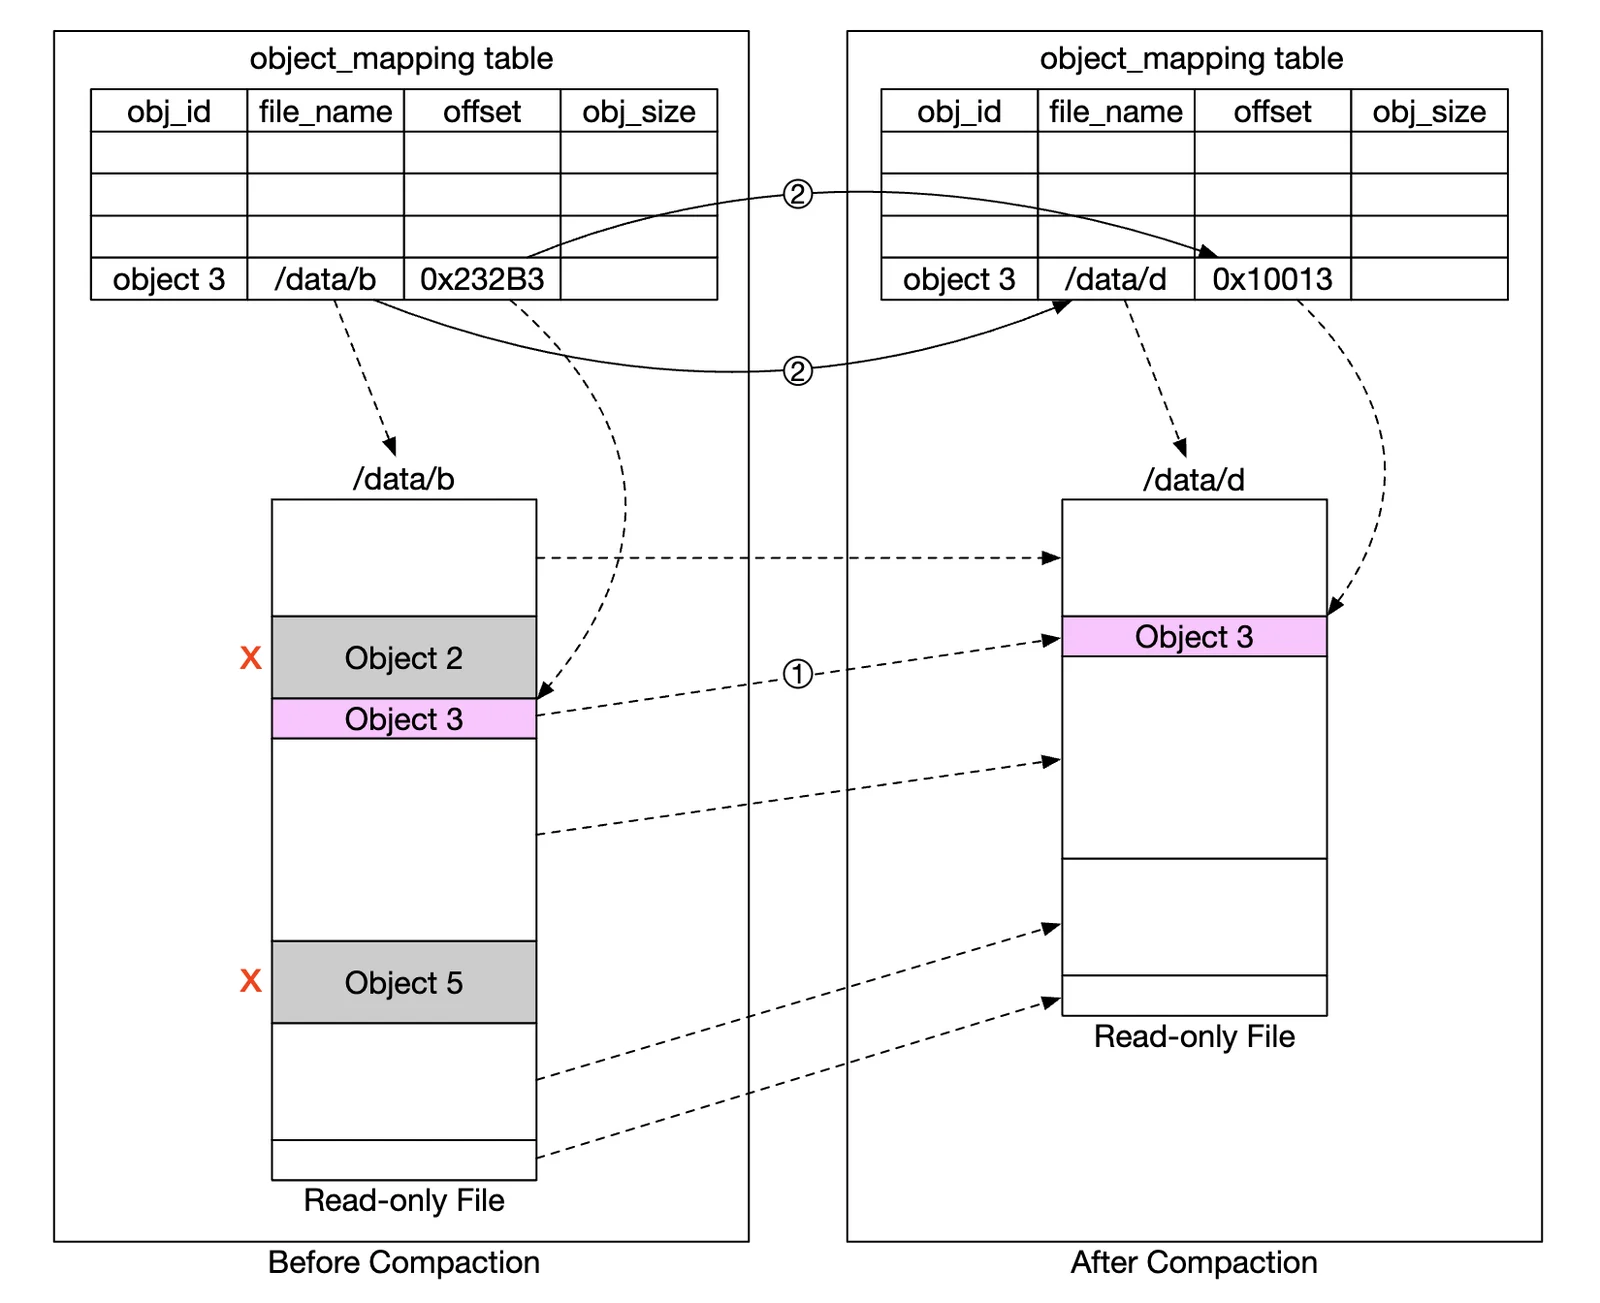
为了便于删除,我们将使用一个称为压缩(Compaction)的过程:
- 垃圾回收器把未被删除的对象从「data/b」复制到「data/d」
- 复制完成后,通过一个数据库事务更新
object_mapping表 - 为了避免产生太多小文件,只对增长超过一定阈值的文件进行压缩
第 4 步:总结
我们讨论了以下内容:
- 设计一个类 S3 的对象存储
- 比较对象存储、块存储和文件存储之间的差异
- 介绍了存储桶中对象的上传、下载、列出和版本控制
- 深入探讨了设计细节:数据存储与元数据存储、复制与纠删码、分段上传、分片