第 27 章 数字钱包
引言
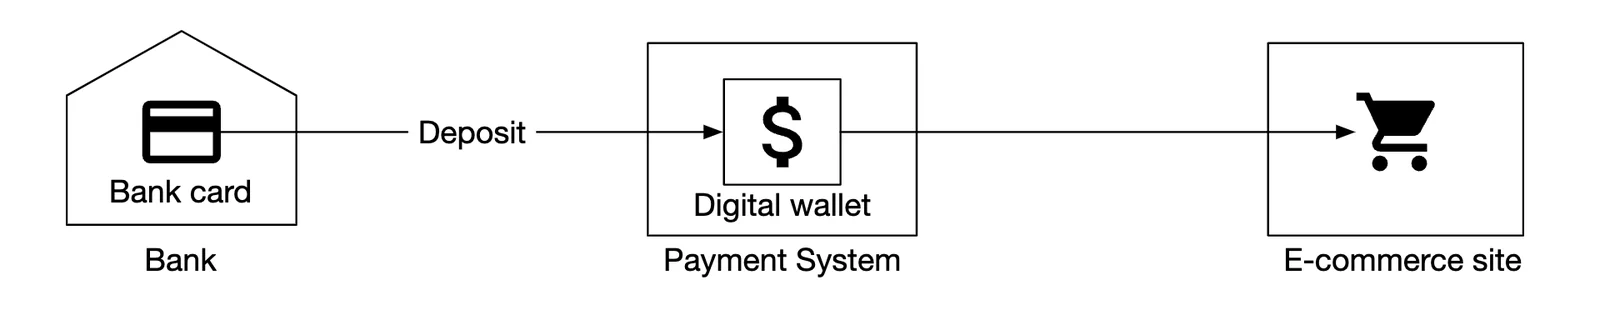
支付平台通常会提供钱包服务(Wallet Service),允许客户在应用内存放资金,之后可以随时提取。
你还可以用它购买商品和服务,或向同样使用该数字钱包(Digital Wallet)服务的其他用户转账。这比走常规支付通道更快、更便宜。
第 1 步:理解问题并确定设计范围
- 候选人:我们只关注数字钱包之间的转账吗?还需要支持其他操作吗?
- 面试官:目前先关注数字钱包之间的转账。
- 候选人:系统需要支持每秒多少笔交易?
- 面试官:假设是 100 万 TPS。
- 候选人:数字钱包对正确性有严格要求。我们可以认为事务保证就足够了吗?
- 面试官:可以。
- 候选人:我们需要证明正确性吗?
- 面试官:可以通过对账(Reconciliation)来做,但对账只能发现差异,无法告诉我们差异的根本原因。我们希望能够从头重放数据,以重建历史。
- 候选人:可以假设可用性要求是 99.99% 吗?
- 面试官:可以。
- 候选人:需要考虑外汇兑换吗?
- 面试官:不需要,这不在范围内。
总结一下,我们需要支持:
- 支持两个账户之间的余额转账
- 支持 100 万 TPS
- 可靠性达到 99.99%
- 支持事务
- 支持可复现性(Reproducibility)
粗略估算
在云上部署的传统关系型数据库大约可以支持 1000 TPS。
要达到 100 万 TPS,我们需要 1000 个数据库节点。但如果每笔转账涉及两条分录(一出一入),那么实际上需要支持 200 万 TPS。
我们的设计目标之一是提高单个节点能处理的 TPS,从而减少数据库节点的数量。
| 单节点 TPS | 节点数量 |
|---|---|
| 100 | 20,000 |
| 1,000 | 2,000 |
| 10,000 | 200 |
第 2 步:提出高层设计并获得认可
API 设计
在本次面试中,我们只需要支持一个接口:
POST /v1/wallet/balance_transfer - 将余额从一个钱包转到另一个钱包
请求参数:from_account、to_account、amount(用字符串表示,以免丢失精度)、currency、transaction_id(幂等键)。
响应示例:
{
    "status": "success"
    "transaction_id": "01589980-2664-11ec-9621-0242ac130002"
}
基于内存的分片方案
我们的钱包应用为每个用户账户维护账户余额。
表示它的一个好的数据结构是 map<user_id, balance>,可以用内存型的 Redis 存储来实现。
由于单个 Redis 节点无法承受 100 万 TPS,我们需要把 Redis 集群划分到多个节点上。
分区算法示例:
String accountID = "A";
Int partitionNumber = 7;
Int myPartition = accountID.hashCode() % partitionNumber;
可以用 Zookeeper 存储分区数量和 Redis 节点的地址,因为它是一个高可用的配置存储。
最后,钱包服务是一个无状态服务,负责执行转账操作。它可以轻松地水平扩展:
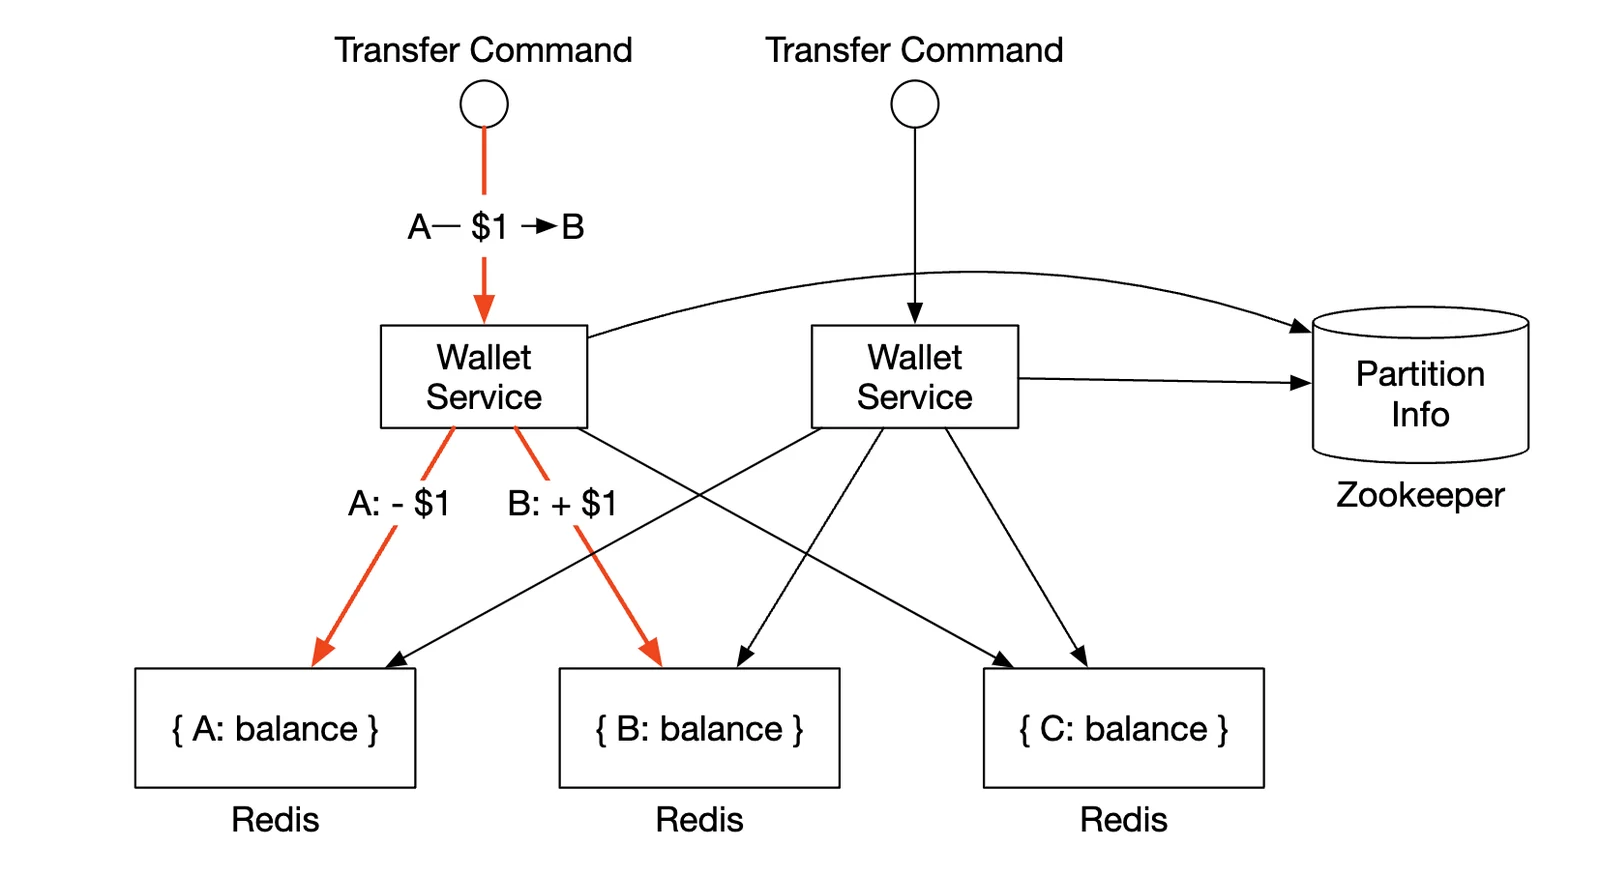
虽然这个方案解决了可扩展性问题,但它无法让我们以原子方式执行余额转账。
分布式事务
处理事务的一种方法,是在标准的、已分片的关系型数据库之上使用两阶段提交(Two-Phase Commit)协议:
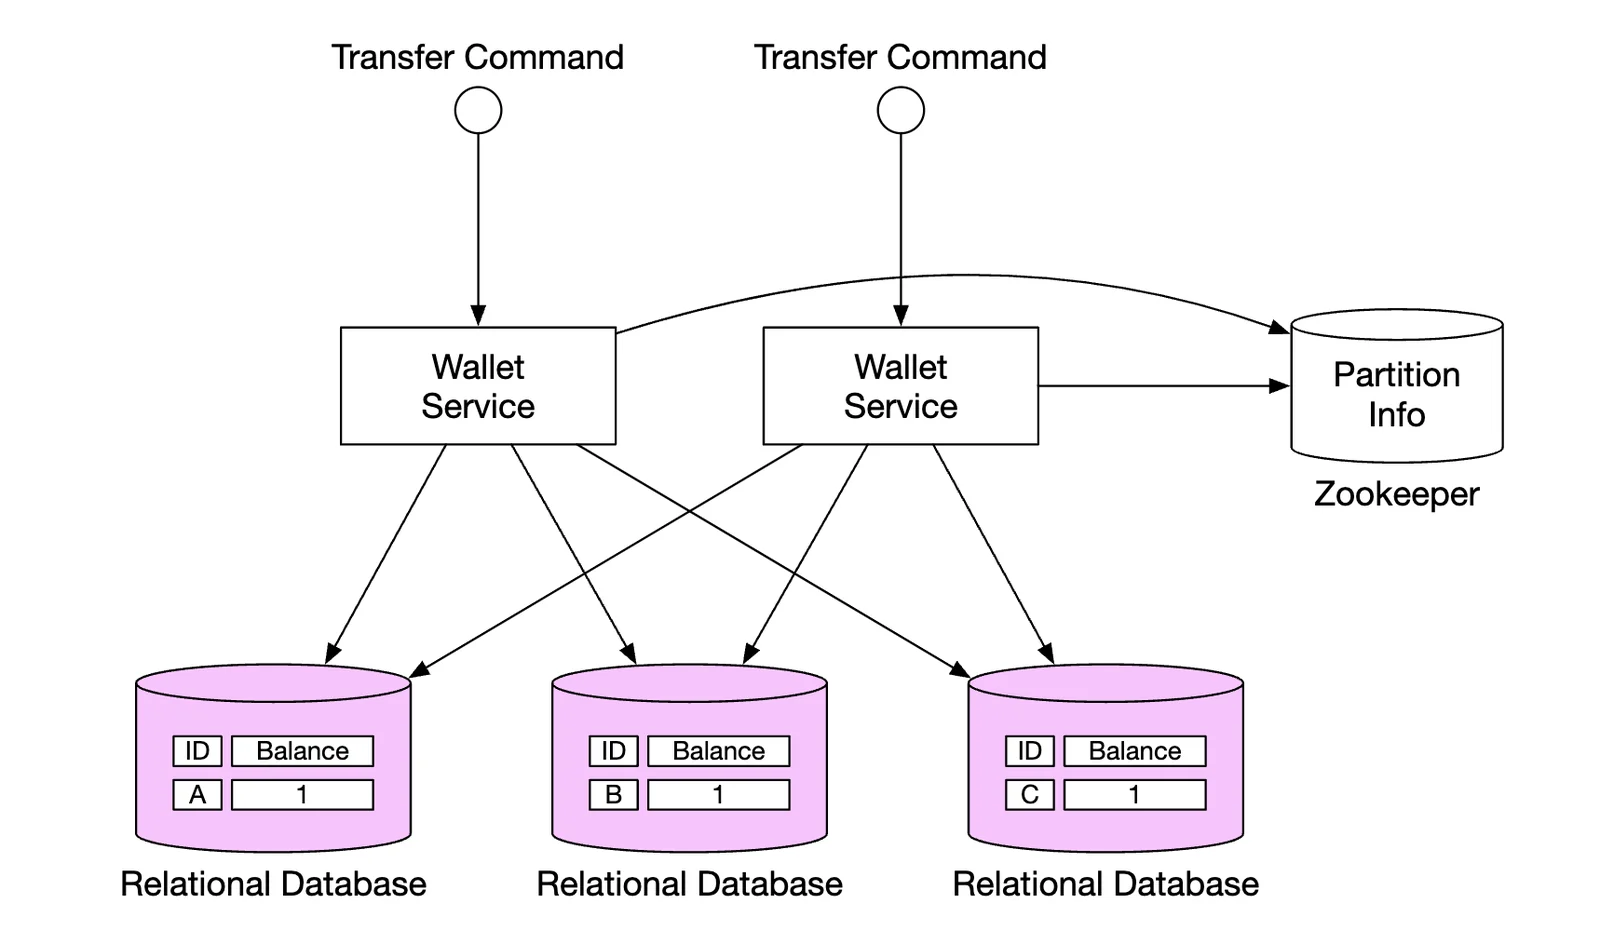
两阶段提交(2PC)协议的工作方式如下:
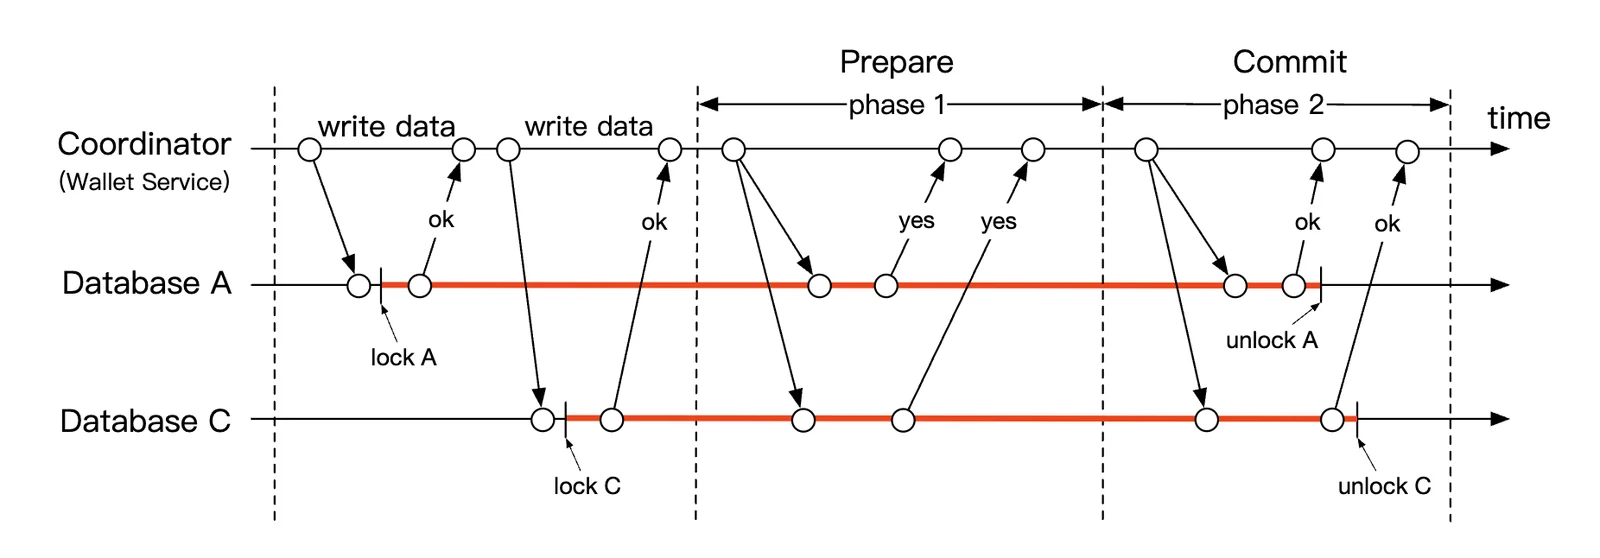
- 协调者(钱包服务)像平常一样在多个数据库上执行读写操作
- 当应用准备提交事务时,协调者请求所有数据库对事务进行准备(prepare)
- 如果所有数据库都回复“yes”,协调者就请求这些数据库提交事务
- 否则,请求所有数据库中止事务
2PC 方法的缺点:
- 由于锁竞争,性能不佳
- 协调者是单点故障
使用 Try-Confirm/Cancel(TC/C)实现分布式事务
TC/C 是 2PC 协议的一种变体,它借助补偿事务(Compensating Transaction)来工作:
- 协调者请求所有数据库为事务预留资源
- 协调者收集各数据库的回复:如果都是 yes,就请求数据库执行 try-confirm;如果有 no,就请求数据库执行 try-cancel。
TC/C 与 2PC 的一个重要区别是:2PC 执行的是单个事务,而 TC/C 中是两个相互独立的事务。
TC/C 按阶段的执行方式如下:
| 阶段 | 操作 | A | C |
|---|---|---|---|
| 1 | Try | 余额变动:-$1 | 不做任何事 |
| 2 | Confirm | 不做任何事 | 余额变动:+$1 |
| Cancel | 余额变动:+$1 | 不做任何事 |
第 1 阶段:try
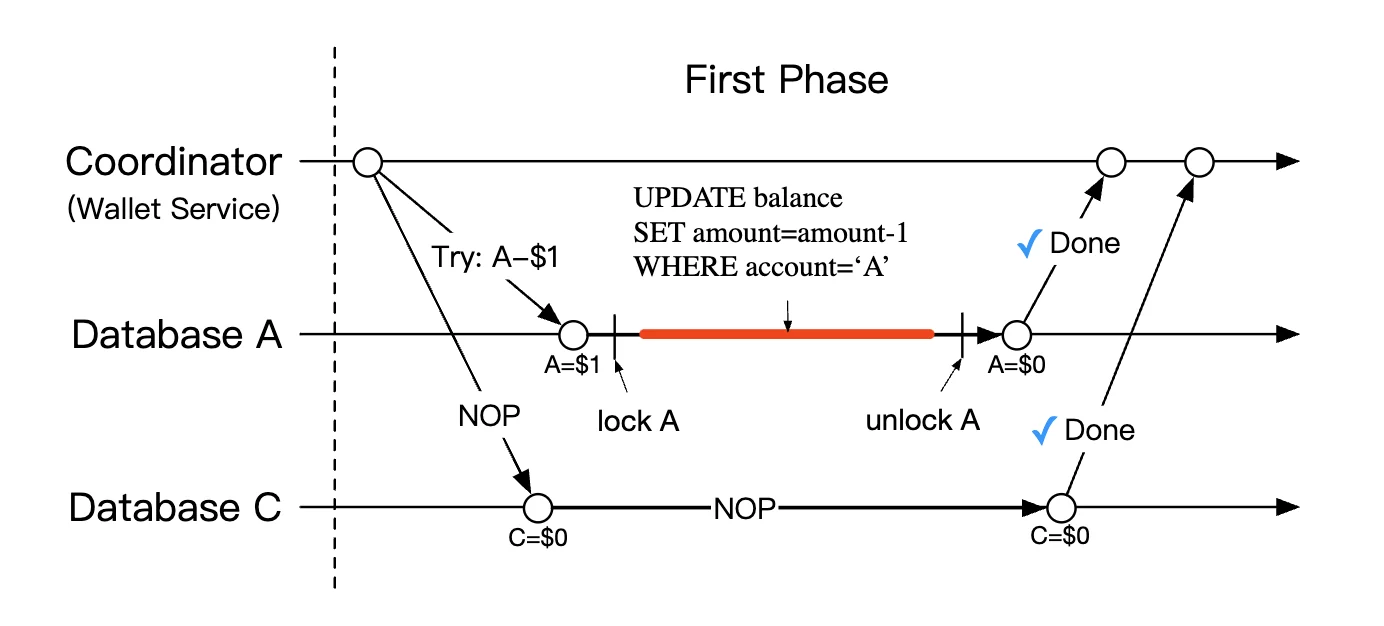
- 协调者在 A 的数据库中启动本地事务,把 A 的余额减少 1$
- C 的数据库收到一条 NOP 指令,什么也不做
第 2a 阶段:confirm
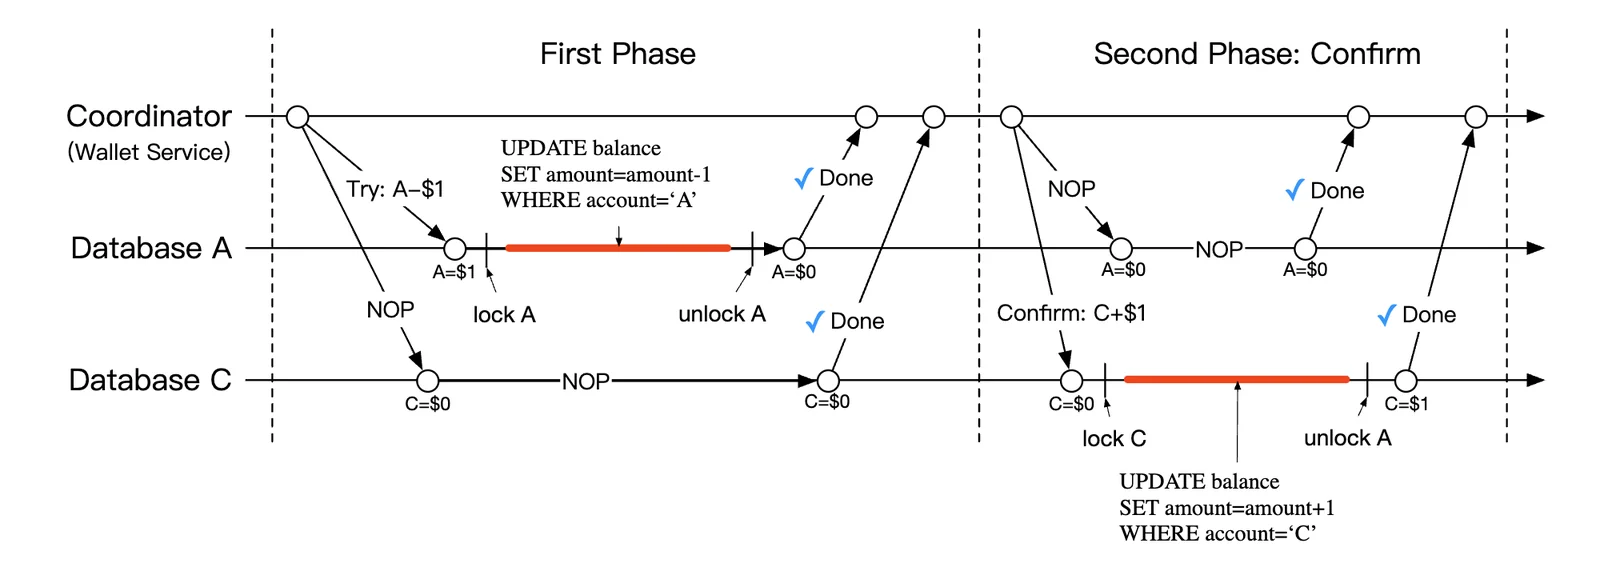
- 如果两个数据库都回复“yes”,就开始 confirm 阶段。
- A 的数据库收到 NOP,而 C 的数据库被指示把 C 的余额增加 1$(本地事务)
第 2b 阶段:cancel
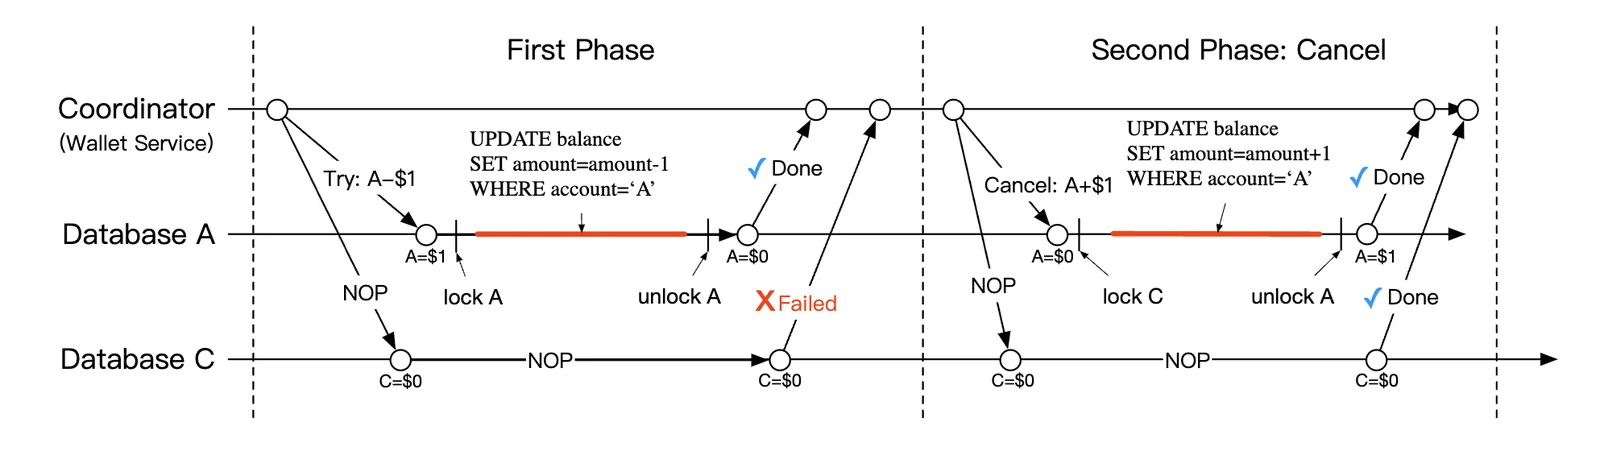
- 如果第 1 阶段中的任何操作失败,就开始 cancel 阶段。
- A 的数据库被指示把 A 的余额增加 1$,C 的数据库收到 NOP
2PC 与 TC/C 的对比如下:
| 第一阶段 | 第二阶段:成功 | 第二阶段:失败 | |
|---|---|---|---|
| 2PC | 事务尚未完成 | 提交/取消所有事务 | 取消所有事务 |
| TC/C | 所有事务都已完成(已提交或已取消) | 如有需要,执行新的事务 | 撤销已经提交的事务 |
TC/C 也被称为补偿式分布式事务。高层操作在业务逻辑中处理。
TC/C 的其他特性:
- 与数据库无关,只要数据库支持事务即可
- 分布式事务的细节和复杂性需要在业务逻辑中处理
TC/C 的故障模式
如果协调者在执行过程中宕机,它需要恢复自己的中间状态。 这可以通过维护阶段状态表(Phase Status Table)来实现,这些表在数据库分片内被原子地更新:
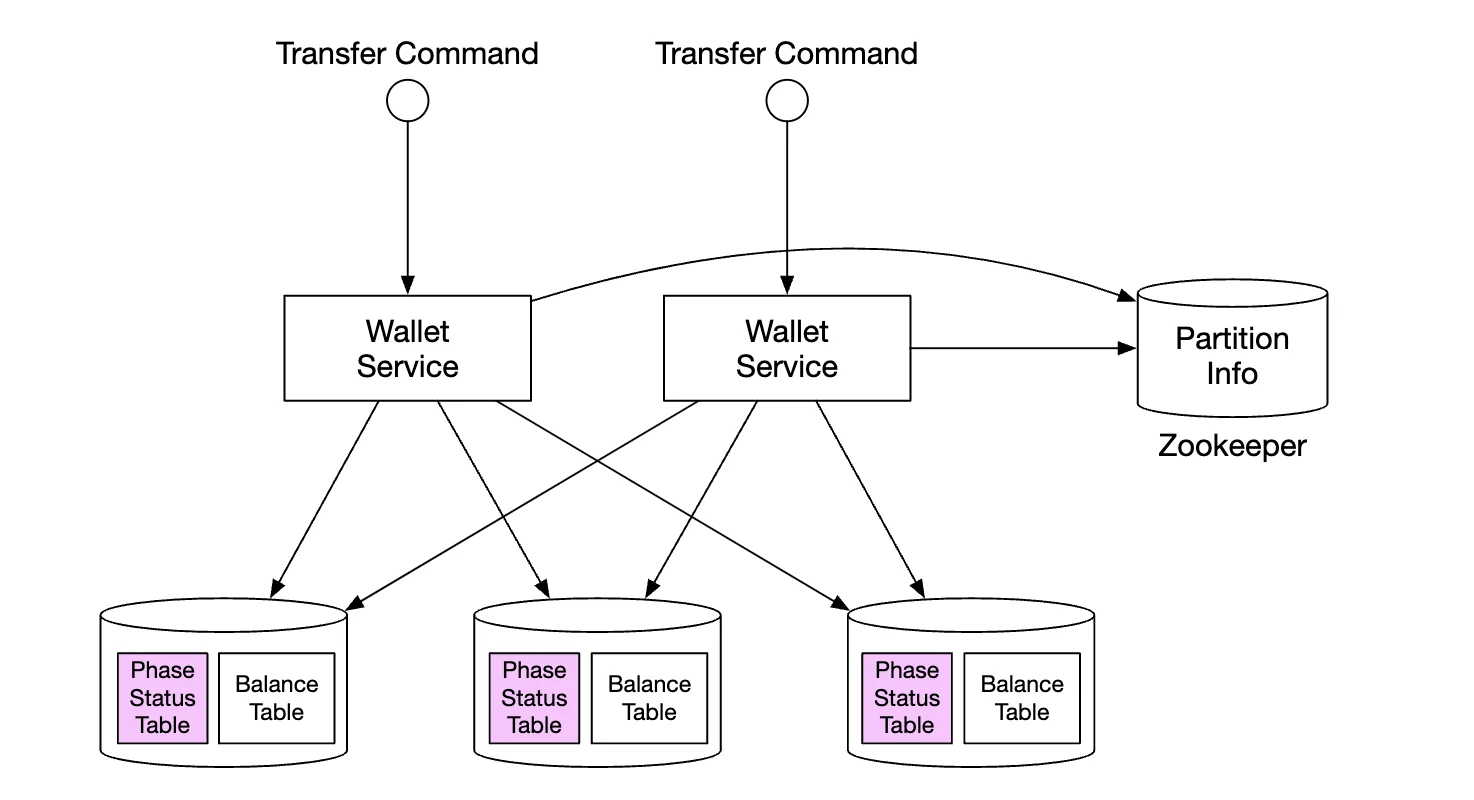
这张表包含哪些内容:
- 分布式事务的 ID 和内容
- try 阶段的状态:未发送、已发送、已收到响应
- 第二阶段的名称:confirm 或 cancel
- 第二阶段的状态
- 乱序标志(稍后解释)
使用 TC/C 的一个注意事项是:当分布式事务正在执行时,会有一个短暂的时刻,各账户的状态彼此不一致:
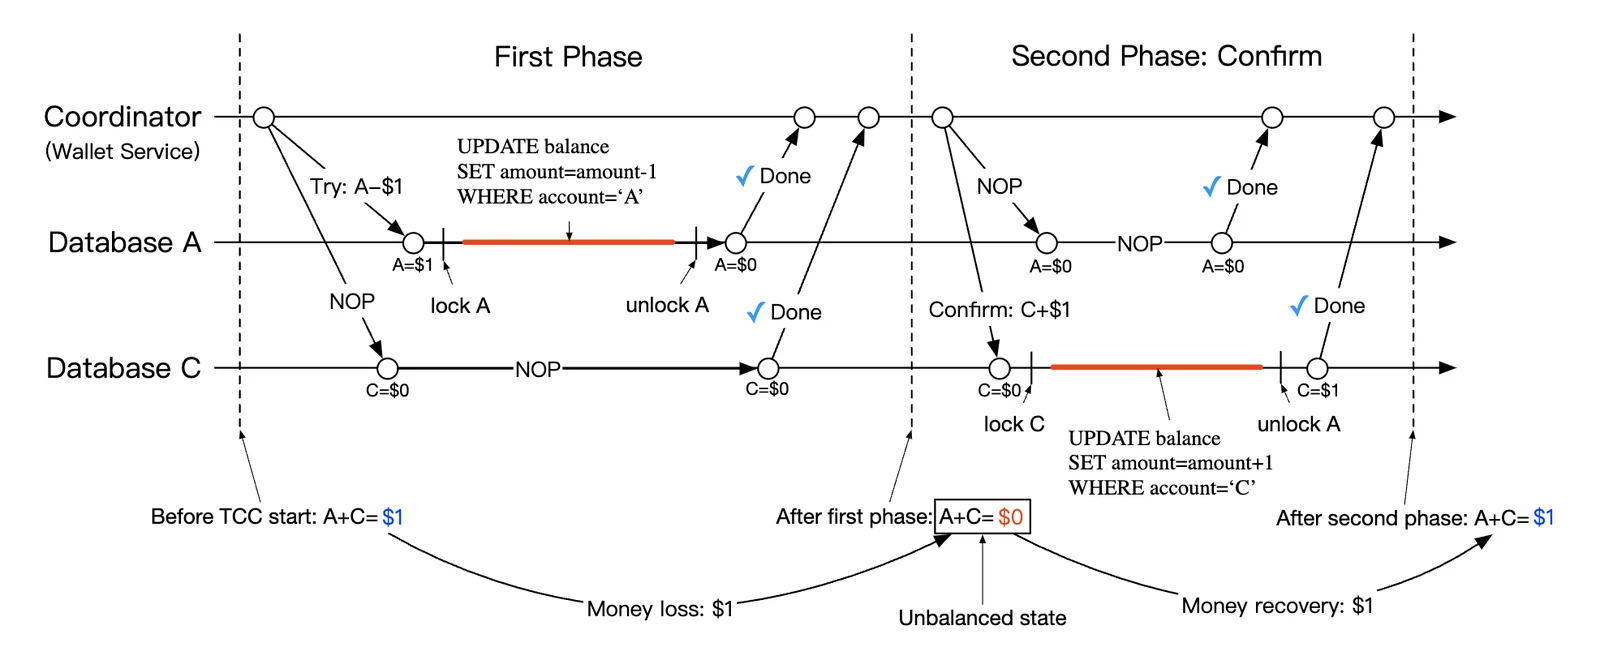
只要我们总能从这种状态中恢复,并且用户无法利用这个中间状态(例如把钱花掉),这就没有问题。 通过始终先执行扣减、后执行增加,就能保证这一点。
| Try 阶段的选择 | 账户 A | 账户 C |
|---|---|---|
| 选择 1 | -$1 | NOP |
| 选择 2(无效) | NOP | +$1 |
| 选择 3(无效) | -$1 | +$1 |
注意,上表中的选择 3 是无效的,因为不依赖 2PC,我们就无法保证跨不同数据库的事务以原子方式执行。
需要处理的一个边界情况是乱序执行:
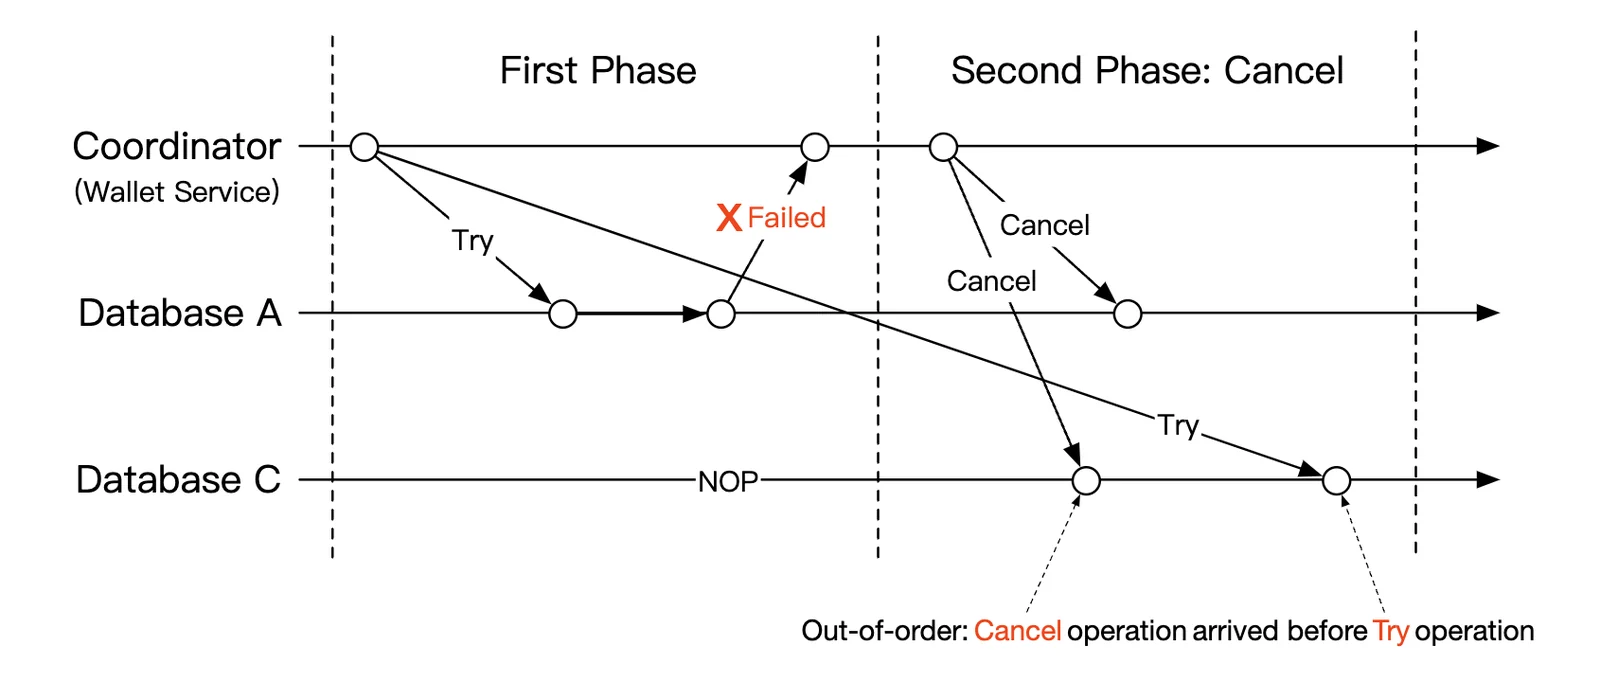
数据库有可能在收到 try 之前先收到 cancel 操作。这种边界情况可以通过在阶段状态表中添加乱序标志来处理。 当我们收到 try 操作时,先检查乱序标志是否已设置,如果已设置,就返回失败。
使用 Saga 实现分布式事务
另一种流行的方法是使用 Saga,它是在微服务架构中实现分布式事务的一种标准做法。
它的工作方式如下:
- 所有操作按顺序排列。每个操作在各自的数据库中都是独立的。
- 操作从第一个到最后一个依次执行
- 当某个操作失败时,整个流程开始回滚,通过补偿操作一直回退到起点
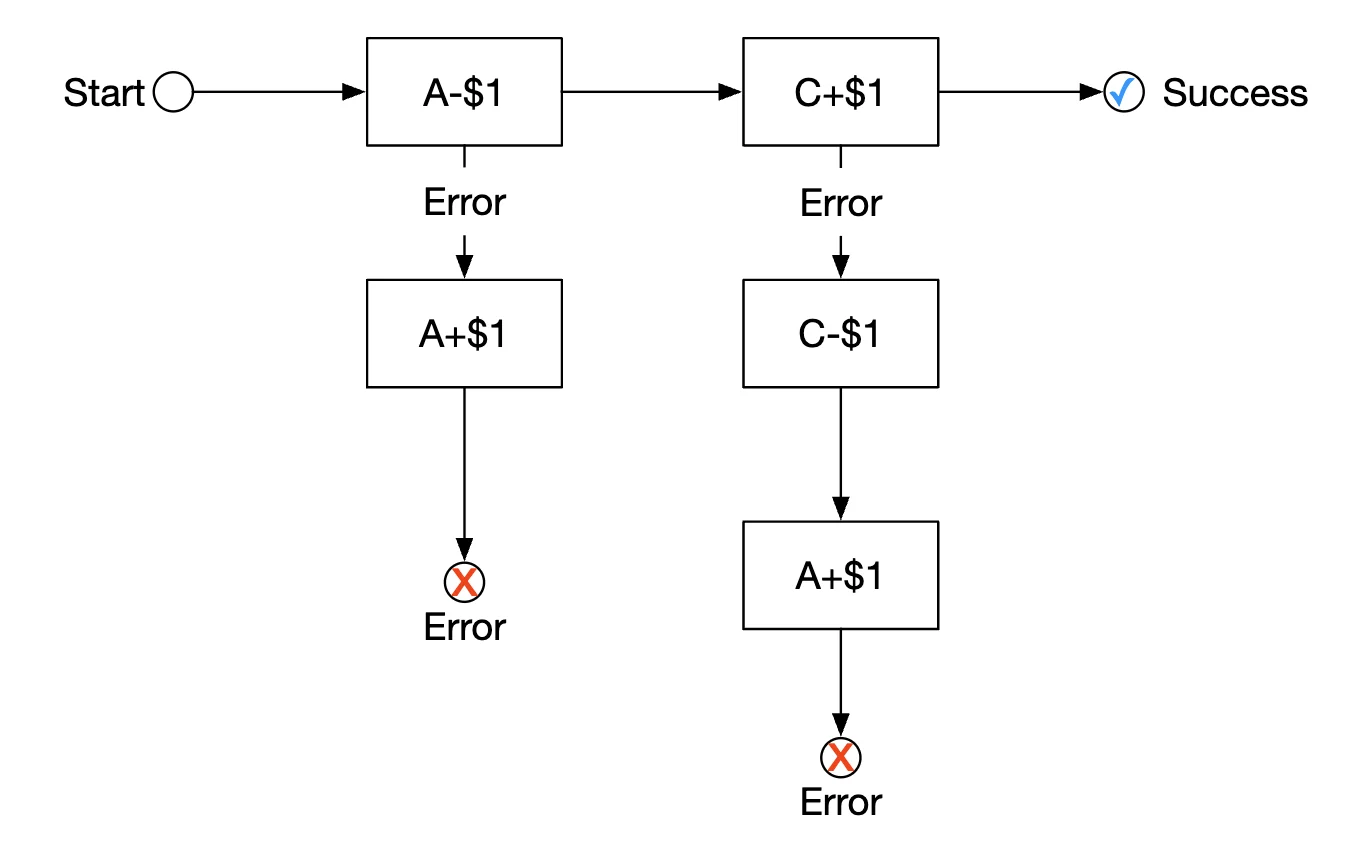
我们如何协调这个工作流?有两种方法可选:
- 协同(Choreography):参与 saga 的所有服务都订阅相关事件,各自完成 saga 中属于自己的那部分
- 编排(Orchestration):由单个协调者指示所有服务按正确的顺序完成各自的工作
使用协同方式的难点在于,业务逻辑被拆分到多个以异步方式通信的服务中。 编排方式能很好地处理复杂性,因此在数字钱包系统中通常是首选方法。
TC/C 与 Saga 的对比如下:
| TC/C | Saga | |
|---|---|---|
| 补偿动作 | 在 Cancel 阶段 | 在回滚阶段 |
| 中心化协调 | 是 | 是(编排模式) |
| 操作执行顺序 | 任意 | 线性 |
| 能否并行执行 | 能 | 不能(线性执行) |
| 是否可能看到部分不一致的状态 | 是 | 是 |
| 应用逻辑还是数据库逻辑 | 应用 | 应用 |
主要区别在于 TC/C 可以并行执行,因此我们的决策取决于延迟要求:如果需要实现低延迟,就应该选择 TC/C 方法。
无论采用哪种方法,我们仍然需要支持审计和重放历史,以便从失败状态中恢复。
事件溯源
在现实中,数字钱包应用可能会接受审计,我们必须回答某些问题:
- 我们是否知道任意时刻的账户余额?
- 我们如何知道历史余额和当前余额是正确的?
- 在代码变更之后,我们如何证明系统逻辑是正确的?
事件溯源(Event Sourcing)是一种能帮助我们回答这些问题的技术。
它由四个概念组成:
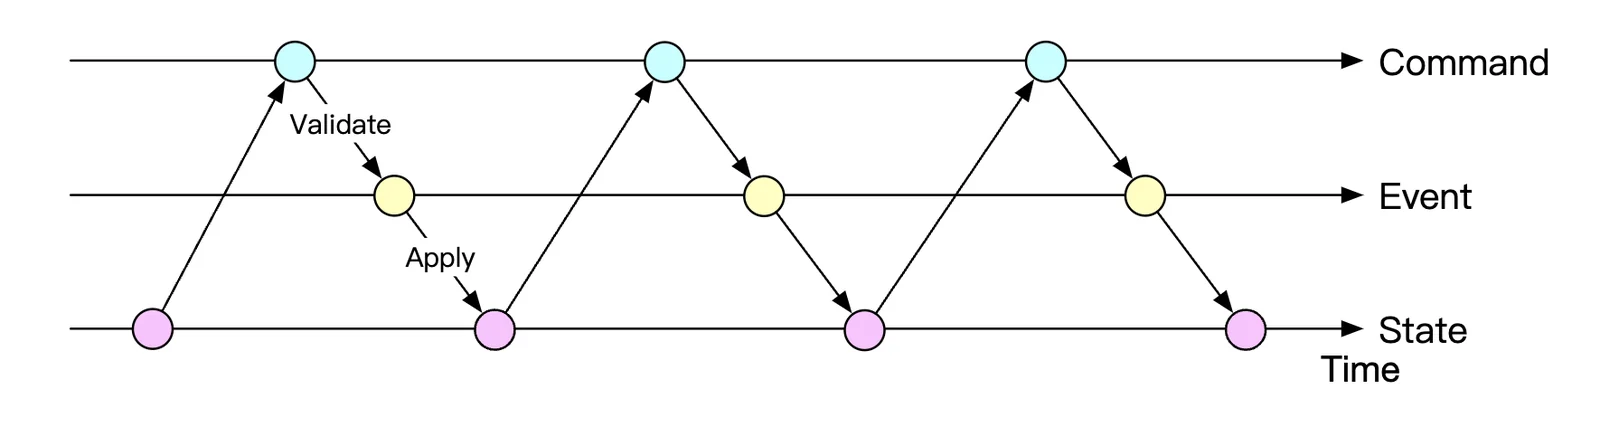
- 命令(Command):来自现实世界的预期动作,例如从账户 A 向 B 转账 1$。命令需要有全局顺序,因此它们被放入一个 FIFO 队列。
- 与事件不同,命令可能失败,并且由于 IO 或无效状态等原因带有一定的随机性。
- 命令可以产生零个或多个事件
- 事件生成可能包含外部 IO 之类的随机性。稍后会再讨论这一点
- 事件(Event):系统中已发生事件的历史事实,例如“从 A 向 B 转账了 1$”。
- 与命令不同,事件是在我们系统中已经发生的事实
- 与命令类似,事件也需要有序,因此它们被放入一个 FIFO 队列
- 状态(State):事件导致的变化。例如一个记录账户与其余额对应关系的键值存储。
- 状态机(State Machine):驱动事件溯源过程。它主要负责校验命令,并应用事件来更新系统状态。
- 状态机应当是确定性的,因此它不应读取外部 IO,也不应依赖随机性。
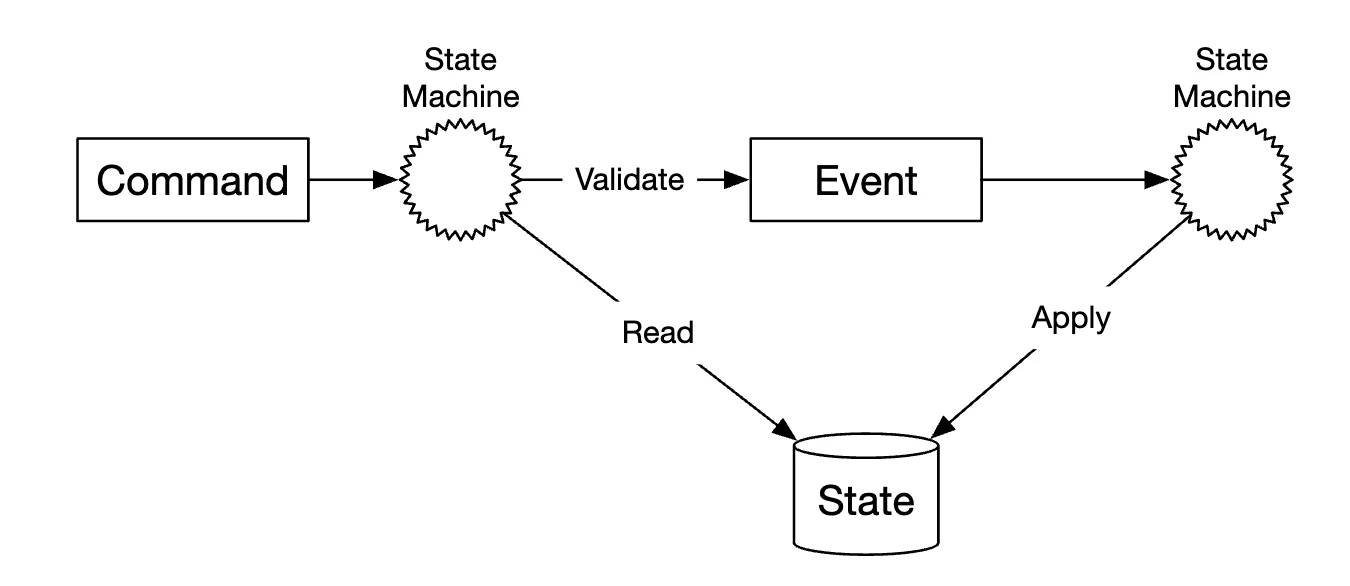
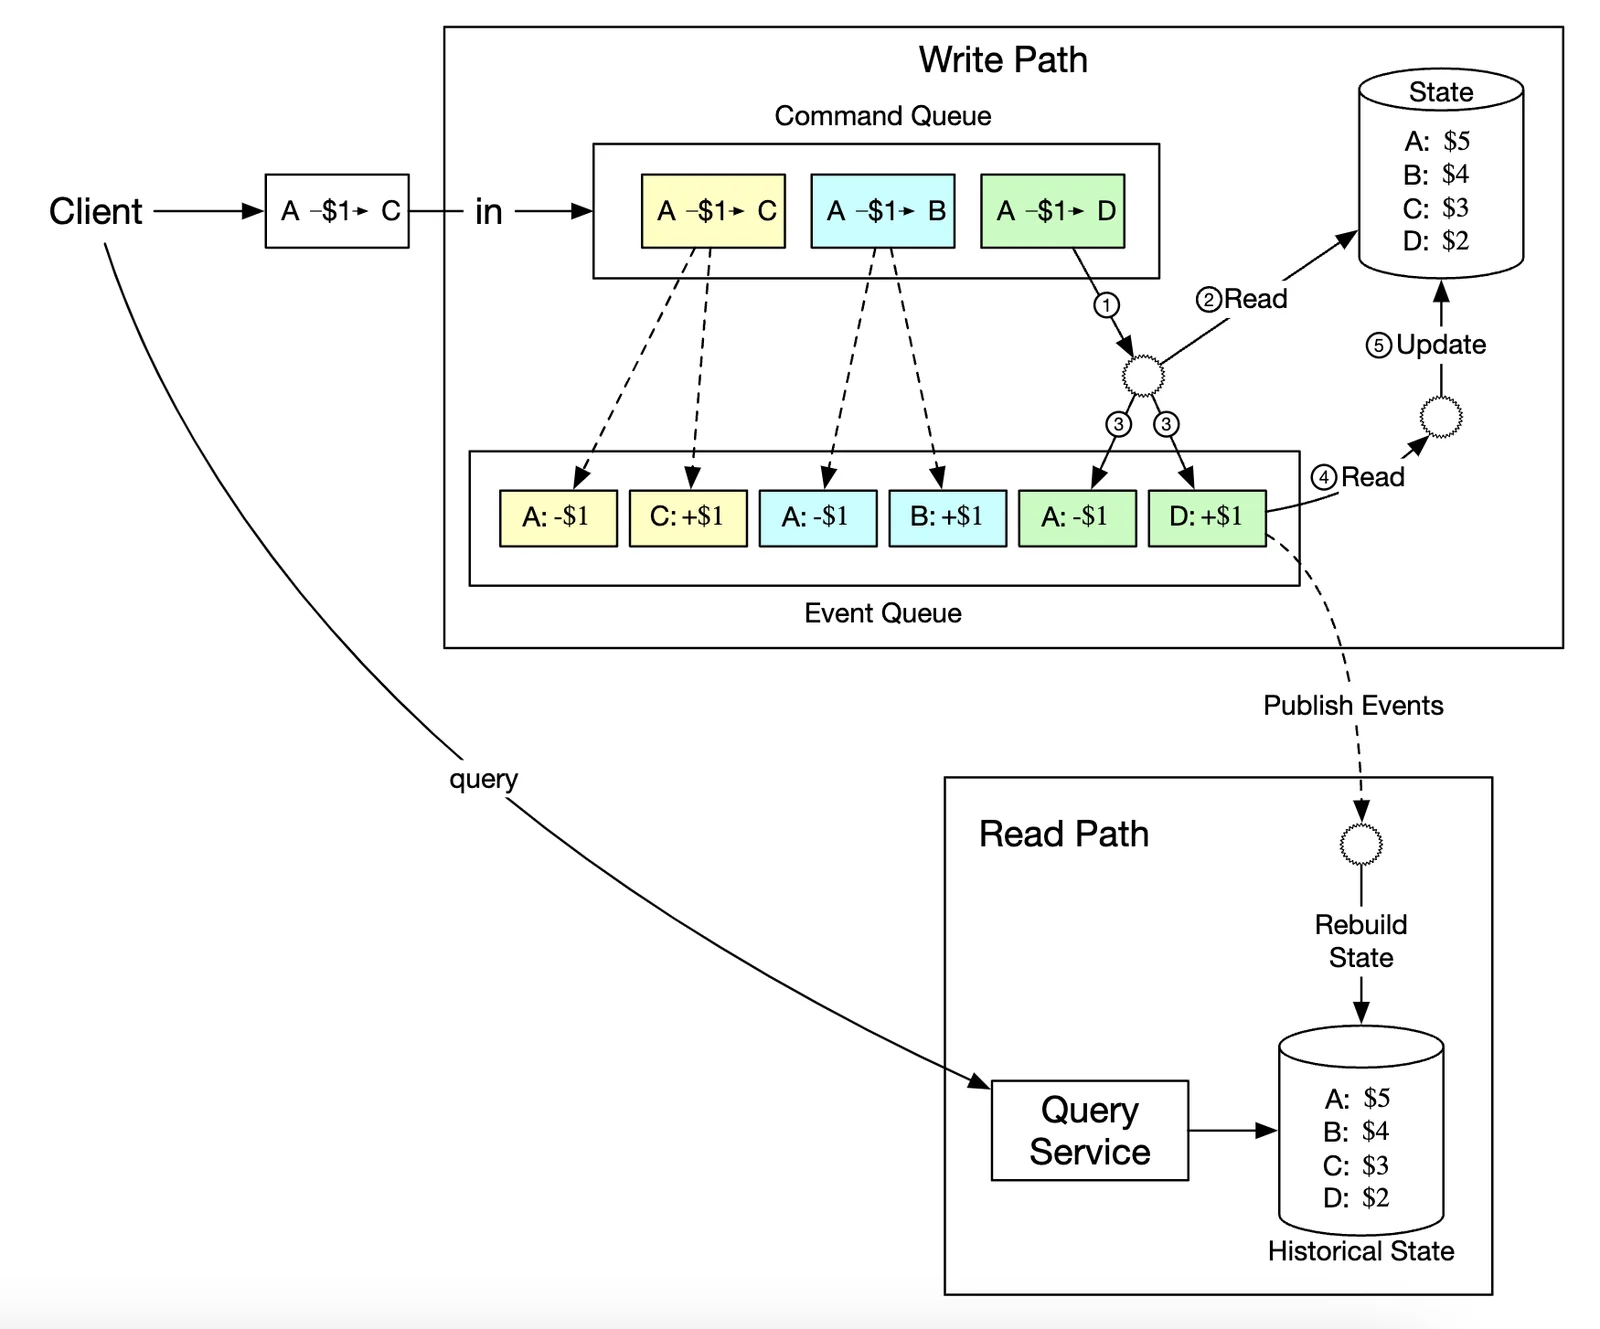
下面是事件溯源的动态视图:
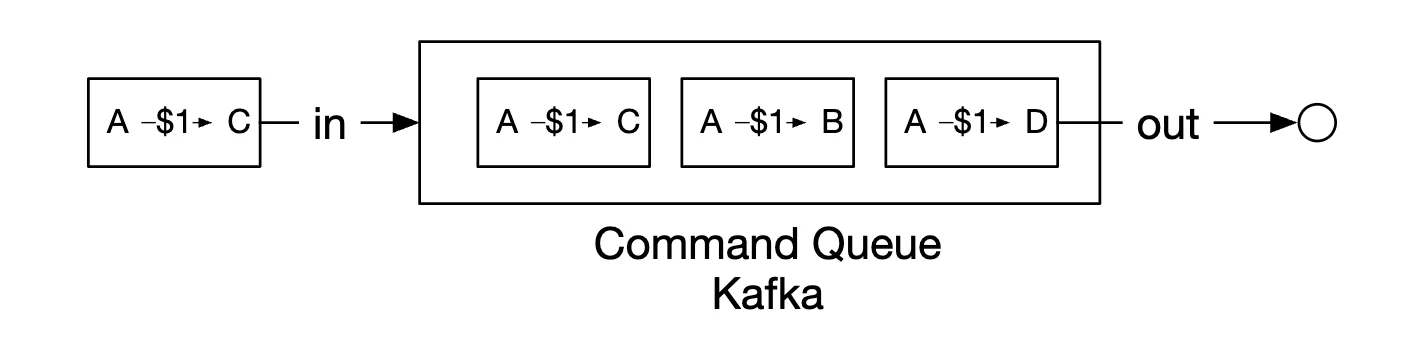
对于我们的钱包服务,命令就是余额转账请求。我们可以把它们放入一个 FIFO 队列,例如 Kafka:
完整的架构如下:
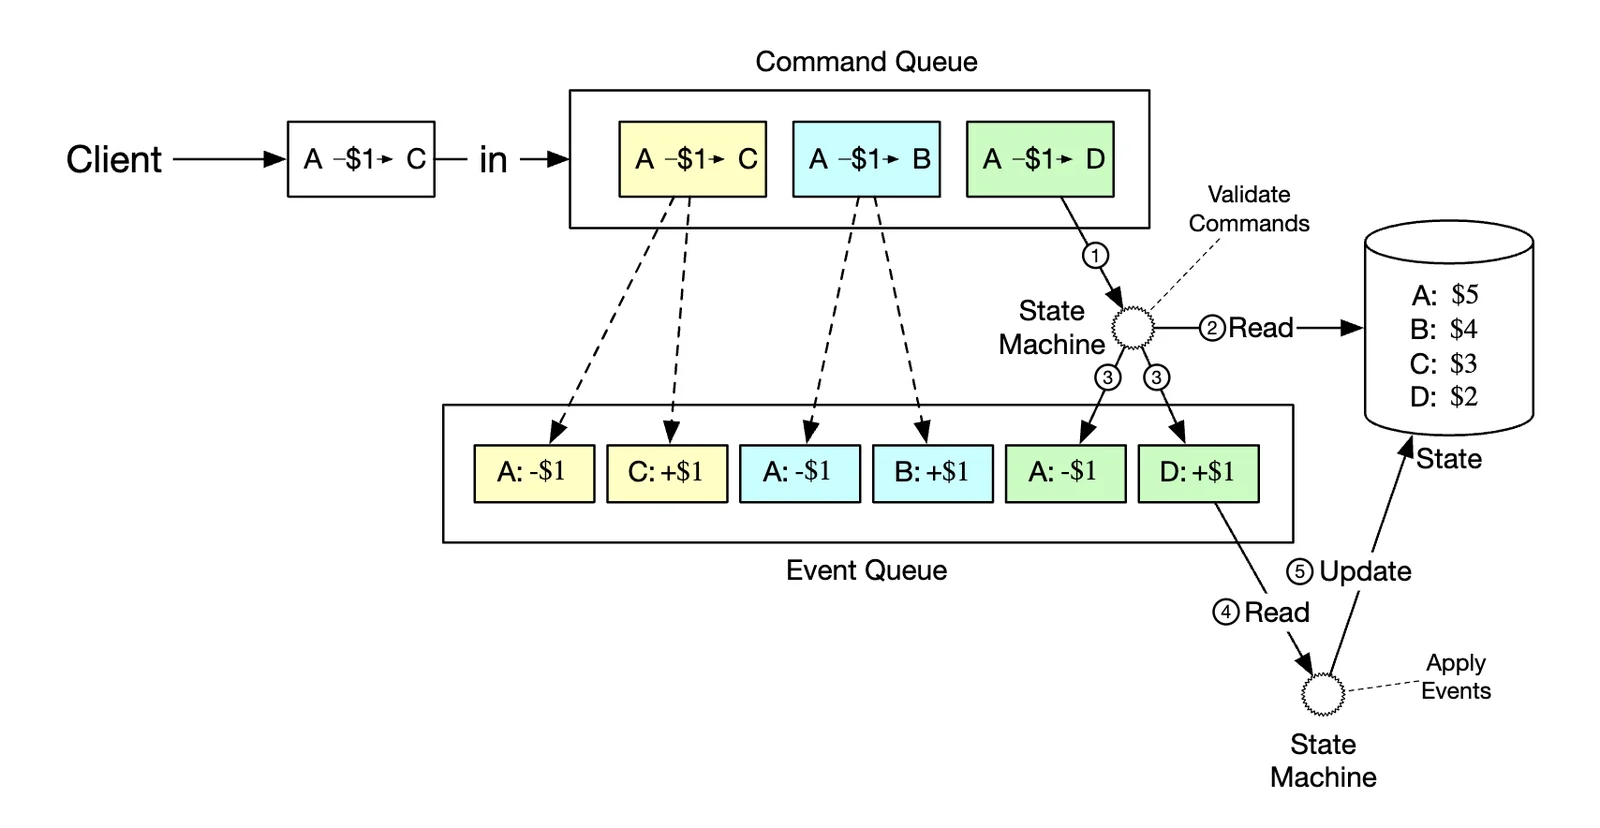
- 状态机从命令队列中读取命令
- 从数据库中读取余额状态
- 校验命令。如果有效,就为两个账户各生成一个事件
- 读取下一个事件,并通过更新数据库中的余额(状态)来应用它
使用事件溯源的主要优势是它的可复现性。在这个设计中,所有状态更新操作都被保存为所有余额变动的不可变历史。
通过从头重放事件,总能重建历史余额。 由于事件列表是不可变的,且状态机是确定性的,我们可以保证成功重放出任何一个中间状态。
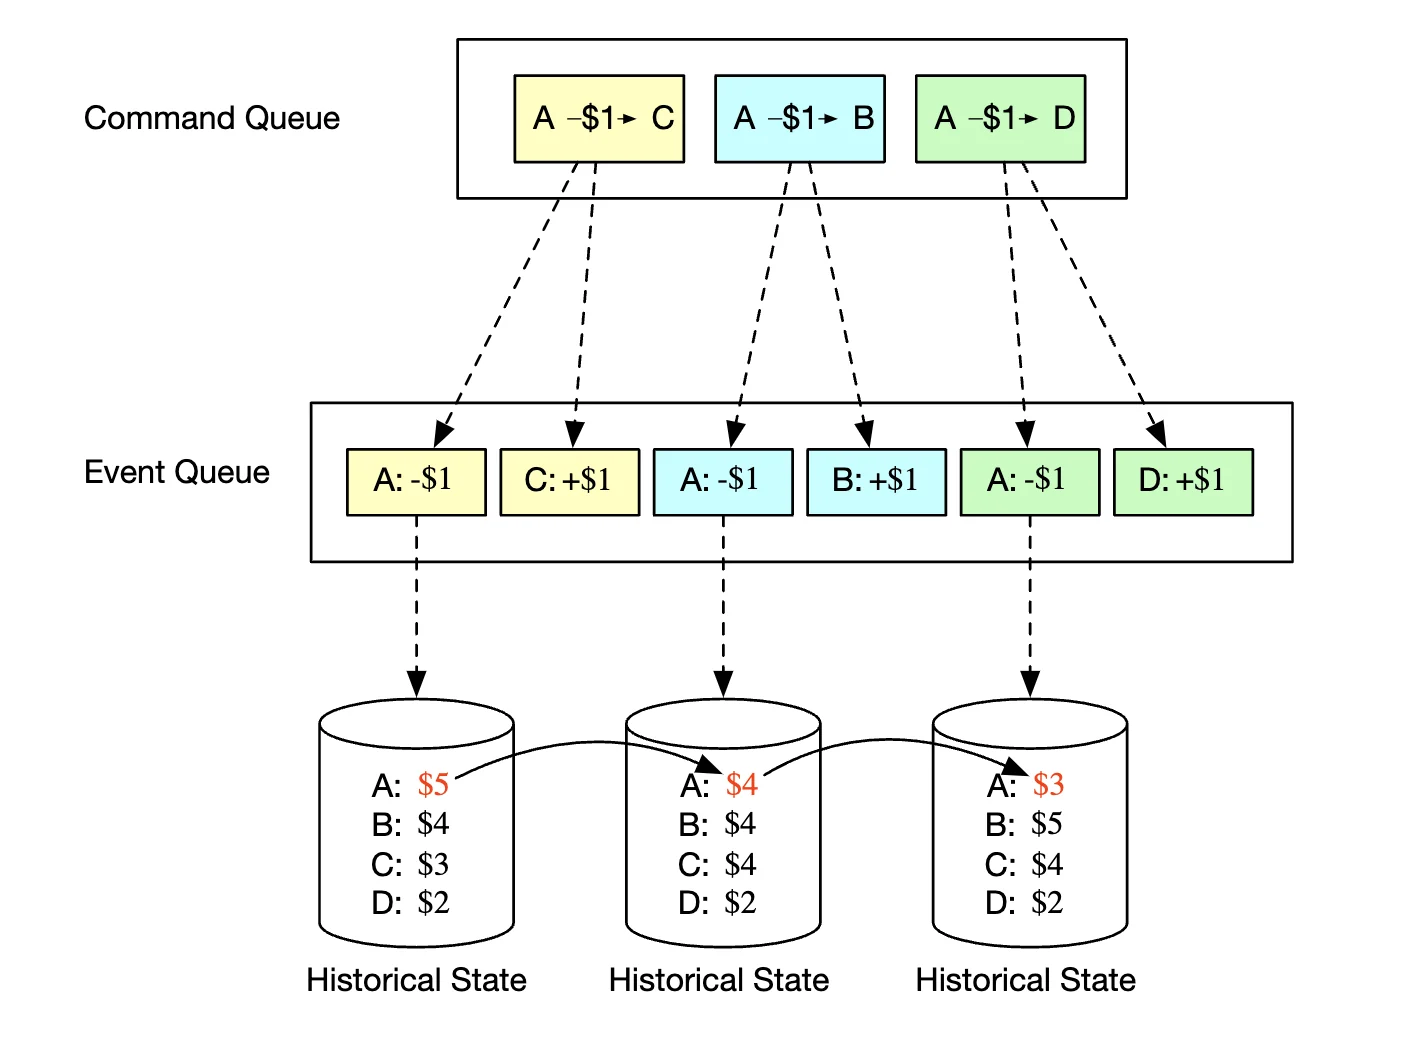
本节开头提出的所有审计相关问题,都可以借助事件溯源来解答:
- 我们是否知道任意时刻的账户余额?可以从头开始重放事件,直到我们关心的那个时间点
- 我们如何知道历史余额和当前余额是正确的?可以通过从头重新计算所有事件来验证正确性
- 在代码变更之后,我们如何证明系统逻辑是正确的?可以让不同版本的代码处理同一批事件,验证它们的结果是否完全一致
客户查询自己余额的请求可以用 CQRS 架构来处理:可以有多个只读状态机,它们基于不可变的事件列表,负责查询历史状态:
第 3 步:深入设计
在本节中,我们将探讨一些性能优化,因为我们仍然需要扩展到 100 万 TPS。
高性能事件溯源
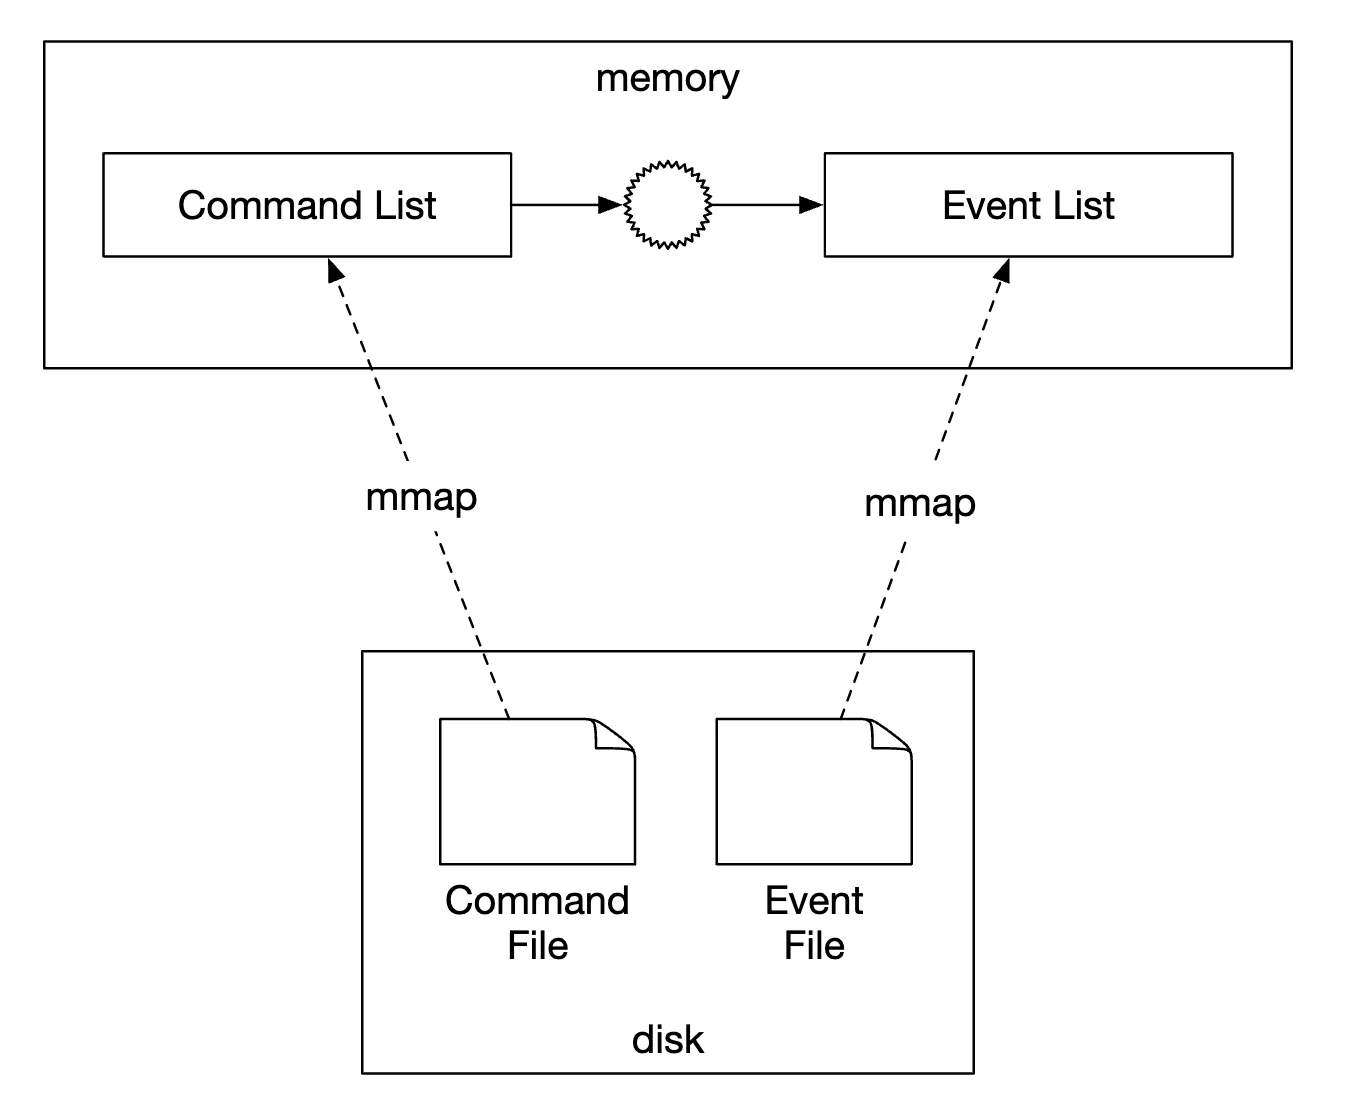
我们要探讨的第一个优化,是把命令和事件保存到本地磁盘存储中,而不是 Kafka 这样的外部存储。
这避免了网络延迟;而且由于我们只做追加操作,这类操作在 HDD 上通常也很快。
下一个优化是把最近的命令和事件缓存在内存中,以节省从磁盘重新加载它们的时间。
在底层,我们可以借助一个叫 mmap 的命令来实现上述优化,它既把数据存储到本地磁盘,又把数据缓存在内存中:
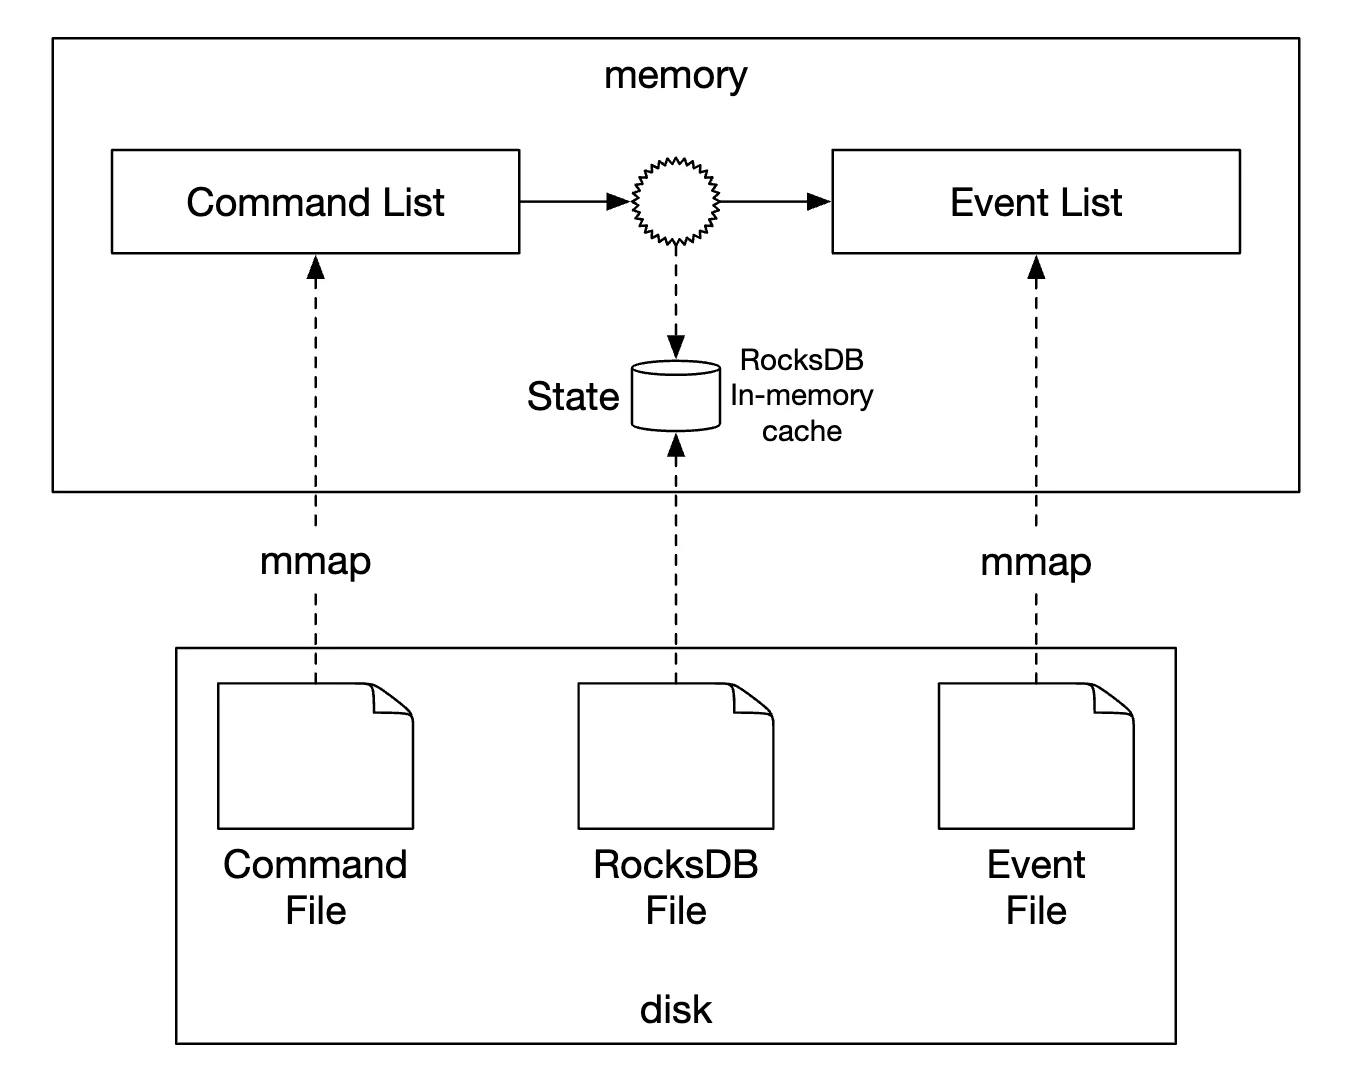
下一个可以做的优化,是用 SQLite(一种基于文件的本地关系型数据库)把状态也存储在本地文件系统中。RocksDB 也是一个不错的选择。
就我们的用途而言,我们选择 RocksDB,因为它使用日志结构合并树(Log-Structured Merge-Tree,LSM),这种结构针对写操作做了优化。 读性能则通过缓存来优化。
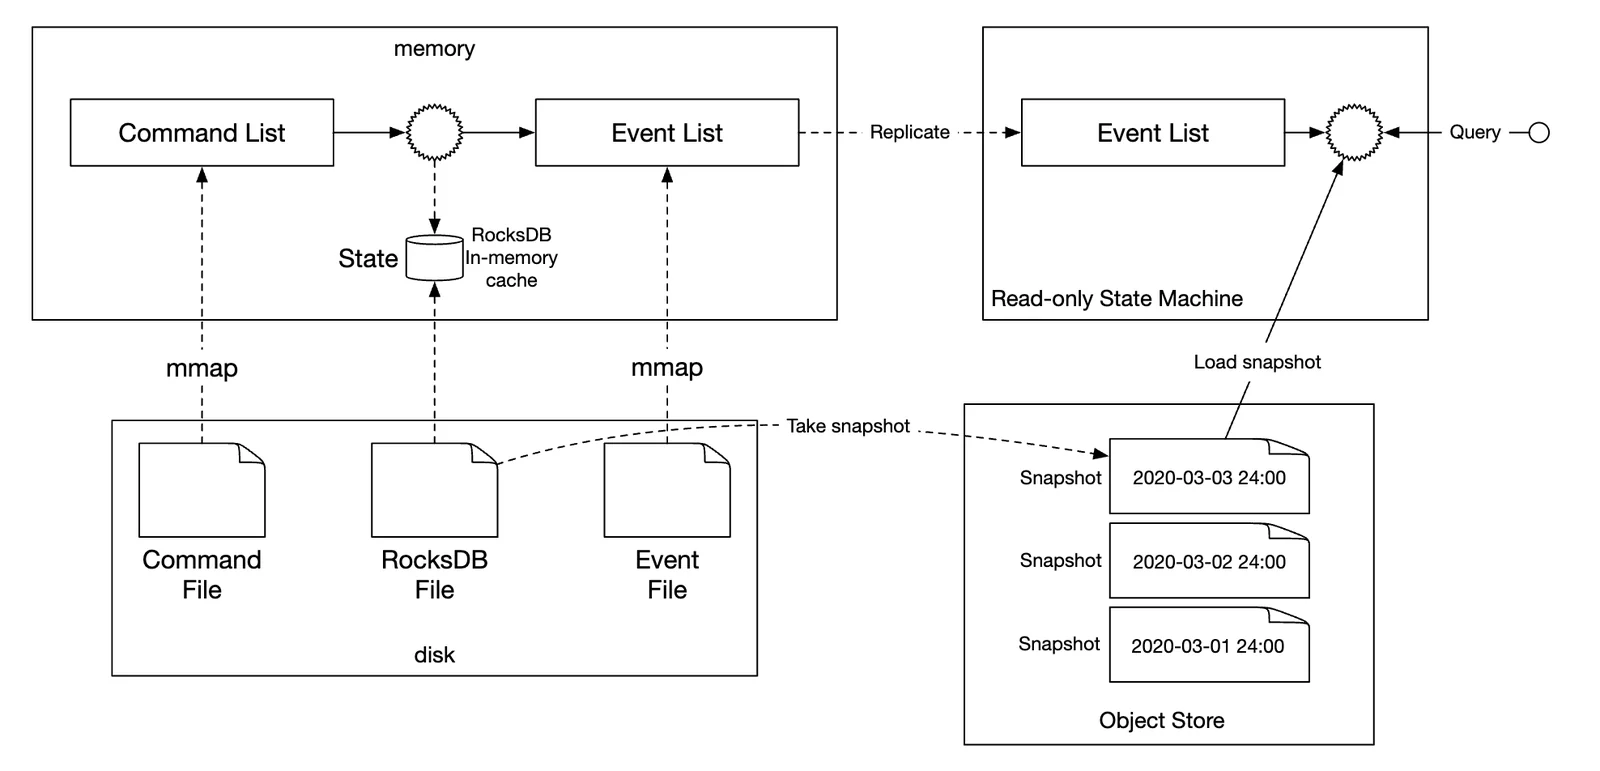
为了优化可复现性,我们可以定期把快照保存到磁盘,这样就不必每次都从头重建某个状态。我们可以把快照作为大型二进制文件存储在分布式文件存储中,例如 HDFS:
可靠的高性能事件溯源
到目前为止做的所有优化都很好,但它们让我们的服务变成了有状态的。出于可靠性考虑,我们需要引入某种形式的复制。
在此之前,我们应该分析一下系统中哪类数据需要高可靠性:
- 状态和快照总是可以通过事件列表重新生成。因此,我们只需要保证事件列表的可靠性。
- 有人可能认为事件列表总能从命令列表重新生成,但事实并非如此,因为命令是非确定性的。
- 结论是,我们只需要确保事件列表的高可靠性
为了实现事件的高可靠性,我们需要把事件列表复制到多个节点上。我们需要保证:
- 没有数据丢失
- 日志文件中数据的相对顺序在各副本之间保持一致
为此,我们可以采用一种共识算法,例如 Raft。
在 Raft 中,有一个处于活跃状态的 leader,以及若干处于被动状态的 follower。如果 leader 宕机,会由某个 follower 接替。 只要超过一半的节点正常运行,系统就能继续运行。
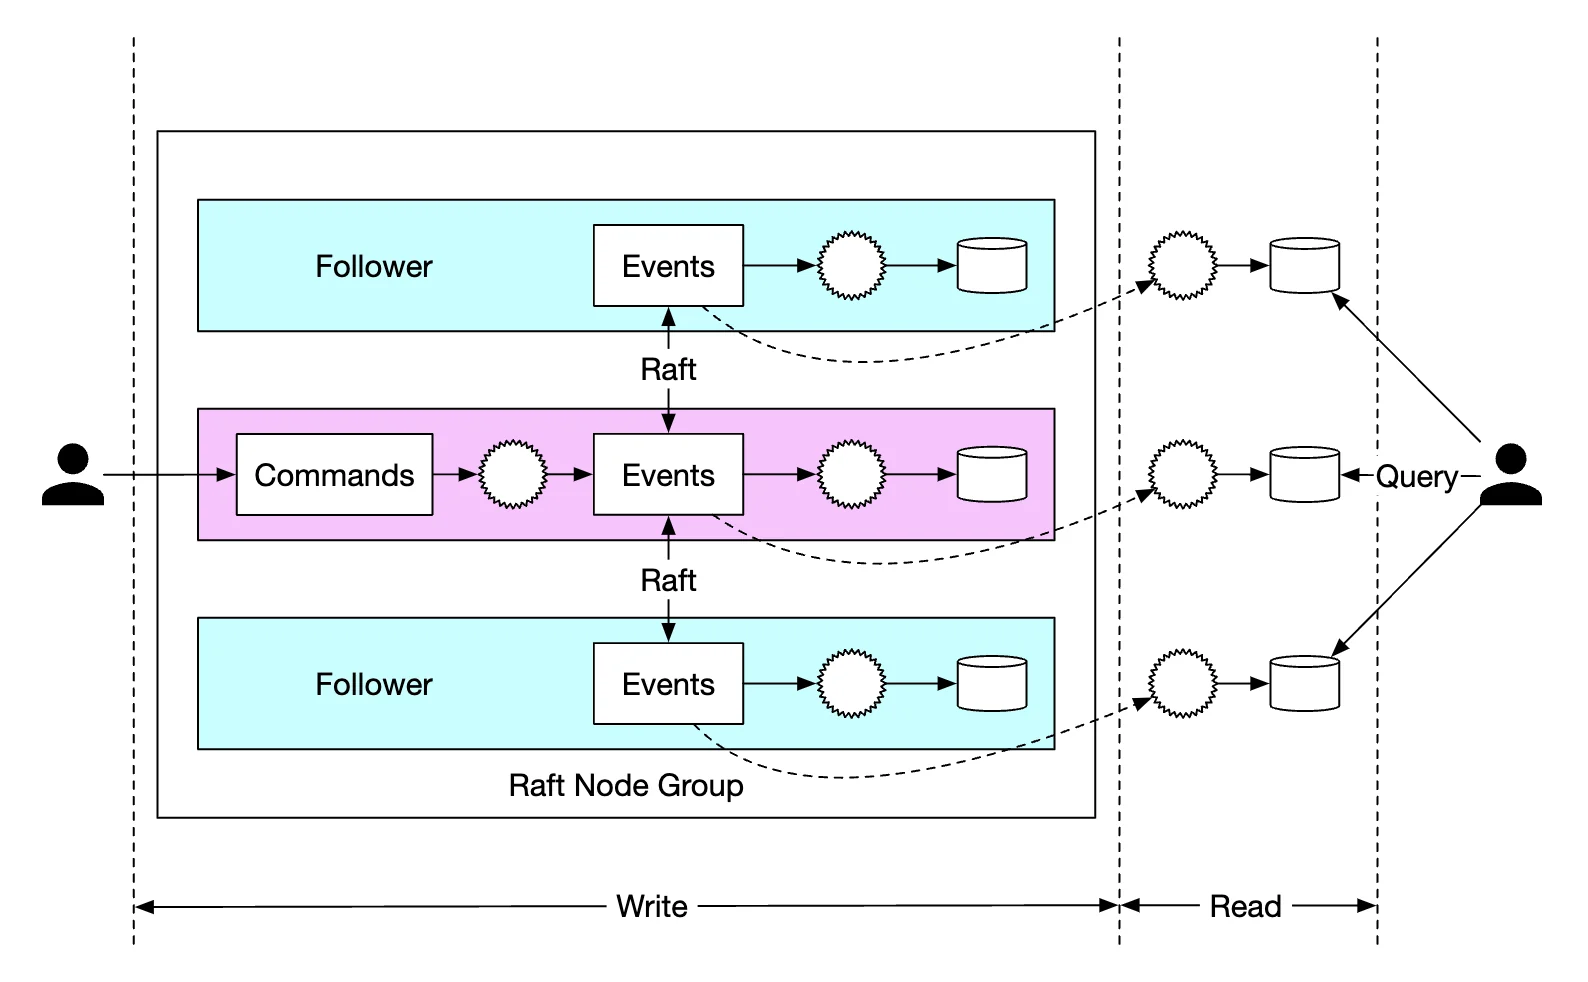
采用这种方法,所有节点都基于事件列表来更新状态。Raft 确保 leader 和 follower 拥有相同的事件列表。
分布式事件溯源
到目前为止,我们已经设计出了一个单节点性能高且可靠的系统。
我们还需要解决一些局限:
- 单个 Raft 组的容量是有限的。到了某个时候,我们需要对数据分片并实现分布式事务
- 在 CQRS 架构中,请求/响应流程很慢。客户端需要定期轮询系统,才能知道自己的钱包何时被更新
轮询不是实时的,因此用户可能要过一段时间才能得知自己余额的更新。另外,如果轮询频率太高,还可能让查询服务过载:
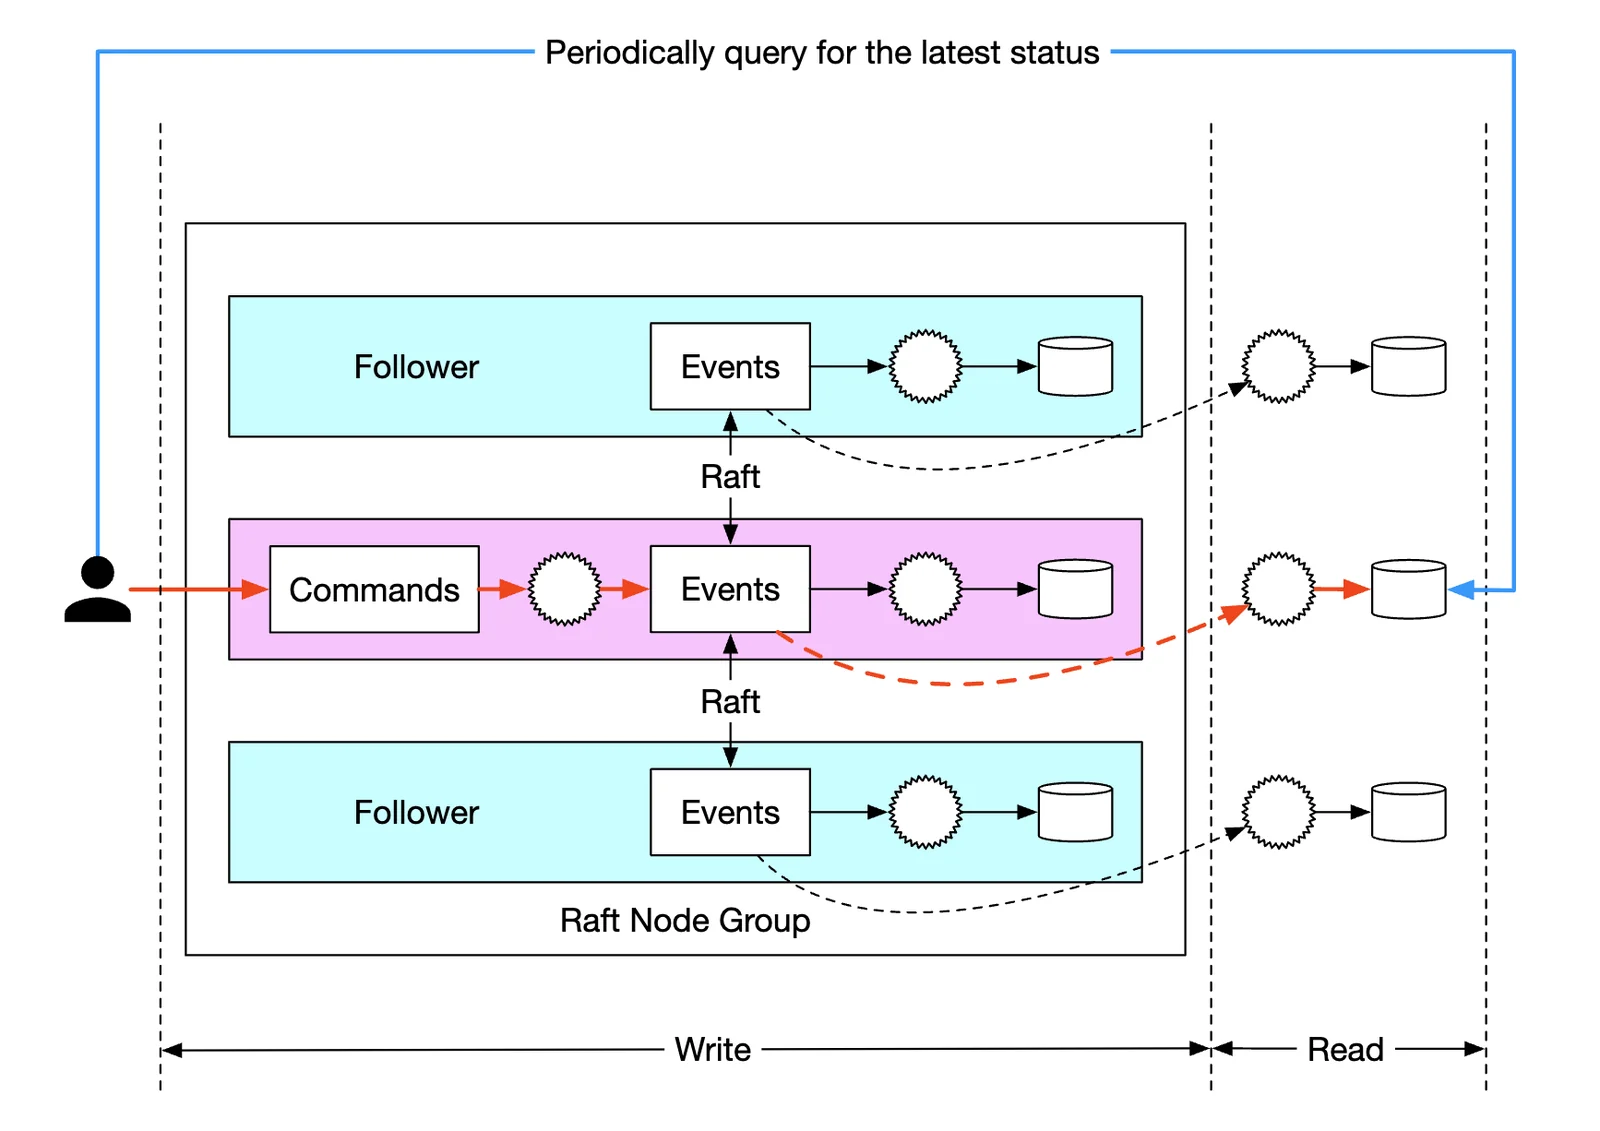
为了减轻系统负载,我们可以引入一个反向代理(Reverse Proxy),由它代表用户发送命令,并代表用户轮询响应:
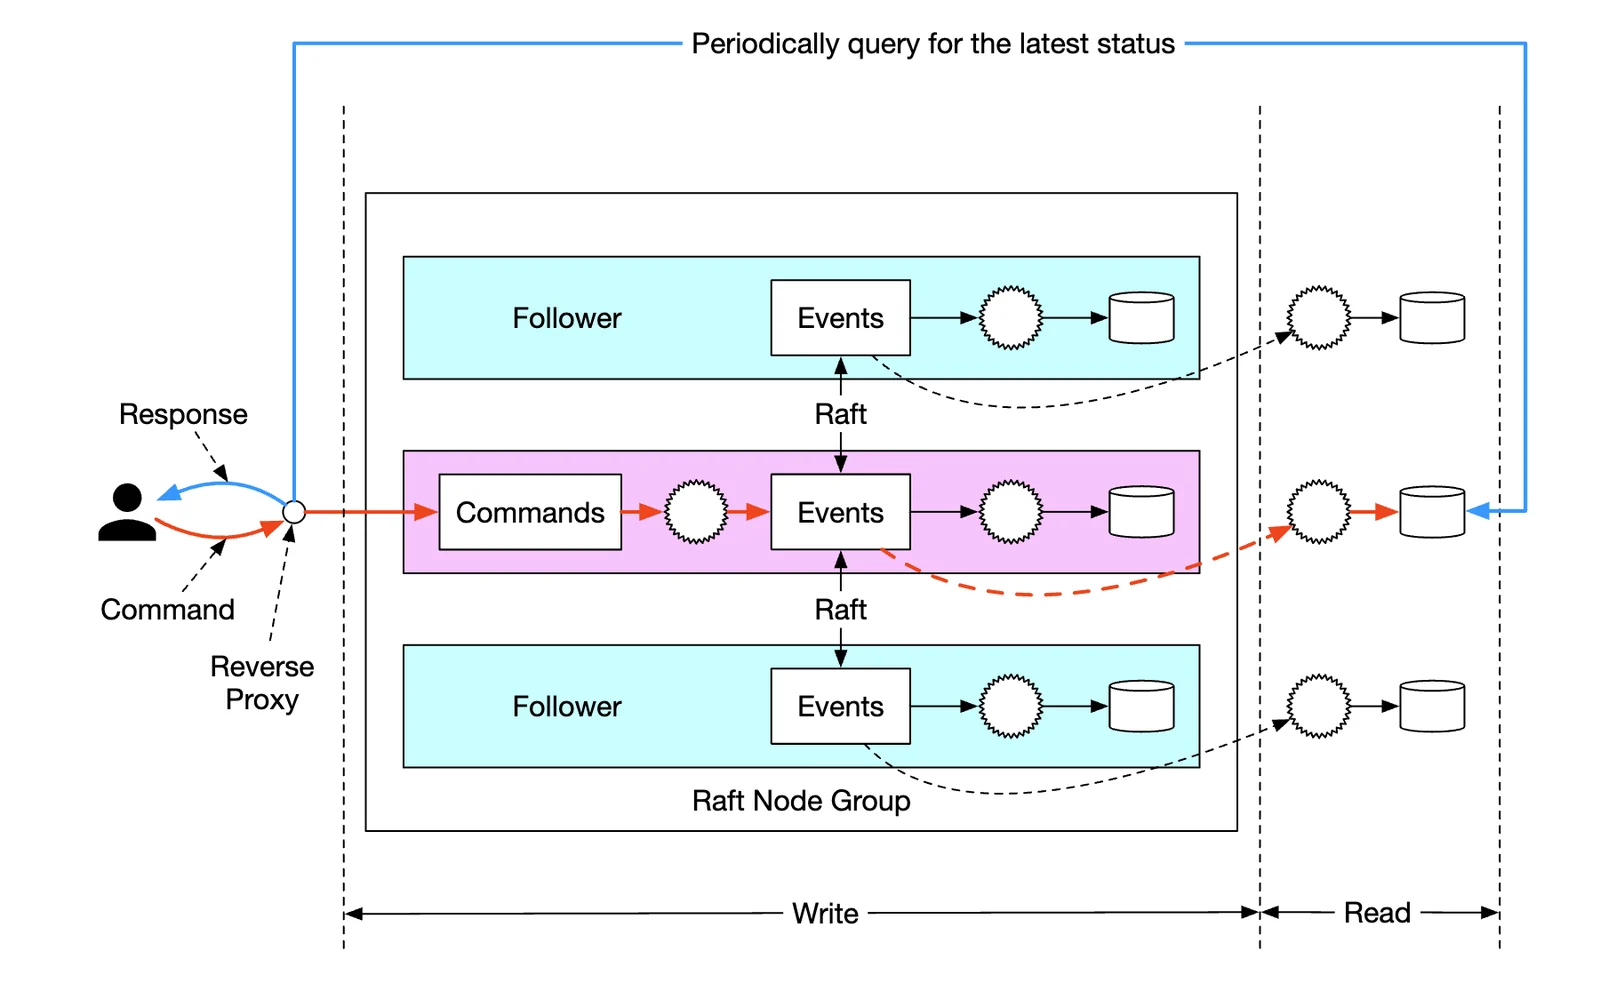
这减轻了系统负载,因为我们可以用一个请求为多个用户获取数据,但它仍然没有解决实时回执的需求。
我们可以做的最后一个改动,是让只读状态机在响应就绪后立即把它推送回反向代理。这能让用户感觉更新是实时发生的:
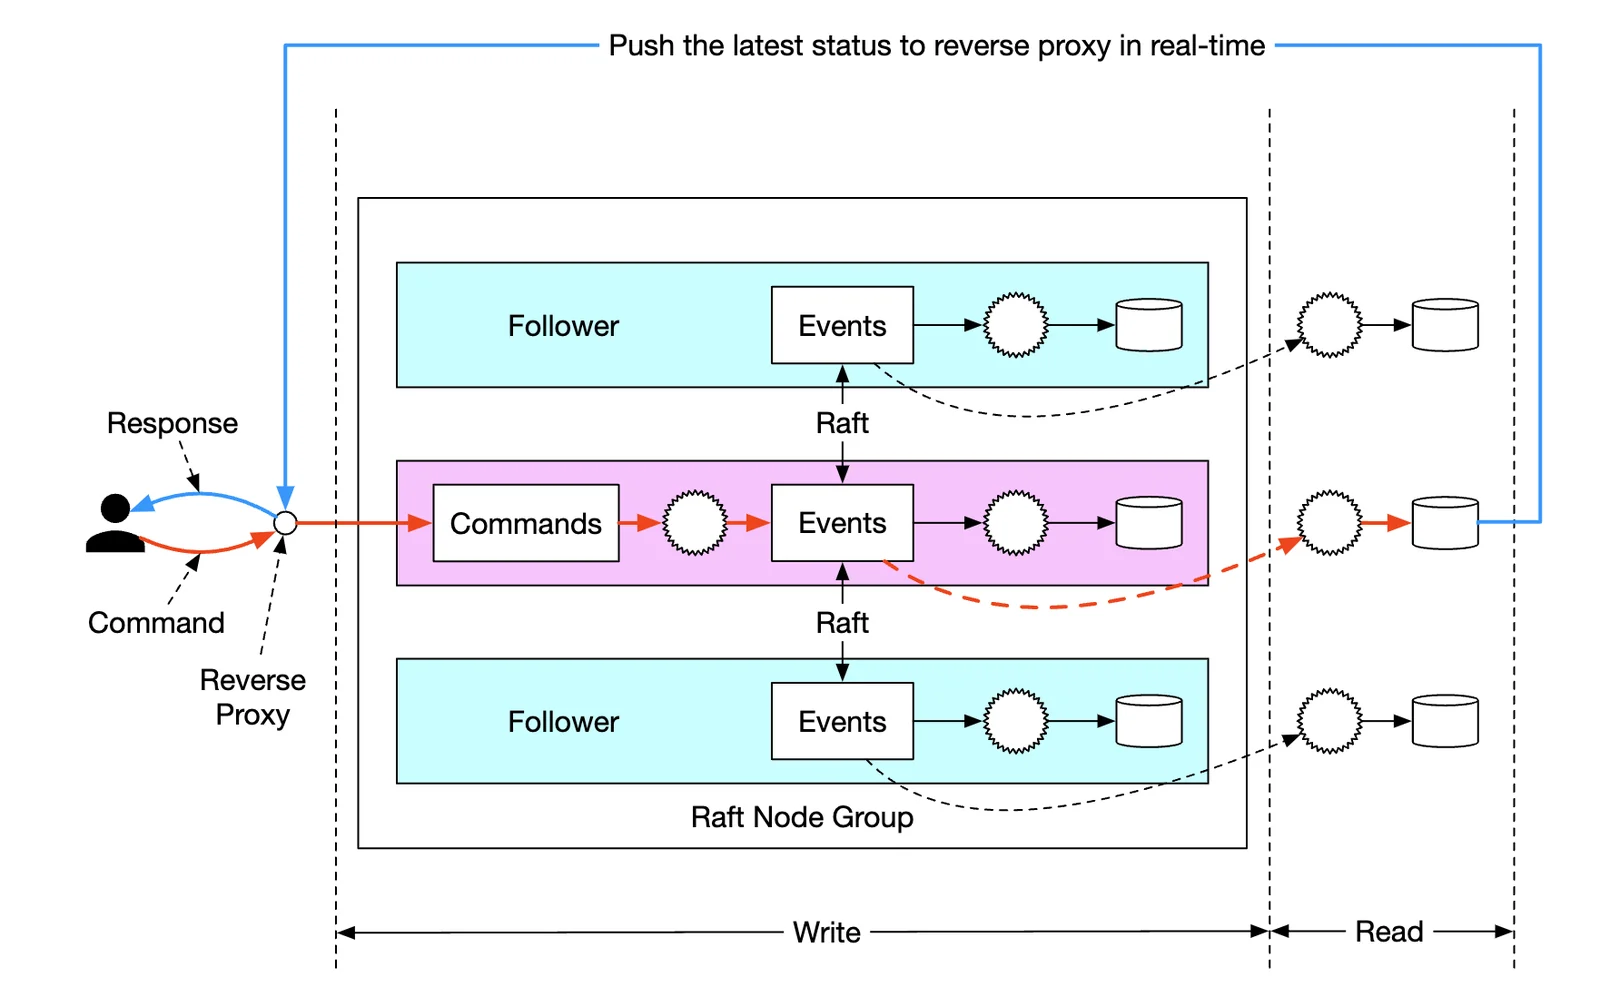
最后,为了让系统进一步扩展,我们可以把系统分片成多个 Raft 组,并在它们之上借助协调者,通过 TC/C 或 Saga 实现分布式事务:
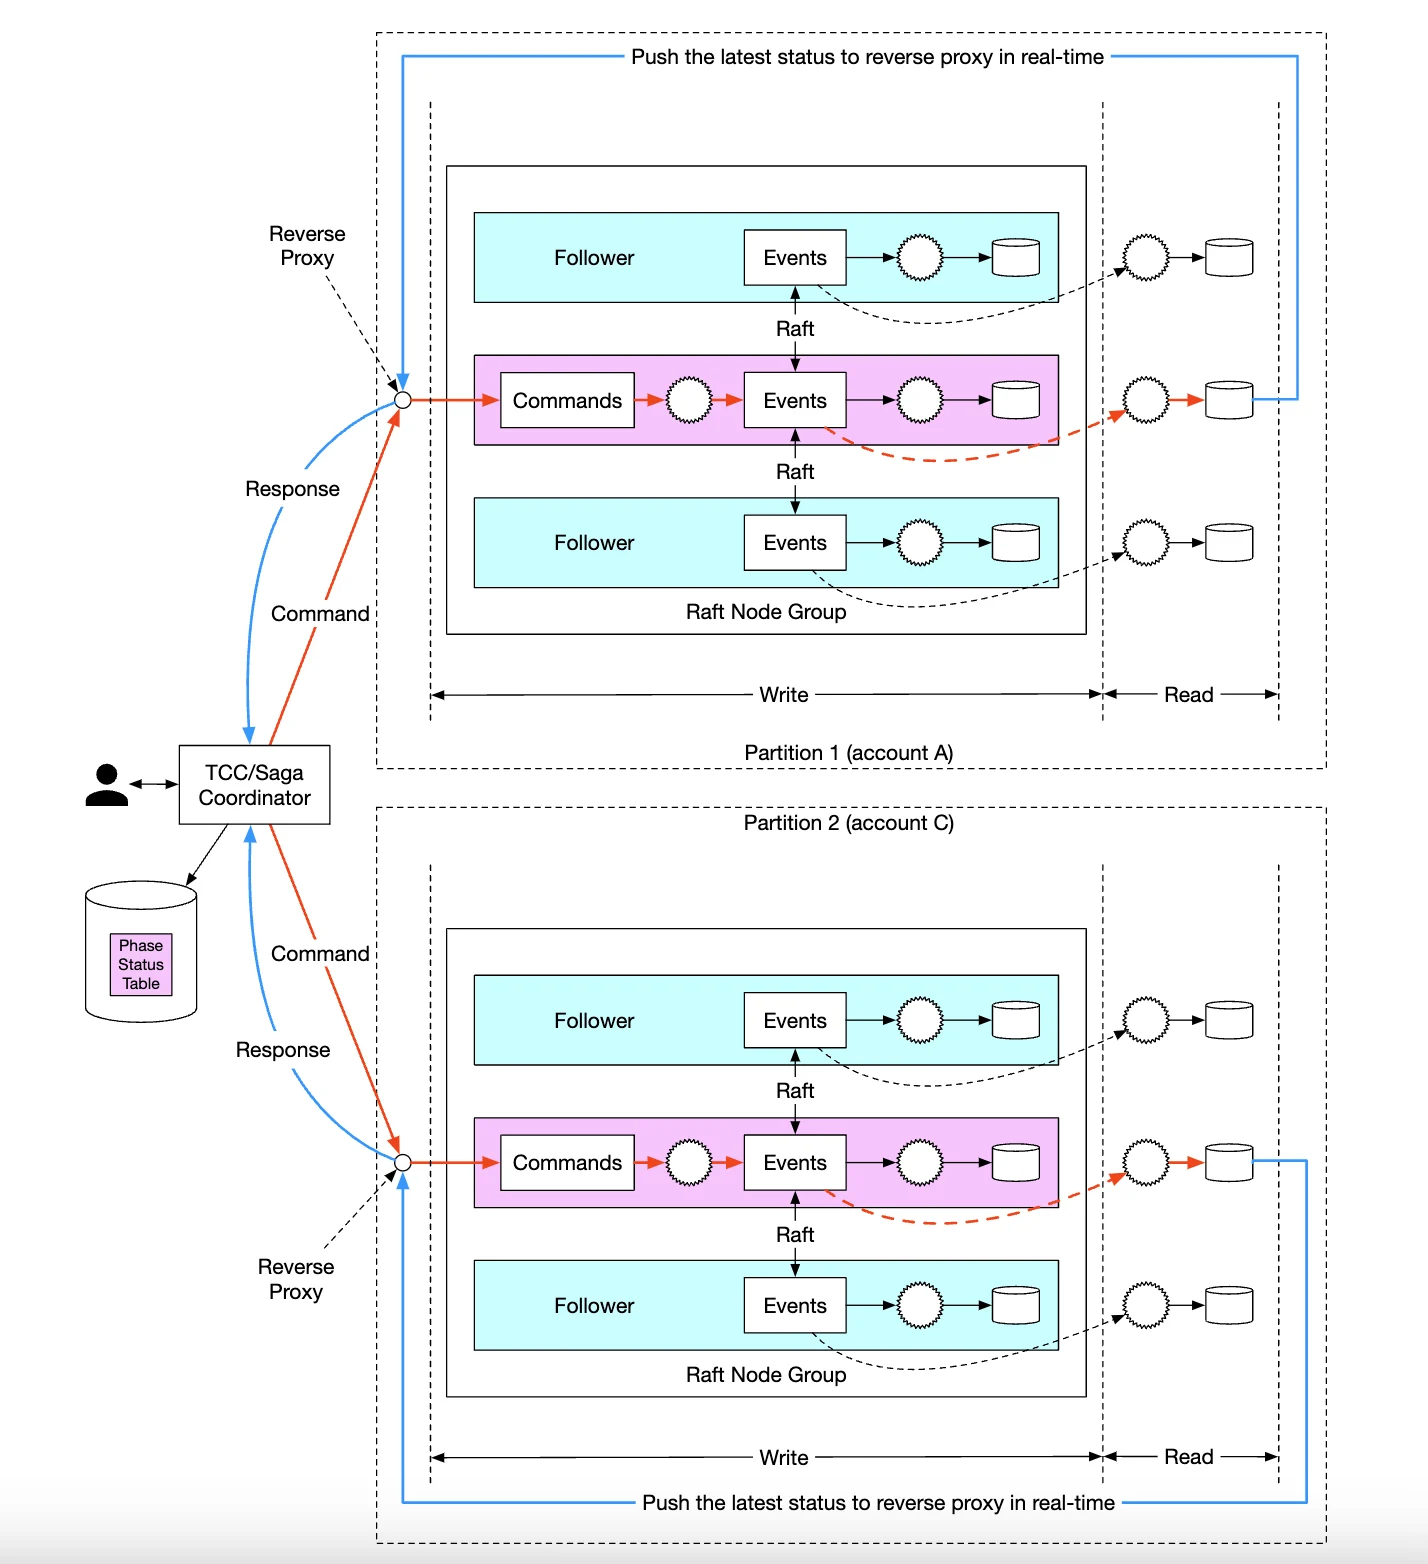
下面是在最终系统中,一个余额转账请求的生命周期示例:
- 用户 A 向 Saga 协调者发送一个包含两个操作(
A-1和C+1)的分布式事务。 - Saga 协调者在阶段状态表中创建一条记录,用于跟踪该事务的状态
- 协调者确定需要把命令发送到哪些分区。
- 分区 1 的 Raft leader 收到
A-1命令,对其进行校验,把它转换为事件,并复制到 Raft 组内的其他节点 - 事件结果被同步到读状态机,读状态机再把响应推送回协调者
- 协调者创建一条记录,表示该操作已成功,然后继续执行下一个操作
C+1 - 下一个操作的执行过程与第一个类似:确定分区、发送命令、执行,然后读状态机推送回响应
- 协调者创建一条记录,表示操作 2 也已成功,最后把结果通知客户端
第 4 步:总结
我们的设计演进过程如下:
- 我们从一个使用内存型 Redis 的方案开始。这种方法的问题在于它不是持久化存储。
- 我们转而使用关系型数据库,并在其上通过 2PC、TC/C 或分布式 saga 执行分布式事务。
- 接着,我们引入事件溯源,使所有操作都可审计
- 一开始我们用外部数据库和队列把数据存储到外部存储中,但这种方式性能不佳
- 于是我们改为把数据存储在本地文件存储中,利用只追加操作的性能优势。我们还使用缓存来优化读路径
- 上一种方法虽然性能好,但不够持久。因此,我们引入了带复制的 Raft 共识,以避免单点故障
- 我们还采用了 CQRS,并借助反向代理代表用户管理事务的生命周期
- 最后,我们把数据分区到多个 Raft 组中,并通过分布式事务机制(TC/C 或分布式 saga)对它们进行协调